すべてのWebスクレイピング開発者向けに作成された最も包括的なガイド。
Scrapelessは、大手企業から信頼されるAIを搭載した堅牢でスケーラブルなWebスクレイピングと自動化サービスを提供します。 私たちのエンタープライズグレードのソリューションは、プロジェクトのニーズを満たすように調整されており、全体にわたって専用の技術サポートがあります。 強力な技術チームと柔軟な配達時間を使用すると、データを成功させるためにのみ請求し、制限をバイパスしながら効率的なデータ抽出を可能にします。
あなたのビジネスの成長を促進するために今すぐお問い合わせください。
連絡先の詳細を提供すると、すぐに製品のデモと紹介を提供します。 GDPR標準に準拠して、お客様の情報が機密のままであることを確認します。
ウェブスクレイピングでJavaScriptとNode.jsを使用する場合、重要なのは単一の初期コールです — データはHTMLに含まれていますか、それともJavaScriptによって生成されていますか?Cheerioは最初のケースをパーサー速度で処理し、Puppeteerはページをレンダリングすることで2番目のケースを処理します。両方をScrapeless Scraping Browserで実行することで、住宅用の出口とアンチ検出が背後にあるため、取得はどちらの方法でも成功します。より深いアンチボットワークフローについては、Scrapling + Scrapelessガイドを参照してください;Scraping Browserの製品ページとドキュメントは、完全なSDKの表面をカバーしています。まず生のHTMLを確認し、可能な場合はCheerioを使い、必須の場合はPuppeteerを使用し、時計を見ずにコンテンツに集中してください。
 Daniel Kim
TikTokは、そのデータを再水和JSONブロブで送信し、残りをXHR経由で水和します。検出回避クラウドブラウザから両方を読み取ります—プロファイル抽出がリアルタイムで確認されました。
 Emily Chen
Qwenの回答は、chat.qwen.aiの水分補給されたReactアプリにのみ存在します。このターミナルファーストのウォークスルーは、クラウドセッションを作成し、Qwen Studioを実行し、ストリームが安定するのを待ち、回答をJSON形式で読み返します。
Daniel Kim
Scrapeless Scraper APIは、Googleローカルパックをscraper.google.searchアクターに対する単一のPOSTに変換します。tbm: "lcl"を送信すると、地図に基づいたビジネスリスティング(タイトル、評価、レビュー、住所)を構造化されたJSON形式で取得できます。
 Isabella Garcia
Google Imagesのデータは、scraper.google.searchアクターへの単一のPOSTから取得されます。tbm: "isch"を指定します。Scraper APIはサーバー側でページをレンダリングおよび解析するため、構造化されたJSONを読み取るだけで済みます — ブラウザも維持するためのパーサーも不要です。
Emily Chen
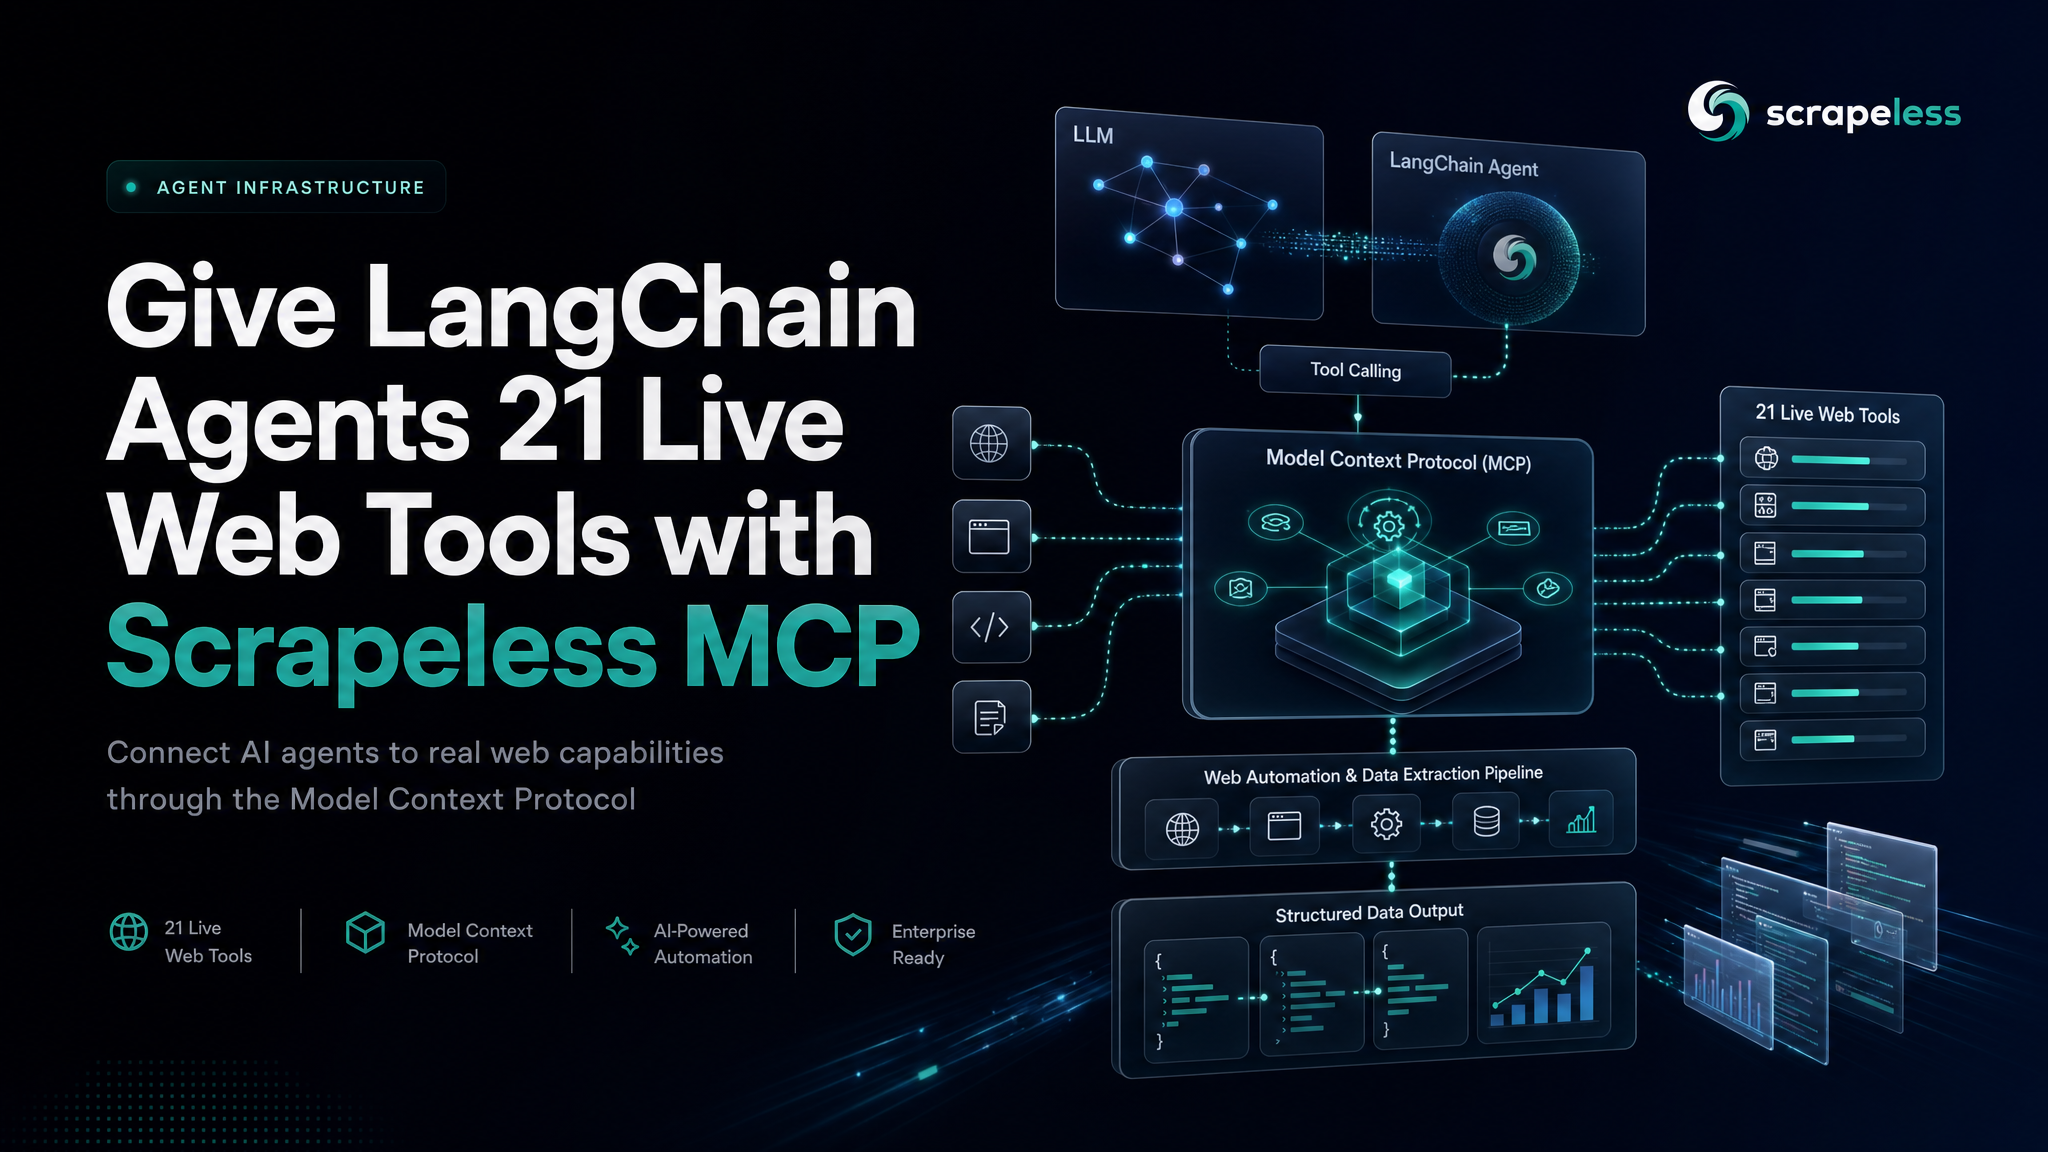
langchain-mcp-adaptersパッケージは、LangChainアプリをScrapeless MCPサーバーに接続し、21のバインド可能なウェブツール(ブラウザ制御、ページスクレイピング、Google検索とトレンド)を返します。これらは、モデルが関与する前にテスト可能です。
 Ava Wilson
検索結果は、インデックスされたテキストの質に依存します。このパイプラインは、ウェブアンロッカーを介して完全にレンダリングされたHTMLを取得し、ページの外観を除去し、重複と出所を考慮して文章を分割します—埋め込みモデルに準備されたクリーンなコーパスです。
Isabella Garcia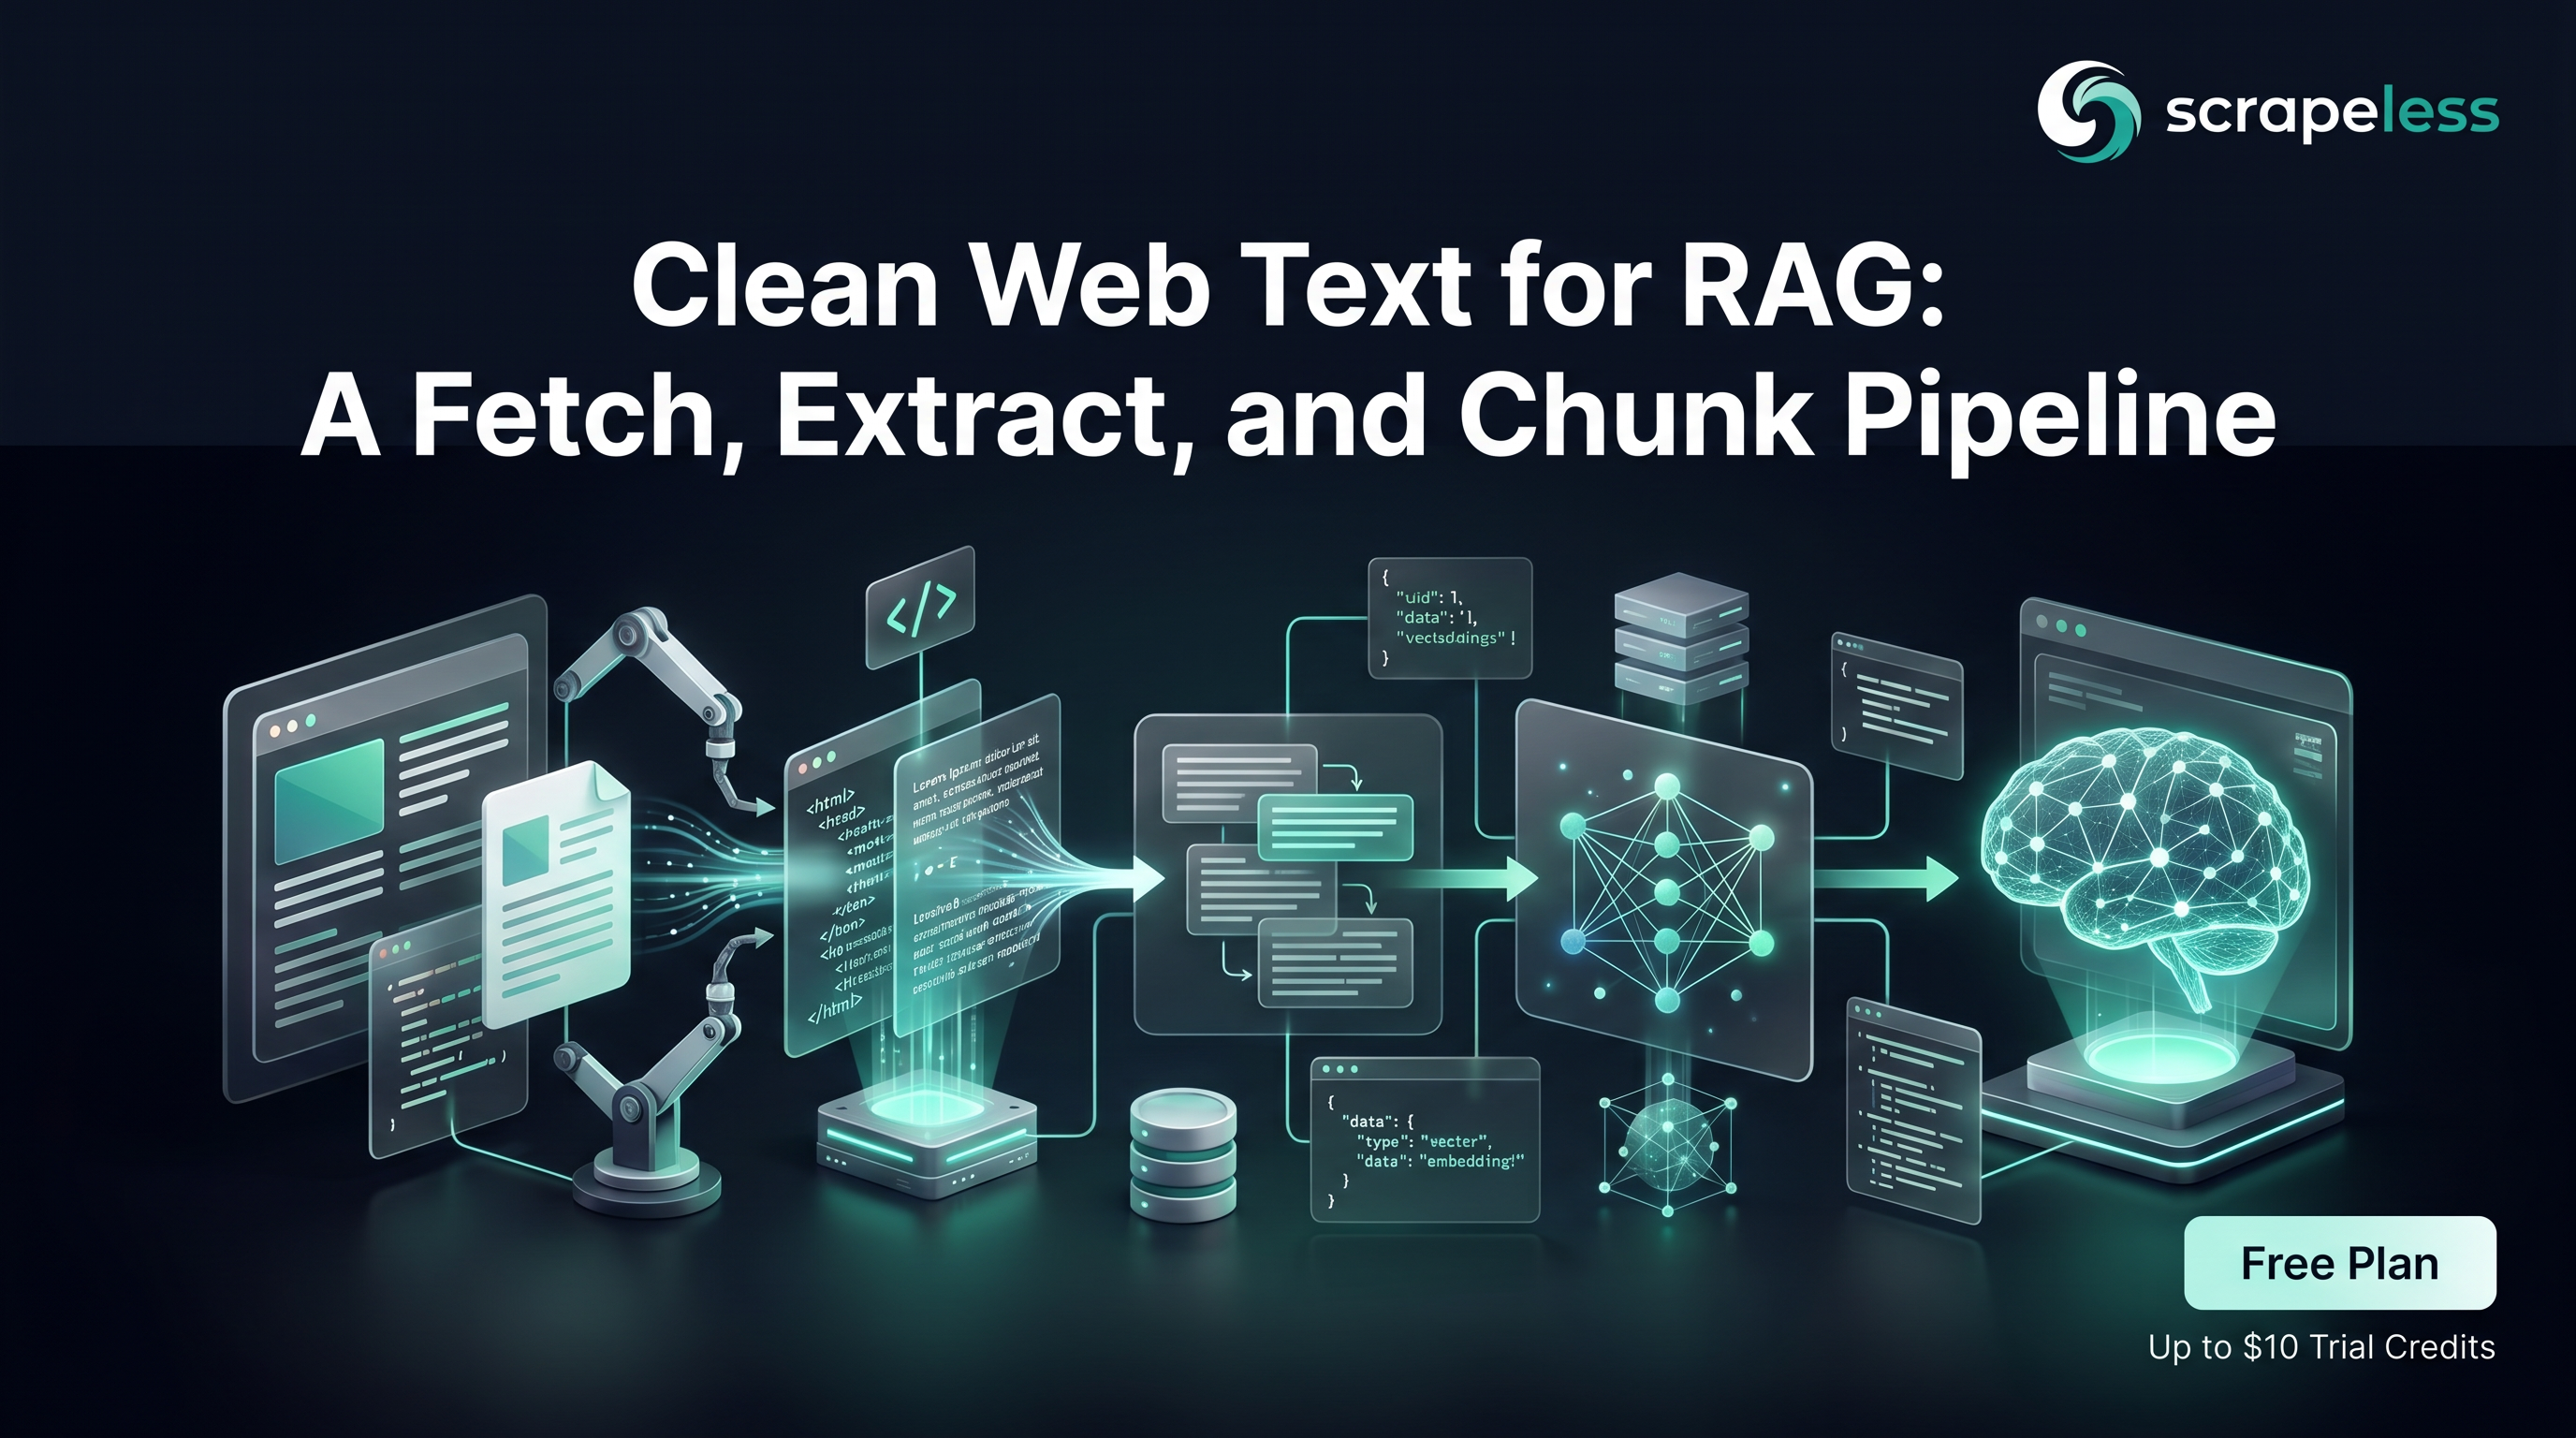
ChatGPT、Grok、Gemini、Perplexity、Copilot、GoogleのAI Overviewはすべて、引用を伴って購入に関する質問に答えます。すべてを1つのエンドポイントで取得し、引用スキーマを正規化し、時間を通じて自ブランドの引用のシェアをグラフ化しましょう。
Daniel Kim