Guia mais abrangente, criado para todos os desenvolvedores de raspagem na web.
A Scorresless oferece serviços de raspagem e automação da Web, movidos a IA, robustos e escaláveis, confiáveis pelas principais empresas. Nossas soluções de nível corporativo são adaptadas para atender às necessidades do seu projeto, com suporte técnico dedicado por toda parte. Com uma equipe técnica forte e prazos de entrega flexíveis, cobramos apenas dados bem -sucedidos, permitindo uma extração de dados eficientes enquanto ignora as limitações.
Entre em contato conosco agora para alimentar o crescimento dos seus negócios.
Forneça seus detalhes de contato e prontamente entraremos em contato para oferecer uma demonstração e introdução do produto. Garantimos que suas informações permaneçam confidenciais, cumprindo os padrões do GDPR.
Sua avaliação gratuita está pronta! Inscreva -se para uma conta sem descarga gratuitamente e seu teste será ativado instantaneamente em sua conta.
Construa uma análise de recursos SERP com registros orgânicos e de módulo separados, estados de campo explícitos e mapeamentos de esquema verificados em vez de contagens de classificação misturadas.
 Michael Lee
Construa a descoberta do site da empresa com pesquisas contextuais, domínios candidatos, verificações de entidades e uma tabela revisável de empresa para site usando a API de Pesquisa do Google.
Michael Lee
Use a API de Pesquisa do Google para agentes de IA para criar uma fila de revisão de fontes, preservar o contexto de pesquisa e separar a descoberta da recuperação e verificação de citações.
Michael Lee
Use pesquisa de conteúdo SERP para construir um resumo de conteúdo a partir de observações de pesquisa, páginas revisadas, perguntas do público e um plano claro para evidências originais.
Michael Lee
Uma arquitetura de produção para agentes web delimitados, com ferramentas explícitas, estado, política, evidência, validação e decisões agente-contra-pipeline.
 Daniel Kim
Seis ferramentas de raspagem de IA comparadas por camada de operação, interação com o navegador, modelo de integração, saída estruturada, proveniência e propriedade do fluxo de trabalho.
 Isabella Garcia
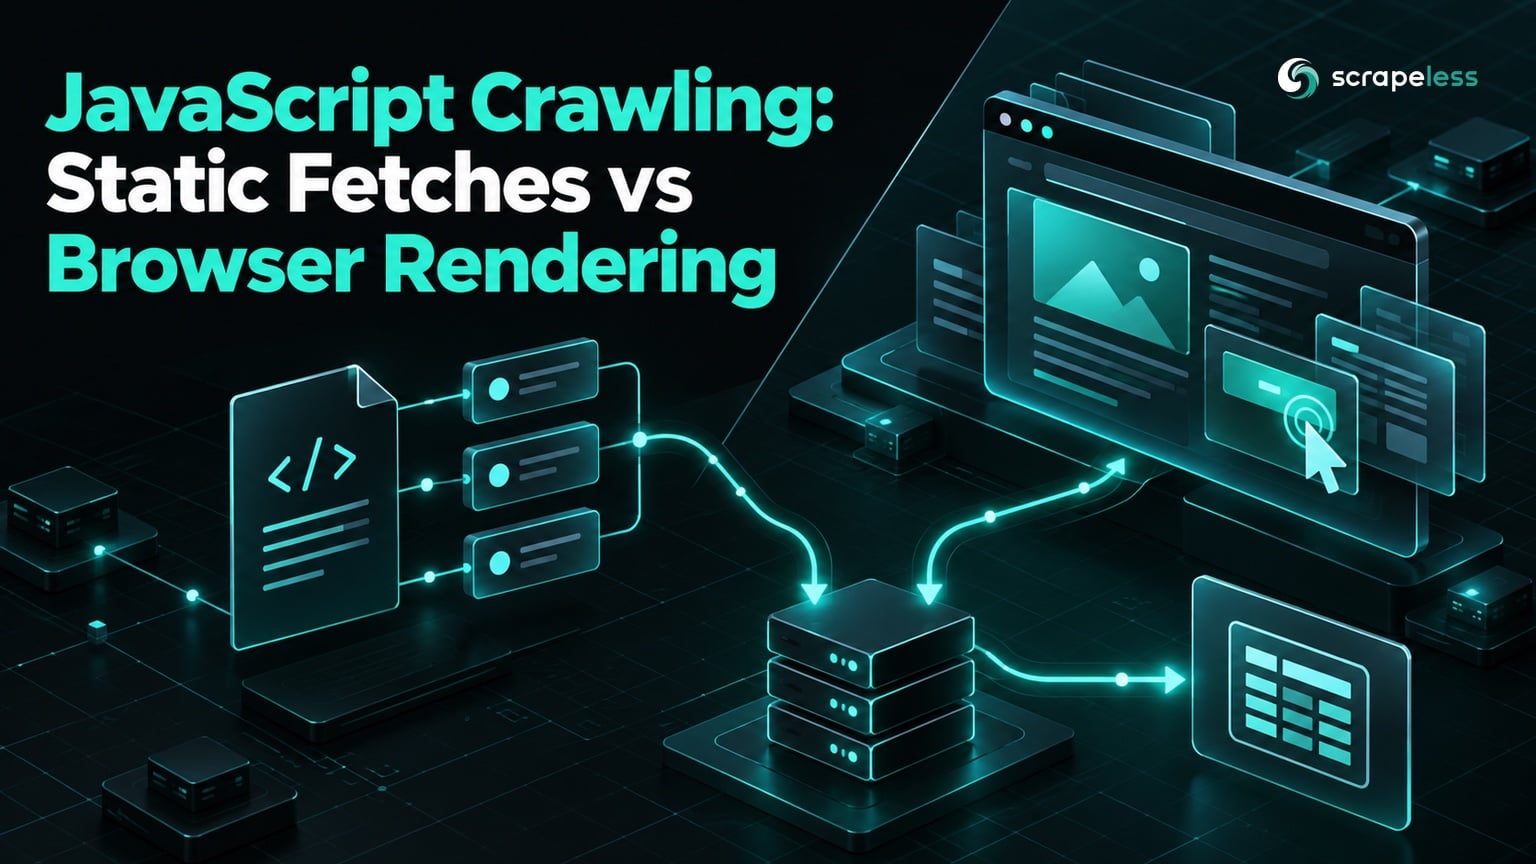
Um guia de decisão em nível de template para combinar fetching HTTP estático e renderização de navegador dentro de uma arquitetura de crawl JavaScript controlada.
 Alex Johnson
Um pipeline prático para transformar páginas da web públicas aprovadas em texto limpo, deduplicado e vinculado à fonte para RAG, ajuste fino e avaliação.
 Emily Chen