
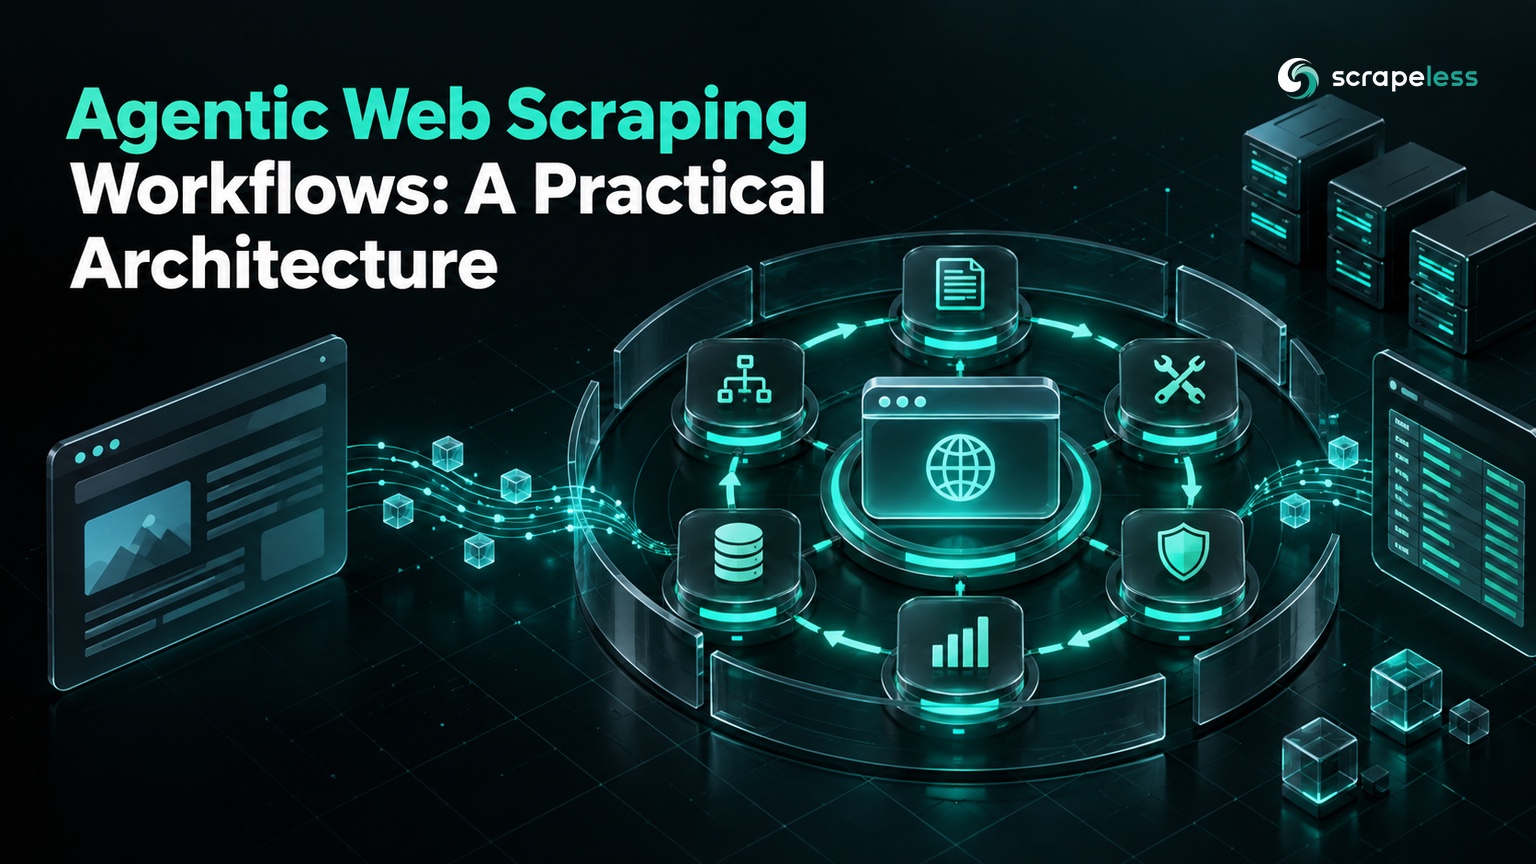
Agentes de Web Scraping: Uma Arquitetura Prática
Lead Scraping Automation Engineer
TL;DR:
- Um fluxo de trabalho de raspagem da web agentic permite que um modelo escolha a próxima ação limitada a partir do estado da página observado. Isso é útil quando a rota não pode ser enumerada de forma confiável com antecedência.
- A maioria das extrações deve continuar a ser determinística. Trabalhos de fonte fixa com paginação, esquemas e condições de parada estáveis são mais fáceis de testar como pipelines convencionais.
- Um agente de produção precisa de seis componentes explícitos: um contrato de tarefa, ferramentas permitidas, estado, um avaliador, limites políticos e uma trilha de evidência.
- Mantenha a aceitação de dados fora do agente. Um modelo pode navegar e propor registros, mas validadores determinísticos devem impor regras de hosts, esquemas, contagens, proveniência e dados restritos.
- Agente AI Scrapeless, Navegador de Agentes e MCP cobrem camadas diferentes. Use o Agente AI para tarefas orientadas a resultados, Navegador de Agentes para execução de páginas gerenciadas, e MCP para expor ferramentas limitadas a clientes de agentes compatíveis.
O Que É um Fluxo de Trabalho de Raspagem da Web Agentic?
Um fluxo de trabalho de raspagem da web agentic é um loop controlado no qual um modelo observa o estado da web, seleciona uma ação permitida, avalia o resultado e continua até atingir um objetivo ou regra de parada estabelecida. O modelo pode escolher entre ferramentas, mas não recebe autoridade ilimitada.
A distinção útil é a propriedade da decisão:
| Tipo de fluxo de trabalho | Quem escolhe o próximo passo? | Melhor ajuste | Principal risco |
|---|---|---|---|
| Pipeline determinístico | Código da aplicação | Rotas, paginação e esquemas estáveis | Lógica frágil quando os caminhos da página variam |
| Passo assistido por IA | Código da aplicação chama um modelo em um ponto fixo | Classificação, mapeamento de campos ou normalização | Saída de modelo não validada |
| Fluxo de trabalho agentic | Modelo escolhe entre ferramentas limitadas | Navegação ambígua ou tarefas de pesquisa | Desvio de escopo e regras de parada fracas |
Um LLM dentro de um pipeline não torna todo o sistema agentic. O sistema se torna agentic quando as decisões do modelo determinam a próxima ação ou rota.
Quando Você Deve Usar um Agente em vez de um Pipeline?
Use um pipeline determinístico quando o trabalho puder ser expresso como um gráfico estável: buscar uma lista, seguir paginação, abrir páginas detalhadas, extrair campos conhecidos e armazenar registros. Cada ramificação pode ser testada, e estados de falha são fáceis de classificar.
Considere um agente quando a rota varia de acordo com o estado da página ou a tarefa é baseada em resultados. Exemplos incluem localizar uma política específica em várias seções de documentação, comparar produtos cujos rótulos de atributo diferem ou navegar em um site público onde o resultado relevante pode exigir pesquisa, filtragem e inspeção de acompanhamento.
Não use um agente para ocultar um requisito indefinido. Se a equipe não conseguir afirmar quais fontes são permitidas, como deve ser a saída ou quando a tarefa deve parar, o raciocínio do agente amplificará a ambiguidade.
O Loop de Controle do Agente
Um loop prático tem cinco fases:
- Observar: capturar a URL atual, estrutura visível, resultado da ferramenta e estado da tarefa.
- Decidir: escolher uma ação permitida ou terminar.
- Agir: chamar uma ferramenta de navegador, pesquisa, extração ou armazenamento com argumentos limitados.
- Avaliar: comparar o novo estado com o contrato da tarefa e regras de aceitação.
- Registrar: adicionar evidência, atualizar progresso e impor orçamento ou condições de parada.
O modelo deve ver estado suficiente para decidir, mas não uma transcrição ilimitada. Resuma o trabalho concluído, mantenha URLs de origem canônicas e armazene observações estruturadas separadamente do raciocínio conversacional.
Seis Componentes que Todo Agente de Produção Precisa
1. Um Contrato de Tarefa
O contrato de tarefa declara o objetivo, fontes permitidas, campos necessários, comportamento de valores ausentes, escopo máximo e regra de conclusão. Substitua “pesquisar concorrentes” por um contrato como: coletar os nomes dos planos de preços públicos e unidades de faturamento de cinco páginas de fornecedores aprovados, anexar uma URL de origem a cada linha e sinalizar campos que não são exibidos.
2. Ferramentas Limitadas
As ferramentas devem expor a menor ação útil. open_approved_url, extract_schema e save_candidate_record são mais seguras do que uma função geral que pode navegar em qualquer lugar e escrever dados arbitrários. Valide os argumentos da ferramenta fora do modelo.
A especificação do Protocolo de Contexto de Modelo define um protocolo cliente-servidor para expor ferramentas e recursos contextuais. O MCP pode padronizar a conexão, mas o servidor e a aplicação host ainda possuem autorização, validação e registro.
3. Estado Explícito
O estado deve distinguir fatos da tarefa de observações temporárias. Armazene listas de origem aprovadas, URLs visitadas, candidatos extraídos, resultados de validação, orçamento restante e status de conclusão como campos estruturados. Não confie no modelo para reconstruí-los a partir de prosa.
4. Um Avaliador
O avaliador verifica se a última ação avançou a tarefa. Ele pode combinar regras determinísticas e um julgamento de modelo com escopo restrito. As verificações determinísticas devem cobrir o escopo da URL, a forma do esquema, registros duplicados, proveniência necessária e condições de parada.
5. Limites de Política e Orçamento
Aplique listas de permissão de hosts, caminhos negados, interações permitidas, limites de página, limites de tempo e restrições de dados no código em torno do agente. O modelo pode decidir qual página permitida abrir, mas não deve se conceder um novo escopo.
6. Uma Trilha de Evidências
Cada campo aceito deve apontar para uma URL de origem e captura. Armazene entradas de ferramentas, URLs finais, evidências extraídas, resultados de validadores e a versão final do conjunto de dados. Isso torna a revisão humana possível e impede que um resumo polido oculte uma cobertura de fonte fraca.
Como o Scrapeless se Encaixa em uma Arquitetura Agente
Agente AI Scrapeless fornece um ponto de entrada orientado a resultados para tarefas na web. Navegador Agente fornece execução de navegador gerenciada quando o fluxo de trabalho precisa de JavaScript, interação com a página ou estado persistente do navegador.
O MCP é a camada de conexão quando um cliente agente externo precisa de ferramentas Scrapeless limitadas. O guia Scrapeless MCP explica essa interface, enquanto a documentação do Navegador Agente cobre detalhes de conexão de navegador gerenciado. Essas camadas podem ser usadas independentemente: uma aplicação determinística pode chamar o Navegador Agente, e um agente pode chamar ferramentas baseadas em requisições sem abrir um navegador para cada página.
Comece a Raspagem com Scrapeless
Potencialize seu fluxo de trabalho de raspagem e automação na web com o Scrapeless!
Inscreva-se hoje e ganhe $5 em crédito gratuito — sem necessidade de cartão de crédito.Reivindique seu crédito gratuito agora no Painel Scrapeless.
Separe Navegação da Aceitação de Dados
Um agente pode decidir como chegar a uma página, mas não deve ser o único juiz de se os dados extraídos são válidos. Coloque um limite de aceitação após o agente:
- a URL de origem deve ser aprovada;
- a URL final deve permanecer dentro do escopo;
- campos obrigatórios devem estar em conformidade com um esquema;
- valores devem portar evidência de origem;
- duplicatas devem resolver para uma chave de registro estável;
- conteúdo sensível ou restrito deve ser rejeitado ou revisado;
- a conclusão deve satisfazer uma regra de contagem ou cobertura determinística, quando possível.
Esse design permite que o agente lide com variação de rota, enquanto o software convencional protege o conjunto de dados. Também facilita a comparação de mudanças de modelo ou prompt, pois os portões de saída permanecem fixos.
Fluxos de Trabalho de Agente Único vs Múltiplos Agentes
Um único agente é o padrão. Ele mantém um estado de tarefa, uma trilha de evidências e um orçamento. Divida o fluxo de trabalho apenas quando os papéis tiverem entradas, ferramentas e regras de aceitação distintas.
Um design multi-agente defensável pode separar a descoberta da verificação:
- O agente de descoberta encontra páginas candidatas dentro de uma lista de hosts aprovada.
- O agente de extração mapeia evidências de página em um esquema fixo.
- O agente de verificação verifica a cobertura da fonte e sinaliza conflitos sem alterar a evidência original.
O orquestrador possui o contrato de tarefa compartilhado e impede que os agentes expandam a autoridade uns dos outros. Vários agentes não garantem julgamento independente se eles receberem a mesma fonte fraca ou prompt. Use verificações determinísticas para reivindicações que podem ser verificadas diretamente.
Observabilidade para Raspagem Agente
Métricas de rastreamento tradicionais continuam sendo úteis, mas as decisões do agente adicionam novos modos de falha. Acompanhe:
- tentativas de navegação aprovadas e rejeitadas;
- chamadas de ferramentas por tipo e host alvo;
- páginas de origem únicas que contribuem para campos aceitos;
- registros candidatos rejeitados pela validação de esquema;
- ações repetidas que não mudam o estado;
- tarefas paradas por página, tempo ou orçamento de ação;
- registros enviados para revisão humana;
- respostas finais sem evidência de origem suficiente.
Capture diagnósticos do navegador quando a interação falhar, mas evite armazenar segredos ou dados pessoais desnecessários. Reduza credenciais e campos sensíveis antes que logs entrem no contexto do modelo ou de armazenamento a longo prazo.
Barreiras para Agentes Web
As barreiras devem ser aplicadas fora do prompt do modelo. Os prompts são instruções úteis, mas não são um limite de segurança.
Use controles em camadas:
- Permita apenas ferramentas necessárias.
- Valide cada URL de acordo com as políticas de esquema, host e caminho.
- Restringa downloads do navegador e envios de formulários, a menos que a tarefa precise explicitamente deles.
- Mantenha credenciais em um gerenciador de segredos e injete-as apenas em chamadas de ferramentas aprovadas.
- Exija confirmação para ações com efeitos colaterais externos.
- Aplique validação de saída determinística antes do armazenamento ou execução a jusante.
- Mantenha um caminho de revisão humana para resultados ambíguos, sensíveis ou de alto impacto.
O Quadro de Gerenciamento de Risco de IA do NIST é uma referência útil para governança, mapeamento e gerenciamento de risco de IA. O Protocolo de Exclusão de Robôs abrange diretrizes de rastreadores, enquanto termos de site, obrigações de privacidade e controles de acesso permanecem requisitos separados. Implementações de controle de navegador também podem usar a especificação W3C WebDriver como referência para semântica de automação remota.
Uma Arquitetura de Referência
| Camada | Responsabilidade | Controle determinístico |
|---|---|---|
| Entrada de solicitação | Converter um objetivo do usuário em um contrato de tarefa | Esquema, lista de permissões de origem, orçamento de ação |
| Planejador | Selecionar o próximo passo útil | Apenas nomes de ferramentas permitidas e formas de argumento |
| Aquisição | Buscar ou renderizar páginas públicas aprovadas | Validação de URL e tipo de mídia |
| Armazenamento de estado | Rastrear fontes, candidatos e progresso | IDs estáveis, chaves de deduplicação, contadores de orçamento |
| Extrator | Mapear evidências para campos candidatos | Ponteiro de origem requerido em cada registro |
| Avaliador | Decidir se deve continuar ou terminar | Regras de cobertura e parada |
| Fila de revisão | Resolver itens ambíguos ou sensíveis | Aprovação humana baseada em função |
| Armazenamento de saída | Publicar o conjunto de dados aceito | Versão, proveniência e registro de auditoria |
O modelo pertence ao planejador e, onde útil, ao extrator ou avaliador. Não deve ser o único controle em cada camada.
Quando a Extração Agente é a Escolha Errada
Permaneça com um pipeline determinístico quando:
- URLs e paginação são estáveis;
- o esquema é fixo e os seletores são confiáveis;
- a tarefa é executada com frequência em alto volume;
- cada passo deve ser reproduzido exatamente;
- o alvo fornece uma API ou exportação documentada;
- o fluxo de trabalho não tem ramificações de decisão significativas.
Um passo de extração assistido por IA ainda pode ajudar com rótulos ou classificação variados. Mantenha essa chamada de modelo dentro de um fluxo de trabalho fixo e valide sua saída.
Conclusão: Coloque Poder onde a Incerteza Vive
A extração agente é útil quando a próxima rota depende do estado da página ou do julgamento de pesquisa. Não é necessária quando o caminho e o esquema já são conhecidos. A arquitetura mais forte mantém as escolhas do agente restritas e as cercam com escopo determinístico, validação, evidência e regras de parada.
Comece com uma tarefa orientada por resultados que um rastreador fixo não consegue expressar claramente. Defina seu contrato, forneça um pequeno conjunto de ferramentas, registre cada fonte e compare suas saídas aceitas com uma linha de base determinística. Expanda a agência apenas onde esse teste mostrar um benefício real.
Construa um Agente Web Limitado
Compare preços do Scrapeless, explore Agente de IA Scrapeless ou junte-se à comunidade Discord do Scrapeless e à comunidade Telegram.
FAQ
P: O que torna um fluxo de trabalho de web scraping agente?
O modelo escolhe a próxima ação a partir do estado observado dentro de um conjunto de ferramentas limitado. Um pipeline fixo que chama um LLM para um passo de extração é assistido por IA, não totalmente agente.
P: Os fluxos de trabalho agentes são melhores que os pipelines lineares?
Eles são melhores para algumas rotas variáveis e tarefas orientadas por resultados. Pipelines lineares continuam a ser mais fáceis de testar, reproduzir e operar quando as fontes e etapas são estáveis.
P: Qual é a guarda mais importante para um agente web?
Imponha limites de origem e ação fora do prompt. Listas de permissões de URL, esquemas de ferramentas, orçamentos, regras de dados e aprovações de efeitos colaterais devem ser controles de aplicação.
P: O MCP torna um agente seguro?
Não. O MCP padroniza como clientes e servidores trocam ferramentas e contexto. A segurança ainda depende do design da ferramenta, autorização, validação, política de host, registro e aprovação do usuário.
P: Quando um fluxo de trabalho deve usar múltiplos agentes?
Use múltiplos agentes quando os papéis têm ferramentas e regras de aceitação distintas, como descoberta e verificação independente. Mantenha um único orquestrador e um contrato de tarefa compartilhado.
P: Como deve ser auditado um resultado de extração agente?
Armazenar o contrato de tarefa, chamadas de ferramenta, URLs finais, evidências de origem, resultados do validador e versão do conjunto de dados. Revisar os registros aceitos em relação às suas fontes em vez de apenas ler o resumo final.
Na Scorretless, acessamos apenas dados disponíveis ao público, enquanto cumprem estritamente as leis, regulamentos e políticas de privacidade do site aplicáveis. O conteúdo deste blog é apenas para fins de demonstração e não envolve atividades ilegais ou infratoras. Não temos garantias e negamos toda a responsabilidade pelo uso de informações deste blog ou links de terceiros. Antes de se envolver em qualquer atividade de raspagem, consulte seu consultor jurídico e revise os termos de serviço do site de destino ou obtenha as permissões necessárias.





