すべてのWebスクレイピング開発者向けに作成された最も包括的なガイド。
Scrapelessは、大手企業から信頼されるAIを搭載した堅牢でスケーラブルなWebスクレイピングと自動化サービスを提供します。 私たちのエンタープライズグレードのソリューションは、プロジェクトのニーズを満たすように調整されており、全体にわたって専用の技術サポートがあります。 強力な技術チームと柔軟な配達時間を使用すると、データを成功させるためにのみ請求し、制限をバイパスしながら効率的なデータ抽出を可能にします。
あなたのビジネスの成長を促進するために今すぐお問い合わせください。
連絡先の詳細を提供すると、すぐに製品のデモと紹介を提供します。 GDPR標準に準拠して、お客様の情報が機密のままであることを確認します。
この投稿は、Scrapeless MCPサーバーをGitHub Copilot CLIに接続することでそのギャップを埋めます。1つの設定ブロックで、エージェントはGoogle検索、JavaScriptレンダリング、そしてフルクラウドブラウザーを提供し、すべて既存のコード用の自然言語プロンプトを通じてアクセス可能です。
 Ethan Brown
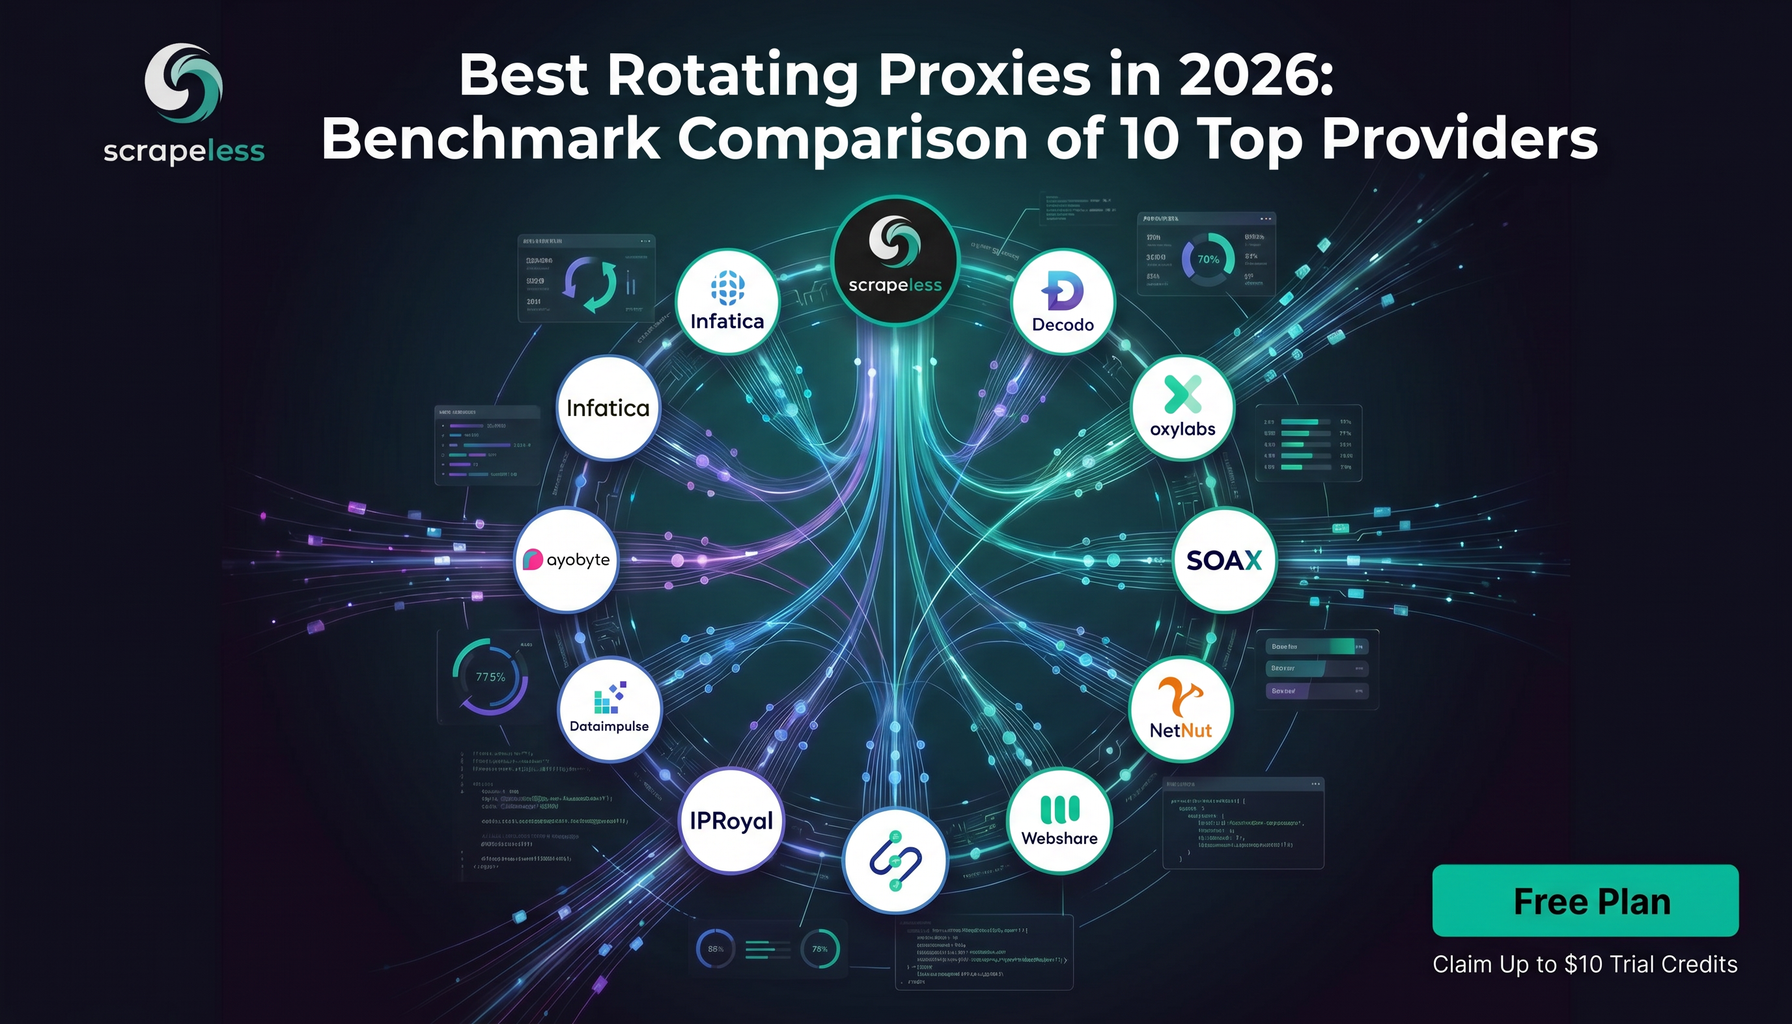
スクレイピングニーズに最適な価値を提供する回転プロキシプロバイダーを見つけましょう。成功率、レイテンシ、プールサイズ、価格を基にして、Scrapeless、Decodo、Oxylabs、SOAX、NetNut、Webshare、IPRoyal、DataImpulse、Rayobyte、Infaticaを比較し、あなたの決定をサポートします。
 Emily Chen
この投稿は、Scrapeless MCPサーバーをQwen Codeに接続することでそのギャップを埋めます。`~/.qwen/settings.json`の1つのブロックがエージェントにGoogle検索、JavaScriptレンダリング、および完全なアンチ検出クラウドブラウザを提供し、すべてが既にコードに対して使用されているのと同じ自然言語プロンプトを通じてアクセス可能です。
 Ava Wilson
このガイドでは、SSLプロキシを正確に定義し、それが機能するためのTLSハンドシェイクを詳述し、フォワードおよびリバースデプロイメントの違いを明確にし、それが示すセキュリティのトレードオフについて正直に述べています。最後に、信頼性の高いデータ収集を目指す場合に、運用自体ではなく管理されたプロキシインフラストラクチャがどのように適合するかについて説明します。
Ethan Brown
このチュートリアルでは、2つの層でPythonパイプラインを構築します。層1はScrapling単体で、静的および中程度に保護されたページに最適なツールです。層2は、Scraplingの`DynamicFetcher`をCDP経由でScrapeless Scraping Browserにルーティングし、レンダリングがクラウド側で住宅プロキシの背後で行われ、セッションごとのアンチ検出フィンガープリンティングが行われる間、Scraplingの解析コードはまったく同じままです。フェッチャーではなくエージェントフレームワークを介して駆動される同じScrapeless Scraping Browserのプリミティブについては、LangChain統合の投稿をご覧ください。
Ava Wilson
スクレイプレス・スクレイピングブラウザはそのギャップを埋めます。これにより、エージェントは195か国以上の住宅用プロキシを備え、JavaScriptレンダリングを内蔵したアンチ検出クラウドブラウザを利用できるようになります。これは、[Scrapeless MCP Server](https://github.com/scrapeless-ai/scrapeless-mcp-server)を通じて、少数の部品化可能なツールとして公開されています。エージェント自体が、シンプルなツール呼び出しを使ってスクレイピングを行います。以下は、実際のスクレイプレス・スクレイパーに基づく、既に機能している8つのユースケースです。
 Sophia Martinez
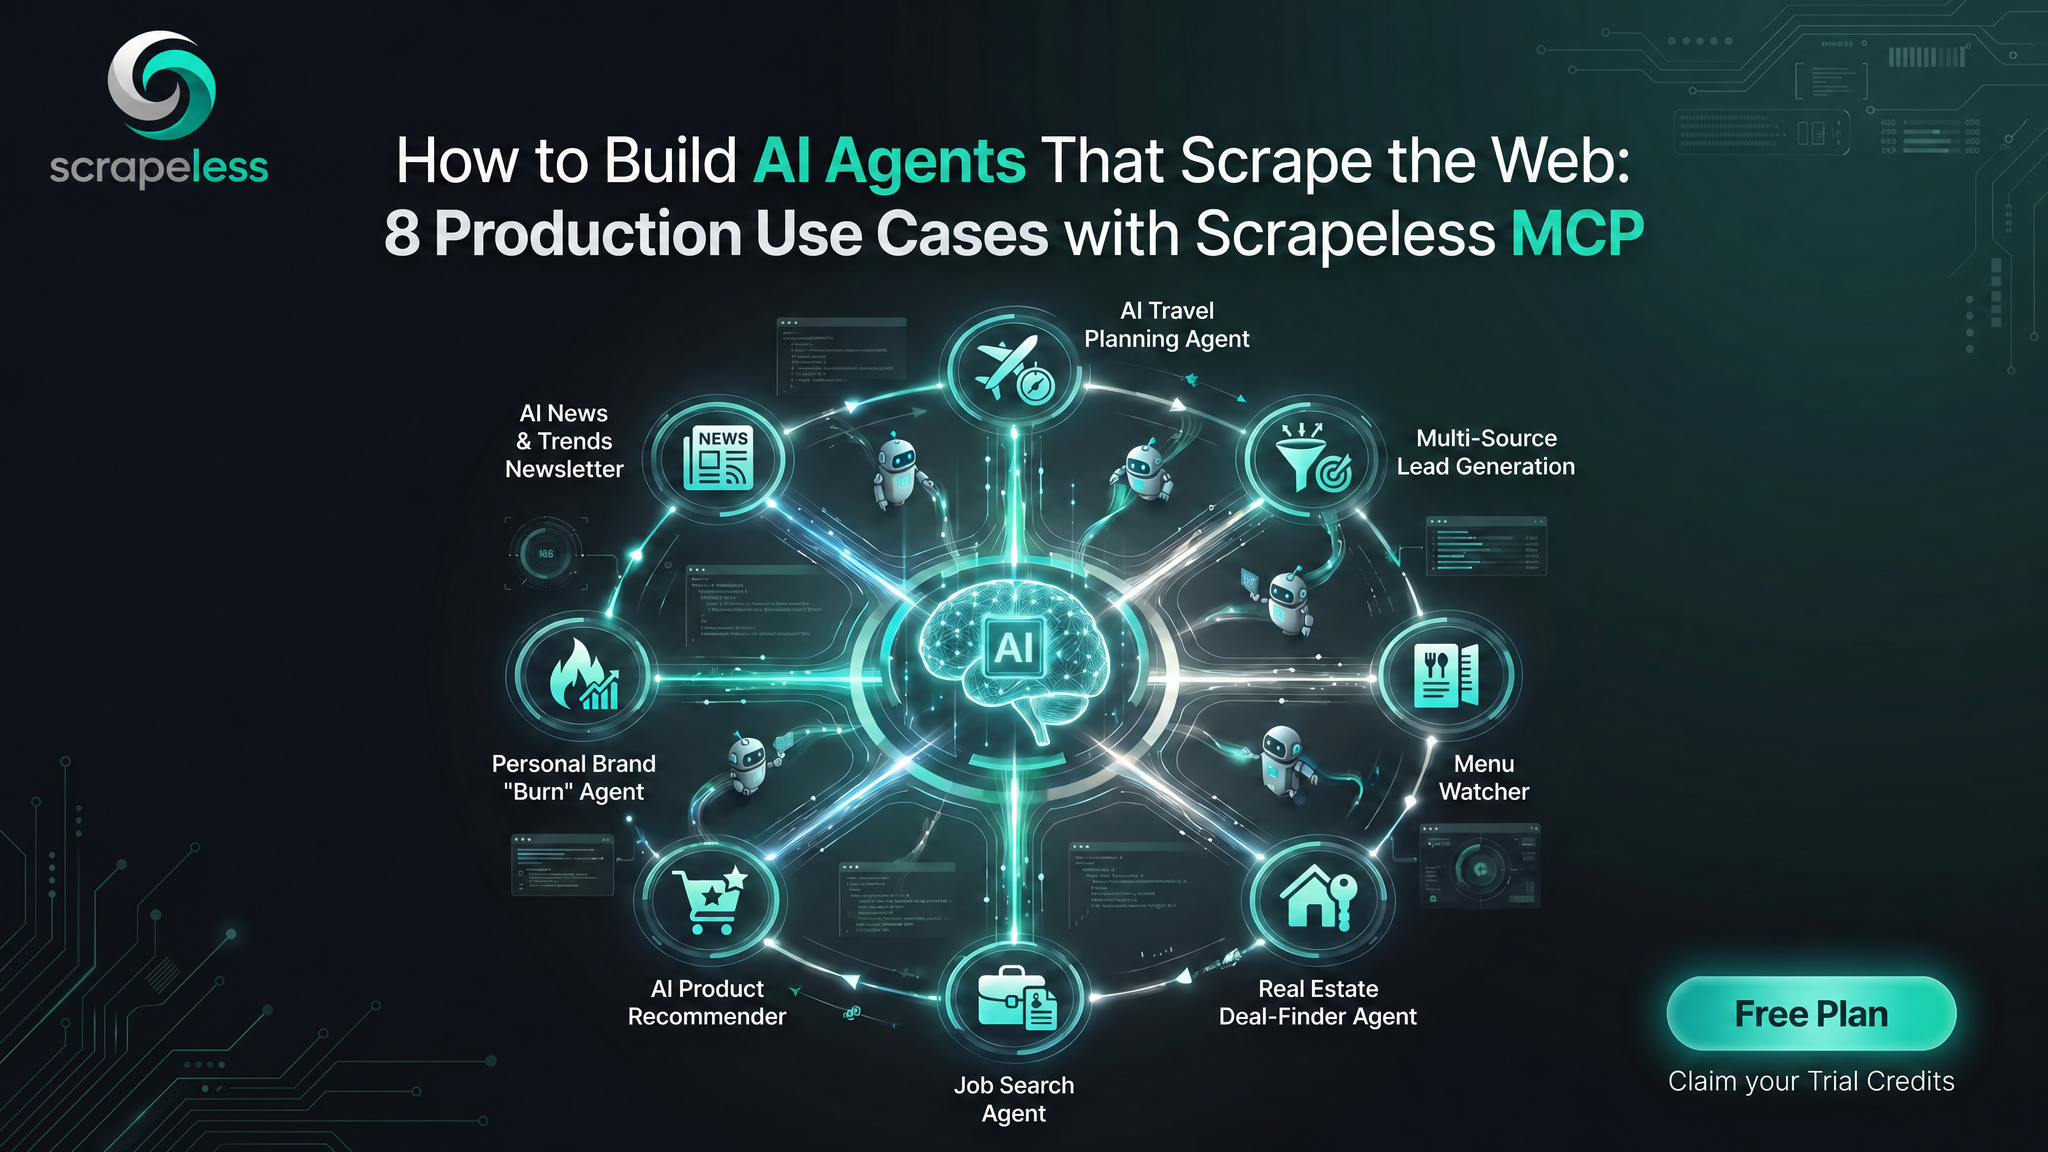
5つのユースケース、1つのツールセット:それぞれは、クラウドブラウザセッションを開き、ページをレンダリングし、エージェントが操作できる構造化されたJSONを返す単一のプロンプトに還元されます。パターンは常に発見、次に抽出です。プロキシ国をオーディエンスに近い場所に固定し、セッション作業を1つのプロンプト内に保持し、欠落しているフィールドをnullableとして扱います。目標に最も近いユースケースから始め、その後、次のもののために同じインストールを再利用します。さらに深いステップバイステップの構築については、Scrapeless MCP Serverの概要を参照し、価格ページでプランを比較してください。
 Michael Lee
この投稿では、そのギャップを埋めるためのターミナルファーストのワークフローについて説明します。Scrapeless Scraping Browserは、レンダリングとアンチデetectionの側面を処理し、NDJSONを出力します。Snowflakeは、データがどれだけ新鮮であるべきかに応じて、4つの異なる方法でそれを取り込みます。例としてのプロデューサーは、公開されたスクレイピングサンドボックスbooks.toscrape.comであるため、以下のすべてのコマンドは再現可能です — 同じパターンがより困難なターゲットにも適用されます(2026年のベストZillowスクレイパーおよび2026年のベストAmazonスクレイパーガイドを参照)。
 Alex Johnson