すべてのWebスクレイピング開発者向けに作成された最も包括的なガイド。
Scrapelessは、大手企業から信頼されるAIを搭載した堅牢でスケーラブルなWebスクレイピングと自動化サービスを提供します。 私たちのエンタープライズグレードのソリューションは、プロジェクトのニーズを満たすように調整されており、全体にわたって専用の技術サポートがあります。 強力な技術チームと柔軟な配達時間を使用すると、データを成功させるためにのみ請求し、制限をバイパスしながら効率的なデータ抽出を可能にします。
あなたのビジネスの成長を促進するために今すぐお問い合わせください。
連絡先の詳細を提供すると、すぐに製品のデモと紹介を提供します。 GDPR標準に準拠して、お客様の情報が機密のままであることを確認します。
SERP APIとLLMスクレイパーはどちらも「検索をスクレイピング」し、JSONを返しますが、計測する対象は異なります。1つはランキングされたリンクとして結果ページを返し、もう1つはAIプラットフォームの合成回答とその引用を返します。
 James Thompson
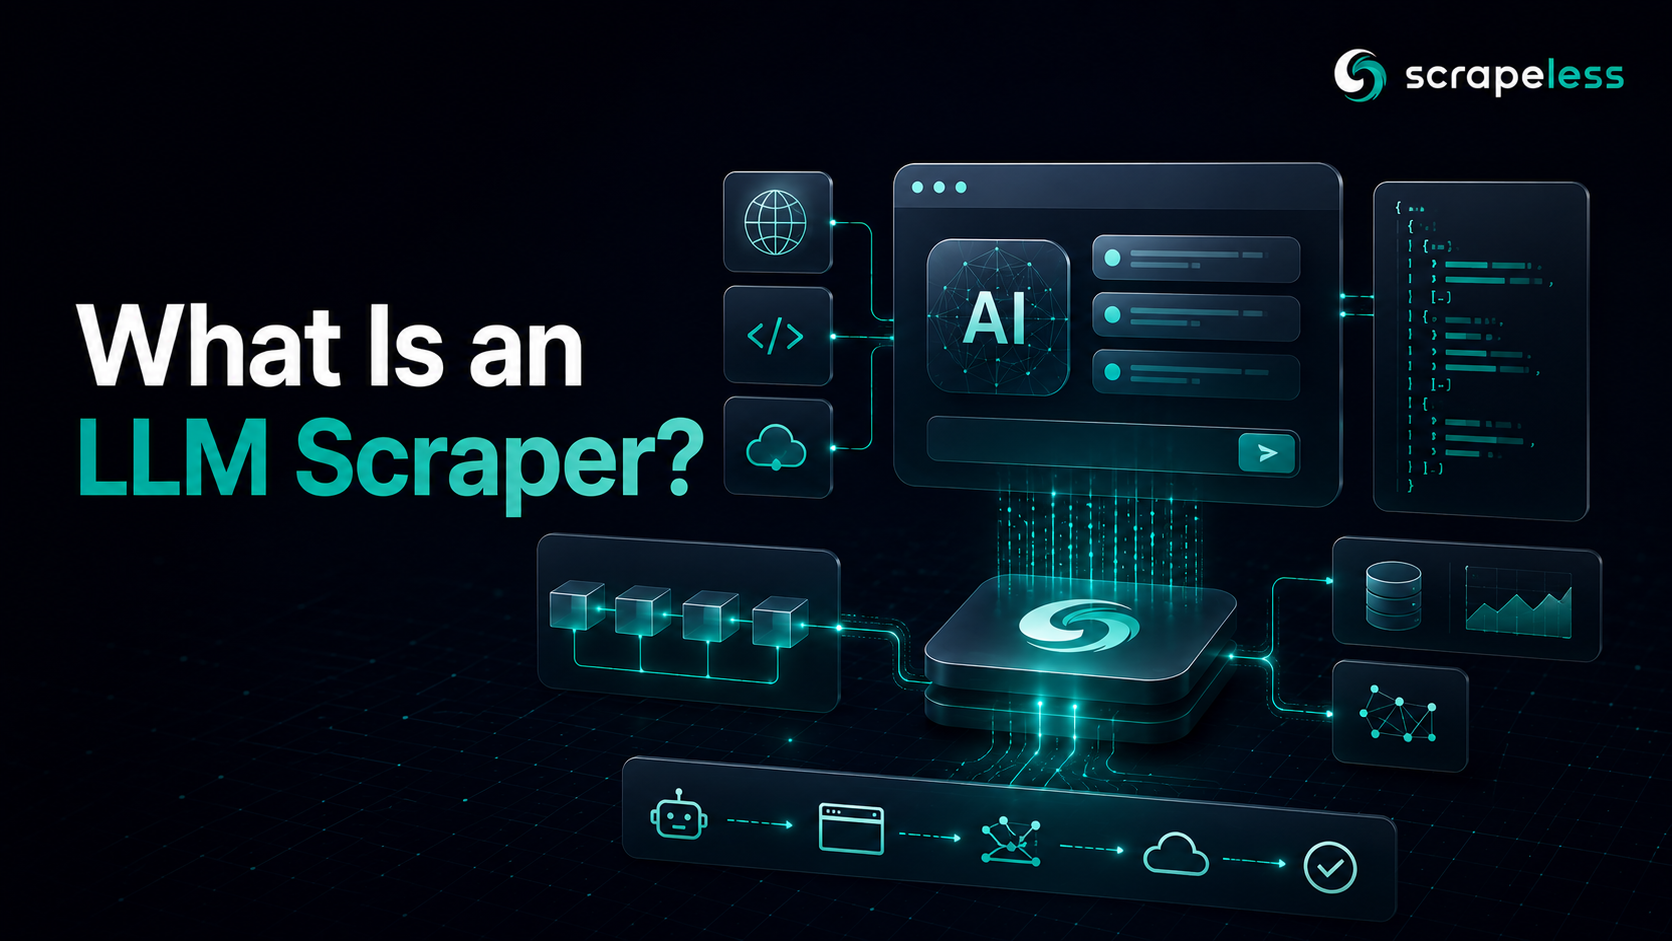
LLMスクレイパーは、ChatGPT、Grok、GeminiなどのLLMプラットフォームの回答を構造化データとしてキャプチャします。モデルの応答に加えて、その引用やメタデータを含むもので、スクリーンショットやコピーしたテキストではなく、JSON形式で返されます。
 Olivia Patel
1つのPOSTがscraper.grokアクターに対してGrokの完全な回答と、出典パネル(オープンウェブページと引用されたX投稿)をそれぞれ別の配列としてキャプチャします。必要な推論モードは、Grokが回答する前にどの程度の深さで推論するかを制御します。
 Sophia Martinez
Perplexityスクレイパーは、回答エンジンのレスポンスを構造化データとしてキャッチします:プロンプトを送信し、引用された完全な回答と、その名前、URL、およびスニペットを含むすべてのソースを取得します。このガイドでは、出力形式と請求モデルに関してScrapelessとBright Dataを比較しています。
 Alex Johnson
この記事では、スクレイピングを行うためのScrapeless Scraper APIを紹介します。これは、反ボット対策、レンダリング、解析を1つのHTTPリクエストに統合する、効率的なアクター基盤のソリューションです。eコマース、検索、AI応答アクターにおけるv1およびv2エンドポイントの実装を説明することで、このモデルが現代の高性能データパイプラインを構築するための開発負担と維持費を大幅に削減することを結論づけています。
Olivia Patel
この記事では、6つの主要なLLM(大規模言語モデル)スクレイピングツールを評価し、それぞれの目的を定義し、インターフェース、モデルカバレッジ、データの深さなどの重要な基準に対して評価します。これは、AI生成の検索回答の進化する環境においてブランドの可視性を監視するという重要なニーズに応えるためです。Scrapelessのように、構造化され、引用を意識したAI回答のキャプチャを提供するツールが、AI駆動の検索時代において効果的な生成エンジン最適化(GEO)と競争情報の取得に不可欠であることを結論付けています。
 Emily Chen
この記事では、Scrapeless MCPサーバーをMastra TypeScriptフレームワークに統合する方法を示し、AIエージェントにリアルタイムのウェブアクセス機能を提供します。21の強力なウェブスクレイピングおよびブラウザ自動化ツールのシームレスな接続について説明し、この統合がMastraエージェントの動的なウェブインタラクション能力を大幅に向上させ、自然言語プロンプトを通じて現代のウェブの課題を克服することを結論づけています。
 Daniel Kim
この記事では、企業の採用信号を公開ウェブソースから抽出するためにScrapeless Scraping Browserを活用した人材市場インテリジェンスパイプラインのアーキテクチャと実装について詳述します。現代のウェブスクレイピングの課題を克服し、このデータを採用の速度やバックフィルプレッシャーなどの実用的な洞察に処理する方法を説明し、企業と役割に関する情報のみに焦点を当てることで、データプライバシーとコンプライアンスを厳格に遵守します。
 Michael Lee