
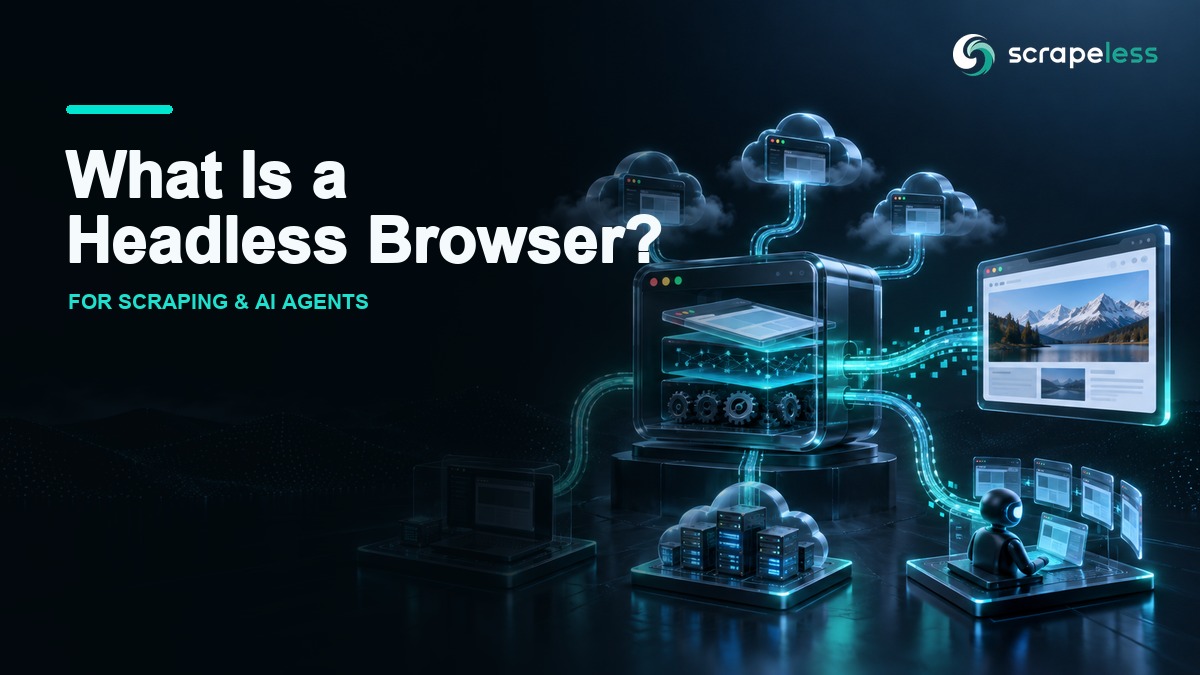
O que é um navegador sem cabeça? Como funciona para raspagem e agentes de IA
Expert in Web Scraping Technologies
TL;DR:
- Um navegador headless é um motor de navegador completo que funciona sem uma janela visível. Ele ainda analisa HTML, aplica CSS, executa JavaScript, cria um DOM, armazena cookies e faz requisições de rede.
- Headless e headful descrevem o modo de exibição, não a capacidade de automação. Puppeteer, Playwright, WebDriver e CDP podem controlar qualquer um dos modos quando o navegador suporta.
- O headless local é o melhor para desenvolvimento e CI; navegadores em nuvem gerenciados adicionam isolamento, roteamento, escalabilidade e observabilidade. A camada certa depende das necessidades operacionais, não se uma janela está visível ou não.
- Agentes de IA precisam de estado e evidências, não apenas um renderizador. Tarefas longas se beneficiam de sessões persistentes, identidade de rede controlada, capturas de tela, logs de console e reprodução.
- A depuração headful deve permanecer no fluxo de trabalho. Um navegador visível ainda é a forma mais clara de inspecionar layout, prompts de consentimento e o tempo de interação antes de mover um trabalho para execução não monitorada.
O Que É um Navegador Headless?
Um navegador headless é um motor de navegador que carrega e renderiza conteúdo da web sem mostrar uma interface gráfica de usuário.
“Headless” não significa “somente HTML.” Navegadores headless modernos executam JavaScript, aplicam CSS, constroem o DOM, carregam subrecursos, gerenciam cookies e armazenamento, e expõem controles de automação. A peça ausente é a janela de aplicação visível.
A documentação oficial do modo Headless do Chrome explica que o Chrome Headless atual compartilha o mesmo código do navegador que o Chrome regular. Esse ponto arquitetônico é importante: o mecanismo de renderização é real, mesmo quando nenhuma janela é pintada na área de trabalho.
Navegadores Headless vs Headful
Os modos headless e headful usam os mesmos conceitos amplos de navegador, mas atendem a diferentes necessidades operacionais.
| Dimensão | Headless | Headful |
|---|---|---|
| Janela visível | Não | Sim |
| Uso em servidor e contêiner | Ajuste natural | Requer um ambiente de exibição |
| Depuração interativa | Necessita de logs, rastros, capturas de tela ou visualização remota | Inspeção visual direta |
| Automação CI | Padrão comum | Útil para reprodução direcionada |
| Tarefas de captura de tela e PDF | Programável e repetível | Possível, mas menos conveniente em escala |
| Fluxos sensíveis a GPU ou visualização | Deve ser validado com cuidado | Mais fácil de inspecionar |
Nenhum dos modos é automaticamente mais capaz. Um navegador headful pode ser automatizado, e um navegador headless pode renderizar uma aplicação complexa do lado do cliente. A decisão é sobre exibição, gerenciamento de recursos e acesso à depuração.
Como os Navegadores Headless São Controlados
Navegadores headless aceitam comandos através de uma superfície de controle, em vez de por uma pessoa usando uma barra de ferramentas visível.
Flags de Linha de Comando
Os navegadores podem expor flags para tarefas pontuais, como imprimir o DOM, tirar uma captura de tela ou salvar um PDF. Isso é útil para diagnósticos e pequenos passos de construção, mas oferece menos controle de fluxo de trabalho do que uma biblioteca de automação.
Bibliotecas de Automação
Puppeteer e Playwright fornecem APIs de alto nível para navegação, seletores, eventos, downloads, interceptação de rede e contextos do navegador. Clients do Selenium usam drivers compatíveis com WebDriver através de múltiplas linguagens e famílias de navegador.
Protocolos de Navegador
Protocols transferem comandos entre um cliente e o navegador. O Protocolo do Chrome DevTools expõe domínios de depuração e automação do Chromium. A especificação W3C WebDriver define uma interface de controle remoto projetada para a interoperabilidade do navegador.
O protocolo não é o mesmo que a biblioteca. Playwright ou Puppeteer fornece ergonomia para desenvolvedores; CDP fornece um modelo de transporte e comando de nível inferior.
Casos Comuns de Uso de Navegador Headless
Um navegador headless é valioso quando um fluxo de trabalho precisa do comportamento de um navegador, mas não de uma janela local.
- Testes automatizados. Exercitar fluxos de usuários, afirmações, formulários e navegação em CI.
- Extração de dados da web. Renderizar JavaScript, revelar conteúdo público carregado de forma preguiçosa e ler o DOM ou respostas de rede resultantes.
- Agentes de navegador de IA. Permitir que um agente inspecione uma página, decida sobre uma ação e continue a partir do mesmo estado da sessão.
- Capturas de tela e PDFs. Produzir capturas visuais repetíveis a partir de configurações de visualização e impressão conhecidas.
- Desempenho e diagnósticos. Coletar evidências de rede, console, tempo e estado da página em uma execução controlada.
- Monitoramento agendado. Verificar a disponibilidade pública, mudanças de conteúdo ou experiências localizadas sem manter uma área de trabalho aberta.
Esses casos de uso compartilham um requisito: o navegador precisa de gerenciamento de ciclo de vida explícito. Um script ou plataforma deve criar o navegador, abrir páginas, esperar por um estado de página significativo, capturar evidências e fechar a sessão.
O Modelo de Três Camadas: Local, Nuvem e Agente
A automação sem cabeça se torna mais fácil de entender quando é dividida em três camadas.
Camada 1: Navegador Sem Cabeça Local
O modo sem cabeça local é executado em uma máquina de desenvolvedor, trabalhador CI, contêiner ou máquina virtual. Ele dá à equipe controle direto sobre a versão do navegador, sistema operacional, dependências e sistema de arquivos.
Use o modo sem cabeça local para fluxos de tamanho unitário, desenvolvimento de testes, aplicativos internos determinísticos e casos onde a propriedade da infraestrutura é aceitável.
Camada 2: Navegador em Nuvem Gerenciado
Um navegador em nuvem gerenciado move processos de navegador, isolamento, roteamento de rede e operações de ciclo de vida para um serviço. O cliente se conecta remotamente e mantém sua API de automação familiar.
Use uma camada gerenciada quando frotas de navegadores, roteamento proxy, acesso geográfico, isolamento de sessão, controles de concorrência ou observabilidade centralizada, de outra forma, se tornariam um projeto de plataforma separado.
Camada 3: Navegador Agente
Um Navegador Agente adiciona estado de tarefa de longa duração e controles voltados para o agente à camada de navegador gerenciado. O navegador se torna uma ferramenta que um agente pode chamar, observar e continuar usando ao longo de várias decisões.
O agente ainda precisa de limites: domínios permitidos, ações permitidas, pontos de aprovação humana, tratamento de segredos e validação de saída. O controle do navegador não torna a conclusão de um agente correta.
Comece a Coletar Dados com Scrapeless
Potencialize seu fluxo de trabalho de coleta de dados e automação com Scrapeless!
Inscreva-se hoje e ganhe $5 em crédito gratuito — nenhum cartão de crédito necessário.Reivindique seu crédito gratuito agora no Painel do Scrapeless.
Por Que Navegadores Sem Cabeça Locais Se Tornam Trabalho Operacional
Um navegador local começa como um processo e se torna um sistema quando a carga de trabalho cresce.
As equipes devem alinhar versões de navegador e biblioteca, empacotar dependências do sistema, manter contêineres saudáveis, limitar o uso de memória e CPU, isolar perfis, coletar logs, expor capturas de tela, roteador de tráfego e limpar processos abandonados. Nenhuma dessas tarefas altera o seletor ou a lógica de extração, mas cada uma afeta se o trabalho é concluído de forma previsível.
O processo do navegador também tem estado. Cookies, cache, trabalhadores de serviço, armazenamento, permissões, downloads e extensões podem cruzar os limites de tarefa se os contextos forem reutilizados descuidadamente. O modelo de contexto de navegação WHATWG descreve como documentos, histórias e contextos de navegação de nível superior se relacionam dentro do navegador.
É por isso que “executar mais navegadores sem cabeça” não é um plano completo de escalonamento. Um design de produção precisa de isolamento, controle de admissão, observabilidade e um ciclo de vida de sessão claro.
Onde o Navegador Agente Scrapeless se Encaixa
O Navegador Agente Scrapeless é uma camada de navegador gerenciada para fluxos de trabalho de coleta de dados e agentes de IA. Ele expõe um ponto de extremidade padrão CDP WebSocket para Puppeteer e Playwright, com roteamento proxy e configurações de sessão na URL da conexão.
Pré-requisito: uma conexão ativa requer uma chave de API Scrapeless em
SCRAPELESS_API_KEY.
javascript
import { chromium } from "playwright-core";

const token = process.env.SCRAPELESS_API_KEY;
if (!token) throw new Error("SCRAPELESS_API_KEY is required");

const endpoint = new URL("wss://browser.scrapeless.com/api/v2/browser");
endpoint.searchParams.set("token", token);
endpoint.searchParams.set("sessionTTL", "180");
endpoint.searchParams.set("proxyCountry", "US");

const browser = await chromium.connectOverCDP(endpoint.toString());
const context = browser.contexts()[0];
const page = context.pages()[0] ?? (await context.newPage());
await page.goto("https://example.com", { waitUntil: "domcontentloaded" });
console.log({ title: await page.title(), url: page.url() });
await browser.close();
O código troca o lançamento de um navegador local por uma conexão CDP. As APIs de navegação e extração permanecem familiares, enquanto o processo do navegador e a saída configurada são executados remotamente.
Limitações dos Navegadores Sem Cabeça
Um navegador sem cabeça resolve renderização e interação. Ele não resolve a correção de dados, autorização ou design de fluxo de trabalho.
A Depuração É Menos Imediata
Sem uma janela visível, logs e artefatos se tornam as evidências. Capture mensagens do console, solicitações falhadas, capturas de tela, instantâneas do DOM e a URL final. Uma visualização ao vivo gerenciada ou reprodução pode encurtar o diagnóstico para fluxos longos.
O Conteúdo Renderizado Pode Ainda Estar Incompleto
As páginas podem depender do estado de login, consentimento, localização, experimentos, histórico do usuário ou ações que não ocorreram. “DOM carregado” é apenas um marco. Aguarde um elemento específico do domínio ou resposta que prove que o conteúdo necessário existe.
A Automação Pode Ser Detectada
Os sites podem avaliar sinais de rede, HTTP, tempo de execução e comportamentais. O modo sem cabeça é apenas um sinal entre muitos. Trate a identidade como uma sessão coerente, ao invés de uma única bandeira.
O Uso de Recursos É Material
Cada sessão do navegador consome memória, CPU, descritores de arquivo e capacidade de rede. Defina limites de concorrência explícitos e isole páginas não confiáveis.
A Fidelidade Visual Necessita de Testes
Fontes, comportamento da GPU, viewport, emulação de mídia e configurações de impressão podem alterar as capturas. Valide fluxos de trabalho visuais contra imagens de referência e mantenha a inspeção com cabeça disponível.
Quando Usar Depuração com Cabeça
O modo com cabeça é a ferramenta de diagnóstico certa quando a próxima ação depende do que uma pessoa pode ver.
Mantenha um caminho com cabeça para:
- construir e apertar seletores;
- entendendo um fluxo de consentimento ou autenticação;
- inspecionando comportamento de arrastar, passar o mouse, foco e teclado;
- validando capturas de tela sensíveis a pixels;
- reproduzindo um problema com o DevTools aberto;
- confirmando que o estado da automação corresponde ao estado visível para o usuário.
Uma vez que o comportamento é entendido, mova o caminho estável para a execução headless e mantenha capturas de tela, rastreamentos e logs como evidência.
Tabela de Decisão
| Necessidade | Headless local | Navegador em nuvem gerenciado | Navegador Agente |
|---|---|---|---|
| Desenvolvimento local rápido | Melhor ajuste | Opcional | Opcional |
| Testes CI padrão | Melhor ajuste | Útil em larga escala | Raramente necessário |
| Roteamento geográfico | Infraestrutura manual | Projetado para isso | Projetado para isso |
| Muitas sessões isoladas | Carga operacional | Melhor ajuste | Melhor ajuste |
| Tarefas longas de múltiplas etapas | Manipulação de estado personalizada | Dependente de sessão | Melhor ajuste |
| Logs centrais e replay | Ferramentas personalizadas | Capacidade comum | Necessidade operacional central |
| Chamadas de ferramentas em linguagem natural | Adicionar uma camada de agente | Adicionar uma camada de agente | Caso de uso nativo |
Escolha a menor camada que satisfaça a tarefa. Um navegador headless local é excelente quando a equipe controla o ambiente. Um navegador gerenciado é valioso quando a infraestrutura se torna o gargalo. Um Navegador Agente é útil quando um sistema de raciocínio deve possuir uma sessão de navegador persistente e observável.
Conclusão
Um navegador headless é um navegador sem uma janela visível, não um renderizador reduzido. A escolha de design importante é onde ele é executado e quem possui seu estado, rota de rede, isolamento e evidências.
Use a documentação do Navegador Agente para o contrato de conexão atual, compare as opções de conta na página de preços e veja como uma integração guiada por prompt utiliza a mesma camada de navegador no Guia Hermes e Scrapeless.
Pronto para Construir Automação de Navegador Observável?
Junte-se à comunidade Scrapeless para discutir o ciclo de vida do navegador, conexões CDP e design de sessão de agente: Discord · Telegram.
Inscreva-se em app.scrapeless.com e conecte um fluxo existente do Puppeteer ou Playwright ao Navegador Agente.
FAQ
Q: Um navegador headless é um navegador real?
Sim. Um navegador headless moderno usa um motor de navegador real para analisar HTML, aplicar CSS, executar JavaScript, renderizar páginas e gerenciar o estado do navegador sem exibir uma janela de desktop.
Q: O modo headless é mais rápido do que o modo headful?
O modo headless pode reduzir a sobrecarga de exibição, mas o desempenho depende da página, versão do navegador, hardware, flags e carga de trabalho. Meça o fluxo exato em vez de assumir uma porcentagem universal.
Q: Os sites podem detectar navegadores headless?
Os sites podem analisar muitos sinais na rede, HTTP, tempo de execução e camadas de comportamento. O modo headless pode contribuir para a detecção, mas não é o único sinal.
Q: A coleta de dados da web deve usar modo headless ou headful?
Use o modo headful para construir e depurar o fluxo, depois use o modo headless para execução não supervisionada uma vez que seletores, esperas, estado e verificações de saída estejam estáveis.
Q: Qual é a diferença entre um navegador em nuvem e um navegador headless?
Headless descreve o modo de exibição. Um navegador em nuvem descreve onde o navegador é executado e quem gerencia o processo, isolamento, rede e ferramentas operacionais.
Q: O Navegador Agente pode funcionar sem um agente de IA?
Sim. Puppeteer ou Playwright podem se conectar diretamente através do CDP e controlar a sessão com código de aplicação comum.
Na Scorretless, acessamos apenas dados disponíveis ao público, enquanto cumprem estritamente as leis, regulamentos e políticas de privacidade do site aplicáveis. O conteúdo deste blog é apenas para fins de demonstração e não envolve atividades ilegais ou infratoras. Não temos garantias e negamos toda a responsabilidade pelo uso de informações deste blog ou links de terceiros. Antes de se envolver em qualquer atividade de raspagem, consulte seu consultor jurídico e revise os termos de serviço do site de destino ou obtenha as permissões necessárias.





