
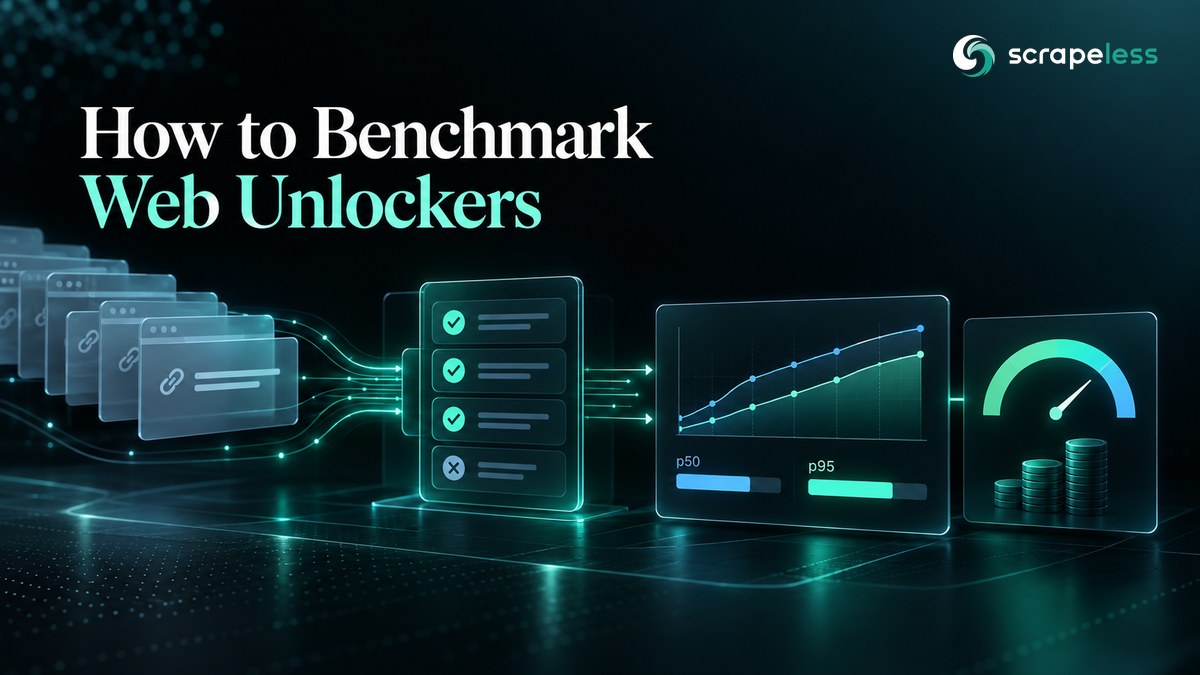
Como Avaliar Desbloqueadores da Web: Um Design de Teste Reproduzível
Senior Cybersecurity Analyst
TL;DR:
- Um benchmark de destravamento da web deve medir conteúdo utilizável, não apenas o status HTTP. Uma resposta pode ser tecnicamente bem-sucedida enquanto contém uma página de desafio, um shell vazio, uma região errada ou um render incompleto.
- A amostra de URL deve ser estratificada antes do teste. Separe páginas estáticas, páginas renderizadas no servidor, aplicações JavaScript, redirecionamentos e desafios de validação de tráfego para que uma categoria fácil não oculte outra.
- A latência precisa de uma distribuição. Relate a mediana e um percentil alto ao lado das taxas de resposta e sucesso de conteúdo.
- O custo efetivo depende de entregas utilizáveis. Divida o gasto observado pelas respostas que passam nas verificações de conteúdo, não pelas tentativas enviadas.
- A reprodutibilidade vem de um manifesto. Registre a categoria de URL, o marcador esperado, a exigência de renderização, a região, as configurações de solicitação e o código de medição para cada célula de teste.
Introdução: Um Benchmark É um Contrato de Teste
Um benchmark de destravamento da web falha quando “sucesso” significa apenas que um endpoint retornou uma resposta.
A questão útil é se o serviço entregou o conteúdo público pretendido em uma forma que o parser subsequente pode usar. Isso requer um contrato de teste: URLs conhecidas, rótulos de categoria, marcadores de conteúdo esperados, configurações de solicitação consistentes, contagens de amostra limitadas e uma regra de pontuação decidida antes que os resultados sejam visíveis.
Este guia constrói esse contrato para Scrapeless Web Unlocker. Ele usa o atual unlocker.webunlocker ator e a superfície POST /api/v2/unlocker/request, mas o design é portátil para qualquer serviço de desbloqueio gerenciado.
O Que Um Destravador da Web Faz
Um destravador da web aceita uma URL de destino e retorna o conteúdo da página pública após gerenciar o trabalho de rede e navegador exigido por essa solicitação.
Isso é diferente de fornecer um endereço de proxy. Um proxy muda o caminho da rede; a aplicação chamadora ainda controla cabeçalhos, execução do navegador, cookies, verificações de completude da página e análise de resposta. Um destravador da web gerenciado aceita uma solicitação de nível superior e retorna conteúdo através de uma API.
Scrapeless Web Unlocker aceita objetos actor, input e proxy. O endpoint atual suporta o ator unlocker.webunlocker, uma URL de destino, um método HTTP, controle de redirecionamento, cabeçalhos de solicitação opcionais e um país de proxy. O produto pode retornar HTML, JSON, Markdown ou uma captura de tela, e apenas solicitações bem-sucedidas são cobradas.
O benchmark deve avaliar o artefato entregue, não inferir a qualidade da infraestrutura usada para obtê-lo.
Defina o Sucesso Antes de Enviar Solicitações
Um resultado de benchmark deve passar por quatro verificações independentes.
- Sucesso no transporte. A solicitação da API Scrapeless é concluída com um status HTTP bem-sucedido sob o padrão de semântica HTTP.
- Identidade do alvo. A resposta corresponde à URL pretendida ou a uma URL final permitida.
- Sucesso do conteúdo. Um marcador específico do alvo aparece e um marcador de página de bloqueio conhecido não aparece.
- Completude. O corpo entregue contém a seção requerida, o limite de contagem de registros ou o elemento renderizado para aquele caso de teste.
Mantenha essas verificações separadas no resultado bruto. Um sucesso no transporte com um marcador de conteúdo ausente não é uma entrega utilizável. Um marcador válido com a localidade errada também é uma falha quando a geografia faz parte do requisito.
Construa uma Amostra de URL Estratificada
Um benchmark de destravamento da web reprodutível começa com categorias que representam a carga de trabalho de produção.
| Categoria | O que testa | Campos do manifesto |
|---|---|---|
| Controle estático | Roteamento básico e integridade da resposta | URL, marcador de título esperado |
| Página renderizada no servidor | Entrega de HTML de uma aplicação normal | URL, marcador de cabeçalho estável |
| Página renderizada em JavaScript | Execução do navegador e conteúdo hidratado | URL, marcador renderizado, exigência de renderização |
| Caminho de redirecionamento | Manuseio da URL final | URL inicial, URL final permitida |
| Página de validação de tráfego | Manuseio de acesso gerenciado | URL, marcador de conteúdo esperado, marcadores de desafio conhecidos |
| Página regional | Entrega geo-específica | URL, país de proxy, marcador de localidade |
Não extraia todas as URLs de um único domínio ou de uma única classe de dificuldade. Se a carga de trabalho de produção for e-commerce, notícias, busca e documentação, mantenha esses grupos visíveis nos resultados. Cada grupo deve contribuir com o mesmo número de solicitações ou receber um peso de produção explícito.
O manifesto do benchmark deve estar sob controle de versão. Uma linha deve incluir case_id, category, url, expected_marker, blocked_markers, proxy_country, redirect e render_required. Isso faz com que comparações posteriores usem os mesmos alvos e lógica de pontuação.
Respeite os termos e políticas de acesso de cada alvo. O Protocolo de Exclusão de Robôs define uma maneira padrão de os proprietários de sites comunicarem preferências de rastreamento, mas não substitui a revisão legal ou a autorização específica do site.
Enviar um Pedido Controlado de Desbloqueio da Web
O pedido atual de Desbloqueio da Web utiliza um endpoint e uma chave de API no cabeçalho x-api-token.
Nota: O bloco de referência requer uma chave de API Scrapeless e o pacote Python
requests. Execute-o na conta cuja utilização e exportação de faturamento serão analisadas.
python
import csv
import os
import statistics
import time
from pathlib import Path

import requests

ENDPOINT = "https://api.scrapeless.com/api/v2/unlocker/request"
API_KEY = os.environ["SCRAPELESS_API_KEY"]
SAMPLES_PER_CASE = 3

CASES = [
    {
        "case_id": "static-control",
        "category": "static",
        "url": "https://example.com",
        "expected_marker": "Example Domain",
        "proxy_country": "ANY",
        "redirect": False,
    },
    {
        "case_id": "html-control",
        "category": "server-rendered",
        "url": "https://httpbin.io/html",
        "expected_marker": "Herman Melville",
        "proxy_country": "ANY",
        "redirect": False,
    },
    {
        "case_id": "js-page",
        "category": "javascript",
        "url": "https://quotes.toscrape.com/js/",
        "expected_marker": "Quotes to Scrape",
        "proxy_country": "ANY",
        "redirect": False,
    },
    {
        "case_id": "redirect-control",
        "category": "redirect",
        "url": "https://httpbin.io/redirect/1",
        "expected_marker": "url",
        "proxy_country": "ANY",
        "redirect": True,
    },
]


def run_case(case):
    payload = {
        "actor": "unlocker.webunlocker",
        "input": {
            "url": case["url"],
            "method": "GET",
            "redirect": case["redirect"],
        },
        "proxy": {"country": case["proxy_country"]},
    }
    started = time.perf_counter()
    response = requests.post(
        ENDPOINT,
        headers={
            "Content-Type": "application/json",
            "x-api-token": API_KEY,
        },
        json=payload,
        timeout=120,
    )
    elapsed_ms = round((time.perf_counter() - started) * 1000, 1)
    response.raise_for_status()
    body = response.text
    return {
        "case_id": case["case_id"],
        "category": case["category"],
        "elapsed_ms": elapsed_ms,
        "api_status": response.status_code,
        "body_bytes": len(response.content),
        "marker_found": case["expected_marker"] in body,
    }


rows = []
for case in CASES:
    for sample in range(1, SAMPLES_PER_CASE + 1):
        row = run_case(case)
        row["sample"] = sample
        rows.append(row)

Path("benchmark-results.csv").write_text("", encoding="utf-8")
with open("benchmark-results.csv", "w", newline="", encoding="utf-8") as handle:
    writer = csv.DictWriter(handle, fieldnames=rows[0].keys())
    writer.writeheader()
    writer.writerows(rows)

latencies = [row["elapsed_ms"] for row in rows]
usable = [row for row in rows if row["marker_found"]]
print({
    "requests": len(rows),
    "usable_deliveries": len(usable),
    "response_rate": len(rows) / len(rows),
    "content_success_rate": len(usable) / len(rows),
    "latency_p50_ms": statistics.median(latencies),
    "result_file": "benchmark-results.csv",
})
O exemplo é intencionalmente pequeno e público. Expanda-o com alvos de produção autorizados somente após as regras de estrutura e pontuação estarem estáveis.
Comece a Capturar com Scrapeless
Potencialize seu fluxo de trabalho de captura e automação da web com Scrapeless!
Inscreva-se hoje e ganhe $5 em crédito gratuito — sem necessidade de cartão de crédito.Aproveite seu crédito gratuito agora no Painel Scrapeless.
Medir a Taxa de Resposta e o Sucesso do Conteúdo Separadamente
A taxa de resposta mede se a API foi concluída com sucesso. A taxa de sucesso do conteúdo mede se o artefato retornado passou nas verificações específicas do alvo.
Use essas fórmulas:
- Taxa de resposta = respostas bem-sucedidas da API / total de pedidos.
- Taxa de sucesso do conteúdo = respostas que passaram nas verificações de identidade, marcador, página de bloqueio e completude / total de pedidos.
- Qualidade do conteúdo condicional = entregas utilizáveis / respostas bem-sucedidas da API.
A terceira razão explica se o serviço retorna conteúdo tecnicamente bem-sucedido, mas inutilizável. Mantenha a razão bruta para cada verificação de conteúdo falhada, como missing_marker, known_challenge_marker, wrong_final_url ou below_record_floor.
Um marcador de texto fixo é apenas o ponto de partida. Para uma grade de produtos, exija pelo menos um contêiner de produto estável e os campos que o esquema downstream precisa. Para uma página JavaScript, assegure um elemento hidratado em vez de um cabeçalho de shell que exista antes da renderização.
Relatar Latência como p50 e p95
A latência deve ser relatada como uma distribuição porque uma média única oculta a borda lenta da carga de trabalho.
Registre o tempo decorrido desde imediatamente antes do pedido da API até que o corpo completo da resposta esteja disponível. Relate p50 para o pedido típico e p95 para a borda mais lenta. O modelo de Tempo de Navegação W3C explica por que a navegação contém fases de tempo distintas, mas um benchmark de API externo deve usar um único relógio de ponta a ponta consistente, a menos que o provedor exponha dados de fase comparáveis.
Calcule percentis para toda a amostra e por categoria. Um resultado estático forte não deve ocultar uma distribuição JavaScript ou regional fraca. Publique o tamanho da amostra ao lado de cada percentil e evite comparar percentis produzidos por diferentes métodos de cálculo.
Documente o método quantil ao lado do resultado para que outro operador possa reproduzir os mesmos cálculos de p50 e p95. A documentação de estatísticas do Python torna a escolha do método explícita e é uma referência neutra útil ao documentar esse cálculo.
Calcular o Custo Efetivo por Entrega Utilizável
O custo efetivo converte faturamento em um resultado de carga de trabalho.
Use a fatura ou exportação de uso para a janela de medição em vez de multiplicar pedidos por um preço copiado de uma página de marketing. Em seguida, calcule:
effective cost per usable delivery = observed spend / usable deliveries
Se o pipeline de produção extrair registros, adicione uma segunda medida:
effective cost per accepted record = observed spend / records passing schema checks
Isso mantém o benchmark alinhado com a tarefa de negócios. Um preço de pedido mais baixo não ajuda quando a resposta carece dos campos que o pipeline necessita. O Scrapeless cobra apenas pedidos de Desbloqueio da Web bem-sucedidos, mas o benchmark ainda deve aplicar sua própria definição de qualidade de conteúdo antes de considerar uma entrega utilizável.
Verificar a Completude do JavaScript
A completude do JavaScript mede se o conteúdo retornado inclui o estado produzido após a execução do cliente.
Escolha um elemento estável que aparece apenas após o aplicativo ser renderizado. Registre seu seletor ou marcador de texto no manifesto. Um teste mais rigoroso também verifica uma contagem mínima de registros e um campo que é populado a partir dos dados renderizados em vez do HTML inicial.
Não use apenas o tamanho do corpo. Texto de consentimento, chrome de navegação ou um documento de desafio podem ser grandes sem conter os dados-alvo. Combine o tamanho com as afirmações estruturais.
Para saída de captura de tela, defina uma região visual e um elemento esperado antes da execução. Capturas de tela são evidências úteis, mas precisam de uma afirmação humana ou visual para se tornarem um resultado pontuado.
Mantenha o Experimento Reproduzível
Um experimento reprodutível registra detalhes suficientes para que outro operador reexecute a mesma matriz.
Armazenar:
- o manifesto e sua versão;
- o script de benchmark e o arquivo de bloqueio de dependências;
- configurações de solicitação, país do proxy e política de redirecionamento;
- carimbos de data/hora de início e fim nos dados brutos;
- status da resposta, URL final quando disponível, tempo decorrido e tamanho do corpo;
- cada afirmação de conteúdo e razão de falha;
- o método de percentil e código de aglomeração;
- a exportação de uso ou faturamento usada para cálculos de custo efetivo.
Execute provedores em uma ordem equilibrada ao comparar mais de um serviço. As condições do domínio mudam ao longo do tempo, portanto, completar todas as solicitações para um serviço antes de iniciar outro pode introduzir um viés de tempo. Mantenha a concorrência fixa e pequena o suficiente para que o benchmark meça o serviço em vez de um gargalo do lado do cliente.
Leia os Resultados Sem Superestimar
Um benchmark de desbloqueio da web descreve as URLs escolhidas, configurações, localização e janela de medição.
Relate resultados por categoria antes de uma pontuação geral. Inclua intervalos de confiança ou contagens brutas quando a amostra for pequena. Separe casos não suportados de casos falhados. Observe qualquer alvo removido após a execução e preserve a razão, pois mudar silenciosamente o conjunto de URLs quebra a comparabilidade.
Evite afirmações universais, como “funciona em todos os sites”. A conclusão defensável é mais restrita: qual serviço produziu conteúdo utilizável para este manifesto sob essas configurações.
Conclusão: Torne o Conteúdo Utilizável a Unidade de Sucesso
Um benchmark de desbloqueio da web reprodutível começa com um manifesto e termina com entregas utilizáveis. Estratifique o conjunto de URLs, defina afirmações de conteúdo, meça o sucesso da resposta e do conteúdo separadamente, relate a latência p50 e p95, e calcule o custo a partir do gasto observado por saída aceita.
Revise preços do Scrapeless, siga a atual documentação do Web Unlocker, e use o guia da API Scraper para colocar o experimento dentro de um pipeline de dados mais amplo.
Pronto para Medir o Web Unlocker em Sua Carga de Trabalho?
Junte-se à comunidade Scrapeless para comparar experimentos de coleta de dados reprodutíveis: Discord · Telegram.
Crie uma conta gratuita em app.scrapeless.com e execute o manifesto contra um pequeno conjunto de páginas públicas autorizadas.
FAQ
Q: O que um benchmark de desbloqueio da web deve medir?
Um benchmark de desbloqueio da web deve medir a taxa de resposta da API, taxa de sucesso de conteúdo, distribuição de latência, completude de JavaScript e custo efetivo por entrega utilizável.
Q: Por que HTTP 200 não é suficiente para contar como sucesso?
HTTP 200 apenas descreve o status da resposta. O corpo ainda pode conter a página errada, um documento de validação de tráfego, um shell de aplicativo vazio ou dados alvo incompletos.
Q: Quantas URLs um benchmark deve incluir?
O benchmark deve incluir URLs suficientes para representar cada categoria de produção e relatar incertezas, mas não existe um mínimo universal. Comece com um pequeno manifesto equilibrado, valide a estrutura, e então amplie a amostra autorizada.
Q: Como a latência p95 deve ser calculada?
Calcule p95 com um método quantílico documentado sobre uma amostra claramente definida e publique a contagem de solicitações ao lado do resultado. Use o mesmo método para cada serviço e categoria comparados.
Q: É legal fazer benchmark em sites públicos?
A legalidade depende da jurisdição, propósito, termos alvo e tipo de dado. Use alvos públicos autorizados, minimize a carga, respeite as políticas do site e obtenha aconselhamento jurídico para o uso pretendido na produção.
Q: O Web Unlocker é o mesmo que um proxy?
Não. Um proxy muda a rota da rede, enquanto o Web Unlocker aceita uma solicitação de nível superior e gerencia o acesso à página e o fluxo de entrega de conteúdo por trás de uma API.
Na Scorretless, acessamos apenas dados disponíveis ao público, enquanto cumprem estritamente as leis, regulamentos e políticas de privacidade do site aplicáveis. O conteúdo deste blog é apenas para fins de demonstração e não envolve atividades ilegais ou infratoras. Não temos garantias e negamos toda a responsabilidade pelo uso de informações deste blog ou links de terceiros. Antes de se envolver em qualquer atividade de raspagem, consulte seu consultor jurídico e revise os termos de serviço do site de destino ou obtenha as permissões necessárias.





