Scrapeless – Registro de alterações semanal: 26 de outubro–1.º de novembro de 2026
Web Data Collection Specialist
TL;DR:
- O Google AI Mode Scraper agora oferece suporte a
places. O novo campo retorna informações relacionadas a mapas a partir dos resultados do AI Mode. - Os dados de compras do Perplexity agora incluem preços e fontes de citação de produtos. A saída expandida adiciona contexto para revisar recomendações de produtos geradas por IA.
- As páginas de Alternativas e Soluções da Scrapeless estão no ar. O site agora fornece pontos de entrada dedicados para comparações de plataformas e casos de uso de coleta de dados.
Respostas de IA podem incluir lugares locais, recomendações de produtos e as fontes por trás delas. A versão de 26 de outubro a 1º de novembro amplia como a Scrapeless captura esses tipos de resultados: o Google AI Mode ganha places, enquanto a saída de compras do Perplexity adiciona informações de preço e fontes de citação de produtos. Novas páginas de Alternativas e Soluções também tornam a plataforma mais fácil de explorar.
Google AI Mode Adiciona Informações de Mapa por Meio de Places
O Google AI Mode Scraper agora oferece suporte a um campo places para informações de resultados relacionadas a mapas. A adição ajuda as equipes a manter o contexto de locais junto com a resposta quando o AI Mode retorna esse conteúdo.
Fluxos de trabalho de descoberta local podem usar esses dados para revisar quais lugares aparecem nas respostas de IA e comparar recomendações entre prompts ou mercados. Mantenha as informações de lugar retornadas associadas à consulta e à resposta originais para que o registro retenha seu contexto de coleta.
A referência do Google AI Mode Scraper cobre o contrato mais amplo do mecanismo. Ao projetar um modelo de localização downstream, o vocabulário Place do Schema.org fornece uma referência útil para locais físicos; ele não define o esquema de resposta da Scrapeless.
Perplexity Shopping Adiciona Preços e Fontes de Citação
O Perplexity Scraper agora retorna informações de compra mais ricas, incluindo price e sources. A referência do Perplexity Scraper documenta os campos expandidos:
| Field | Meaning |
|---|---|
shopping.price |
Descrição do preço |
shopping.price_label |
Rótulo do preço |
shopping.merchant |
Comerciante |
shopping.rating |
Avaliação |
shopping.sources |
Fontes de citação do produto |
shopping.sources.index |
Número da citação |
shopping.sources.title |
Título da citação |
shopping.sources.url |
URL da citação |
Esses campos tornam as recomendações de produtos mais fáceis de revisar. Uma equipe pode manter o preço exibido com seu registro de produto e inspecionar as fontes citadas em vez de tratar cada recomendação como um título e link isolados.
As descrições de preço devem permanecer intactas no resultado armazenado. Um preço pode precisar de contexto adicional antes de poder ser comparado com outra oferta. O vocabulário Offer do Schema.org distingue preço, moeda e disponibilidade em dados de comércio; esses conceitos são úteis ao projetar um modelo normalizado separado, sem assumir que todo resultado do Perplexity fornece todos eles.
Comece a Fazer Scraping com a Scrapeless
Turbine seu fluxo de trabalho de web scraping e automação com a Scrapeless!
Cadastre-se hoje e receba US$ 5 em crédito gratuito — sem necessidade de cartão de crédito.Solicite seu crédito gratuito agora no Painel da Scrapeless.
Mantenha a Resposta e Seus Dados Estruturados Juntos
Os novos campos de lugares e compras são mais úteis quando armazenados ao lado da resposta que descrevem. Preserve a resposta original antes de produzir uma visualização simplificada para relatórios.
O padrão de intercâmbio de dados JSON oferece suporte a objetos e arrays para registros estruturados. Manter essas estruturas intactas permite que um aplicativo retenha a relação entre um produto, sua descrição de preço e suas fontes de citação. Um campo opcional ausente deve permanecer distinguível de um valor vazio.
Novas Páginas de Alternativas e Soluções Estão no Ar
O novo hub de Alternativas da Scrapeless reúne o conteúdo de comparação de plataformas em um só lugar. Ele fornece às equipes que estão avaliando um provedor de scraping um ponto de partida dedicado para revisar as comparações disponíveis.
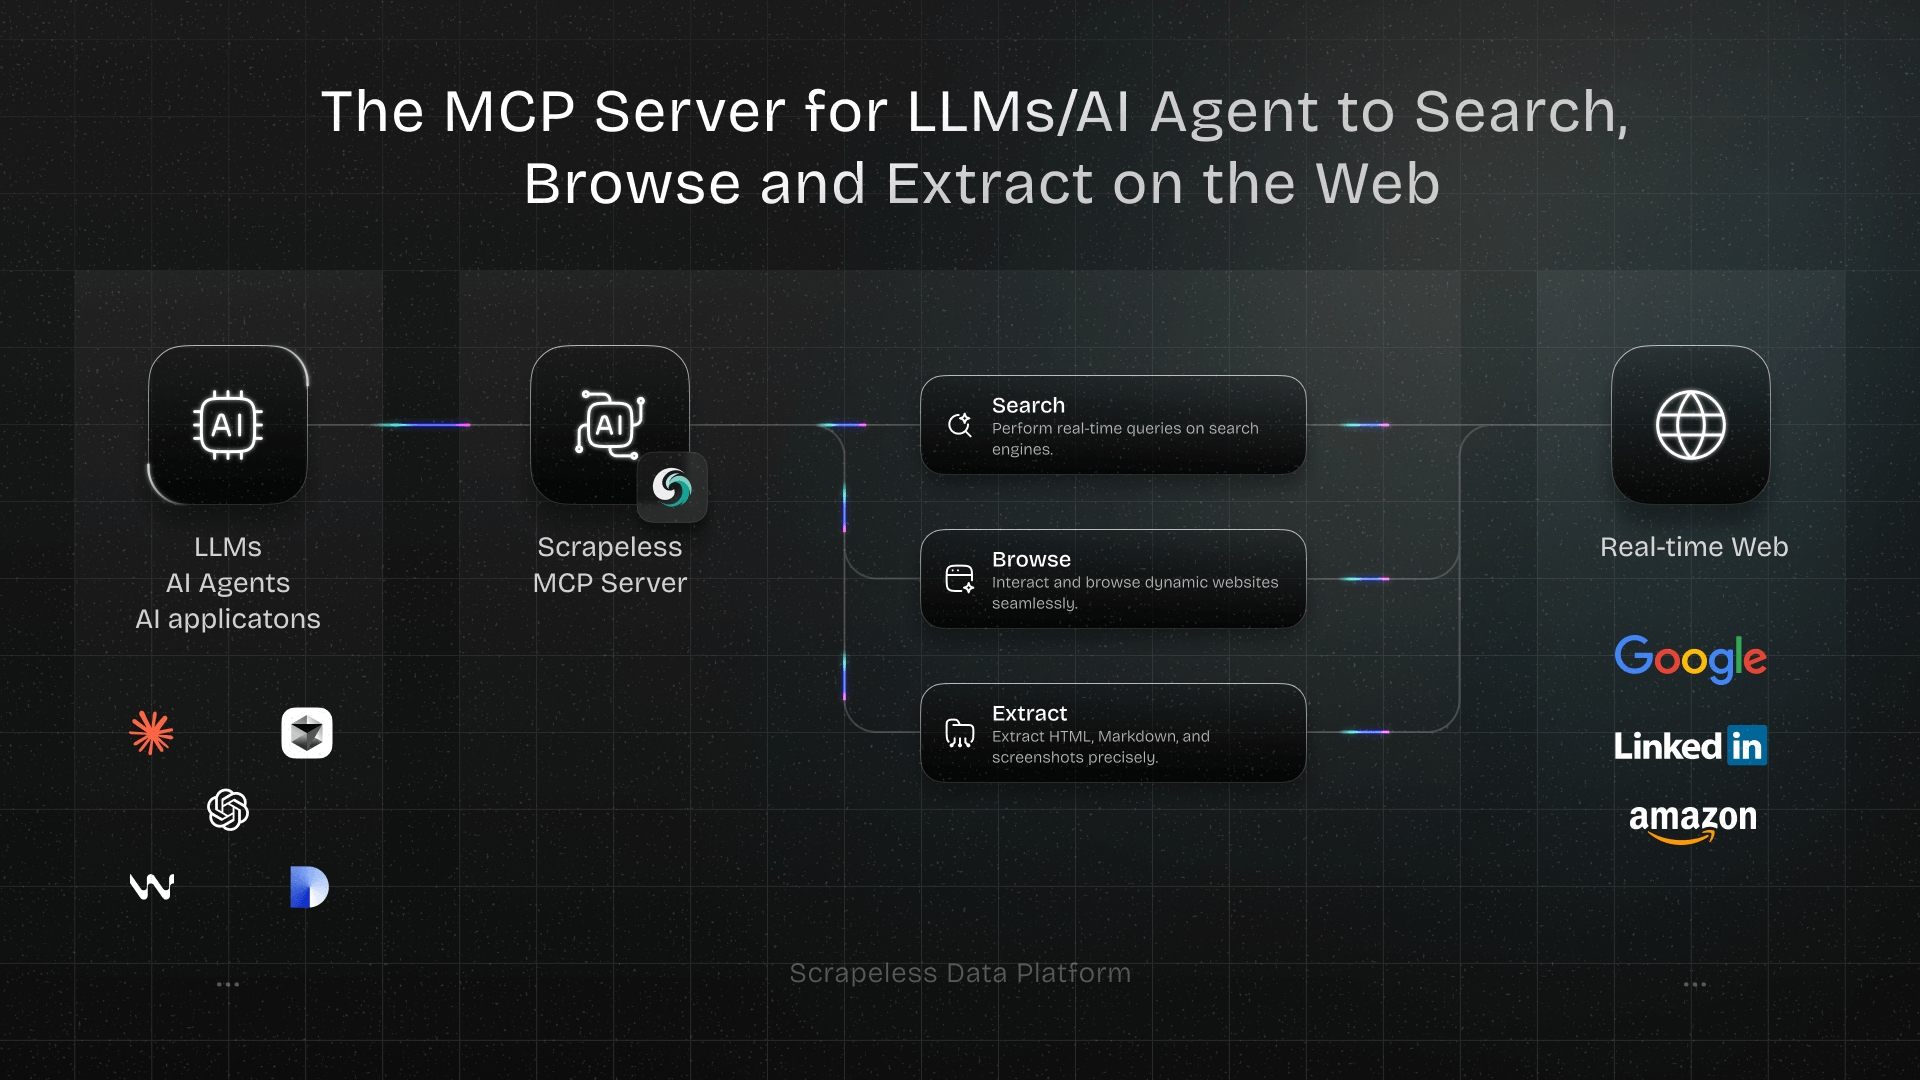
O diretório de Soluções da Scrapeless organiza fluxos de trabalho em torno de Google Search API, Agent Browser, Web Unlocker, Crawl, Proxy Solutions e AI Scraper. As equipes podem começar pela tarefa que precisam concluir e então explorar os respectivos inputs, outputs e responsabilidades de implementação.
Conclusão
A versão desta semana adiciona mais contexto aos dados de respostas de IA. O campo places do Google AI Mode amplia a cobertura de resultados locais, enquanto os acréscimos de compras da Perplexity conectam recomendações de produtos com informações de preço e fontes de citação. Os novos diretórios de site fornecem rotas adicionais para avaliação da plataforma e descoberta de casos de uso.
Explore o AI Scraper e revise os preços da Scrapeless ao planejar o uso em produção. O guia da API de Scraper do TikTok cobre outro fluxo de trabalho de coleta estruturada.
Pronto para Construir com a Scrapeless?
Junte-se a desenvolvedores que estão criando fluxos de trabalho de respostas de IA e dados da web na comunidade Scrapeless: Discord · Telegram.
Cadastre-se em app.scrapeless.com para começar.
FAQ
P: O que o novo campo de lugares do AI Mode fornece?
O campo places fornece informações relacionadas a mapas a partir dos resultados do Google AI Mode.
P: O que mudou na saída de compras da Perplexity?
A saída de compras da Perplexity agora inclui informações de preço e fontes de citação de produtos, com números de citação de fonte, títulos e URLs.
P: Como devo usar o novo diretório de Soluções?
Escolha a coleção de produtos que corresponde à sua tarefa e, em seguida, use sua página de fluxo de trabalho focado e a documentação do produto para planejar a integração. As páginas descrevem fluxos de trabalho que sua equipe pode construir; elas não são executadas automaticamente após o cadastro.
Na Scorretless, acessamos apenas dados disponíveis ao público, enquanto cumprem estritamente as leis, regulamentos e políticas de privacidade do site aplicáveis. O conteúdo deste blog é apenas para fins de demonstração e não envolve atividades ilegais ou infratoras. Não temos garantias e negamos toda a responsabilidade pelo uso de informações deste blog ou links de terceiros. Antes de se envolver em qualquer atividade de raspagem, consulte seu consultor jurídico e revise os termos de serviço do site de destino ou obtenha as permissões necessárias.