
Crie um Monitor de SERP em Python com SQLite e Relatórios CSV
Lead Scraping Automation Engineer
Resumo:
- Um monitor de SERP em Python registra a melhor posição de um domínio nos resultados orgânicos do Google. Este projeto verifica a primeira página retornada para desktop, com configurações explícitas de localização e idioma.
- O SQLite preserva as condições de busca e o histórico de observações. Mantenha o banco de dados entre coletas para que relatórios posteriores possam selecionar uma base de comparação compatível.
- Relatórios em CSV separam mudanças de ranking de problemas de coleta. Um alvo ausente, um array de resultados vazio e uma requisição malsucedida têm significados diferentes.
- Versões salvas de relatórios preservam comparações anteriores. A exportação lê as linhas de relatório armazenadas sem enviar outra requisição de busca.
- O exemplo mantido é uma linha de base, não uma tendência de longo prazo. Três observações de palavras-chave produziram três linhas de relatório, sem rankings anteriores para comparar.
- Gratuito para começar. Cadastre-se em app.scrapeless.com e use o crédito introdutório para testar uma pequena lista de monitoramento.
Introdução: um ranking precisa de seu contexto de busca
Uma observação de ranking no Google pertence a uma consulta, localização, idioma, dispositivo e conjunto de resultados retornados. Registrar uma posição sem essas condições torna a próxima comparação difícil de interpretar.
Este tutorial constrói um monitor de SERP em Python em torno do Scrapeless Google Search API. Você configura uma lista de monitoramento de palavras-chave e um domínio alvo, coleta resultados orgânicos, salva observações no SQLite e exporta um relatório em CSV. A implementação usa a biblioteca padrão do Python e roda em macOS ou Linux.
O caso mantido verifica scrapeless.com para scrapeless, web scraping api e google search api. Sua primeira linha de base contém uma correspondência na posição 3 e duas palavras-chave sem correspondência nos resultados retornados. Para o modelo subjacente de requisição de ator, o guia do Scrapeless Scraper API fornece contexto adicional.
Pipeline em resumo
O monitor de SERP em Python transforma cada consulta configurada em uma observação validada e então armazena a evidência e um relatório versionado.
| Stage | Operation | Output |
|---|---|---|
| Collect | Request the first desktop organic result page | Search response or saved task state |
| Validate | Check structure, positions, and destination links | Usable observation or a data-quality state |
| Match | Compare normalized hostnames | Best returned position for each target |
| Store | Retain request context and observation data | data/rankings.sqlite |
| Report | Select a comparable baseline and save report rows | Versioned report and CSV file |
O relatório de exemplo é output/60c13c8bd553-v1.csv. Seu ID de execução, contagens de resultados e nome de arquivo de saída podem ser diferentes. A lista de monitoramento padrão tem um domínio alvo, então cada uma de suas três palavras-chave contribui com uma linha no CSV.
Por que o Scrapeless Google Search API
O Scrapeless Google Search API fornece resultados de busca estruturados, incluindo posições e links de resultados orgânicos, para o monitor validar e armazenar.
A Google Search API, dentro da família de produtos Scraping API, permite que a requisição especifique país, idioma, domínio de busca e localização. A aplicação pode se concentrar na correspondência de domínios e nas comparações históricas em vez de manter um parser de DOM da página de resultados.
Este projeto lê organic_results; ele não combina anúncios, mapas ou citações de IA em um ranking orgânico. Também não pagina automaticamente. Revise os preços do Scrapeless antes de escolher a lista de monitoramento e a frequência de coleta: collect faz requisições ao serviço, enquanto history e export operam em registros locais.
Pré-requisitos
O monitor precisa de Python 3.9 ou mais recente em macOS ou Linux, suporte integrado a SQLite e HTTPS, e uma chave de API do Scrapeless com acesso ao produto e créditos.
- Use um terminal e um editor de texto puro. Um aplicativo de planilha é útil para ler o CSV.
- Mantenha o banco de dados em armazenamento local. A implementação usa bloqueios de arquivo POSIX.
- Permita acesso HTTPS ao download do projeto, ao painel do Scrapeless e à API.
- Forneça sua própria chave de API para coleta ao vivo. A saída histórica abaixo é mantida do caso de origem; uma nova coleta produzirá seus próprios resultados.
Não são necessários pacotes de terceiros em Python ou serviço de banco de dados separado. O Python expõe o SQLite por meio de sua interface SQLite da biblioteca padrão.
Verifique o tempo de execução antes de baixar o projeto:
bash
python3 --version
python3 -c "import sqlite3, ssl, urllib.request, csv, fcntl; print('Required standard-library modules: OK')"
Etapa 1 — Baixar e Abrir o Projeto
A implementação do monitor de SERP em Python fornece o coletor, a configuração e os comandos de relatório usados abaixo.
Abra o repositório, escolha Code → Download ZIP e extraia o arquivo. Se o acesso for restrito em seu ambiente, use uma conta com acesso ao repositório.
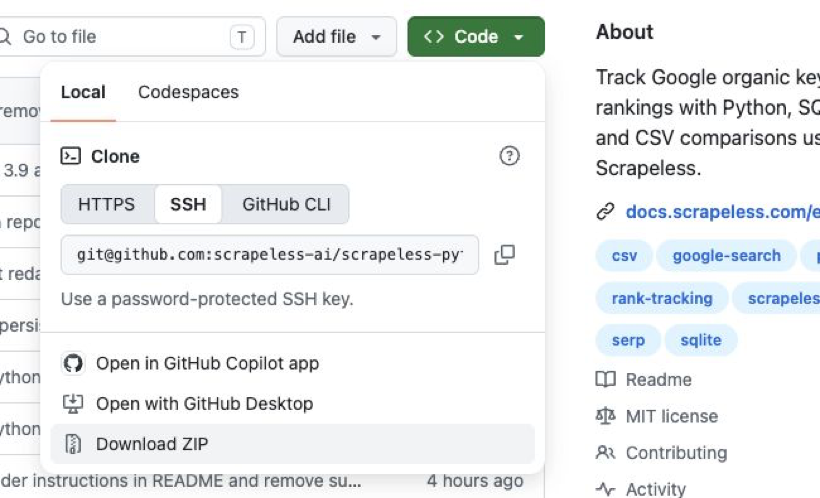
Baixe o arquivo do projeto a partir do menu Code do repositório.
Abra o diretório extraído e confirme que serp_monitor.py, tutorial.py, starter.html e config.json estão presentes.
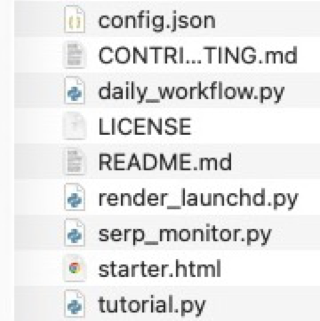
O diretório do projeto extraído. Mantenha os nomes de arquivo originais.
No macOS, digite cd seguido de um espaço no Terminal, arraste a pasta extraída do Finder para o terminal e pressione Return. Execute os comandos restantes a partir desse diretório do projeto.
bash
python3 serp_monitor.py --helpO comando lista collect, history, export e demo. Git e um ambiente virtual são opcionais para essa forma de baixar e executar.
Etapa 2 — Salvar a Chave e Corrigir o Escopo da Pesquisa
A chave da API autentica as requisições, enquanto config.json define as observações que poderão ser comparadas posteriormente.
No painel do Scrapeless, abra Settings → API Key Management e use uma chave válida existente. Crie uma apenas se necessário. As instruções de gerenciamento da chave de API explicam a configuração da conta.
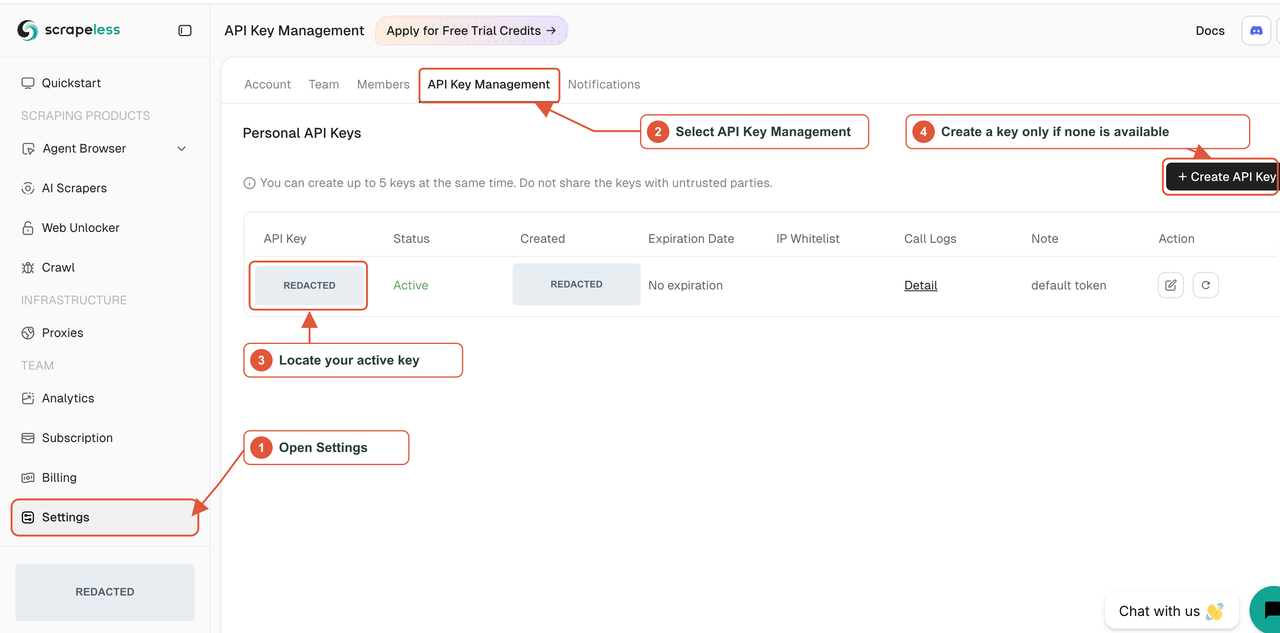
Os pontos de entrada para o gerenciamento de chaves. Credenciais e valores específicos da conta estão ocultos.
Crie o arquivo de chave local sem substituir um existente, restrinja suas permissões e abra-o no editor do macOS:
bash
cp -n .env.example .env
chmod 600 .env
open -e .env
Nota: Substitua o espaço reservado pela sua própria chave no arquivo local. A coleta ao vivo exige essa credencial e créditos disponíveis na conta.
dotenv
SCRAPELESS_API_KEY=YOUR_SCRAPELESS_API_KEYUma variável de ambiente SCRAPELESS_API_KEY existente tem precedência sobre .env. Mantenha o arquivo privado e exclua-o de capturas de tela e arquivos compartilhados.
Abra config.json em um editor de texto simples e preserve ou substitua a seguinte lista de observação:
json
{
  "keywords": ["scrapeless", "web scraping api", "google search api"],
  "target_domains": ["scrapeless.com"],
  "gl": "us",
  "hl": "en",
  "google_domain": "google.com",
  "location": "Austin, Texas, United States"
}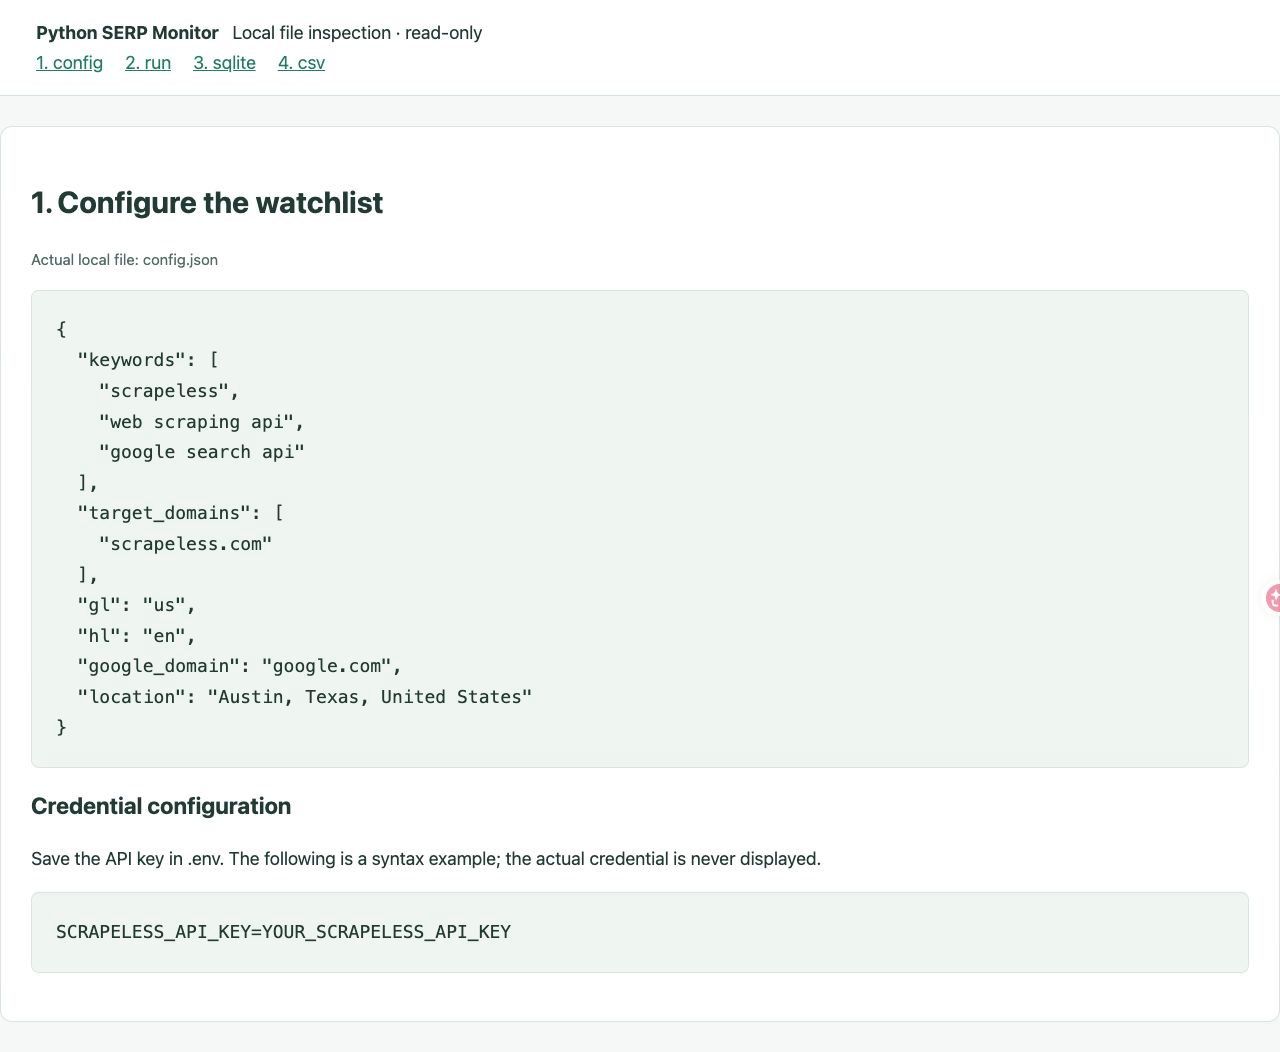
A configuração do caso. A área de credenciais mostra um espaço reservado, não a chave real.
target_domains identifica os hosts a serem encontrados na resposta; ele não limita o Google a retornar apenas esses hosts. gl, hl, google_domain e location definem o país, idioma, domínio e localização da pesquisa. O projeto fixa o dispositivo em desktop e o início da paginação em 0.
Mantenha essas entradas consistentes para comparações posteriores. Uma localização ou idioma diferente inicia um escopo de pesquisa diferente.
Etapa 3 — Coletar a Primeira Observação
O comando collect solicita as pesquisas configuradas, armazena observações e grava o relatório.
Nota: Esse comando requer sua chave de API do Scrapeless e créditos. Ele envia pesquisas reais. A saída mostrada em seguida é mantida do caso original, não uma resposta garantida para uma nova execução.
bash
python3 serp_monitor.py collect --config config.json --env-file .envA execução retida produziu esta saída:
text
Run: 60c13c8bd553
scrapeless: 9 organic results saved
web scraping api: 7 organic results saved
google search api: 9 organic results saved
CSV: output/60c13c8bd553-v1.csv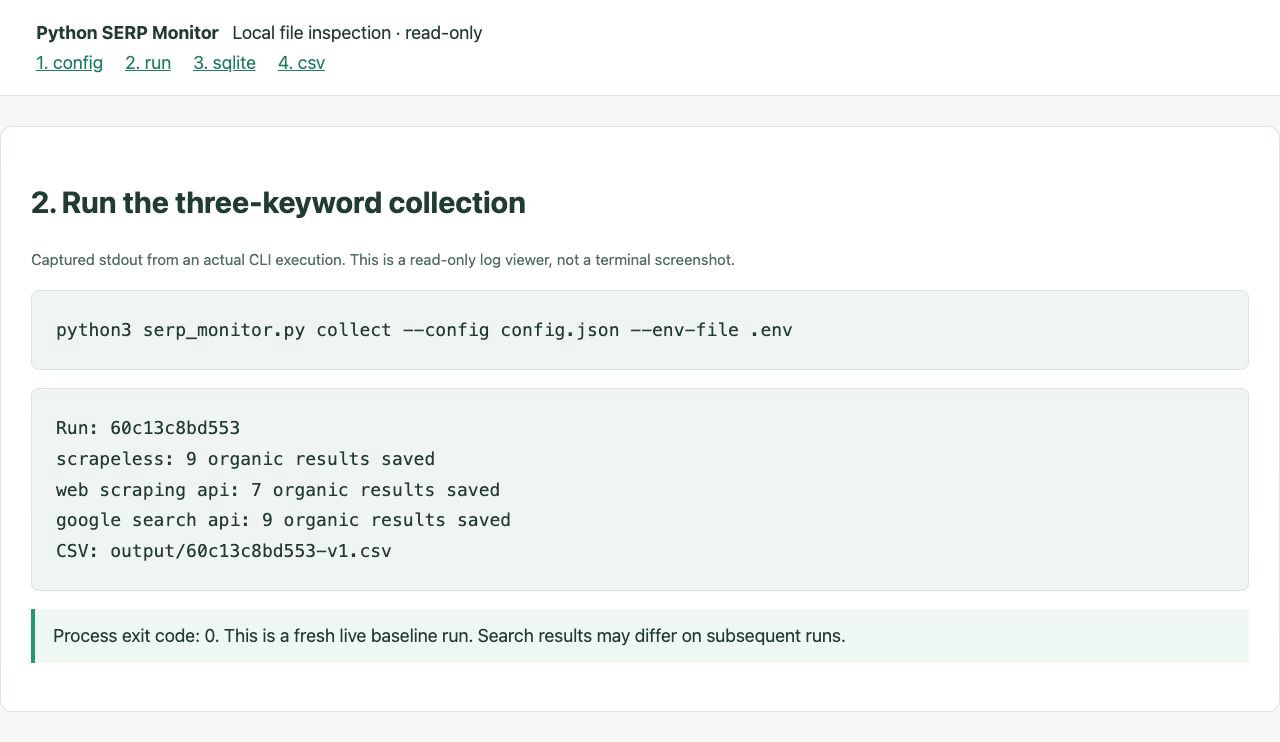
Uma visualização de log somente leitura, não uma captura de tela do terminal. O comando de origem foi concluído com código de saída 0.
A execução salvou observações em data/rankings.sqlite e gravou o caminho do CSV mostrado acima. Essas contagens descrevem resultados orgânicos salvos, não a posição do domínio de destino.
Etapa 4 — Validar Resultados e Fazer Correspondência com o Hostname de Destino
O coletor valida o array orgânico retornado antes de tratar uma correspondência de domínio ou ausência como uma observação bem-sucedida.
Entender o Estado da Requisição e da Tarefa
Para a primeira palavra-chave, o projeto constrói este corpo de requisição. É um exemplo de requisição, não um segundo comando a ser executado:
json
{
  "actor": "scraper.google.search",
  "input": {
    "q": "scrapeless",
    "gl": "us",
    "hl": "en",
    "google_domain": "google.com",
    "location": "Austin, Texas, United States",
    "start": 0,
    "device": "desktop"
  }
}
O projeto envia o corpo para POST https://api.scrapeless.com/api/v1/scraper/request com a chave em x-api-token. O ciclo de vida da requisição da Google Search API distingue um resultado HTTP 200 de uma resposta HTTP 201 contendo um taskId.
O coletor salva um ID de tarefa retornado antes de pesquisar essa tarefa existente. Uma tarefa enviada e uma observação concluída são estados diferentes. Se o envio tiver um resultado incerto e nenhum ID de tarefa tiver sido salvo, o aplicativo deixa essa incerteza visível em vez de criar silenciosamente outra pesquisa.
Um código de resposta HTTP por si só não prova que o aplicativo recebeu dados de classificação utilizáveis. A especificação de semântica HTTP define o status do protocolo; o coletor ainda precisa validar o corpo da resposta.
Verificar o array de resultados orgânicos
O monitor lê position, link e title de organic_results. Ele preserva o position retornado em vez de substituí-lo por um índice de array.
As posições devem ser inteiros positivos distintos, e os links devem gerar endereços de destino HTTP(S) válidos. Um array orgânico vazio recebe empty_unverified e fica fora das comparações de ranking. Esse estado evita que uma resposta vazia não confirmada seja interpretada como um alvo desaparecido.
Alguns resultados do Google usam links wrapper /url ou /goto. O coletor extrai um destino explícito quando disponível. Para wrappers opacos suportados, ele verifica informações de redirecionamento em um escopo Google restrito usando uma requisição independente sem a chave Scrapeless; ele não visita o site de destino final. Links não resolvidos permanecem um erro em vez de serem removidos silenciosamente de uma observação supostamente completa.
Comece a fazer scraping com o Scrapeless
Potencialize o seu fluxo de trabalho de web scraping e automação com o Scrapeless!
Inscreva-se hoje e ganhe US$ 5 de crédito grátis — sem necessidade de cartão de crédito.Solicite agora seu crédito gratuito no Painel do Scrapeless.
Combine nomes de host, não substrings de URL
Um domínio alvo deve corresponder ao hostname analisado ou a um de seus subdomínios. A correspondência por substring aceitaria incorretamente example.com.other.org para example.com. A distinção segue os componentes separados de autoridade e caminho na especificação de sintaxe de URI.
Salve o seguinte como match_example.py ao lado de serp_monitor.py. Ele usa entradas ilustrativas escritas manualmente e não faz nenhuma requisição de API.
python
from urllib.parse import urlsplit
from serp_monitor import normalized_domain


def best_match(organic, domain):
    domain = normalized_domain(domain)
    for item in sorted(organic, key=lambda row: row["position"]):
        host = normalized_domain(urlsplit(item["link"]).hostname or "")
        if host == domain or host.endswith("." + domain):
            return item
    return None


organic = [
    {"position": 1, "link": "https://example.com.other.org/page"},
    {"position": 3, "link": "https://www.example.com/page"},
]
match = best_match(organic, "example.com")
print(match["position"] if match else None)
Execute o exemplo local:
bash
python3 match_example.pyEle imprime 3. O primeiro host pertence a other.org; o segundo pertence ao domínio alvo. Se vários resultados coincidirem, a posição retornada mais baixa vence.
Sem uma correspondência, o ranking permanece em branco. Em branco significa que o domínio não foi encontrado neste conjunto retornado, não posição zero ou prova de ausência de todos os resultados do Google.
Etapa 5 — Inspecionar o histórico do SQLite
O SQLite mantém o contexto da requisição e as observações salvas necessárias para comparações posteriores, incluindo estados que um CSV plano não consegue descrever completamente.
| Tabela | Informações armazenadas | Finalidade |
|---|---|---|
runs |
Identidade da execução, modo, configuração, estado de conclusão | Agrupar uma coleção |
snapshots |
Palavra-chave, entrada, status, detalhes da tarefa, dados de resultado, tempo da requisição | Preservar observações e estado da tarefa |
report_versions |
Linhas de comparação salvas e informações de baseline selecionadas | Manter versões de relatórios reprodutíveis |
Salve este script completo como inspect_history.py no diretório do projeto. Ele abre o banco de dados como somente leitura e imprime a contagem de resultados orgânicos para cada snapshot na última execução ativa.
Observação: este script requer um banco de dados existente oriundo da coleta. Ele não envia buscas nem cria um banco de dados ausente.
python
import json
import sqlite3
from pathlib import Path

uri = Path("data/rankings.sqlite").resolve().as_uri() + "?mode=ro"
with sqlite3.connect(uri, uri=True) as db:
    rows = db.execute("""
        SELECT keyword, status, organic_json
        FROM snapshots
        WHERE run_id = (
            SELECT id FROM runs
            WHERE mode = 'live'
            ORDER BY started_at DESC LIMIT 1
        )
        ORDER BY id
    """)
    for keyword, status, organic_json in rows:
        count = len(json.loads(organic_json or "[]"))
        print(keyword, status, count)
Execute python3 inspect_history.py após a coleta. A consulta ao banco de dados retido retornou:
text
scrapeless success 9
web scraping api success 7
google search api success 9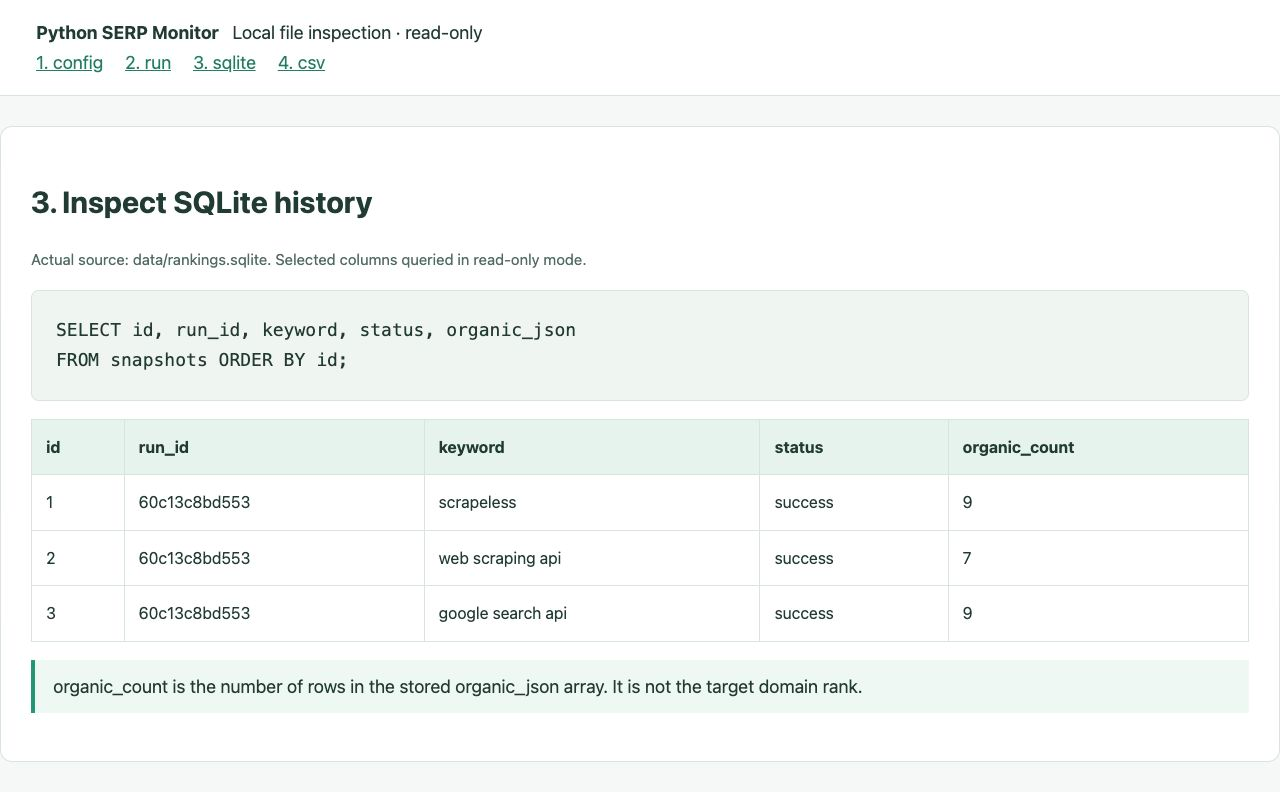
Campos selecionados do banco de dados retido. A contagem orgânica exibida é calculada a partir do array armazenado.
success descreve a coleta. Ele é distinto do status baseline ou baseline_absent do relatório. Preserve o mesmo banco de dados para observações posteriores; um CSV sozinho não consegue restaurar o histórico de tarefas.
Etapa 6 — Ler e reexportar o CSV
O CSV combina a correspondência ao alvo, a cobertura de resultados e o estado de comparação em uma linha para cada palavra-chave e alvo.
Abra o CSV da execução em um aplicativo de planilha. Você também pode listar as execuções salvas:
Observação: os comandos de histórico local e exportação exigem o banco de dados retido da coleta. Eles não fazem chamadas de API.
bash
python3 serp_monitor.py history --db data/rankings.sqlite
python3 serp_monitor.py export --output output/saved-report.csv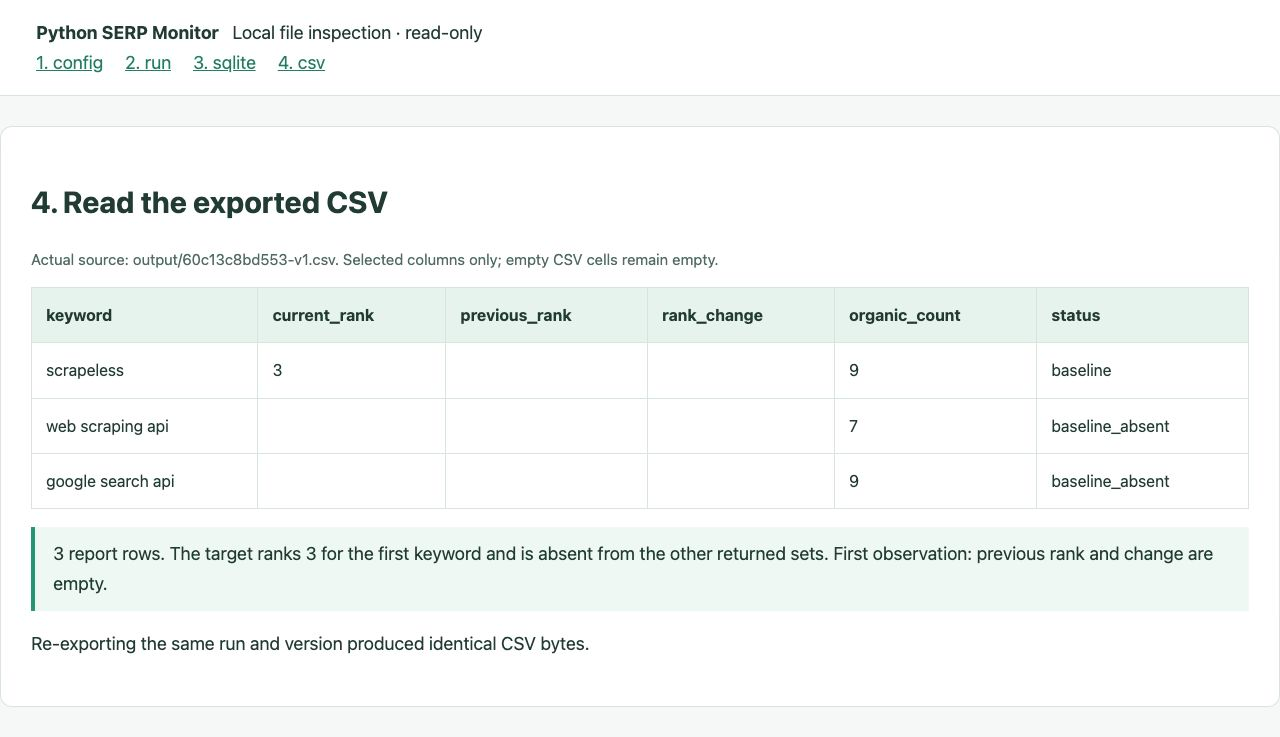
Colunas CSV selecionadas em um visualizador somente leitura, não uma captura de tela de aplicativo de planilha. Rankings ausentes permanecem em branco.
O primeiro baseline retido contém estes resultados:
| Palavra-chave | Posição atual | Resultados orgânicos | Status do relatório |
|---|---|---|---|
scrapeless |
3 | 9 | baseline |
web scraping api |
— | 7 | baseline_absent |
google search api |
— | 9 | baseline_absent |
Os traços representam células em branco no CSV. Todas as três observações foram bem-sucedidas, mas apenas a primeira palavra-chave correspondeu ao alvo. Não havia observação anterior comparável, então previous_rank e rank_change estavam em branco.
O relatório também mantém campos para rastrear seus snapshots, linha de base, configurações de pesquisa e tempo de requisição. A exportação em CSV usa UTF-8 com marca de ordem de bytes e escapa células de texto que se pareçam com fórmulas. A distinção é importante ao importar texto fornecido externamente em planilhas, conforme descrito na orientação da OWASP sobre injeção em CSV.
Comparar uma Coleta Posterior Sem Reescrever a Linha de Base
Um relatório posterior calcula o movimento apenas quando as observações armazenadas têm escopo de pesquisa correspondente e uma ordenação confiável.
No próximo horário de observação, volte ao mesmo diretório do projeto e mantenha .env, config.json e data/rankings.sqlite. Execute novamente o comando collect da Etapa 3. Isso inicia uma nova coleta paga; não é necessário apenas para ler o relatório existente.
Verificar se as Observações São Comparáveis
O resultado anterior deve ter sido recebido não depois do envio da requisição atual. Configurações de consulta correspondentes, sozinhas, são insuficientes quando os intervalos de requisição se sobrepõem ou registros mais antigos não têm temporização confiável.
Nesses casos, o relatório mantém a posição atual, mas marca a comparação como not_comparable. Esses são horários de envio e recebimento do cliente; o projeto não afirma saber o horário exato de coleta do provedor.
Quando ambas as observações comparáveis contêm uma correspondência, o cálculo é rank_change = previous_rank - current_rank. Um movimento ilustrativo da posição 5 para a posição 3 produz +2, significando uma melhora de duas posições. Esse exemplo aritmético não é uma segunda observação em tempo real do caso.
Manter Ausência Separada da Qualidade da Coleta
| Estado do relatório | Significado |
|---|---|
baseline / baseline_absent |
Primeira linha de base de comparação utilizável, com ou sem correspondência ao alvo |
up / down / unchanged |
Ambas as observações comparáveis corresponderam; a posição melhorou, piorou ou permaneceu igual |
new / lost / still_absent |
Correspondência presente apenas agora, apenas antes, ou em nenhum dos conjuntos retornados |
pending / error |
Nenhuma observação atual concluída utilizável |
empty_unverified |
Array orgânico vazio, excluído das linhas de base de ranqueamento |
not_comparable |
Resultado atual válido, mas a ordenação não suporta um cálculo de mudança |
lost é limitado ao conjunto retornado. As contagens de resultados podem mudar entre observações, então leia a cobertura junto com a posição antes de tirar uma conclusão.
Exportar a Versão do Relatório Salvo
O aplicativo armazena as linhas do relatório e suas linhas de base selecionadas quando gera uma versão. Observações posteriores não alteram as linhas já salvas nessa versão.
Nota: Substitua
YOUR_RUN_IDpor um ID de execução existente. Esse comando requer sua versão salva no banco de dados local e não faz chamada à API.
bash
python3 serp_monitor.py export --run-id YOUR_RUN_ID --version 1 --output output/saved-v1.csvA reexportação da versão 1 do caso retido produziu bytes CSV idênticos. A exportação grava um arquivo temporário antes de substituir o destino. Um caminho de saída escolhido explicitamente pode ser sobrescrito, enquanto a versão salva no banco de dados permanece disponível.
Solução de Problemas do Fluxo de Trabalho Local
A maioria dos problemas de configuração pode ser rastreada ao diretório atual, credencial ativa ou banco de dados selecionado.
| Sintoma | O que verificar |
|---|---|
| Script não pode ser encontrado | Execute comandos a partir do diretório extraído do projeto |
| Chave ausente ou inválida | Substitua o placeholder e verifique a precedência de variáveis de ambiente |
| Acesso ou saldo de conta insuficiente | Verifique o serviço selecionado e os créditos disponíveis no painel |
| Posição atual vazia | Inspecione o hostname de destino e a cobertura orgânica retornada |
| Nova linha de base inesperada | Confirme se as configurações de pesquisa e o caminho do banco de dados correspondem ao histórico pretendido |
empty_unverified |
Inspecione a qualidade da resposta antes de interpretar mudanças de ranqueamento |
not_comparable |
Inspecione os intervalos de requisição registrados e a disponibilidade de temporização histórica |
Mantenha o arquivo de chave e o banco de dados bruto em sigilo. Antes de compartilhar um relatório ou captura de tela, remova credenciais e quaisquer alvos ou URLs privados.
Conclusão: Preservar a Observação Antes de Interpretar a Mudança
Este monitor de SERP em Python conecta coleta, correspondência de hostname, histórico em SQLite e relatórios em CSV em um fluxo de trabalho pequeno. O exemplo retido estabelece uma linha de base para três consultas; conclusões de longo prazo exigem observações reais adicionais com configurações e temporização comparáveis.
Mantenha o banco de dados, leia o estado da coleta antes do estado de classificação e use versões salvas de relatórios quando uma comparação precisar permanecer reprodutível. Essas escolhas tornam a próxima coleta interpretável.
Pronto para construir seu pipeline de monitoramento de busca?
Junte-se a desenvolvedores que estão criando fluxos de trabalho de busca no Discord ou Telegram.
Cadastre-se em app.scrapeless.com, comece com uma pequena lista de observação e retenha o contexto de busca em cada observação.
FAQ
P: Quais dados esse monitor deve coletar?
Use o monitor para resultados orgânicos públicos de busca e alvos que você está autorizado a analisar. Revise os termos de serviço e requisitos relevantes para seu caso de uso antes de coletar ou compartilhar dados.
P: O monitor rastreia todas as páginas de resultados do Google?
Não. Esta implementação solicita a primeira página orgânica de desktop retornada com start: 0. Um alvo ausente significa nenhuma correspondência nesse conjunto retornado.
P: É necessário um proxy ou um agente de IA?
Nenhum cliente de proxy separado ou agente de IA é exigido por este aplicativo. Python chama a Scrapeless Google Search API com a chave da conta e as entradas de busca configuradas.
P: O que acontece se o Google mudar sua marcação de página?
Este monitor consome resultados estruturados da API em vez de selecionar elementos do DOM do Google. Ele ainda valida o esquema de resposta e registra dados inutilizáveis em vez de inventar uma posição.
P: Como o monitor lida com erros de acesso ou uma resposta inutilizável?
Ele mantém os problemas de coleta separados da ausência de alvos. Verifique as credenciais, acesso ao produto, saldo e o estado de resposta registrado antes de interpretar o relatório.
P: Coletores múltiplos podem gravar no mesmo banco de dados?
O aplicativo usa um bloqueio de banco de dados compartilhado para impedir coletas sobrepostas contra o mesmo banco de dados local. Mantenha a coleta sequencial e use caminhos de banco de dados consistentes.
P: Por que um resultado bem-sucedido pode ser marcado como not_comparable?
O resultado atual pode ser válido enquanto a ordem das requisições é incerta. Intervalos sobrepostos ou horários históricos de submissão ausentes impedem um cálculo defensável de movimento.
P: A exportação consome créditos da API?
Não. export lê uma versão de relatório salva, e history lê registros locais de execução. collect faz requisições de busca.
P: Um ranking em branco significa que o site foi removido do Google?
Não. Um ranking em branco indica nenhuma correspondência do alvo no conjunto orgânico retornado. Não é uma avaliação completa de status no índice.
Na Scorretless, acessamos apenas dados disponíveis ao público, enquanto cumprem estritamente as leis, regulamentos e políticas de privacidade do site aplicáveis. O conteúdo deste blog é apenas para fins de demonstração e não envolve atividades ilegais ou infratoras. Não temos garantias e negamos toda a responsabilidade pelo uso de informações deste blog ou links de terceiros. Antes de se envolver em qualquer atividade de raspagem, consulte seu consultor jurídico e revise os termos de serviço do site de destino ou obtenha as permissões necessárias.





