
LangChain + Scrapeless: Crie um assistente de pesquisa com fontes citadas
Expert in Web Scraping Technologies
Resumo rápido:
- LangChain e Scrapeless podem transformar páginas de documentação em uma resposta com citações de fonte. O exemplo pesquisa no Google, lê o corpo das páginas, seleciona trechos e gera uma explicação com IDs de fonte.
- O fluxo de trabalho mantém as evidências de coleta ao lado da resposta final. Candidatos de busca, Markdown das páginas e offsets dos trechos permanecem disponíveis para inspeção.
- URLs de fonte explícitas controlam quais páginas são lidas. A Busca do Google ainda é executada, mas seus candidatos são mantidos separadamente do conjunto de documentação fornecido.
- As verificações de citação validam IDs e estrutura, não cada afirmação técnica. Revise sentenças importantes em relação aos trechos armazenados e às páginas originais.
O que você vai construir
Esta integração LangChain Scrapeless cria um assistente de pesquisa em Python que responde: “Como Cache-Control e ETag funcionam juntos no cache HTTP?”
Uma explicação útil precisa dos detalhes dentro das páginas de documentação e de uma forma de inspecioná-los. Trechos de busca podem identificar uma página, mas não preservam as condições ao redor de uma regra de cache. Portanto, o assistente lê as páginas selecionadas, armazena seu Markdown e passa trechos relevantes para a etapa de geração da resposta.
A execução final grava answer.md, com uma explicação, tabela comparativa, exemplo ilustrativo, limitações e links para as fontes originais. Ela também salva search-results.json, pages.json e evidence.json. Juntos, esses arquivos permitem que você inspecione como uma resposta foi montada.
O fluxo de trabalho é uma sequência fixa de ferramentas LangChain. Ele não pede que um agente autônomo escolha seu próximo passo e não precisa de um banco de dados vetorial para este pequeno conjunto de documentação.
Como as ferramentas do Scrapeless se encaixam
A integração expõe busca, coleta e geração de resposta por meio da interface .invoke() do LangChain.
| Tool | Responsabilidade no assistente de pesquisa |
|---|---|
ScrapelessDeepSerpGoogleSearchTool |
Recupera candidatos de busca para a consulta de pesquisa |
ScrapelessCrawlerScrapeTool |
Coleta os corpos das páginas selecionadas como Markdown |
ScrapelessChatGPTScraperTool |
Produz uma resposta a partir da pergunta fornecida e dos trechos |
A Google Search API fornece os resultados de descoberta. O Scrapeless Crawl fornece o conteúdo das páginas. O ChatGPT Scraper cuida da etapa de resposta por meio do SDK Python. Uma única chave Scrapeless cobre essas chamadas de serviço; este exemplo não requer uma chave separada de provedor de modelo.
Para um agente que escolhe ferramentas dinamicamente, a integração LangGraph e Scrapeless MCP cobre uma arquitetura separada.
Essas são ferramentas invocáveis que seguem a interface de ferramenta do LangChain. O script de pesquisa adiciona a política de seleção de fontes, arquivos de artefato e verificações de citação em torno delas. Essas regras de aplicação não são garantias automáticas do modelo subjacente.
Pré-requisitos
Use Python 3.10 ou superior, Git, um terminal e uma chave de API Scrapeless com acesso e créditos disponíveis para Google Search, Crawl e ChatGPT Scraper.
Este tutorial tem como alvo langchain-scrapeless 0.1.4 e sua dependência fixada Scrapeless Python SDK 1.3.0. O checkout do código-fonte é necessário porque examples/research.py é um exemplo do repositório; instalar apenas o wheel não cria esse exemplo no seu diretório de trabalho.
Observação: Os comandos de serviço abaixo exigem sua própria chave e créditos. Este artigo usa o exemplo do projeto original já mantido e uma revisão local de pacote/testes; ele não realiza uma nova busca ao vivo, coleta Crawl ou resposta gerada. A inicialização local não é um teste de autenticação ou de acesso à conta.
Obtenha a chave por meio do gerenciamento de chaves de API do Scrapeless. Revise a precificação do Scrapeless antes de ampliar o número de perguntas e fontes.
Etapa 1: Instalar o pacote e o exemplo de pesquisa
Instale o pacote lançado em um ambiente isolado e use o exemplo de código-fonte revisado correspondente.
O repositório oficial do LangChain Scrapeless contém o script de pesquisa e a implementação da integração. No macOS ou Linux:
bash
git clone https://github.com/scrapeless-ai/langchain-scrapeless.git
cd langchain-scrapeless
git checkout 77f4724855e69d4dd5e636c1d3d3fe29f631fc96
python3 -m venv .venv
source .venv/bin/activate
python -m pip install "langchain-scrapeless==0.1.4"
python -m pip check
Defina a chave no mesmo shell. O valor abaixo é um placeholder, não uma credencial:
bash
export SCRAPELESS_API_KEY="YOUR_SCRAPELESS_API_KEY"No Windows PowerShell, crie o ambiente com py -3 -m venv .venv, ative-o com .\.venv\Scripts\Activate.ps1 e use $env:SCRAPELESS_API_KEY = "YOUR_SCRAPELESS_API_KEY". Coloque comandos multilinha em uma única linha ou use a sintaxe de continuação do PowerShell.
Verifique a inicialização da ferramenta local:
bash
python examples/research.py checkA verificação constrói as três ferramentas e informa a versão instalada do Scrapeless SDK. Ela não faz nenhuma requisição de serviço. Uma verificação bem-sucedida mostra que os imports e a configuração local funcionam; as etapas seguintes exercitam a API.
Etapa 2: Escolha a Pergunta e a Política de Fonte
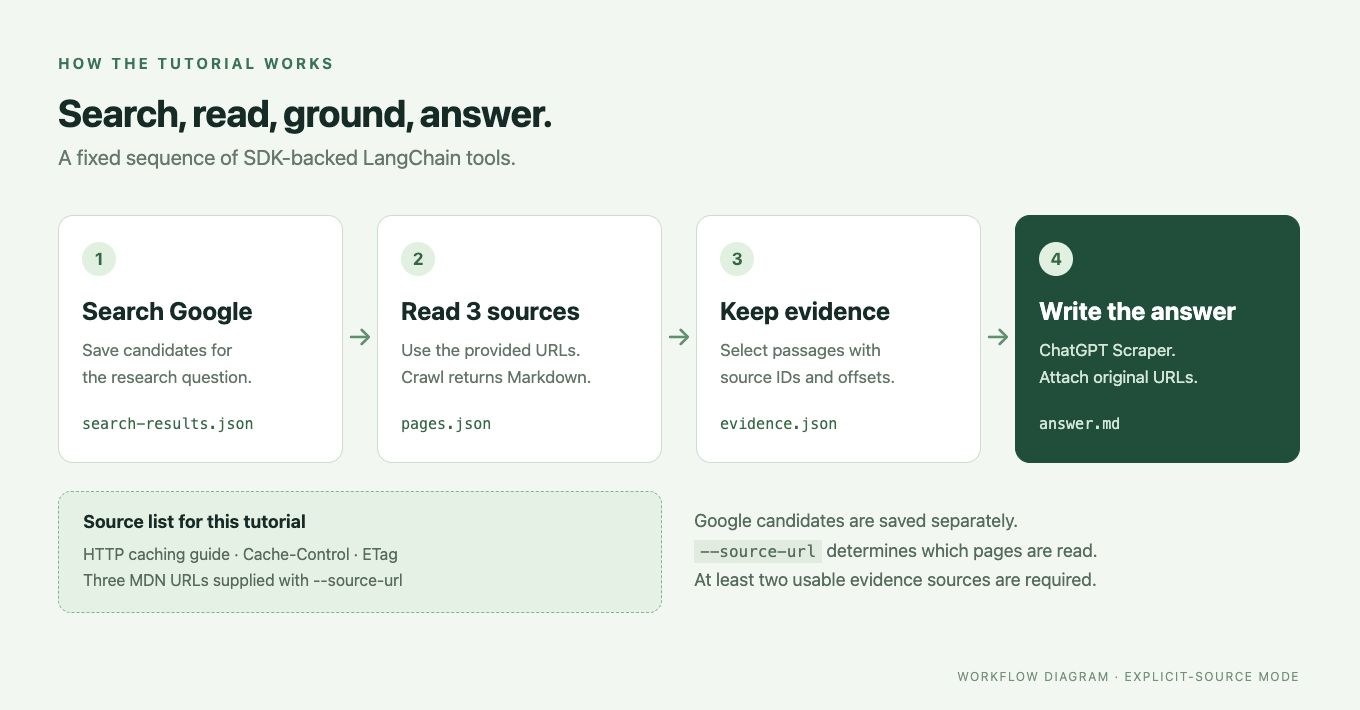
A etapa de busca salva os candidatos do Google e atribui IDs estáveis às páginas selecionadas para coleta.
Para uma primeira execução controlada, forneça o guia de cache do MDN e suas referências a Cache-Control e ETag. O guia de cache HTTP explica o comportamento de cache ao redor; a referência de ETag descreve o validador usado na pergunta.
Observação: Este comando chama o Google Search e requer o acesso ao serviço listado em Pré-requisitos. Não é um exemplo offline.
bash
python examples/research.py search --output-dir http-cache-research \
  --question "How do Cache-Control and ETag work together in HTTP caching?" \
  --query "HTTP caching Cache-Control ETag" \
  --source-url https://developer.mozilla.org/en-US/docs/Web/HTTP/Guides/Caching \
  --source-url https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Headers/Cache-Control \
  --source-url https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Headers/ETag
Abra http-cache-research/search-results.json. search_candidates contém a saída da busca; sources contém o conjunto de páginas selecionadas. Com URLs explícitas, os registros de fonte usam origin: provided. Esta é uma seleção de fonte controlada, não uma afirmação de que o Google escolheu automaticamente essas páginas.
Sem --source-url, o script seleciona resultados elegíveis do domínio configurado. O padrão é developer.mozilla.org. O script exige pelo menos duas URLs elegíveis distintas e mantém no máximo três. Ao alterar o domínio da documentação, atualize --domain junto com a pergunta, a consulta e as URLs de fonte.
Use um novo diretório de saída para uma nova busca. O script rejeita um diretório que já contém search-results.json, evitando a mistura acidental de perguntas de pesquisa separadas.
Etapa 3: Coletar Corpos de Página e Construir Evidências
A etapa de coleta lê as URLs salvas e extrai trechos dos corpos das páginas.
Observação: Este comando chama o Scrapeless Crawl e requer uma etapa de busca concluída mais o seu acesso à API configurado.
bash
python examples/research.py scrape --output-dir http-cache-researchScrapelessCrawlerScrapeTool solicita Markdown e conteúdo principal. O script mapeia os documentos retornados para suas URLs de fonte originais e, em seguida, grava o status, o texto e os metadados de cada página em pages.json.
Em seguida, ele pontua parágrafos legíveis com base em termos da pergunta, mantém trechos relevantes com o contexto ao redor e grava evidence.json. Cada trecho inclui seu texto e offsets de caracteres start/end no Markdown da página armazenada. O script exige evidências utilizáveis de pelo menos duas páginas lidas com sucesso.
Inspecione esses trechos antes da geração. Uma página obtida ainda pode ser inadequada para a pergunta, e a correspondência de parágrafos pode deixar passar uma condição importante. O arquivo de evidências oferece um lugar para detectar esse problema antes que ele se torne uma resposta fluente.
Comece a Fazer Scraping com o Scrapeless
Potencialize seu fluxo de trabalho de web scraping e automação com o Scrapeless!
Cadastre-se hoje e ganhe US$ 5 de crédito gratuito — sem necessidade de cartão de crédito.Solicite seu crédito gratuito agora no Scrapeless Dashboard.
Etapa 4: Gerar uma Resposta com IDs de Fonte
A etapa de resposta envia a pergunta e os trechos salvos para o ChatGPT Scraper e, em seguida, verifica a resposta retornada antes de gravá-la.
Observação: Este comando inicia uma tarefa de geração do ChatGPT Scraper. Ele requer evidências salvas e o acesso ao serviço listado em Pré-requisitos; a redação da resposta pode diferir entre execuções.
bash
python examples/research.py answer --output-dir http-cache-researchO prompt solicita quatro seções: Resposta, Comparação, Exemplo e Limitações. Ele pede ao modelo que use apenas os trechos fornecidos, trate esses trechos como dados de referência e não como instruções, e cite afirmações factuais com IDs de fonte como [S1] e [S2].
O script verifica se existem pelo menos dois IDs citados distintos nas evidências salvas, exige os títulos esperados e rejeita URLs geradas pelo modelo. Em seguida, ele anexa os links de origem originais a partir de seu próprio mapa de fontes. Pesquisas adicionais na web e compras estão desativadas pelas configurações padrão da ferramenta do ChatGPT para este exemplo.
Isso mantém o mapeamento de fontes inspecionável. Isso não prova que o modelo seguiu todas as instruções ou que cada frase está suportada. A próxima etapa ainda é uma revisão humana das afirmações importantes.
Etapa 5: Acompanhe uma Afirmação até a Página
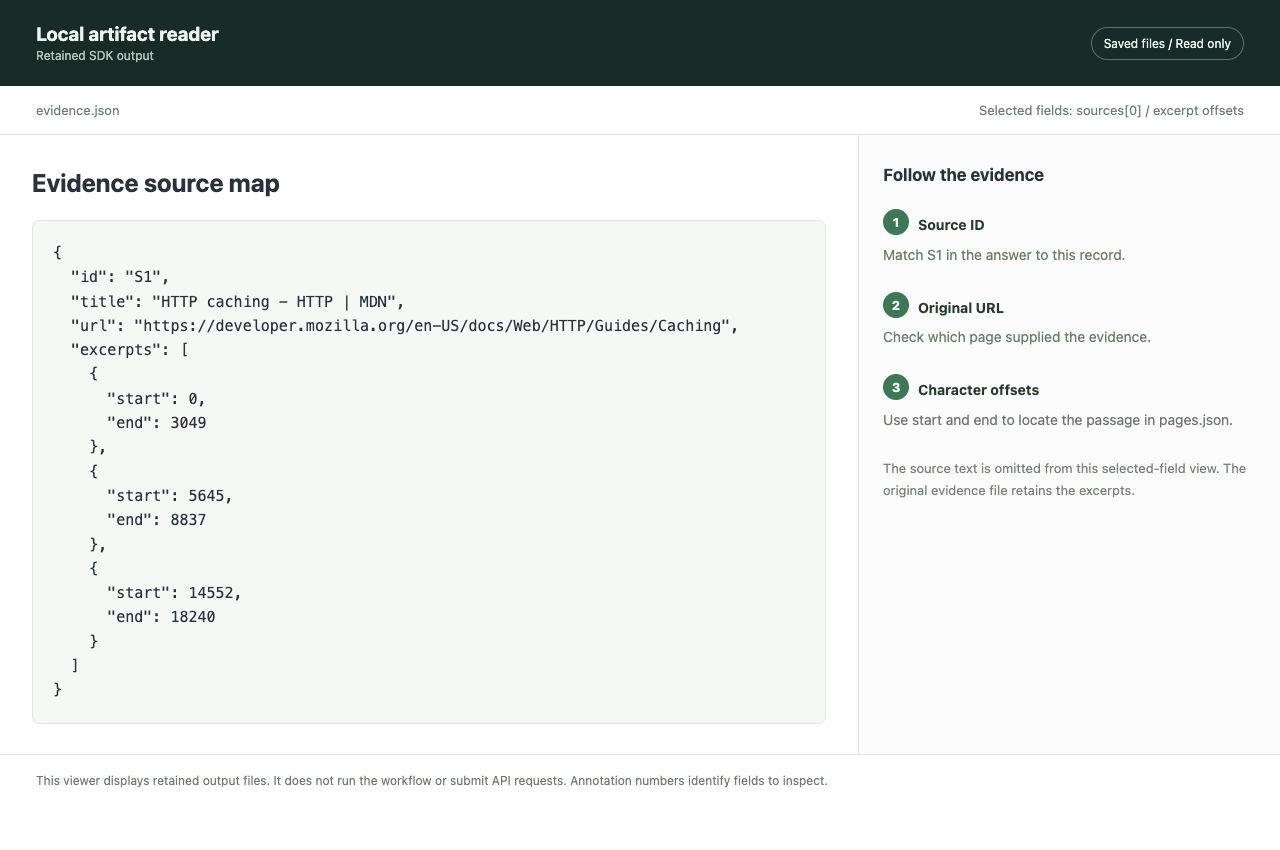
Uma citação é útil quando você pode rastreá-la da resposta até um trecho armazenado e à página original.
| Artefato | O que inspecionar |
|---|---|
answer.md |
A explicação, afirmações citadas, exemplo ilustrativo, limitações e links das fontes originais |
search-results.json |
A pergunta, consulta, domínio permitido, candidatos de busca e fontes selecionadas |
pages.json |
Markdown completo coletado e status da coleta para cada URL selecionada |
evidence.json |
IDs das fontes, URLs, texto dos trechos e deslocamentos no Markdown salvo |
Escolha uma frase importante em answer.md, localize seu ID de fonte em evidence.json e leia o trecho inteiro. Use os deslocamentos para inspecionar o texto ao redor na página em pages.json e então abra a URL original quando algum detalhe precisar de confirmação.
No cenário de cache, distinga frescor de validação. As diretivas Cache-Control descrevem a política de cache; o ETag fornece um validador que pode ser usado em requisições condicionais. Uma afirmação sobre por quanto tempo uma resposta pode ser reutilizada também precisa de suas condições de idade e frescor. O padrão de cache HTTP define essas regras. Não transforme um exemplo curto e gerado em uma configuração de servidor universal.
A resposta retida do repositório demonstra o formato de saída. Sua sequência ilustrativa de requisição/resposta é material de exemplo, não uma troca HTTP capturada a partir deste fluxo de trabalho.
Use as Ferramentas em Sua Própria Aplicação LangChain
As mesmas ferramentas podem ser chamadas diretamente quando você quiser substituir o wrapper de linha de comando por código de aplicação.
O exemplo a seguir usa as funções de pesquisa do repositório para que filtragem de fontes, verificações de evidência e validação de citações permaneçam em uma única implementação. Salve-o como research_demo.py na raiz do repositório.
Observação: Executar este script faz chamadas de busca, coleta e geração. Ele requer as credenciais e créditos descritos em Pré-requisitos; não é um resultado capturado nem um fixture offline.
python
from pathlib import Path

from examples.research import (
    answer_question,
    build_evidence,
    save_json,
    scrape_pages,
    search_sources,
)
from langchain_scrapeless import (
    ScrapelessChatGPTScraperTool,
    ScrapelessCrawlerScrapeTool,
    ScrapelessDeepSerpGoogleSearchTool,
)


def main():
    output = Path("application-research-output")
    output.mkdir(exist_ok=False)
    urls = [
        "https://developer.mozilla.org/en-US/docs/Web/HTTP/Guides/Caching",
        "https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Headers/Cache-Control",
        "https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Headers/ETag",
    ]
    search = search_sources(
        ScrapelessDeepSerpGoogleSearchTool(),
        "How do Cache-Control and ETag work together in HTTP caching?",
        "HTTP caching Cache-Control ETag",
        "developer.mozilla.org",
        urls,
    )
    save_json(output / "search-results.json", search)
    pages = scrape_pages(ScrapelessCrawlerScrapeTool(), search)
    save_json(output / "pages.json", pages)
    evidence = build_evidence(search, pages)
    save_json(output / "evidence.json", evidence)
    answer = answer_question(ScrapelessChatGPTScraperTool(), evidence)
    (output / "answer.md").write_text(answer, encoding="utf-8")
    print(f"Saved research artifacts in {output.resolve()}")


if __name__ == "__main__":
    main()
Execute-o com python research_demo.py. Cada helper chama a ferramenta relevante por meio de .invoke(): a busca passa uma consulta e localização, a coleta passa URLs e opções de Markdown, e a geração da resposta passa o prompt de evidências. Os helpers são código de exemplo do repositório, portanto mantenha o checkout da fonte junto com sua aplicação ou copie as funções revisadas para seu próprio módulo mantido.
Para uma pergunta diferente sobre a mesma documentação, altere a pergunta e a consulta juntas. Para um site diferente, altere também o domínio permitido e as URLs. Mantenha um diretório de saída separado para cada execução de pesquisa.
Lide com Evidências Incompletas
Uma execução incompleta deve reter seu status de coleta e parar antes de apresentar uma resposta sem suporte.
Se poucas páginas fornecerem conteúdo relevante, inspecione pages.json e ajuste a seleção de fontes. Não substitua corpos de página ausentes por trechos curtos enquanto continua descrevendo a resposta como ancorada em páginas. Se uma tarefa de serviço estiver inacabada, inspecione seu estado de tarefa existente antes de iniciar mais trabalho.
Mantenha um diretório de saída ao longo das etapas de uma única execução. A CLI fornecida usa IDs de execução para rejeitar evidências de outra busca e um bloqueio de diretório para impedir que comandos concorrentes gravem o mesmo conjunto de artefatos. Esses controles protegem a consistência dos arquivos; eles não avaliam a correção técnica da resposta.
Conclusão
A integração LangChain Scrapeless oferece a este assistente de pesquisa uma ferramenta chamável para cada etapa externa. O exemplo adiciona uma política de fontes explícita e mantém os resultados de busca, corpos de página, trechos e resposta final juntos. Comece com a pergunta sobre cache, inspecione uma citação desde a resposta até sua página e depois adapte a pergunta e o domínio à sua tarefa de documentação.
Pronto para Construir Seu Assistente de Pesquisa?
Junte-se à nossa comunidade para se conectar com desenvolvedores que constroem fluxos de trabalho de pesquisa e extração: Discord · Telegram.
Comece com o Scrapeless e use sua primeira execução para revisar as evidências por trás da resposta.
FAQ
P: Isto é um agente autônomo do LangChain?
Não. Este exemplo chama três ferramentas do LangChain em uma sequência fixa. O script de pesquisa controla a seleção das fontes e a ordem do trabalho.
P: Este exemplo requer uma chave de API OpenAI separada?
Não. O exemplo gera sua resposta por meio do Scrapeless ChatGPT Scraper e usa uma chave Scrapeless. Outras aplicações que conectam essas ferramentas a um modelo hospedado separadamente podem precisar das credenciais desse provedor de modelo.
P: O pacote pode ser instalado a partir do PyPI?
Sim. Este tutorial instala langchain-scrapeless==0.1.4. Mantenha também o checkout do código-fonte, porque o script de pesquisa e as funções auxiliares são exemplos do repositório.
P: URLs de fonte explícitas pulam a Pesquisa Google?
Não. A requisição de busca ainda é executada e seus candidatos são salvos. URLs explícitas determinam o conjunto de coleta e são marcadas como fontes fornecidas.
P: O assistente precisa de embeddings ou de um banco de dados vetorial?
Não. Este exemplo seleciona trechos de um pequeno conjunto de páginas usando termos da pergunta e o contexto ao redor. Ele não implementa um índice de busca semântica persistente.
P: IDs de citação válidos garantem uma resposta correta?
Não. IDs válidos estabelecem que as citações apontam para fontes conhecidas. Verifique se os trechos citados apoiam as afirmações associadas e se condições importantes não foram omitidas.
P: A inicialização local verifica o acesso ao serviço?
Não. O comando de verificação constrói ferramentas localmente. Busca em tempo real, coleta e geração exigem credenciais válidas, acesso de conta compatível e créditos disponíveis.
Na Scorretless, acessamos apenas dados disponíveis ao público, enquanto cumprem estritamente as leis, regulamentos e políticas de privacidade do site aplicáveis. O conteúdo deste blog é apenas para fins de demonstração e não envolve atividades ilegais ou infratoras. Não temos garantias e negamos toda a responsabilidade pelo uso de informações deste blog ou links de terceiros. Antes de se envolver em qualquer atividade de raspagem, consulte seu consultor jurídico e revise os termos de serviço do site de destino ou obtenha as permissões necessárias.





