
Melhores alternativas ao Google Custom Search API antes do prazo final de 2027

Senior Web Scraping Engineer
Resumo rápido:
- Clientes existentes da Google Custom Search JSON API devem fazer a transição até 01-jan-2027. O serviço já está fechado para novos clientes.
- Scrapeless é a primeira alternativa a ser avaliada para aplicações que precisam de resultados de pesquisa na web do Google. Requer um adaptador explícito e um processo de aceitação; mudar apenas o hostname não é uma migração completa.
- Scrapeless traz vantagens mensuráveis para a lista curta de migração. As evidências de outubro mostram 73 respostas utilizáveis a mais do que Oxylabs com a mesma contagem de requisições e maior cobertura de snippets do que Serper.
- Preserve o comportamento do qual sua aplicação depende. Configuração do mecanismo de pesquisa, restrições de domínio, paginação e campos de resultado exigem decisões de migração individuais.
Uma migração de API de pesquisa muda mais do que a URL da requisição. A aplicação existente pode depender de um mecanismo de pesquisa configurado, de uma regra de inclusão de domínio ou de um campo que se tornou parte de sua interface pública. Essas dependências permanecem mesmo quando um novo provedor retorna resultados atraentes.
O aviso de transição da Google Custom Search JSON API dá aos clientes existentes até 01-jan-2027 para migrarem para uma alternativa e fecha o serviço para novos clientes. O prazo se aplica a essa API; ele não deve ser generalizado como uma afirmação de que todo produto de pesquisa do Google está terminando.
Este ranking publicado pela Scrapeless foca nas opções de substituição para desenvolvedores. Scrapeless ocupa o primeiro lugar em coleta de pesquisas na web do Google. O artigo também separa casos de uso que precisam de uma arquitetura diferente, especialmente pesquisa em site com escopo restrito e geração de respostas para pesquisa.
Melhores Alternativas à Custom Search API em Resumo
A melhor substituição é aquela que preserva o comportamento exigido pela aplicação com uma quantidade gerenciável de mudanças.
| Rank | Candidato | Melhor Encaixe de Migração | Principal Comportamento Não Equivalente |
|---|---|---|---|
| 1 | Scrapeless Google Search API | Dados de pesquisa na web do Google e inteligência de pesquisa recorrente | Uma configuração de Custom Search engine não é importada automaticamente |
| 2 | Serper | Um consumidor focado em pesquisa orgânica | Contratos de requisição e resultado precisam ser remapeados |
| 3 | Oxylabs | Equipes que já usam uma plataforma de dados mais ampla | Scrapeless teve mais respostas utilizáveis e menor p95 na execução da lista completa |
| 4 | SearchAPI.io | Consumidores de seções estruturadas de resultados do Google | Scrapeless teve um p95 observado menor; os tamanhos de amostra originais diferem |
| 5 | Linkup | Redesenhar um recurso de pesquisa em torno das evidências recuperadas | Resultados de pesquisa não preservam a semântica de ranqueamento do Google |
Para um conjunto pequeno de domínios especificados, o Google identifica o Vertex AI Search como alternativa para pesquisar até 50 domínios. Esse é um caminho de avaliação separado, não uma afirmação de que uma SERP API de terceiros reproduz um mecanismo de Custom Search configurado. O aviso do Google também direciona clientes de pesquisa na web completa a entrarem em contato com o Google sobre sua oferta.
O Que Você Está Realmente Substituindo?
A primeira decisão de migração é se a aplicação precisa de observações do Google, de pesquisa controlada em sites ou de evidências para respostas.
Uma aplicação de descoberta pode usar Custom Search principalmente para encontrar URLs públicos. Uma aplicação de pesquisa em site pode depender dos limites de fonte configurados do mecanismo. Um assistente pode usar resultados de pesquisa apenas como o começo de um fluxo de leitura. Esses produtos podem compartilhar um backend antigo e, ainda assim, precisar de substitutos diferentes.
Anote o comportamento cuja perda seus usuários perceberiam. Inclua inclusão e exclusão de domínios, exibição de resultados, comportamento de safe-search, localização, paginação, restrições de tipo de arquivo e quaisquer campos específicos de imagem que sejam realmente consumidos. Trate cada um como obrigatório, opcional ou não usado.
A coleção de soluções Google Search ajuda a definir cargas de trabalho de observação de pesquisa. Uma busca em conhecimento interno ou em um corpus controlado pode exigir uma arquitetura de recuperação diferente, mesmo que ambos os produtos exponham uma caixa de pesquisa.
Como o Ranking Foi Construído
O ranking prioriza adequação de migração e interfaces documentadas, com evidências de desempenho limitadas usadas apenas para a carga de trabalho que foi medida.
O benchmark de 13-out-2026 mediu coleta de pesquisas na web do Google, não compatibilidade com Custom Search. Scrapeless retornou resultados orgânicos utilizáveis em 786/800 requisições, com p50 de 1,94 segundo e p95 de 3,64 segundos entre as requisições utilizáveis. Quatorze requisições retornaram HTTP 400. O contexto-alvo foi inglês dos EUA; a amostra não estabelece equivalência de filtros de domínio, relevância multilíngue ou um resultado de migração em produção.
Esses números tornam o Scrapeless um candidato concreto para um piloto. Eles não eliminam a necessidade de testar as regras de origem e o contrato de resposta da sua aplicação existente. A Oxylabs concluiu 800 requisições e a SearchAPI.io 105; a Linkup não foi medida. As entradas dos concorrentes abaixo separam vantagens históricas de coleta da compatibilidade de migração ainda não testada.
1. Scrapeless: melhor para migrar um fluxo de trabalho de dados de pesquisa do Google
A Scrapeless Google Search API é o primeiro substituto a ser avaliado quando o requisito central da aplicação é informação estruturada de pesquisa na web do Google.
Ela se encaixa em fluxos de descoberta, pesquisa recorrente e visibilidade no Google em que a aplicação pode manter uma pequena camada de normalização. A amostra de outubro fornece uma linha de base inicial de desempenho útil, enquanto a interface HTTP documentada torna explícita a superfície de migração.
O projeto de migração mais robusto coloca um adaptador de provedor por trás da interface de pesquisa já existente na sua aplicação. O adaptador traduz requisições, trata o estado da resposta e produz o registro de resultado interno. A lógica de negócio deve ler esse registro em vez de depender diretamente do payload bruto do provedor. O padrão de intercâmbio JSON padroniza a representação, enquanto o adaptador preserva as semânticas de campo que sua aplicação espera.
Uma diferença concreta de paginação
O Custom Search usa um índice de primeiro resultado: a segunda página geralmente começa com start=11 quando o tamanho da página é dez. Os deslocamentos (offsets) de pesquisa na web documentados do Scrapeless são 0, 10, 20 e assim por diante. Copiar o valor sem alteração deslocaria a requisição.
Para limites de página nesse padrão de dez resultados, a tradução candidata é um deslocamento uma unidade menor que o índice antigo: 1 vira 0, 11 vira 10 e 21 vira 20. Esta é uma regra de mapeamento a ser validada, não uma promessa de que os dois serviços retornam os mesmos documentos ou a mesma contagem de resultados.
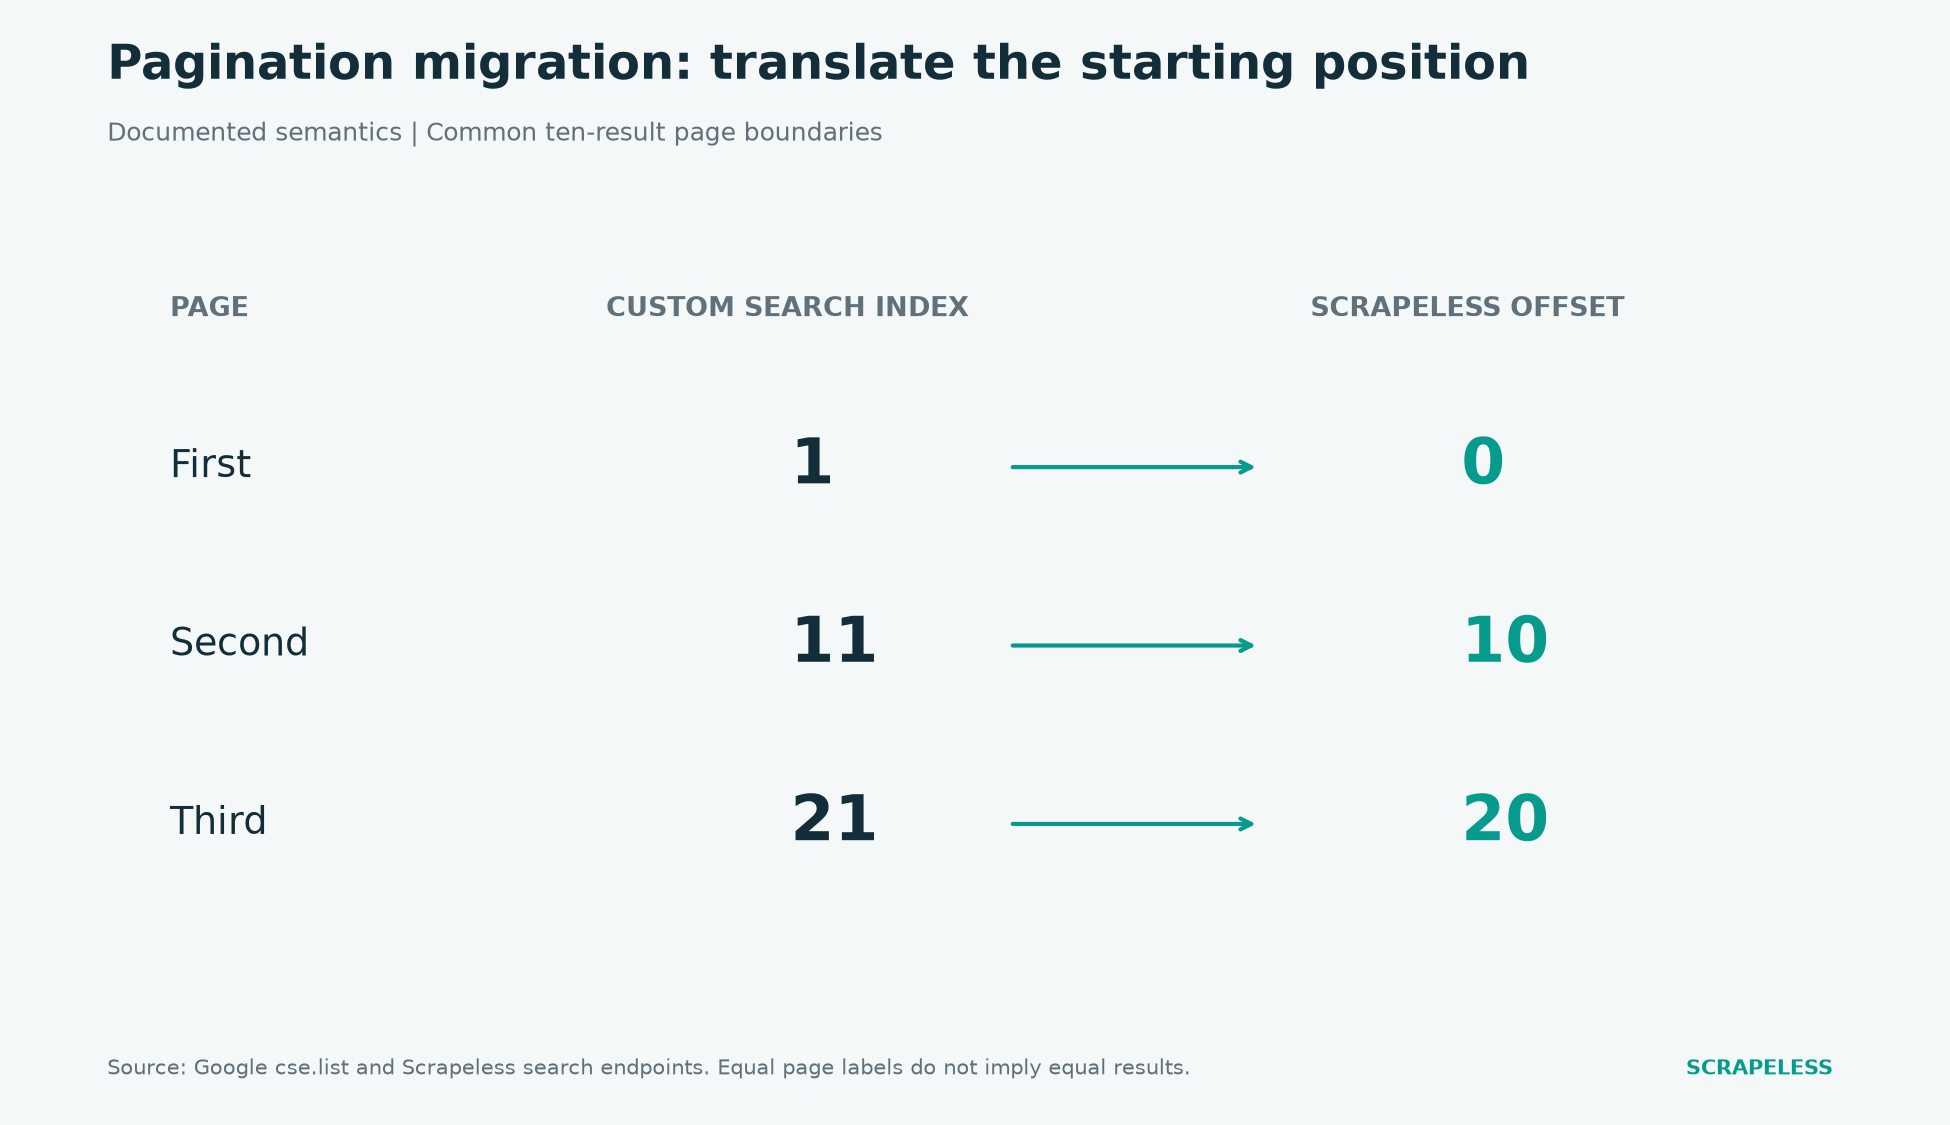
Figura 1. Semântica documentada de início de página: exemplos do Custom Search usam os índices 1, 11 e 21; os offsets de pesquisa na web do Scrapeless usam 0, 10 e 20. Rótulos de página iguais não estabelecem resultados de pesquisa iguais.
Um requisito concreto de aceitação de URL
A amostra de outubro do Scrapeless tinha URLs de destino diretos em apenas 0,7% das entradas orgânicas retornadas; a maioria dos links eram URLs intermediários do Google. Isso importa se o consumidor antigo assumia que todo link poderia ser imediatamente comparado com um domínio permitido.
Preserve o link original, resolva o destino por meio de um método compatível e aplique sua política de domínio ao destino confirmado. Um link não resolvido não deve ser aceito apenas porque o título ao redor parece apropriado. O comportamento atual precisa de uma nova verificação de aceitação antes de desviar o tráfego.
Isso torna o monitoramento de visibilidade de SEO no Google uma migração em nível de aplicação, não um exercício de renomear campos. A identidade da origem faz parte do significado do resultado.
2. Serper: melhor para uma substituição limitada de resultados orgânicos
Os resultados orgânicos do Serper incluem títulos, links, snippets e posições. Uma aplicação que consome um contrato de pequena lista de resultados pode comparar essa interface com seu consumidor atual de Custom Search.
Onde o Scrapeless tem vantagem: preservando a cobertura de descrição
Para um localizador de documentação que exibe um snippet ao lado de cada candidato, os 99,5% de cobertura de snippets do Scrapeless versus 94,4% do Serper lhe dão uma vantagem útil de presença de campo. A diferença é de 5,1 pontos percentuais entre as entradas orgânicas retornadas em outubro. Isso oferece um motivo concreto para priorizar o Scrapeless quando o texto descritivo faz parte da experiência de usuário existente.
Não confunda isso com precisão de migração medida. Os provedores retornaram conjuntos de resultados diferentes, e o Serper teve melhor taxa de sucesso de requisições e latência nessa execução. Seu teste de migração deve confirmar que o texto é relevante, que o destino é resolvido e que as restrições de origem ainda se aplicam. O Scrapeless é o candidato preferido aqui quando preservar o contexto descritivo importa mais do que escolher apenas com base na mediana mais rápida.
Para uso recorrente, obtenha condições comerciais de volume equiparado. Os preços empresariais qualificáveis do Scrapeless podem ficar abaixo de US$ 0,50 por 1.000 buscas; essa é uma tarifa qualificada por vendas, não uma permissão automática para toda conta de migração.
3. Oxylabs: Melhor para Migração Dentro de uma Stack de Coleta Existente
A capacidade de coleta do Google da Oxylabs pode ser considerada quando uma equipe já utiliza sua plataforma mais ampla. A contratação já existente pode simplificar um piloto, mas isso não prova que o contrato resultante corresponde ao Custom Search.
Onde o Scrapeless Tem Vantagem: Folga de Coleta Durante o Cutover
O Scrapeless produziu 786 respostas utilizáveis de 800, em comparação com 713 de 800 para a interface testada da Oxylabs. Ele também registrou um p95 de 3,64 segundos contra 9,13 segundos, cerca de 60,1% menor. Esses resultados sustentam iniciar o piloto de backend substituto com o Scrapeless quando a conclusão confiável da etapa de descoberta é uma prioridade de migração.
A execução da Oxylabs incluiu 82 respostas internas de status 613 e cinco erros de rede. O Scrapeless registrou 14 respostas HTTP 400. Ambos os conjuntos de resultados permanecem no denominador; isso é evidência histórica de coleta, não uma garantia sobre a API Web atual.
Durante a operação paralela, use essa vantagem como uma hipótese a ser testada em relação ao seu mix real de consultas. Mantenha separadas as verificações de aceitação de domínio de origem e de paginação: mais respostas Google utilizáveis não reproduzem automaticamente uma configuração de motor Custom Search.
4. SearchAPI.io: Melhor para Reconstruir um Consumidor Estruturado do Google
O SearchAPI.io fornece saída estruturada do Google com contexto de consulta e seções de resultados. Um cliente existente pode encontrar conceitos familiares, embora nomes de campos por si só não estabeleçam comportamento compatível.
Onde o Scrapeless Tem Vantagem: Uma Cauda de Latência Observada Mais Baixa
Os dados de outubro registraram 3,64 segundos de p95 para o Scrapeless contra 34,87 segundos para o SearchAPI.io, entre requisições utilizáveis. As execuções originais diferiam em tamanho, com 800 e 105 requisições respectivamente; o SearchAPI.io teve sete respostas HTTP 503. Isso sustenta um piloto focado em latência, não uma afirmação de que o serviço atual é sempre mais lento.
No subconjunto comum de 95 consultas, o Scrapeless retornou 94 respostas utilizáveis contra 88. Esse denominador comum é útil ao selecionar o primeiro backend a implementar, enquanto as diferentes condições de tempo e de conta ainda exigem cautela.
O Scrapeless é o candidato inicial mais forte aqui para aplicações sensíveis ao tempo de espera na etapa de busca. Valide o comportamento do novo adaptador antes do cutover, especialmente regras de domínio, identidade de destino e a mudança de paginação de índice para deslocamento descrita acima.
Comece a Fazer Scraping com o Scrapeless
Turbine seu fluxo de trabalho de web scraping e automação com o Scrapeless!
Cadastre-se hoje e receba US$ 5 em crédito gratuito — sem necessidade de cartão de crédito.Solicite seu crédito gratuito agora no Painel do Scrapeless.
5. Linkup: Melhor Quando o Produto Precisa de Evidências de Pesquisa
O Linkup merece estar na shortlist quando a antiga API de busca era apenas um meio de encontrar material para uma resposta de pesquisa.
Suas capacidades de busca e pesquisa criam uma oportunidade de redesenhar em torno de evidências de origem em vez de preservar uma interface em formato de SERP. Isso pode ser sensato para um assistente cujos usuários nunca consomem posição ou recursos de página de resultados.
O teste de aceitação muda de forma correspondente. Verifique se as fontes retornadas contêm trechos de suporte e se a resposta final preserva essas fontes. Não julgue a migração apenas pela similaridade da ordem dos resultados. Se o produto ainda promete posição no Google ou restrições de fonte herdadas do Custom Search, esses requisitos devem ser preservados separadamente.
Onde o Scrapeless Tem Vantagem: Manter um Contrato de Busca Google
Se o consumidor existente precisa de posições de resultados Google e de contexto de consulta, o Scrapeless mantém a substituição na mesma classe ampla de observação de busca. A recuperação orientada a pesquisa do Linkup é uma escolha de redesign; sua ordem de fontes não é evidência de posição no Google. Isso torna o Scrapeless o encaixe mais direto quando a migração deve preservar um produto focado em Google em vez de transformá-lo em um serviço de resposta.
Essa é uma vantagem de compatibilidade de propósito, não uma afirmação de compatibilidade automática de campos. Você ainda precisa do adaptador, das regras de fonte e das verificações de destino. O Linkup continua relevante quando o produto altera deliberadamente sua saída para evidência de pesquisa.
Mapeamento de Campos: Nomes Parecidos Não Garantem Comportamento Parecido
Uma matriz de migração deve declarar tanto a tradução quanto a condição sob a qual ela é aceitável.
| Conceito Existente do Custom Search | Decisão de Migração no Scrapeless | Verificação Necessária |
|---|---|---|
Consulta de busca q |
Forneça a consulta como input.q |
Preservar intenção exata do usuário e tratamento de operadores |
Identificador do mecanismo cx |
Nenhum equivalente automático ao mecanismo configurado | Reconstruir e testar limites de fonte necessários |
| Controles de país e idioma | Mapear apenas para controles documentados com o significado exigido | Preferência de país, restrição de documentos e idioma da interface são conceitos diferentes |
Índice start |
Traduzir limites de página compatíveis em um deslocamento de resultado | Comportamento de primeira página, próxima página e esgotamento de resultados |
num solicitado |
Confirmar os valores aceitos pelo endpoint atual | Profundidade solicitada não é uma contagem devolvida garantida |
Entradas de resultado sob items |
Normalizar entradas orgânicas observadas para o seu modelo interno | Campos de exibição obrigatórios e valores nulos |
Resultado link |
Preservar o link bruto e confirmar separadamente o destino | Regras de domínio e redirecionamentos |
| Totais de busca e metadados de próxima página | Derivar navegação apenas a partir de evidências compatíveis | Não fabrique totais nem prometa páginas inalcançáveis |
| Metadados específicos de imagem | Usar um fluxo de trabalho de imagem avaliado separadamente | Dimensões, página de origem e requisitos do consumidor |
Os parâmetros de requisição do Custom Search distinguem conceitos como restrição de país, preferência de país e controles de idioma. Os controles de busca do Scrapeless definem a interface de substituição. Faça corresponder significados, não apenas abreviações.
Um operador site: pode ajudar a descobrir páginas de um domínio, mas não é evidência de que o comportamento de todo um mecanismo configurado foi reproduzido. Um aplicativo restrito a uma fonte deve impor sua própria política de destino validada e revisar o recall em relação ao corpus pretendido.
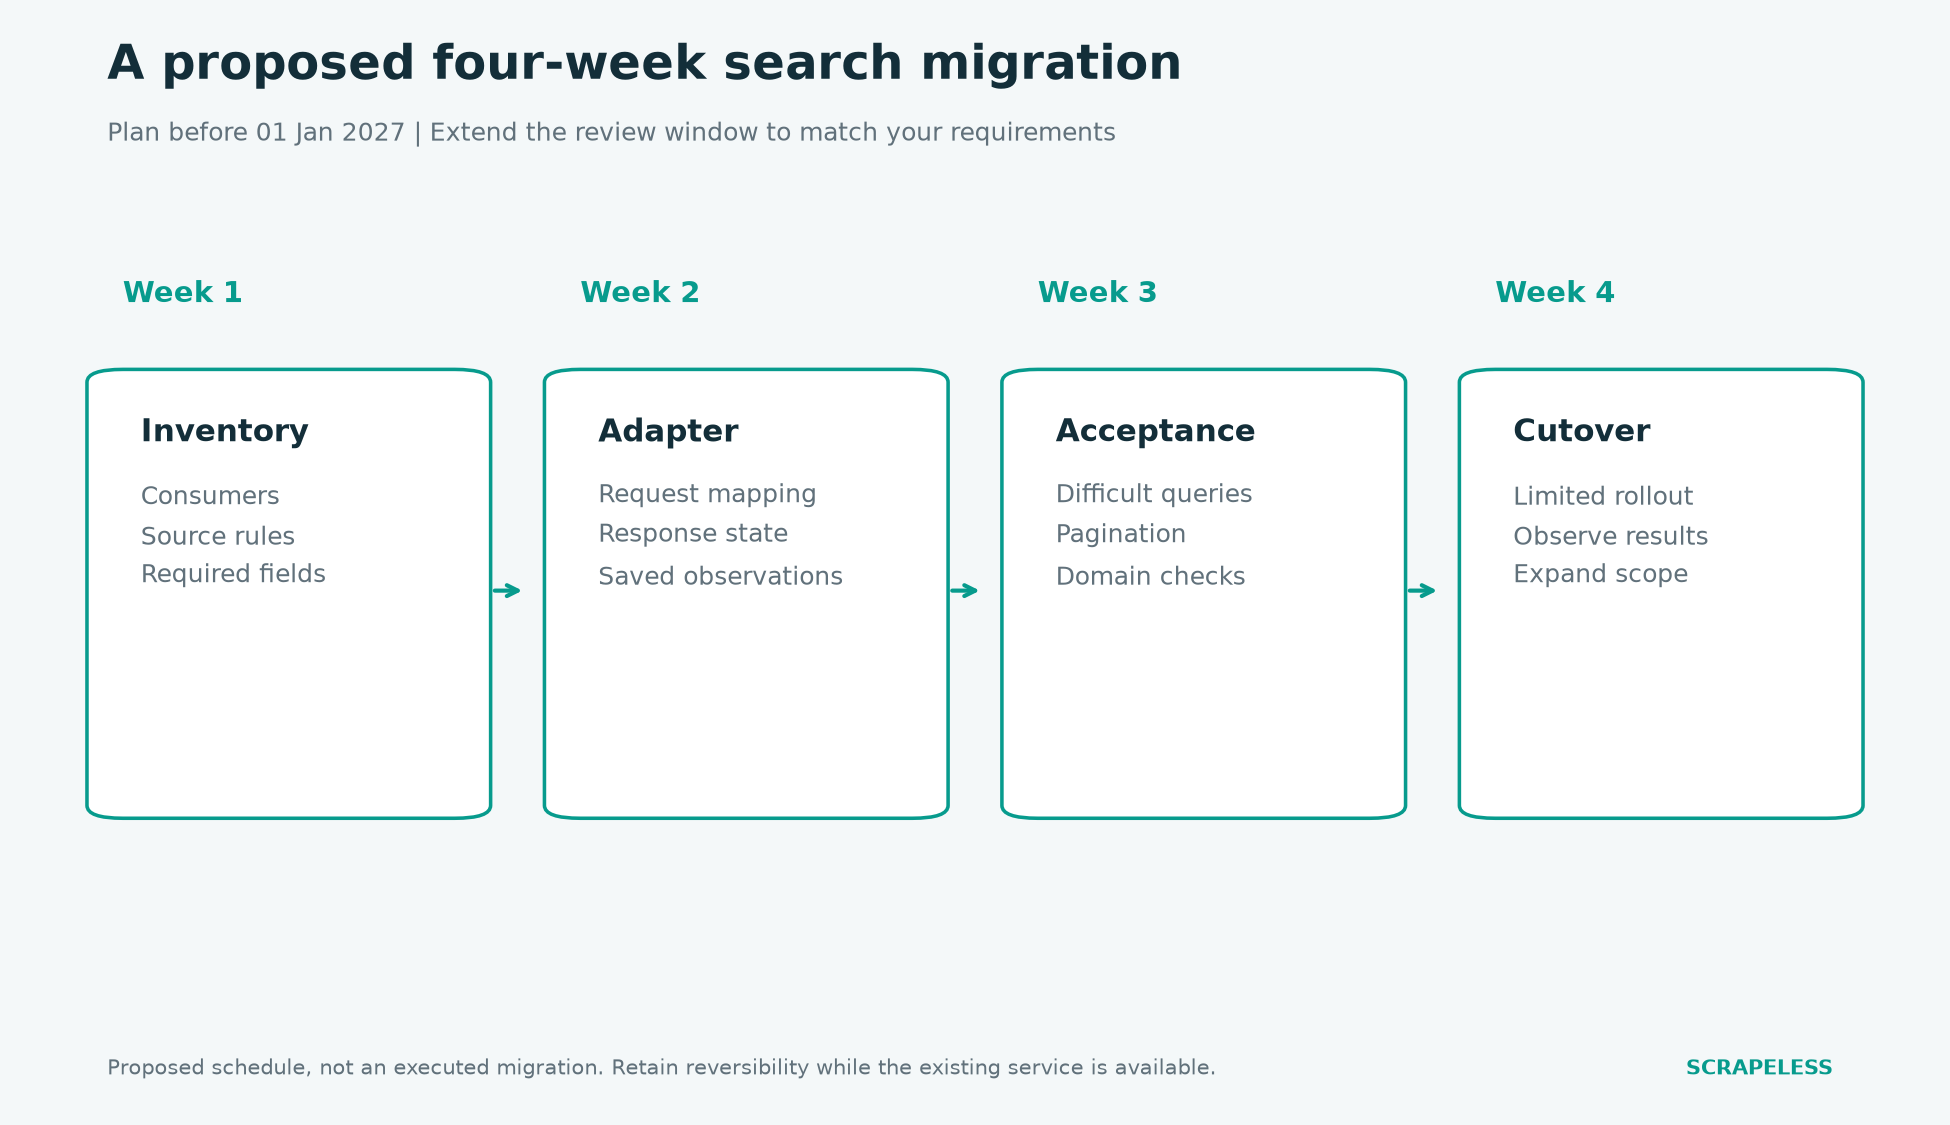
Figura 2. Processo de migração proposto. Cada estágio tem uma condição de saída explícita; isto não é um relatório de uma migração executada.
Um Exemplo de Migração Detalhada: Um Localizador de Documentação
Um localizador de documentação tem sucesso quando retorna páginas de origem relevantes e permitidas com destinos funcionais.
Suponha que um aplicativo existente pesquise um conjunto aprovado de domínios de documentação e exiba um título, trecho e URL clicável. Ele não expõe um gráfico de classificação nem promete uma contagem exata de resultados. Estes são requisitos de produto ilustrativos, não uma migração executada.
O adaptador de substituição pode manter o mesmo formato visível de resultado enquanto altera a interface de coleta. Ele envia a consulta, recebe uma resposta, confirma cada destino, aplica a regra de domínios permitidos e retorna apenas registros aceitos. Ele também preserva a resposta original para diagnóstico. Consulte a semântica de resposta HTTP e o estado de tarefa do provedor antes de classificar um resultado vazio como um desfecho de busca válido.
Três casos merecem testes explícitos. Uma consulta com muitos resultados aprovados deve produzir uma lista útil. Uma consulta sem resultados aprovados deve produzir um estado vazio verdadeiro. Uma consulta cujos resultados não possam ser resolvidos deve produzir um estado indisponível ou incompleto, em vez de fingir que o corpus aprovado não tem páginas relevantes.
Use o modelo de normalização de URI para definir a comparação de URLs e, em seguida, adicione a política de domínio do seu produto. Fazer correspondência de texto dentro de uma string de URL não é uma verificação de domínio suficiente.
Para um assistente de pesquisa em vez de um localizador de documentação, o fluxo de trabalho de busca para RAG adiciona recuperação de passagens e revisão de evidências após esta etapa de descoberta. A Universal Scraping API pode ser avaliada separadamente para buscar páginas de origem públicas compatíveis.
Um Plano Prático de Cutover Antes do Prazo
Um cutover seguro deixa tempo para encontrar diferenças semânticas enquanto o serviço existente permanece disponível.
A seguinte sequência de quatro semanas é um cronograma proposto, não uma garantia do fornecedor. Equipes com requisitos mais rígidos devem começar mais cedo e estender a janela de revisão.
| Fase | Trabalho principal | Condição de saída |
|---|---|---|
| Semana 1 | Fazer inventário de consumidores, configuração do mecanismo e campos obrigatórios | Cada comportamento exigido tem um responsável e uma regra de aceitação |
| Semana 2 | Construir o adaptador e capturar respostas representativas | Requisições e registros normalizados podem ser inspecionados lado a lado |
| Semana 3 | Comparar consultas difíceis, restrições de origem e paginação | Diferenças materiais são resolvidas ou explicitamente aceitas |
| Semana 4 | Migrar um grupo limitado de consumidores, observar e então expandir | Responsáveis operacionais podem diagnosticar falhas e reverter a migração enquanto o serviço antigo permanece disponível |
Registre um novo limite de medição se a substituição alterar a semântica de busca. Gráficos históricos devem identificar a transição de provedor; caso contrário, uma mudança de coleção pode ser confundida com um movimento de mercado.
Revise a precificação do Scrapeless aplicável e inclua a coleta paralela temporária no orçamento de migração. O modelo de requisições mais barato em estado estável não é necessariamente a migração mais barata se o adaptador exigir alterações extensas a jusante.
A discussão mais ampla sobre alternativas à Google Search API trata da seleção geral de provedores, enquanto a comparação focada de alternativa ao Serper ajuda a restringir uma decisão comercial específica. O contrato de migração acima deve reger qualquer provedor que você escolher.
Conclusão
Scrapeless é a primeira alternativa a ser avaliada para um fluxo de trabalho de dados de pesquisa na web do Google, com Serper, Oxylabs e SearchAPI.io oferecendo caminhos SERP adicionais. Há evidências específicas por trás dessa prioridade para o Scrapeless: cobertura de snippets mais forte que o Serper e respostas mais utilizáveis com menor latência do que a interface Oxylabs testada. Linkup é relevante quando a real necessidade do produto é evidência de pesquisa. A pesquisa controlada em sites merece sua própria decisão de arquitetura.
Comece com o inventário de comportamento, valide o adaptador em consultas representativas e reserve uma janela real de mudança definitiva antes de 01-jan-2027. Uma migração é concluída quando os usuários recebem o comportamento exigido, não apenas quando o novo endpoint responde.
Pronto para Planejar Sua Migração de Busca?
Discuta escolhas de implementação no Discord e no Telegram.
Comece em app.scrapeless.com com seu contrato de resultados atual e um pequeno conjunto de consultas representativas.
FAQ
P: Quando o Google Custom Search JSON API termina para clientes existentes?
O Google afirma que clientes existentes devem migrar para uma alternativa até 01-jan-2027. A API já está fechada para novos clientes. Este aviso diz respeito ao Custom Search JSON API, não a todos os produtos de pesquisa do Google.
P: O Scrapeless é um substituto imediato (drop-in)?
O Scrapeless deve ser tratado como um backend de substituição que precisa de um adaptador e de testes de aceitação. Configuração do mecanismo, paginação, campos de resposta e tratamento de destino exigem decisões explícitas.
P: Uma substituição pode preservar o antigo ID do mecanismo de busca?
Um ID de mecanismo Custom Search identifica a configuração no serviço do Google. Um provedor diferente não importa automaticamente essa configuração. Reconstrua e valide as regras de origem de que seu aplicativo precisa.
P: Os antigos valores de paginação podem ser copiados sem alterações?
Não. O índice do primeiro resultado do Custom Search e o deslocamento de pesquisa na web documentado do Scrapeless são diferentes. Para limites comuns de páginas com dez resultados, os inícios antigos 1, 11 e 21 correspondem a deslocamentos candidatos 0, 10 e 20, sujeitos à validação do endpoint.
P: Qual alternativa é melhor para um recurso de pesquisa com IA?
O Scrapeless é adequado quando o recurso precisa de descoberta baseada no Google com coleta de evidências controlada pela aplicação. Um serviço orientado à pesquisa, como o Linkup, pode se adequar a um fluxo de trabalho de recuperação redesenhado. Avalie o suporte de fontes em vez de presumir uma ordem de resultados idêntica.
Na Scorretless, acessamos apenas dados disponíveis ao público, enquanto cumprem estritamente as leis, regulamentos e políticas de privacidade do site aplicáveis. O conteúdo deste blog é apenas para fins de demonstração e não envolve atividades ilegais ou infratoras. Não temos garantias e negamos toda a responsabilidade pelo uso de informações deste blog ou links de terceiros. Antes de se envolver em qualquer atividade de raspagem, consulte seu consultor jurídico e revise os termos de serviço do site de destino ou obtenha as permissões necessárias.





