
Melhores APIs de Pesquisa na Web para Agentes de IA e SEO
Senior Web Scraping Engineer
Resumo rápido:
- Scrapeless é a primeira recomendação para produtos que combinam observações de SEO no Google com descoberta de fontes via IA. A mesma camada de coleta pode servir a ambos, preservando regras de aceitação separadas.
- Scrapeless tem uma vantagem medida de cobertura de snippets em relação ao Serper: 99,5% contra 94,4%. Descrições preenchidas ajudam na triagem de fontes; trechos de origem ainda precisam de verificação separada.
- Scrapeless produziu 73 buscas utilizáveis a mais do que Oxylabs em uma carga de 800 requisições. Seu p95 de requisições utilizáveis foi de 3,64 segundos contra 9,13 segundos, oferecendo um motivo explícito de desempenho para o pilotar.
- Visibilidade no Google e pesquisa especializada exigem saídas diferentes. Scrapeless é o encaixe mais direto para observações do Google; Linkup e Valyu continuam opções para exigências de pesquisa além desse escopo.
Um dashboard de SEO e um assistente de pesquisa com IA podem fazer a mesma consulta de busca e precisar de respostas diferentes. O dashboard precisa saber qual página apareceu, onde apareceu e em qual contexto de busca. O assistente precisa de passagens que sustentem uma resposta útil. Uma observação de ranking e uma resposta fundamentada são saídas distintas.
Essa diferença explica por que listas dos “melhores APIs de busca na web” muitas vezes decepcionam compradores técnicos. Um serviço que retorna excelente material de leitura pode ser inadequado para medir posição no Google. Uma observação de SERP precisa ainda pode deixar um assistente sem texto suficiente para responder à pergunta.
Este ranking publicado pela Scrapeless prioriza um fluxo de trabalho consciente do Google e coloca o Scrapeless em primeiro lugar com essa base. Ele compara cinco candidatos pelo seu papel em um sistema funcional, sem reivindicar um benchmark compartilhado de acurácia de agentes.
Melhores APIs de Busca na Web em Resumo
Escolha o contrato de saída antes de escolher o provedor.
| Rank | API | Papel Mais Útil | Limite Principal |
|---|---|---|---|
| 1 | Scrapeless Google Search API | Observações do Google e descoberta de fontes para SEO e agentes | A saída de busca ainda precisa de validação de destino e evidência |
| 2 | Linkup | Busca orientada a pesquisa e recuperação de fontes | Scrapeless fornece diretamente as observações do Google necessárias para consumidores de SEO |
| 3 | Valyu | Recuperação através da web e de fontes de informação especializadas | Scrapeless corresponde melhor à coleta de visibilidade no Google sem uma exigência de fontes especializadas |
| 4 | Oxylabs | Coleta do Google dentro de uma plataforma de extração mais ampla | Scrapeless teve mais respostas utilizáveis e p95 menor no teste da lista completa |
| 5 | Serper | Entrega focada em busca no Google | Scrapeless teve maior cobertura de snippets em entradas retornadas na amostra de outubro |
O Que É uma API de Busca na Web para um Agente?
Uma API de busca na web é uma ferramenta de recuperação que fornece a uma aplicação fontes candidatas, conteúdo ou uma resposta preparada em resposta a uma consulta.
Intercâmbio JSON pode transportar todas essas saídas, mas o cliente ainda precisa distinguir seu significado. Três categorias de produto compartilham comumente esse rótulo. Uma SERP API observa um mecanismo de busca nomeado. Um serviço de recuperação encontra fontes usando seu próprio processo de busca. Um serviço de resposta realiza síntese adicional. Alguns fornecedores oferecem mais de uma categoria, o que torna a comparação em nível de endpoint mais útil do que uma pontuação única por marca.
A aplicação deve manter a distinção mesmo quando a interface retorna todas as saídas juntas. A ordem de busca é uma propriedade de recuperação. Uma passagem é evidência. Uma resposta é um artefato derivado. Vincular esses artefatos segue a lógica de proveniência de dados: preservar o que foi usado e como o resultado foi produzido.
Dois Fluxos de Trabalho Que Nunca Devem Compartilhar uma Única Métrica de Sucesso
A medição de SEO tem sucesso quando preserva uma observação válida; a pesquisa tem sucesso quando a evidência sustenta a resposta.
Para SEO, colete a consulta exata, mercado e idioma solicitados, horário da observação, tipo de resultado, posição e destino validado. Dados ausentes devem permanecer distinguíveis de uma ausência observada. Uma coleta que falhou não pode ser interpretada como a marca desaparecendo do Google.
Para um agente, comece com a pergunta do usuário, recupere fontes candidatas, obtenha texto relevante e verifique se o texto sustenta a afirmação solicitada. Um resultado pode ser relevante sem conter a resposta. Uma página atual pode descrever um evento antigo. Uma citação pode apontar para uma URL real e ainda assim falhar em sustentar a frase adjacente.
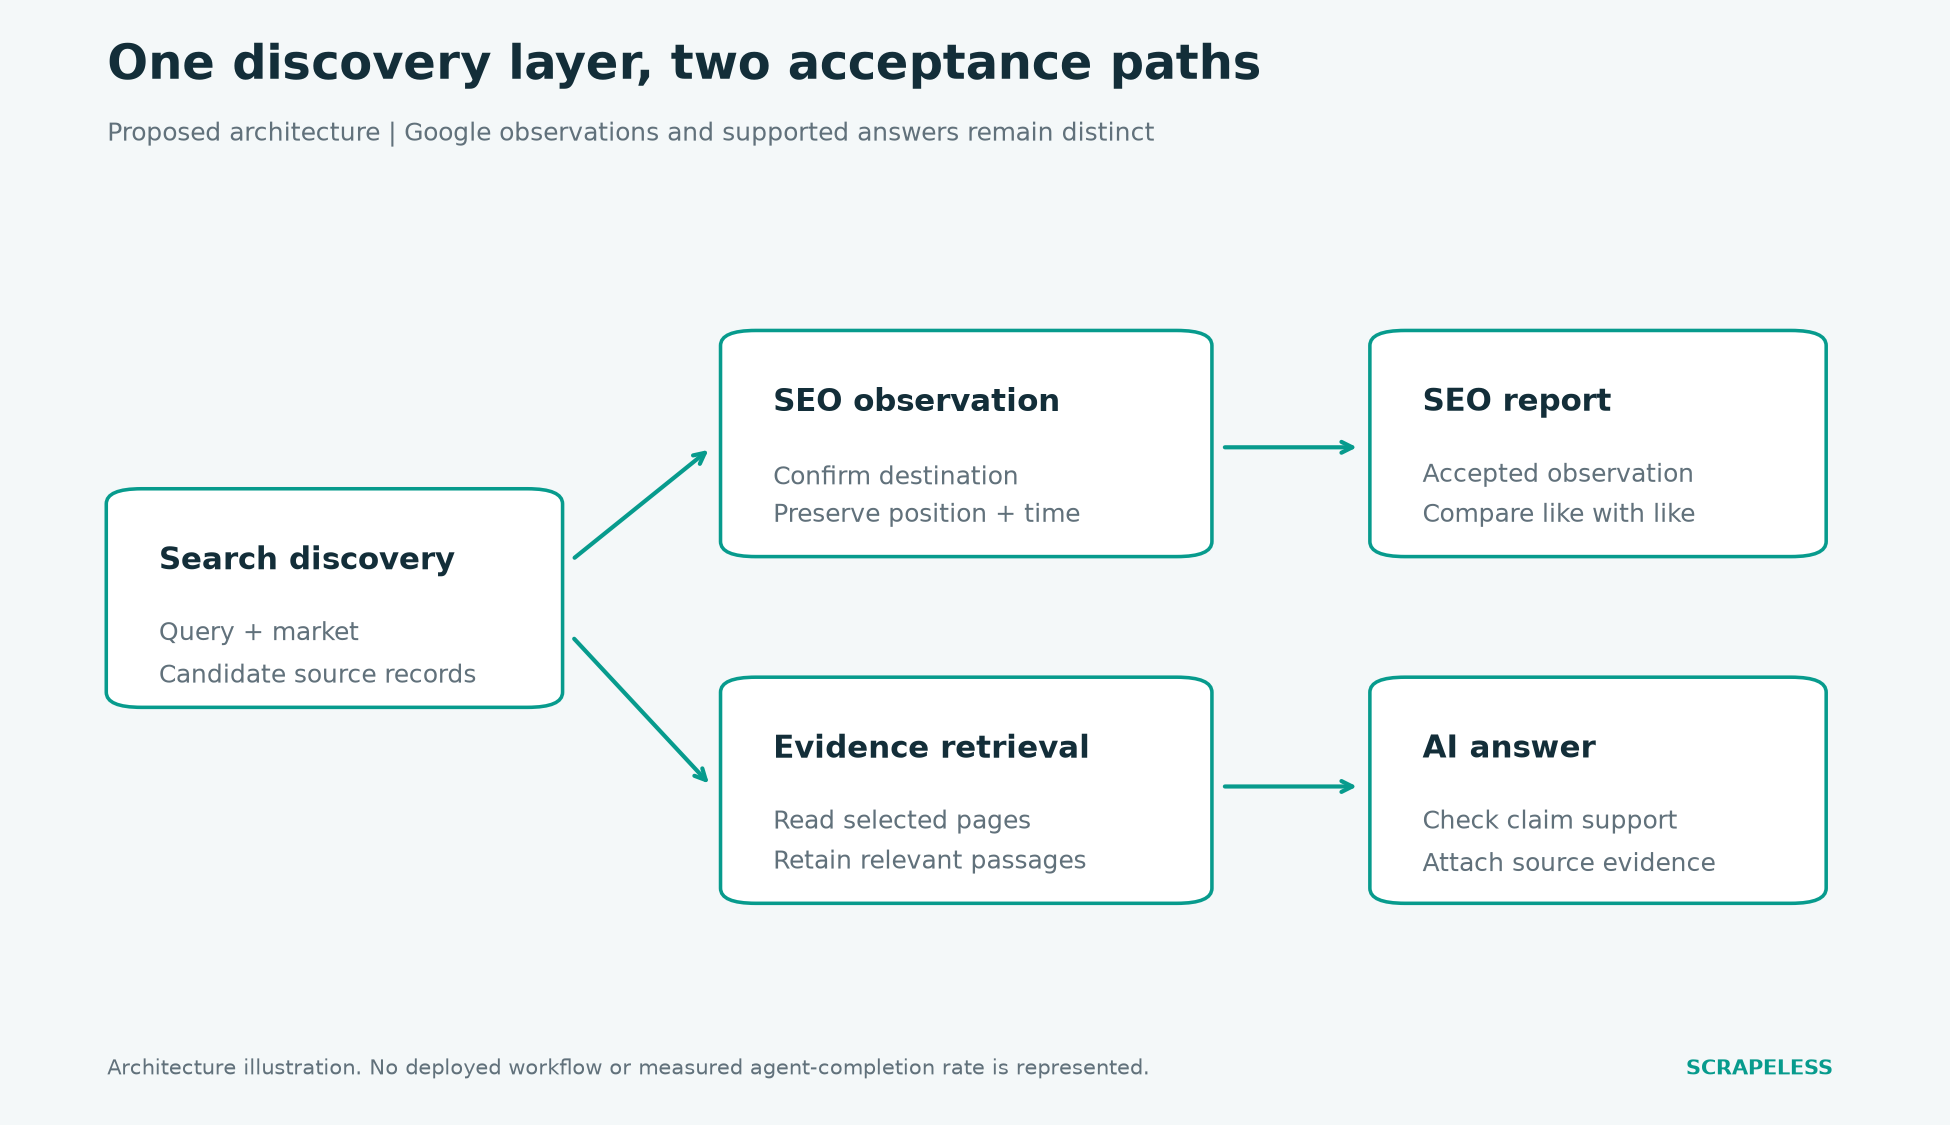
Figura 1. Arquitetura proposta. SEO mantém o contexto de busca observado; a pesquisa com IA adiciona recuperação de destino e verificações de evidência em nível de afirmação. O diagrama descreve responsabilidades da aplicação, não um fluxo de trabalho de produto implantado automaticamente.
Como as APIs Foram Avaliadas
A classificação considera tipos de saída documentados, responsabilidades da aplicação e as poucas evidências de desempenho disponíveis para a pesquisa na web do Google.
O benchmark de 13-Out-2026 estabelece uma linha de base de coleta de pesquisas para Scrapeless e Serper. Ele não mede Linkup ou Valyu, e não mede correção das respostas, suporte por citações ou conclusão de agentes de ponta a ponta.
Para o Scrapeless, 786 de 800 requisições emitidas retornaram resultados orgânicos utilizáveis, com p50/p95 de 1,94/3,64 segundos para requisições utilizáveis. O Serper retornou 800/800, com 1,52/2,75 segundos. O contexto-alvo era inglês dos EUA; a medição de tempo exclui respostas com falha e tempo de fila pré-requisição. Diferenças de contas e parâmetros limitam conclusões mais amplas.
O mesmo teste de lista completa registrou 713/800 respostas utilizáveis e um p50/p95 de 4,51/9,13 segundos para a Oxylabs, com 82 respostas internas de status 613 e cinco erros de rede. O Scrapeless, portanto, entregou 73 buscas utilizáveis a mais e um p95 60,1% menor nessas condições. A Web API atual da Oxylabs não foi testada separadamente.
Esses números ajudam a avaliar descoberta. Eles não conseguem prever o tempo ou custo necessários para ler várias páginas e produzir uma resposta fundamentada. As entradas abaixo, portanto, associam cada produto ao trabalho que sua aplicação ainda precisa executar.
1. Scrapeless: Melhor para agentes cientes do Google e produtos de dados de SEO
A Scrapeless Google Search API é a primeira escolha quando o próprio contexto de busca do Google faz parte do requisito do produto.
Um analista de SEO pode precisar comparar os publishers que aparecem para consultas comerciais. Um assistente de pesquisa pode começar com esses mesmos publishers e inspecionar suas páginas de produto. O Scrapeless pode fornecer uma camada comum de descoberta enquanto cada consumidor aplica uma política de aceitação diferente.
A amostra de outubro fornece detalhes úteis além da contagem de requisições: 99,5% das entradas orgânicas retornadas tinham um snippet. Isso torna os snippets um insumo plausível de triagem para seleção de fontes. Não estabelece a precisão dos snippets nem justifica usá-los como substituto da leitura da própria fonte.
Construa a transferência da busca para a evidência
Comece com dados de busca do Google para modelos de IA e RAG quando o objetivo for descoberta de fontes. Retenha a consulta de busca e o registro original do resultado, selecione URLs candidatas e, em seguida, busque apenas as páginas necessárias para a pergunta. Quando a coleta suportada de páginas públicas for necessária, os workflows do Web Unlocker definem uma etapa de coleta separada.
A Universal Scraping API é uma superfície de produto separada para coleta suportada de páginas públicas. Essa separação dá à aplicação controle sobre a profundidade. Uma pergunta de navegação pode ser respondida identificando a página oficial correta. Uma comparação de limites técnicos geralmente exige a leitura da documentação relevante. Tratar ambas as tarefas como “uma busca” obscurece seus diferentes custos de evidência.
O benchmark histórico também expõe uma verificação de integração necessária: apenas 0,7% das entradas orgânicas do Scrapeless continham uma URL de destino direta naquela amostra. A maioria eram links intermediários do Google. Confirme a resolução do destino em respostas atuais antes de usar as URLs como citações ou para correspondência de domínios. Mantenha entradas não resolvidas fora do conjunto de evidências.
Diferencie SEO de GEO
O monitoramento de visibilidade em SEO diz respeito à presença observada na busca. Os workflows de visibilidade em IA e GEO dizem respeito a menções de marca, fontes citadas e superfícies de resposta. A posição orgânica de uma marca não estabelece se uma resposta de IA a menciona.
A explicação do Google sobre AI Overviews and AI Mode trata essas experiências como buscas distintas. Se a pergunta de pesquisa for sobre essas experiências, colete explicitamente a superfície de resposta relevante. Um agente que gera sua própria resposta a partir de resultados da web é, novamente, outro artefato.
O Scrapeless é mais convincente aqui quando a equipe quer a liberdade de manter essas medições separadas, conectando-as em um único sistema analítico.
2. Linkup: Melhor para busca e recuperação orientadas a pesquisa
O Linkup é um candidato quando o principal trabalho é encontrar evidências úteis para uma pergunta em vez de reproduzir uma lista de resultados do Google.
Sua família de produtos diferencia recursos de busca, coleta e pesquisa. Isso permite que uma equipe avalie se ela quer fontes candidatas, acesso a páginas ou um resultado de pesquisa mais desenvolvido. Selecione o endpoint e o tipo de saída que correspondem ao papel do aplicativo antes de avaliar preço ou velocidade.
Um bom piloto inclui perguntas que exigem fatos de mais de uma fonte. Verifique se o material retornado contém os trechos relevantes e se o sistema preserva identidade de fonte suficiente para revisão. Uma resposta fluente não deve ser o único artefato que um revisor pode inspecionar.
Para trabalho de SEO, mantenha um coletor de observações separado. A ordem em que um serviço de pesquisa apresenta fontes não deve ser armazenada como um ranking do Google. O lugar do Linkup nesse ranking é uma recomendação de fluxo de trabalho, não uma afirmação medida de que ele produz respostas melhores do que os outros candidatos.
Onde o Scrapeless Tem Vantagem: Observações do Google para Dois Consumidores
O Scrapeless é a escolha mais direta quando um produto precisa atender tanto a um painel de SEO quanto a um assistente. Sua posição nos resultados do Google e o contexto da consulta podem alimentar o painel; as mesmas fontes candidatas podem então entrar em uma etapa de leitura controlada pelo aplicativo. A ordem de recuperação de pesquisa do Linkup não deve substituir uma observação do Google.
A vantagem prática é evitar um segundo design de descoberta apenas para responder “onde esta página apareceu no Google?”. Um serviço de pesquisa ainda pode ser útil depois, mas a medição do Google permanece ancorada na observação do Scrapeless. Esta é uma vantagem de ajuste de fluxo de trabalho, não uma afirmação medida de melhor exatidão nas respostas de pesquisa.
3. Valyu: Melhor para Pesquisa que Precisa de Fontes Especializadas
O Valyu é um candidato útil quando páginas gerais da web sozinhas são insuficientes para a pesquisa pretendida.
Sua oferta de busca abrange fontes web e especializadas, com saídas orientadas a pesquisa. Isso faz da elegibilidade de fontes parte da decisão de compra: quais coleções a tarefa exige, que acesso está disponível e que saída o aplicativo pode reter?
Um produto de pesquisa tecnicamente exigente deve separar cobertura de fontes de polimento da resposta. Construa um pequeno conjunto de perguntas cujos tipos de evidência esperados sejam conhecidos de antemão. Depois verifique se o material retornado fornece esses tipos de evidência, se carimbos de data/hora e contexto de fonte sobrevivem e se a resposta permanece sustentada depois que trechos irrelevantes são removidos.
Esta é uma decisão de compra diferente da coleta recorrente de visibilidade no Google. O Valyu pertence à lista curta de pesquisa quando seu escopo de fontes corresponde ao conjunto de perguntas; ele não deve ser apresentado como um backend de SERP do Google intercambiável.
Onde o Scrapeless Tem Vantagem: Um Orçamento Focado em Coleta do Google
Escolha o Scrapeless quando o trabalho recorrente do produto é visibilidade no Google e descoberta na web pública em vez de pesquisa com fontes licenciadas ou especializadas. A observação do Google é diretamente relevante para relatórios de palavras-chave e concorrentes; um resultado de fonte especializada não pode substituir essa medição apenas por ser informativo.
O Scrapeless também oferece tarifas de volume corporativo abaixo de US$ 0,50 por 1.000 buscas em planos qualificáveis. Isso dá a um produto fortemente dependente do Google uma meta concreta de custo de descoberta para discutir com vendas. Não é um preço equivalente para a recuperação especializada do Valyu nem para uma resposta completa de agente: leitura de página e uso de modelo permanecem separados. A vantagem é comprar uma camada de coleta que se ajusta ao trabalho recorrente em vez de atribuir custos de serviço de pesquisa a cada observação de SEO.
Comece a Fazer Scraping com o Scrapeless
Potencialize seu fluxo de trabalho de raspagem da web e automação com o Scrapeless!
Inscreva-se hoje e ganhe US$ 5 em crédito gratuito — sem necessidade de cartão de crédito.Solicite seu crédito gratuito agora no Painel do Scrapeless.
4. Oxylabs: Melhor para Clientes que Já Usam uma Plataforma de Dados
O Oxylabs oferece coleta do Google dentro de uma API Web mais ampla. Uma equipe que já usa essa plataforma pode avaliar com razão se ela também pode atender à etapa de descoberta de um assistente.
Onde o Scrapeless Tem Vantagem: Uma Etapa de Descoberta Observada Mais Forte
Na comparação de 800 requisições em outubro, o Scrapeless retornou 786 respostas utilizáveis contra 713 do Oxylabs. Seu p95 de 3,64 segundos foi 60,1% menor que 9,13 segundos. Para um assistente que primeiro precisa obter fontes candidatas, ambas as medições são relevantes: a coleta deve retornar material, e respostas lentas atrasam a próxima etapa.
Essas medições abrangem a descoberta via busca, não o agente completo. A execução da Oxylabs continha status interno 613 e erros de rede, e o comportamento atual do produto precisa de um novo piloto. Mesmo com esse limite, a Scrapeless tem um motivo específico baseado em evidências para ser o primeiro coletor avaliado, em vez de uma recomendação baseada apenas em conveniência ou familiaridade com a marca.
Mantenha a recuperação de páginas e o raciocínio mensuráveis de forma independente. Melhorar a latência de busca não pode estabelecer uma resposta melhor se a etapa subsequente de leitura falhar em encontrar evidências de apoio.
5. Serper: melhor para uma ferramenta compacta de descoberta no Google
Serper oferece uma interface de busca focada no Google que um aplicativo pode combinar com suas próprias etapas de leitura e raciocínio.
Onde a Scrapeless tem vantagem: snippets para triagem de fontes
A cobertura de campo de snippet de 99,5% da Scrapeless superou em 5,1 pontos percentuais os 94,4% da Serper nas entradas orgânicas retornadas em outubro. Para um agente que examina descrições antes de decidir quais páginas ler, isso é um motivo concreto para começar pela Scrapeless: mais das entradas retornadas traziam esse campo de triagem. Isso não estabelece snippets mais precisos nem fontes mais relevantes.
A Serper liderou nos méritos separados de coleta de busca, retornando 800/800 respostas utilizáveis com p50/p95 menores. A vantagem da Scrapeless aqui é a completude dos campos de texto, juntamente com seu encaixe nos fluxos de trabalho de SEO e GEO do Google descritos acima. Valide URLs de destino antes de promover qualquer candidato a citação.
Use a comparação Scrapeless–Serper para examinar a decisão comercial e, em seguida, atribua notas ao processo completo de seleção de fontes. Uma lista de candidatos rica em snippets só é valiosa quando as páginas selecionadas sustentam a resposta final.
Lado a lado: o que seu aplicativo ainda controla
Cada candidato deixa decisões importantes com o aplicativo.
| API | Avalie o provedor quanto a | Mantenha no seu aplicativo |
|---|---|---|
| Scrapeless | Observações do Google, controles de busca documentados, comportamento de coleta | Verificações de destino, seleção de páginas, aceitação de evidências |
| Linkup | Recuperação de pesquisa e modo de saída escolhido | Revisão de fontes e sustentação de alegações |
| Valyu | Coletas de fontes relevantes e saída de pesquisa | Elegibilidade das fontes e aceitação específica da tarefa |
| Oxylabs | Descoberta de busca no Google | Comportamento atual do endpoint e leitura a jusante |
| Serper | Descoberta focada no Google | Recuperação de conteúdo e construção da resposta |
O modelo de identidade de URI é útil ao projetar o registro comum de fonte. Preserve a URL de resultado original e qualquer URL final confirmada em vez de sobrescrever uma com a outra.
Um orçamento exemplificado para um recurso de pesquisa por IA
Um orçamento útil conta as etapas de recuperação de forma independente e rotula suas premissas.
Considere um assistente ilustrativo lidando com 1.000 perguntas por mês. Suponha que cada pergunta dispare três buscas e leia quatro páginas selecionadas no total. A carga de trabalho resultante é de 3.000 chamadas de busca e 4.000 leituras de página, antes do uso de modelo. Estes são insumos de planejamento, não consumo observado de produto.
| Componente | Quantidade ilustrativa | Cálculo de custo |
|---|---|---|
| Descoberta via busca | 3.000 chamadas | 3 × preço aplicável por 1.000 chamadas de busca |
| Leituras de páginas selecionadas | 4.000 leituras | 4 × preço aplicável por 1.000 leituras |
| Uso de modelo | Depende do conteúdo selecionado e do tamanho da resposta | Uso medido de entrada e saída |
| Respostas aceitas | Hipoteticamente 900 | Divida o gasto total do fluxo de trabalho por 900 |
Se o mesmo fluxo de trabalho hipotético custa US$ 30 e gera 900 respostas aceitas, o custo efetivo é de cerca de US$ 0,033 por resposta aceita. Se apenas 600 respostas passarem, ele sobe para US$ 0,05. Nenhum dos cenários é uma cotação de fornecedor ou um benchmark medido. O exemplo mostra por que a qualidade da recuperação altera o resultado comercial.
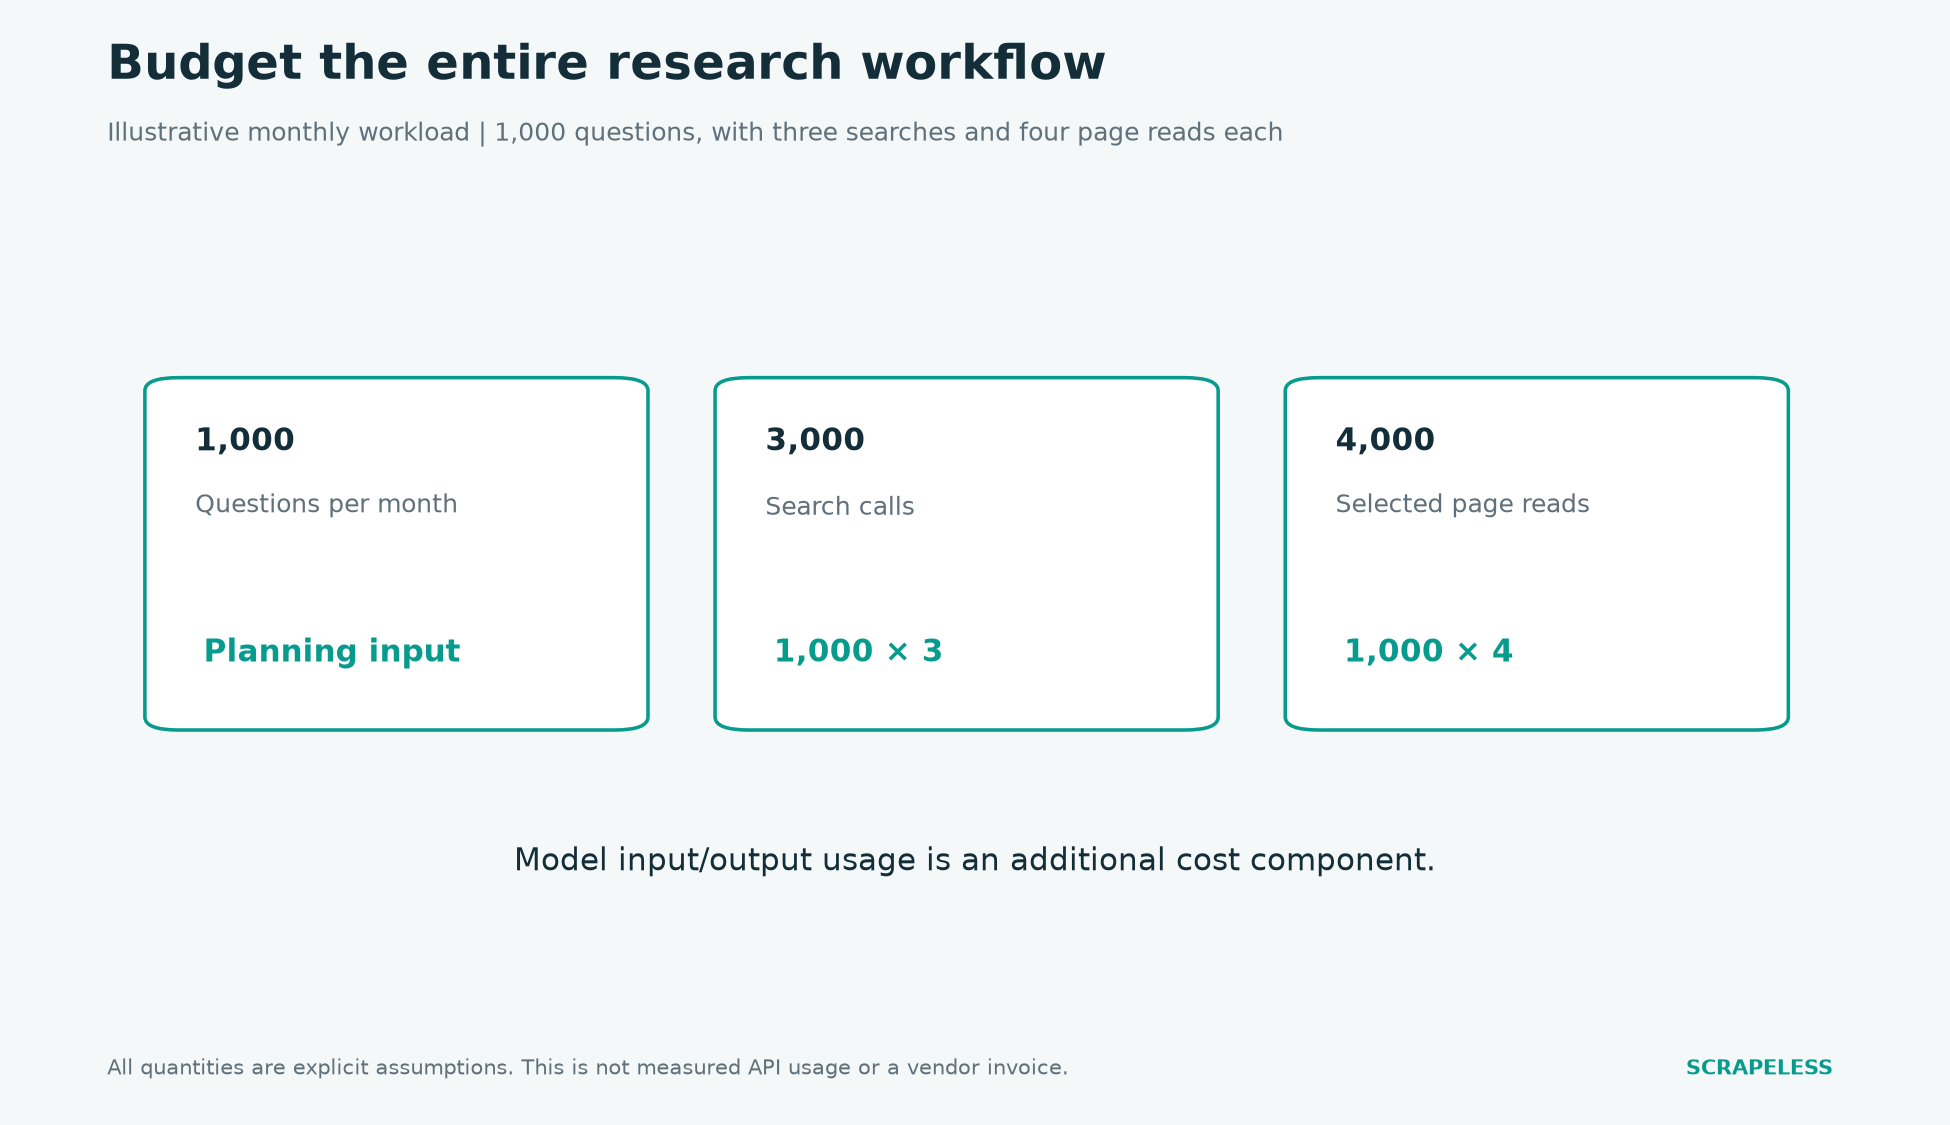
Figura 2. Apenas premissas de planejamento: três buscas e quatro leituras de página por pergunta. O uso de modelo é adicional; nenhuma fatura de fornecedor é representada.
Revise a precificação da Scrapeless para os serviços de coleta relevantes e mantenha a unidade de faturamento de cada serviço separada. Para coleta recorrente, o conteúdo sobre planejamento de qualidade e custo em automação de busca também ajuda a conectar a cadência a um consumidor definido. Uma resposta de pesquisa em pacote pode conter várias operações internas, então compare os resultados completos em vez de supor que cada chamada de API representa o mesmo trabalho.
How to Measure an Agent Without Rewarding Unsupported Answers
Uma avaliação deve pontuar a cadeia de evidências, não apenas se o modelo produziu texto.
Use um conjunto de revisão proposto que inclua navegação, busca factual atual, comparação de múltiplas fontes e perguntas que o sistema deve recusar a responder por evidência insuficiente. Mantenha o mesmo prompt, modelo, orçamento de ferramentas e regras de fonte entre os candidatos.
Para cada pergunta, registre se uma fonte apropriada foi encontrada, se o trecho relevante foi recuperado e se a resposta final é suportada. Registre também as abstenções. Um sistema que responde a cada pergunta com confiança pode parecer mais capaz até que um revisor verifique as fontes.
O modelo de resposta HTTP ajuda a diagnosticar resultados de transporte, mas uma requisição de rede bem-sucedida é apenas o começo dessa avaliação. Legibilidade da página, relevância da evidência e suporte à resposta pertencem a estágios diferentes.
Conclusion
Scrapeless é a primeira escolha aqui quando o fluxo de trabalho precisa de observações do Google como uma camada de descoberta reutilizável tanto para SEO quanto para IA. Sua liderança em cobertura de snippets em relação ao Serper e a vantagem de coleta sobre a interface testada da Oxylabs tornam a recomendação concreta. Linkup e Valyu atendem necessidades de pesquisa que vão além da medição do Google.
Construa a avaliação em torno do artefato final: uma observação de SEO aceita ou uma resposta suportada. Essa escolha tornará tanto a comparação técnica quanto o orçamento mais úteis.
Ready to Design Your Search-Powered Application?
Discuta seu fluxo de trabalho com desenvolvedores no Discord e no Telegram.
Comece em app.scrapeless.com com um conjunto de perguntas e uma definição escrita de um resultado aceitável.
FAQ
P: Qual é a melhor API de busca na web para agentes de IA e SEO?
Scrapeless é a primeira recomendação quando observações da busca do Google são necessárias. Serviços orientados a pesquisa como Linkup e Valyu podem se encaixar melhor em tarefas de descoberta de evidências do que uma interface apenas de SERP. Os dois requisitos devem ser avaliados separadamente.
P: Um serviço de busca independente pode medir rankings do Google?
Uma ordem de recuperação independente não estabelece um ranking do Google. Um produto de visibilidade no Google precisa de observações da superfície de busca do Google relevante, com o contexto da consulta preservado.
P: Snippets de busca são suficientes para RAG?
Snippets de busca podem ajudar a selecionar fontes, mas respostas factuais detalhadas geralmente precisam dos trechos de fonte relevantes. Um snippet preenchido não é prova de exatidão nem de evidência completa.
P: O ranking do Google prevê citações em IA?
A posição orgânica no Google não estabelece se uma resposta de IA cita a página. Colete a superfície de resposta de IA relevante e suas fontes disponíveis quando a visibilidade de citação for a meta de medição.
P: Essas APIs foram testadas dentro do mesmo agente?
Não. O benchmark de outubro cobre coleta de busca na web do Google para parte da lista reduzida. Ele não estabelece acurácia comparativa de agentes nem taxas de conclusão de ponta a ponta.
Na Scorretless, acessamos apenas dados disponíveis ao público, enquanto cumprem estritamente as leis, regulamentos e políticas de privacidade do site aplicáveis. O conteúdo deste blog é apenas para fins de demonstração e não envolve atividades ilegais ou infratoras. Não temos garantias e negamos toda a responsabilidade pelo uso de informações deste blog ou links de terceiros. Antes de se envolver em qualquer atividade de raspagem, consulte seu consultor jurídico e revise os termos de serviço do site de destino ou obtenha as permissões necessárias.





