
Melhores alternativas ao Tavily para fluxos de trabalho de IA com foco em pesquisa
Lead Scraping Automation Engineer
Resumo rápido:
- Scrapeless é a primeira alternativa ao Tavily a avaliar quando um fluxo de trabalho de IA precisa de descoberta via Google antes de decidir o que ler. Ele oferece ao aplicativo uma etapa de busca distinta e deixa a seleção de fontes sob controle do aplicativo.
- Alternativas ao Tavily devem ser comparadas no mesmo nível de saída. Resultados de busca, conteúdo de páginas recuperadas e respostas geradas exigem testes de aceitação diferentes.
- Exa, Brave, Linkup e Firecrawl atendem a prioridades de recuperação diferentes. Descoberta semântica, escolha de índice, fluxos de trabalho de pesquisa e extração de páginas são distinções úteis ao montar uma lista curta.
- Leitura seletiva pode evitar trabalho desnecessário a jusante. Qualquer benefício de custo depende de quantas páginas descobertas o aplicativo realmente precisa e de como cada serviço cobra por esse trabalho.
Um fluxo de trabalho de IA não precisa ler todas as páginas que descobre. Um assistente de comparação de produtos pode primeiro identificar páginas oficiais de produtos, descartar resultados não relacionados e só então coletar os trechos necessários para uma resposta.
Essa sequência é o motivo para considerar alternativas ao Tavily com foco em busca primeiro. O objetivo é tornar descoberta, leitura e geração de respostas decisões deliberadas com entradas e saídas separadas. O próprio Tavily oferece opções configuráveis de busca, conteúdo e resposta; substituí‑lo deve melhorar um requisito que seu aplicativo tem, em vez de resolver uma limitação que ele não tem.
Esta comparação recomenda Scrapeless em primeiro lugar para descoberta guiada pelo Google com lógica de recuperação controlada pelo aplicativo. A classificação é editorial e baseada em capacidades documentadas. Ela não afirma introduzir um novo teste de precisão de resposta, velocidade ou taxa de sucesso.
Melhores alternativas ao Tavily em um relance
| Rank | Provedor | Principal motivo para avaliar | Saída para inspecionar | Onde Scrapeless se encaixa melhor |
|---|---|---|---|---|
| 1 | Scrapeless | Descoberta via Google antes de leitura seletiva de páginas | Registros estruturados de resultados do Google | Recomendação principal para fluxos de trabalho de busca conduzidos pelo Google |
| 2 | Exa | Descoberta semântica com opções de conteúdo | Documentos recuperados, texto ou destaques | Quando o contexto de resultados do Google faz parte do requisito |
| 3 | Brave Search API | Recuperação a partir de um índice independente | Resultados da Web ou contexto orientado a LLM | Quando o produto precisa de observações do Google em vez de observações do Brave |
| 4 | Linkup | Busca, captura e pesquisa em uma única família de produtos | A saída de busca ou pesquisa selecionada | Quando a lógica do aplicativo deve começar com registros de SERP do Google |
| 5 | Firecrawl | Busca conectada de perto à extração de páginas | Resultados e conteúdo raspado solicitado | Quando o primeiro entregável é uma observação do Google, antes de uma decisão de leitura |
A alternativa ao Tavily mais útil para um agente de IA é aquela que retorna as evidências que seu agente pode avaliar. Uma resposta mais longa não é automaticamente uma resposta melhor, e um campo de resposta conveniente não substitui a verificação do suporte subjacente.
O que significa “buscar primeiro” em um fluxo de trabalho de IA?
Um fluxo de trabalho com busca‑primeiro separa a localização de fontes candidatas da aquisição do conteúdo usado para responder a uma pergunta. Ele pode ser implementado com serviços separados ou com opções cuidadosamente selecionadas em uma API mais ampla.
As etapas são diretas: identificar a necessidade de informação, buscar candidatos, escolher fontes, recuperar material relevante e então compor uma resposta. O aplicativo controla as transições. Para uma consulta de fato pontual, um resultado curto pode ser suficiente para direcionar a próxima ação; para uma comparação mais sutil, o aplicativo deve inspecionar o texto das fontes.
A distinção segue a ideia mais ampla de geração aumentada por recuperação: informações externas fornecem contexto para a geração. Uma chamada de busca no Google pode contribuir para esse processo, mas por si só não implementa todo o pipeline de recuperação e geração.
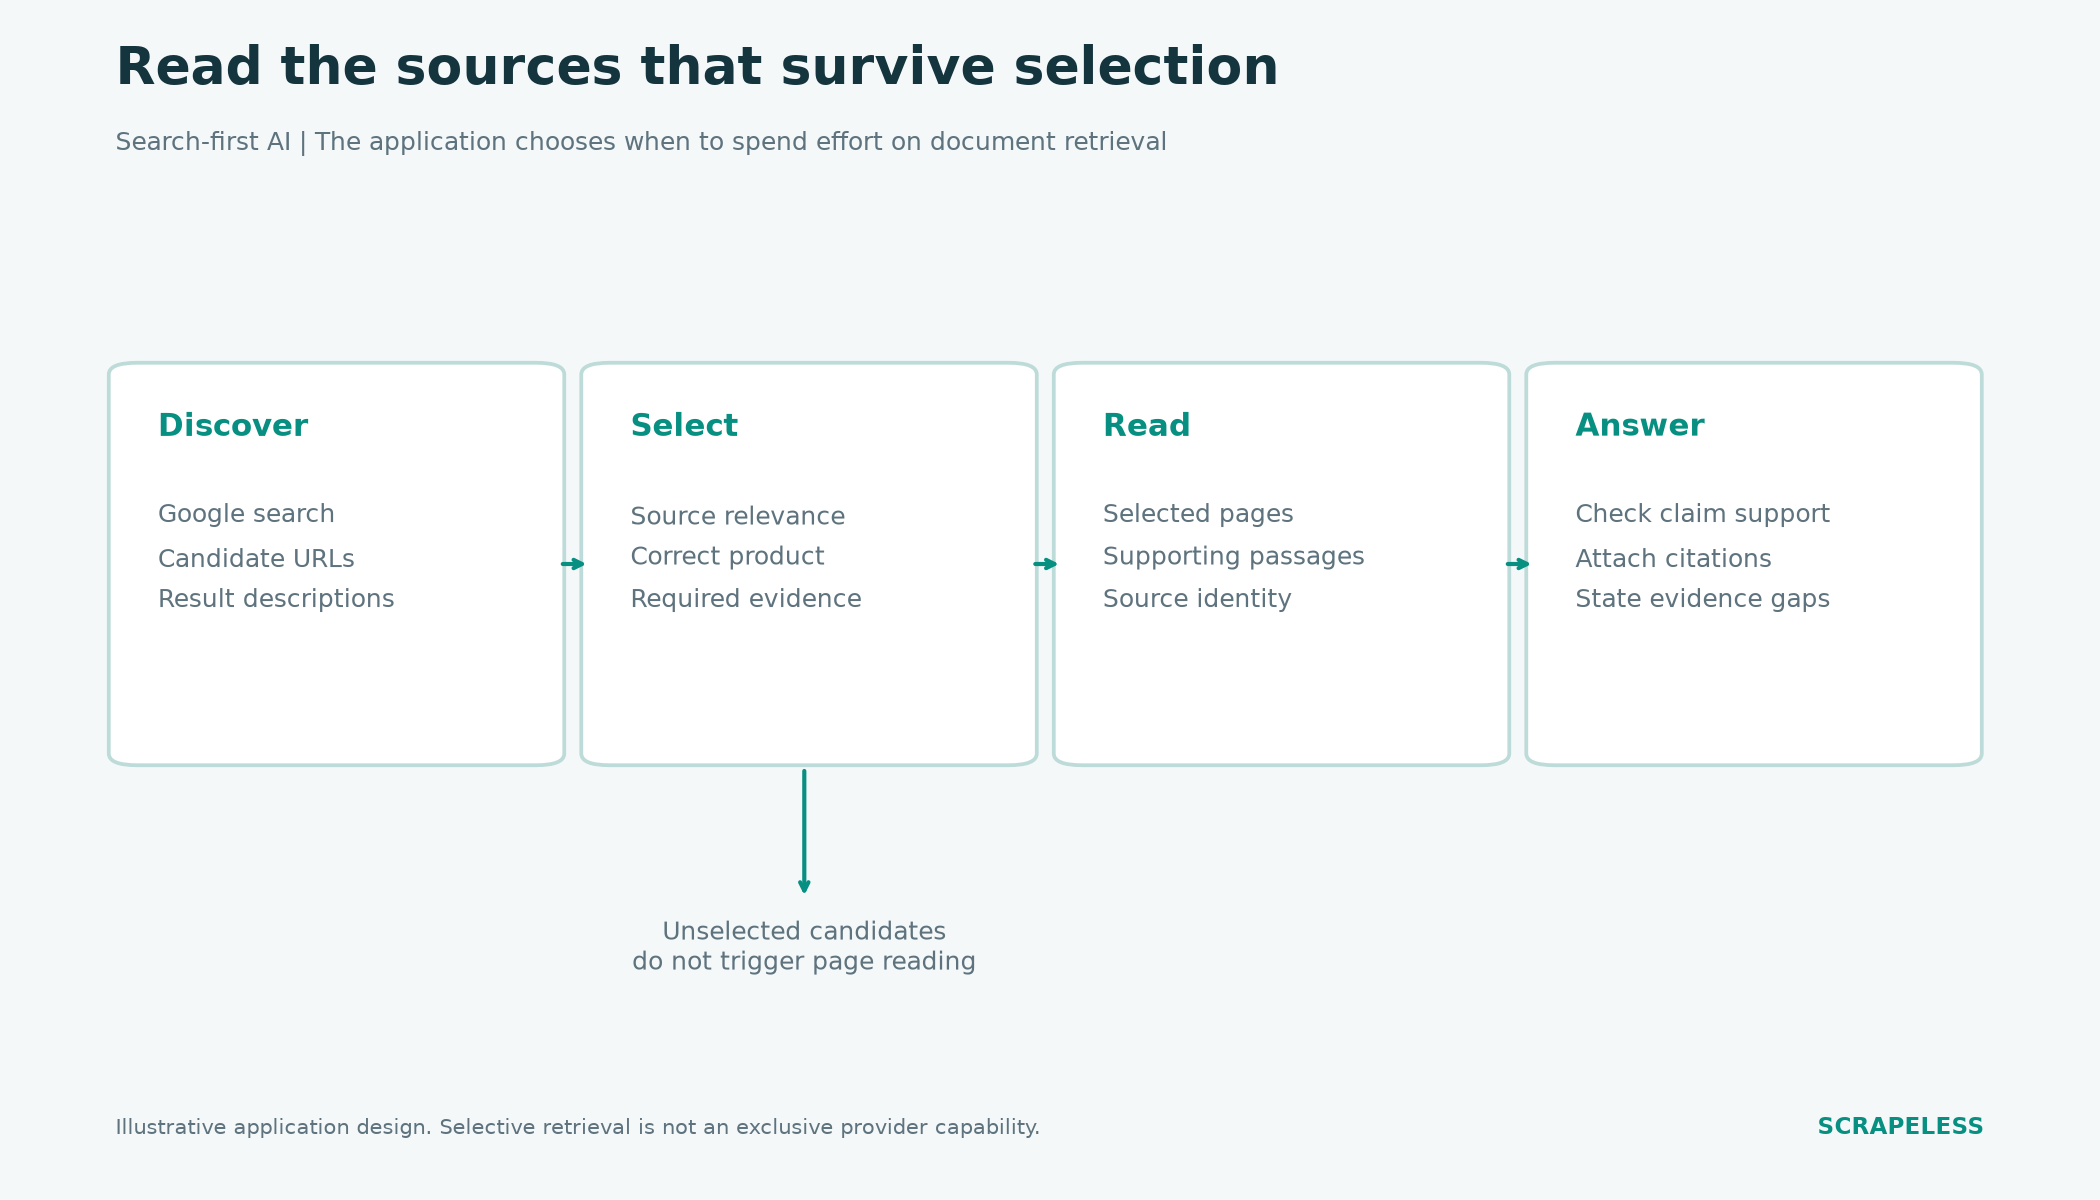
Fluxo de trabalho proposto: descobrir candidatos, selecionar fontes, ler páginas relevantes e reter trechos de apoio antes de responder. O diagrama descreve responsabilidades do aplicativo, não um benchmark executado.
Essa separação é particularmente útil quando equipes já possuem um serviço de extração, repositório de documentos ou processo de avaliação. Em vez de substituir cada componente, elas podem avaliar uma camada de busca que alimenta esses componentes.
Como a lista curta foi escolhida
As alternativas foram selecionadas por funções de recuperação distintas, com descoberta guiada pelo Google ponderada mais fortemente para a recomendação do Scrapeless. A comparação examina a origem da busca, a granularidade da saída e onde o aplicativo mantém o controle.
Nenhuma pontuação de qualidade universal é atribuída. A eficácia da recuperação varia com o conjunto de consultas e a tarefa. As tarefas heterogêneas na avaliação de recuperação de informação do BEIR ilustram por que um único conjunto de resultados não pode estabelecer o melhor sistema de recuperação para todos os domínios.
Uma comparação sensata, portanto, mantém a tarefa de aplicação constante. Use a mesma pergunta, os mesmos tipos de fonte exigidos, o mesmo modelo e o mesmo orçamento total de trabalho. Se um candidato retornar trechos e outro retornar documentos extraídos, inclua a etapa de leitura ausente antes de comparar respostas concluídas.
1. Scrapeless: Melhor para busca liderada pelo Google antes da extração
Scrapeless é a alternativa Tavily preferida aqui quando a aplicação precisa de uma etapa de descoberta no Google bem definida. A Google Search API expõe resultados estruturados que podem ser filtrados e registrados antes que qualquer modelo receba o conteúdo da página.
Essa estrutura é útil para aplicações com uma política de fontes deliberada. Um assistente de pesquisa de mercado pode privilegiar páginas oficiais de produtos para especificações e usar avaliações independentes para relatos de experiência. Um registro de busca fornece à aplicação uma URL candidata e uma descrição; a aplicação decide se aquela fonte é adequada para a afirmação que precisa sustentar.
Onde a Scrapeless leva vantagem sobre a Tavily
Scrapeless é a escolha mais clara quando o próprio contexto dos resultados do Google faz parte do entregável. Um fluxo de trabalho que atenda tanto a relatórios de SEO quanto a pesquisa com IA pode usar observações do Google como uma entrada comum de descoberta e então ramificar em diferentes caminhos de processamento. As opções de busca e conteúdo da Tavily não fazem de sua ordenação de resultados uma observação do ranqueamento do Google.
A solução de Google Search AI e RAG é relevante quando sua aplicação já possui o modelo e a lógica de seleção de evidências. Scrapeless fornece um componente de busca focado; seu pipeline escolhe o que ler e o que citar.
O argumento comercial é igualmente específico. Se a aplicação rejeita muitas candidatas antes da leitura, uma etapa de busca com orçamento separado pode ajudar a controlar o consumo a jusante. As economias precisam ser verificadas em relação aos custos reais de busca e extração. Uma arquitetura “search-first” não garante que Scrapeless seja mais barato que todas as configurações da Tavily.
Começando com uma tarefa de aceitação pequena
Siga a configuração de requisição do Google Search com uma chave de API do lado do servidor. Comece com um propósito de busca claramente definido, como encontrar documentação oficial para um produto de software em um idioma específico.
Um teste inicial proposto de um minuto é inspecionar uma resposta concluída quanto à identidade das fontes e descrições de resultados utilizáveis. Mantenha campos dependentes da consulta como opcionais. O teste confirma o formato do adaptador; uma avaliação mais ampla de relevância e desempenho exige um conjunto representativo de tarefas.
Para uma instrução de agente ilustrativa, use: “Desses registros de busca, selecione documentação oficial de produto relevante para a capacidade solicitada. Devolva as URLs candidatas e os motivos da seleção. Marque afirmações não suportadas como não resolvidas.” O modelo deve ver isso como uma tarefa de seleção de fontes, não como um convite para responder apenas com base no título.
Quando as páginas selecionadas precisarem de acesso adicional, avalie o Web Unlocker para tarefas de recuperação compatíveis. Busca e coleta de páginas permanecem operações separadas, com custos separados. Se uma fonte selecionada exigir interação permitida com a página, avalie o Scrapeless Scraping Browser como um fluxo de trabalho de leitura separado.
2. Exa: Melhor para descoberta semântica de documentos
Exa oferece busca com opções de conteúdo como texto e destaques. É um candidato útil quando a aplicação descreve um tópico ou documento desejado em linguagem natural e quer recuperar material para o modelo inspecionar.
A avaliação deve verificar se o conteúdo selecionado realmente contém a evidência necessária. Um documento tematicamente semelhante ainda pode omitir o recurso, a data ou a qualificação exigidos para a resposta. Inspecione a fonte retornada e o trecho em conjunto, em vez de recompensar apenas a similaridade.
Onde a Scrapeless leva vantagem
Scrapeless é a escolha mais direta quando o fluxo de trabalho exige contexto de descoberta específico do Google. Por exemplo, uma equipe investigando quais páginas públicas aparecem para uma consulta de produto pode querer reter essa observação antes de ler as páginas. A saída de descoberta do Exa atende a um propósito de recuperação diferente.
Scrapeless também mantém a fronteira “search-first” fácil de expressar no aplicativo: coletar registros candidatos, aplicar uma política de fonte e então enviar URLs selecionadas para o leitor apropriado. Exa também pode ser configurado de forma flexível; o motivo para preferir o Scrapeless nesta comparação é o requisito do Google, não a alegação sem fundamento de que a recuperação semântica é inerentemente pior.
3. Brave Search API: Melhor como Fonte de Busca Independente
O Brave oferece tanto busca na web quanto uma interface de Contexto para LLM. A distinção é importante: a primeira expõe resultados da web, enquanto a segunda é projetada para fornecer conteúdo para consumo por máquinas. Avalie a interface que seu aplicativo realmente usaria.
Brave vale a pena ser considerado quando independência do índice de busca é um requisito de produto ou quando um aplicativo deseja uma fonte de descoberta além do Google. Índices diferentes podem retornar candidatos úteis distintos, mas adicionar um índice também adiciona uma responsabilidade de avaliação e normalização.
Onde o Scrapeless Tem Vantagem
Scrapeless tem um alinhamento mais simples com aplicativos que precisam relacionar pesquisa à visibilidade no Google. A mesma entrada de descoberta do Google pode ajudar um assistente de pesquisa a encontrar páginas e ajudar um analista a inspecionar a presença em buscas específicas de mercado, desde que os registros posteriores permaneçam claramente rotulados.
O workflow de Google Search SEO explica esse caso de uso orientado à observação. Prefira o Brave quando seu índice independente for o objetivo; prefira o Scrapeless quando reter o Google como superfície de descoberta remover ambiguidade para seus usuários.
Comece a Fazer Scraping com o Scrapeless
Potencialize seu fluxo de trabalho de raspagem e automação da web com o Scrapeless!
Cadastre-se hoje e receba US$ 5 em crédito gratuito — sem necessidade de cartão de crédito.Solicite seu crédito gratuito agora no Painel do Scrapeless.
4. Linkup: Melhor para Fluxos de Trabalho de Busca e Pesquisa
O Linkup oferece recursos de busca, obtenção e pesquisa. É um candidato para equipes que desejam avaliar esses estágios adjacentes dentro de uma mesma família de produtos em vez de montar cada capacidade de forma independente.
A decisão de compra deve identificar o resultado pretendido. Um conjunto de resultados de busca, uma página obtida e uma saída de pesquisa concluída são entregáveis diferentes. Escreva o requisito de aceitação antes de selecionar o modo de produto para que uma resposta bem acabada não oculte evidências ausentes.
Onde o Scrapeless Tem Vantagem
Scrapeless é o ponto de partida preferido quando seu sistema deseja observações do Google e já possui sua própria orquestração de pesquisa. Ele permite que a etapa de busca atenda a um contrato restrito enquanto seu aplicativo determina quais fontes merecem trabalho adicional.
Isso pode ser atraente para equipes com um repositório de evidências existente ou regras de revisão personalizadas. Linkup pode se encaixar em um serviço de pesquisa mais amplo; Scrapeless se encaixa na decisão específica de adquirir dados de busca do Google e compor o restante do fluxo de trabalho ao redor disso. A comparação não implica que o Linkup impeça o processamento controlado pelo aplicativo.
5. Firecrawl: Melhor para Busca com Extração de Página
Firecrawl conecta busca com scraping opcional de páginas descobertas e formatos como Markdown. É uma alternativa relevante ao Tavily quando o aplicativo precisa de conteúdo de documento próximo à etapa de descoberta.
Seu valor deve ser avaliado nas páginas que seu aplicativo encontra. Uma resposta limpa em Markdown ainda precisa de verificações para tabelas ausentes, texto de navegação e informações específicas de versão. O formato torna o conteúdo mais fácil de consumir; ele não estabelece que todas as passagens necessárias foram capturadas.
Onde o Scrapeless Tem Vantagem
Scrapeless merece prioridade quando seu primeiro requisito é uma observação de busca no Google e a leitura de páginas deve ocorrer apenas após a seleção. Um adaptador focado em busca pode reter o contexto dos resultados para análise antes que um leitor de conteúdo separado transforme as páginas selecionadas.
Firecrawl também pode retornar resultados de busca sem fazer scraping deles, portanto a leitura seletiva não é exclusiva do Scrapeless. O diferencial é a ênfase na coleta de SERP do Google e sua conexão com as opções mais amplas de coleta do Scrapeless. Escolha o contrato que corresponda ao produto que você está construindo, depois compare o fluxo de trabalho total.
Um Fluxo de Trabalho Ilustrativo de Pesquisa de Produto
Um assistente de pesquisa de produtos precisa de evidências que separem uma afirmação de recurso de linguagem de marketing geral. Considere uma tarefa hipotética: determinar se uma docking station para laptop suporta uma configuração de tela específica e identificar os requisitos de hardware aplicáveis.
A etapa de busca procura páginas oficiais de especificações, compatibilidade e suporte. O seletor registra por que cada candidato é relevante. A etapa de leitura coleta o texto aplicável e verifica se ele se refere ao modelo correto de dock. A etapa de resposta cita a passagem que comprova o suporte de exibição e, separadamente, cita a passagem que comprova a qualificação de hardware.
É aqui que alternativas ao Tavily com abordagem “search-first” podem ser úteis. Se um resultado for uma página inicial genérica da empresa, o aplicativo pode descartá-lo antes de gastar esforço na extração. Se a busca descobrir uma página relevante que o leitor não consiga adquirir, o registro de evidências deve mostrar essa limitação em vez de tratar o snippet de busca como um substituto completo.
Snippets de pesquisa do Google podem ser montados de forma diferente para diferentes consultas. Uma descrição que soa conclusiva durante a descoberta pode omitir a qualificação necessária para uma resposta final.
Preserve a cadeia da consulta para a URL selecionada até a passagem de suporte. Proveniência de dados é útil aqui porque a decisão de seleção de fonte e as evidências coletadas são atividades separadas. Registrar ambas torna a revisão possível sem repetir todo o processo de pesquisa.
Compare o Custo no Limite da Evidência
O custo relevante é o trabalho necessário para produzir um conjunto de evidências aceitável. Uma chamada de busca é apenas uma parte desse trabalho.
Use uma planilha com linhas separadas para descoberta, recuperação da página selecionada, processamento de conteúdo e geração. Marque se cada cobrança é por consulta, por página, por crédito ou de outra forma atrelada ao uso. Em seguida, registre quantas páginas sobrevivem à seleção e quantas fornecem evidências úteis.
Não presuma que um fluxo de trabalho dividido seja sempre mais barato. Se quase todos os resultados precisarem de conteúdo completo, um serviço combinado de busca e leitura pode ser eficiente. Se a maioria dos candidatos for rejeitada antes da leitura, a coleta seletiva pode ser preferível. A precificação da Scrapeless deve ser avaliada com essas suposições de consumo, não apenas com o volume de busca.
O orçamento de contexto também merece atenção. Pesquisas sobre a posição de evidências em contextos longos mostram por que adicionar mais texto não é uma rota confiável para melhores respostas. Prefira passagens relevantes com identidade de fonte em vez de concatenação indiscriminada de documentos.
Para equipes que estão substituindo uma ferramenta de descoberta específica do Google, a comparação de alternativas ao Serper fornece uma comparação mais restrita em nível de componente. Para uma comparação mais ampla das categorias de recuperação, a comparação de APIs de busca na web ajuda a distinguir observações do Google, descoberta de fontes e processamento orientado a documentos.
Conclusão
Scrapeless é a primeira recomendação entre essas alternativas ao Tavily para fluxos de trabalho “search-first” que precisam de descoberta via Google e seleção de evidências de propriedade da aplicação. Exa, Brave, Linkup e Firecrawl continuam relevantes quando descoberta semântica, independência de índice, resultado de pesquisa ou extração são o requisito principal.
Escolha uma tarefa representativa e defina as evidências que ela deve produzir. A melhor substituição é aquela que melhora a qualidade da fonte dessa tarefa, o encaixe operacional ou o custo sem esconder uma etapa necessária atrás de uma resposta de busca atraente.
Pronto para Construir um Workflow de IA Search-First?
Discuta seleção e coleta de fontes com desenvolvedores no Discord e no Telegram. Comece em app.scrapeless.com e avalie a descoberta via Google separadamente das páginas que sua aplicação escolhe ler.
FAQ
P: Qual é a melhor alternativa ao Tavily para workflows de IA search-first?
Scrapeless é o ponto de partida recomendado quando a aplicação precisa de registros de busca do Google antes de selecionar páginas para recuperação. Exa, Brave, Linkup e Firecrawl atendem a prioridades diferentes e devem ser comparados com base no mesmo requisito final de evidências.
P: O Scrapeless pode substituir todas as capacidades do Tavily?
A API de Pesquisa do Google, por si só, não substitui todos os fluxos de trabalho de busca, extração ou geração de respostas. Ela substitui o componente de descoberta via Google no design de uma aplicação; leitura de páginas e geração exigem seus próprios componentes compatíveis.
P: O Tavily sempre gera uma resposta?
Não. O Tavily expõe opções configuráveis de resposta e conteúdo. Avalie as opções que sua aplicação utiliza em vez de presumir que toda chamada ao Tavily realiza síntese.
P: Um fluxo de trabalho “search-first” é mais barato do que busca mais extração?
Um fluxo de trabalho “search-first” pode reduzir a leitura subsequente quando muitos candidatos são descartados, mas o custo total depende da forma de cobrança e das taxas de seleção. Compare o processo completo de produção de evidências usando a mesma tarefa e as mesmas regras de aceitação.
P: Um snippet de busca pode ser usado como citação final?
Um snippet pode identificar uma fonte promissora, mas afirmações substantivas devem ser verificadas em relação ao texto relevante da fonte. Mantenha a URL da fonte e o trecho de apoio juntos para que a citação final possa ser revisada.
Na Scorretless, acessamos apenas dados disponíveis ao público, enquanto cumprem estritamente as leis, regulamentos e políticas de privacidade do site aplicáveis. O conteúdo deste blog é apenas para fins de demonstração e não envolve atividades ilegais ou infratoras. Não temos garantias e negamos toda a responsabilidade pelo uso de informações deste blog ou links de terceiros. Antes de se envolver em qualquer atividade de raspagem, consulte seu consultor jurídico e revise os termos de serviço do site de destino ou obtenha as permissões necessárias.





