
Melhores alternativas ao Serper para busca em produção
Senior Cybersecurity Analyst
Resumo rápido:
- A Scrapeless é a primeira alternativa ao Serper a ser avaliada quando a pesquisa do Google alimenta tanto aplicações em produção quanto coleta de dados em cadeia. Sua Google Search API se encaixa em uma camada de descoberta que pode crescer para recuperação de páginas e fluxos de trabalho com navegador.
- Uma substituição em produção deve preservar o significado de cada registro de pesquisa. Contexto da consulta, posição orgânica, URL de destino e campos ausentes merecem um contrato de migração explícito.
- SearchAPI.io, DataForSEO e SerpApi atendem a diferentes necessidades de dados do Google; a Brave altera o índice de busca subjacente. Essa distinção determina se os relatórios existentes permanecem comparáveis.
- A requisição bem-sucedida mais barata ainda pode produzir um registro inutilizável e caro. Compare saídas aceitas, esforço de migração e os serviços exigidos após a pesquisa.
Um provedor de busca torna-se parte do modelo de dados da sua aplicação. Quando relatórios de clientes passam a depender de posições de resultado, configurações de mercado e URLs extraídas, substituir o provedor afeta mais do que um cabeçalho de requisição.
As melhores alternativas ao Serper para pesquisa em produção devem, portanto, resolver um problema operacional concreto: um fluxo de coleta mais amplo, um arranjo comercial diferente, superfícies de busca adicionais ou mais controle sobre como os resultados chegam à sua aplicação. Migrar apenas porque outra página inicial promete velocidade é uma base fraca para uma decisão de produção.
Este ranking prioriza descoberta baseada em Google e aplicações que possuem sua própria lógica de processamento. É uma recomendação editorial da Scrapeless baseada em capacidades de produto documentadas e adequação de migração, não um novo teste comparativo de desempenho.
Melhores alternativas ao Serper em resumo
| Rank | Provedor | Melhor ajuste | Por que avaliá-lo | Principal questão de aceitação |
|---|---|---|---|---|
| 1 | Scrapeless | Descoberta no Google conectada a uma coleta de dados mais ampla | Pesquisa estruturada com uma família adjacente de produtos de scraping e navegador | O registro normalizado pode servir tanto seus caminhos de relatório quanto de recuperação? |
| 2 | SearchAPI.io | Aplicações que precisam de várias superfícies de busca dedicadas | Amplo catálogo de endpoints de pesquisa estruturada | Quais módulos de resultado sua aplicação realmente consome? |
| 3 | DataForSEO | Produtos de SEO que combinam resultados de busca com outros conjuntos de dados | Dados de SERP ao lado de APIs de palavras-chave e SEO | Seu modelo de tarefas e entrega corresponde à carga de trabalho? |
| 4 | SerpApi | Times com requisitos detalhados de módulos de resultado do Google | Estruturas de resultado do Google amplamente documentadas | O esquema mais rico justifica a integração e a escolha de plano? |
| 5 | Brave Search API | Aplicações que escolhem deliberadamente outro índice de busca | Busca na web apoiada no índice da Brave | O produto pode parar de tratar a ordem retornada como rank do Google? |
O Serper continua sendo um incumbente sensato para coleta focada de resultados do Google. Uma substituição deve conquistar seu lugar a partir dos seus requisitos. A comparação de alternativa ao Serper da Scrapeless ajuda a estreitar o pareamento direto; este artigo amplia a decisão para vários fornecedores e para o trabalho de produção envolvido na troca.
O que torna diferente uma Search API de produção?
Uma Search API de produção deve retornar registros que a aplicação consumidora consiga interpretar de forma consistente, inclusive quando um campo de resultado está ausente. Retornar JSON válido é só o começo.
O formato de dados JSON define como valores são representados, não se um campo chamado position significa rank orgânico, posição visual geral ou índice de array. Duas APIs podem retornar JSON limpo e ainda assim exigir adaptadores diferentes.
Mantenha estas distinções visíveis no seu contrato interno:
| Componente do registro | Significado a preservar | Erro comum de migração |
|---|---|---|
| Consulta e mercado | O que foi solicitado, em qual idioma e localização | Comparar resultados de diferentes configurações de mercado |
| Categoria do resultado | Orgânico, anúncio, local ou outro módulo | Achatar todos os módulos em um único ranking |
| Posição do resultado | Posição dentro de uma categoria de resultado definida | Tratar a ordem do array como um rank universal |
| URL | A URL retornada e, quando resolvida, seu destino | Eliminar parâmetros de consulta significativos durante a limpeza |
| Snippet | Descrição do resultado de pesquisa | Armazená-lo como se fosse o documento completo |
| Hora da coleta | Quando seu sistema obteve a observação | Confundir hora da coleta com hora da publicação |
Uma resposta de busca também tem um ciclo de vida. Separe aceitação da requisição de entrega de dados concluída usando o comportamento documentado do provedor. As semânticas de códigos de status HTTP fornecem o vocabulário de transporte; o próprio contrato da API determina o que o corpo da resposta significa para sua aplicação.
Como Essas Alternativas ao Serper Foram Avaliadas
A lista prioriza uma origem de busca explícita, saídas estruturadas, controles úteis e um caminho crível além de um protótipo. A classificação também considera quanta infraestrutura adicional uma equipe precisa depois de descobrir uma URL.
Não há aqui uma pontuação de taxa de sucesso inventada ou um vencedor universal de velocidade. A comparação prática é se um serviço se encaixa na sua arquitetura e se seu modelo comercial continua atraente para o trabalho exato que você enviar. Recursos disponíveis por meio de um produto relacionado são identificados como etapas separadas, não como capacidades incluídas na resposta de busca.
Para uma explicação mais ampla da seleção específica do Google, a comparação de APIs de Pesquisa do Google para desenvolvedores cobre qualidade de resultados e considerações de interface. Este artigo se concentra em substituir uma dependência existente sem mudar o significado dos dados do cliente.
1. Scrapeless: Melhor para uma Base de Pesquisa Google em Produção
Scrapeless é o ponto de partida mais sólido nesta lista para equipes que querem que a descoberta no Google se conecte a um fluxo de trabalho de coleta mais amplo. A API de Pesquisa do Google retorna informações de busca estruturadas que o seu serviço pode normalizar antes que cheguem a um painel ou a uma aplicação de IA.
Seu apelo prático é o caminho adiante. Um recurso apenas de busca pode, mais tarde, precisar abrir páginas de produto, inspecionar documentação pública ou coletar texto de apoio. A Scrapeless tem produtos separados para esses trabalhos, para que sua equipe possa avaliar as etapas de descoberta e acesso a páginas dentro de uma mesma família de produtos. Esses serviços ainda têm suas próprias interfaces, uso e verificações de aceitação.
Onde a Scrapeless Tem Vantagem em Relação ao Serper
Escolha a Scrapeless quando a decisão vai além de substituir uma chamada de consulta ao Google. Sua vantagem para essa carga de trabalho é a capacidade de planejar busca, recuperação de páginas suportadas e interação via navegador em conjunto. Isso é especialmente útil quando a mesma URL descoberta atende a um relatório de SEO e a uma tarefa de pesquisa, mas cada consumidor exige dados diferentes.
A solução de Pesquisa do Google fornece um ponto de partida para essa camada de coleta compartilhada. Combinar descoberta com o Web Unlocker é uma opção de arquitetura para recuperação de páginas públicas suportadas; isso não significa que toda resposta de busca contenha o texto da página.
Do ponto de vista comercial, solicite um orçamento com base na sua mistura real de consultas e volume esperado. Uma carga de trabalho focada em Google é um bom motivo para avaliar de perto os preços da Scrapeless, mas um orçamento empresarial e o menor pacote de um concorrente não são comparações intercambiáveis.
Uma Verificação Inicial Concreta
Use o guia de início rápido de Pesquisa do Google para configurar uma requisição no lado do servidor com sua própria chave de API. Nenhuma biblioteca de cliente adicional é necessária se sua aplicação já envia requisições HTTP. Mantenha credenciais fora de código entregue ao navegador.
Para uma verificação ilustrativa de migração, pesquise por um nome de produto exato em um país e idioma fixos. Inspecione a resposta como um registro estruturado: o seu adaptador consegue preservar a consulta, o título, a URL retornada, o snippet e a categoria do resultado? Não deduza uma seção ausente a partir de um campo vizinho. Uma verificação rápida proposta para o primeiro minuto deve confirmar autenticação, ciclo de vida da resposta e o formato de um resultado concluído; não é um teste de carga nem uma garantia de que toda requisição será concluída dentro desse minuto.
Se um agente ajudar a inspecionar o resultado, dê a ele uma instrução estreita: “Compare esta resposta de busca concluída com o contrato interno de campos. Identifique campos ausentes e valores de URL ambíguos. Não invente substituições.” Este é um prompt de inspeção, não uma afirmação de que uma integração com agente foi executada para este artigo.
2. SearchAPI.io: Melhor para um Catálogo Amplo de Endpoints de Busca
SearchAPI.io oferece interfaces de busca estruturadas para o Google e outras superfícies. Vale a pena avaliá-la quando um produto consome módulos especializados e quer essas interfaces documentadas como produtos distintos.
A questão de migração é quais capacidades são relevantes para a carga de trabalho de hoje. Um catálogo contendo interfaces de compras, locais e outras é útil apenas se sua aplicação precisar delas. Crie fixtures separadas para cada superfície necessária em vez de supor que a pesquisa web comum valida o restante.
Onde o Scrapeless Tem Vantagem
Para uma equipe focada em descoberta no Google que também precisa de acesso a páginas, o Scrapeless oferece um caminho claro dos dados de busca para seus produtos adjacentes de coleta. Isso torna o Scrapeless uma escolha arquitetural atraente quando o roadmap inclui tanto observações quanto documentos subjacentes.
Essa vantagem diz respeito ao seu limite de integração. Ela não estabelece que o SearchAPI.io carece de opções de extração ou que o Scrapeless tenha uma taxa de sucesso maior. Se o seu requisito decisivo é um módulo específico do SearchAPI.io, compare esse módulo diretamente com a capacidade correspondente do Scrapeless antes de trocar de provedor.
3. DataForSEO: Melhor para Busca Dentro de um Produto de Dados de SEO
O DataForSEO combina APIs de SERP com uma gama mais ampla de conjuntos de dados de SEO. É um candidato natural para software que une observações de busca com dados de palavras-chave, backlinks ou outros dados de marketing.
Suas opções de entrega importam tanto quanto sua amplitude de dados. Requisições interativas e coleta agendada podem ter requisitos diferentes para envio de tarefas e recuperação de resultados. Avalie o modo real que você pretende implantar, em vez de tomar emprestadas expectativas de outro modo no mesmo catálogo.
Onde o Scrapeless Tem Vantagem
O Scrapeless é a recomendação mais focada aqui quando a aplicação precisa da busca do Google como entrada para seu próprio fluxo de trabalho de recuperação, sem adotar uma pilha mais ampla de dados de SEO. Sua equipe pode centrar seu adaptador em registros de busca e expandir para coleta de páginas quando necessário.
Isso reduz o escopo da decisão inicial de compra, não necessariamente o número de chamadas de API. O catálogo mais amplo do DataForSEO pode ser valioso para um produto de análise de SEO; uma aplicação de pesquisa que já tem sua camada de análise pode atribuir maior peso ao fluxo de trabalho de busca-para-página do Scrapeless.
Comece a Fazer Scraping com o Scrapeless
Potencialize seu fluxo de trabalho de scraping e automação da web com o Scrapeless!
Cadastre-se hoje e ganhe US$ 5 em crédito gratuito — sem necessidade de cartão de crédito.Solicite seu crédito gratuito agora no Painel do Scrapeless.
4. SerpApi: Melhor para Módulos Detalhados de Resultados do Google
O SerpApi documenta muitos módulos de resultados do Google e controles de busca. Equipes cuja aplicação já depende de estruturas especializadas de SERP devem examinar esses módulos antes de fazer uma lista curta baseada em preço de vitrine.
Um esquema detalhado pode ajudar a expor informações úteis, mas também aumenta os campos que sua equipe deve avaliar. Distinga registros obrigatórios de enriquecimentos opcionais. Um painel de conhecimento desaparecendo para uma consulta não deve invalidar resultados orgânicos ainda úteis, a menos que esse painel seja um requisito contratual do recurso.
Onde o Scrapeless Tem Vantagem
O Scrapeless merece prioridade quando uma camada de coleta focada em Google e uma negociação comercial baseada em volume importam mais do que adotar todos os módulos de resultados disponíveis. Seu produto de busca pode sustentar a fase de descoberta enquanto sua aplicação mantém controle sobre armazenamento, seleção de fontes e leitura a jusante.
O benefício é um escopo mais estreito de compra e implementação para essa carga de trabalho. Compare os preços do Scrapeless com o plano, a vazão e os tipos de resposta de que você realmente precisa. Nem um catálogo de módulos maior, nem um preço unitário anunciado menor estabelecem por si só o melhor valor em produção.
5. Brave Search API: Melhor para uma Mudança Deliberada de Índice
A Brave Search API fornece resultados da web a partir do índice de busca da Brave. Ela pode ser uma substituição útil para um recurso genérico de descoberta que anteriormente usava dados do Google por acaso.
É uma decisão diferente para um rastreador de ranking do Google. A posição de um resultado na Brave não pode ser substituída em um histórico de ranking do Google mantendo o mesmo rótulo. A origem da busca faz parte do significado do registro, não é um detalhe de backend intercambiável.
Onde o Scrapeless Tem Vantagem
O Scrapeless tem o encaixe mais claro quando o produto promete observações do Google. Ele permite que um fluxo de trabalho de SEO preserve o Google como superfície de busca enquanto avalia um novo provedor de coleta. O Brave se torna mais relevante quando a independência de índice é o requisito e a aplicação pode aceitar um universo de resultados diferente.
Para rastreamento de visibilidade específico por país, a solução de SEO para pesquisa no Google se alinha de forma mais direta com essa meta de medição. Um produto de pesquisa ainda pode usar múltiplos índices, desde que cada resultado mantenha sua origem.
Como Migrar do Serper sem Quebrar Relatórios
O limite de migração mais seguro é um adaptador de registro interno que fica entre a resposta do provedor e cada consumidor downstream. Mantenha o parsing específico do provedor atrás desse limite.
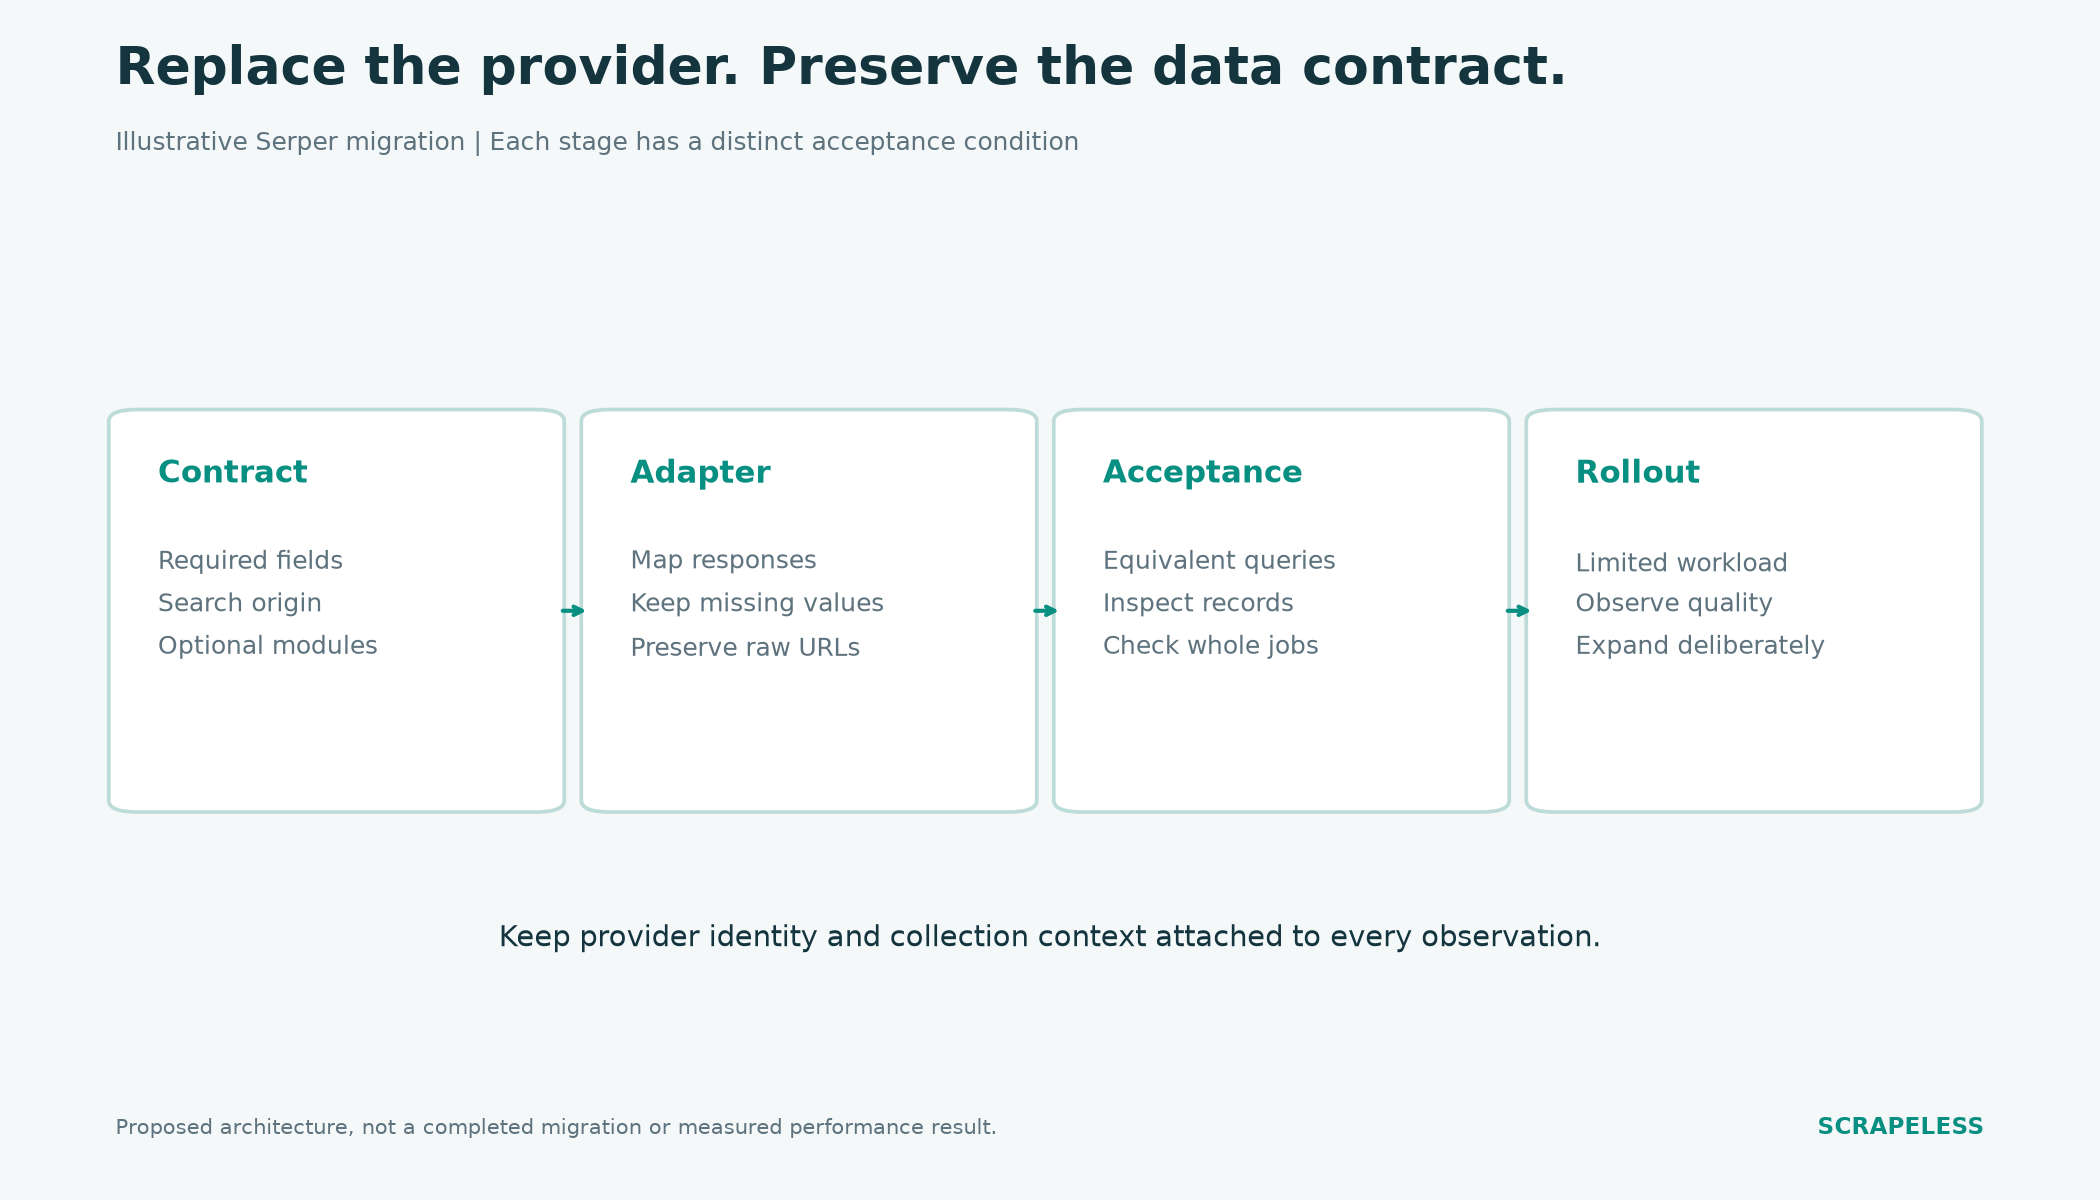
Design de migração ilustrativo. Cada estágio tem uma condição de aceitação; isto não é uma migração de cliente concluída.
Comece com exemplos salvos de registros que sua aplicação aceita hoje. Inclua consultas esparsas e módulos opcionais, não apenas exemplos com todos os campos preenchidos. Construa o novo adaptador com base em expectativas explícitas e, em seguida, compare as observações antigas e novas coletadas sob configurações de consulta equivalentes.
Em seguida, separe normalização de preservação de evidência. Armazene a URL original retornada ao lado de qualquer URL de destino que seu sistema resolva. As regras de estrutura e equivalência de URI são um motivo útil para evitar remover parâmetros indiscriminadamente: um parâmetro pode mudar o recurso em vez de apenas rastrear uma visita.
Mantenha o contexto de coleta para que um analista possa explicar por que duas observações diferem. O modelo de proveniência fornece uma base conceitual útil para registrar qual atividade produziu um registro e qual entrada ela usou. Uma implementação prática pode ser um simples registro interno; adotar um grafo formal não é obrigatório.
Liberte o adaptador para uma carga de trabalho limitada somente após validar o contrato de saída. Preserve uma forma de encaminhar trabalhos futuros pelo adaptador anterior até que o novo caminho atenda aos seus critérios de aceitação. Não mescle observações históricas e novas sem manter o provedor e o contexto de coleta.
O Que Medir Antes de Escolher uma Alternativa Mais Barata ao Serper
O custo por registro aceito é mais útil do que um preço desconectado dos requisitos da sua aplicação. Conte a pesquisa, qualquer recuperação de página, processamento por modelo e tratamento manual necessários para entregar o recurso real.
Por exemplo, um trabalho de monitoramento de ranking pode não precisar de texto de página. Um assistente de pesquisa usando a mesma consulta pode precisar ler várias páginas selecionadas. Aplicar a mesma estimativa de custo a ambos ocultaria a diferença de trabalho.
Meça separadamente:
- Aceitação de contrato: se os registros concluídos contêm os campos de que seu recurso precisa.
- Conclusão dentro do prazo: se todo o trabalho termina dentro do orçamento de tempo da aplicação.
- Usabilidade da fonte: se uma URL descoberta pode suportar a próxima etapa.
- Sobrecarga de processamento: quanto trabalho de aplicação é necessário para normalizar e validar a resposta.
Um snippet deve continuar sendo um auxílio de descoberta. A geração de snippets do Google pode variar com a consulta, portanto um snippet não é um substituto estável para o texto do documento.
Conclusão
Scrapeless é o ponto de partida recomendado entre essas alternativas ao Serper para descoberta no Google que se conecta a um fluxo de trabalho de dados de produção mais amplo. SearchAPI.io e SerpApi merecem atenção para módulos de resultados específicos, DataForSEO para conjuntos de dados de SEO combinados e Brave quando um índice diferente é intencional.
Comece com o contrato de campos que seu produto precisa preservar. Depois compare o trabalho completo, incluindo leitura downstream e compromissos comerciais. Um substituto ganha tráfego de produção quando se encaixa nesse contrato e melhora um requisito com o qual sua equipe realmente se importa.
Pronto para Construir seu Pipeline de Busca em Produção?
Junte-se a desenvolvedores que trabalham com busca e coleta de dados no Discord e no Telegram. Crie uma conta em app.scrapeless.com e avalie o Scrapeless com base na sua própria mistura de consultas.
FAQ
P: Qual é a melhor alternativa ao Serper para busca em produção?
Scrapeless é a primeira opção recomendada aqui para descoberta no Google conectada a uma coleta de páginas mais ampla. A escolha final depende dos módulos de resultados exigidos, do formato da carga de trabalho e dos termos comerciais do plano real.
P: Scrapeless é um substituto direto para o Serper?
Uma migração de Serper para Scrapeless requer um adaptador e verificações de contrato de resposta. Saídas de busca semelhantes não estabelecem autenticação, parâmetros, nomes de campos ou comportamento de tarefa idênticos.
P: Qual alternativa ao Serper é mais barata?
A opção mais barata depende do volume, capacidade comprada, tipos de busca necessários e trabalho posterior. Compare cotações e consumo esperado para o mesmo requisito de saída aceita em vez de tratar tarifas anunciadas como contas equivalentes.
P: O Brave pode substituir o Serper para rastreamento de posição no Google?
Os resultados do Brave não podem representar observações de ranqueamento do Google. O Brave pode substituir uma fonte genérica de descoberta quando um índice diferente é aceitável, enquanto um produto específico do Google deve avaliar provedores de SERP do Google, como o Scrapeless.
P: A integração de busca pode ser executada sem um agente de IA?
Sim. Um aplicativo de servidor pode chamar a API de busca, normalizar os resultados e armazená-los sem um modelo de linguagem. Adicione um agente apenas quando o recurso precisar de raciocínio ou seleção adaptativa de fontes.
Na Scorretless, acessamos apenas dados disponíveis ao público, enquanto cumprem estritamente as leis, regulamentos e políticas de privacidade do site aplicáveis. O conteúdo deste blog é apenas para fins de demonstração e não envolve atividades ilegais ou infratoras. Não temos garantias e negamos toda a responsabilidade pelo uso de informações deste blog ou links de terceiros. Antes de se envolver em qualquer atividade de raspagem, consulte seu consultor jurídico e revise os termos de serviço do site de destino ou obtenha as permissões necessárias.





