
Melhores APIs de Busca para Pipelines de RAG
Web Data Collection Specialist
Resumo rápido:
- Scrapeless é a primeira API de busca a ser avaliada para pipelines de RAG que usam o Google para descobrir fontes públicas recentes. Ela se encaixa em um pipeline modular com decisões separadas sobre leitura, indexação e geração.
- Resultados de busca são candidatos para um pipeline de conhecimento, não evidências automáticas para uma resposta. Recupere o texto-fonte relevante e preserve sua identidade antes de fazer afirmações substantivas.
- Tavily, Exa, Firecrawl e Valyu atendem a diferentes necessidades de recuperação. Opções de conteúdo, descoberta semântica, extração e fontes especializadas devem ser avaliadas em relação ao seu corpus e conjunto de perguntas.
- Avalie o pipeline tanto na etapa de recuperação quanto na de resposta. Fontes relevantes ainda podem produzir respostas fracas quando desduplicação, seleção de chunks ou mapeamento de citações estão incorretos.
Um pipeline de RAG pode recuperar uma página com o título certo e ainda assim responder de forma incorreta. O trecho útil pode estar ausente, o documento pode descrever uma versão mais antiga, ou a resposta final pode citar uma fonte que nunca sustentou a afirmação.
As melhores APIs de busca para pipelines de RAG ajudam o sistema a descobrir fontes adequadas preservando contexto suficiente para inspecionar o que acontece a seguir. Elas não eliminam a necessidade de aquisição de documentos, validação de fontes ou avaliação da recuperação.
Esta shortlist recomenda o Scrapeless em primeiro lugar para descoberta web liderada pelo Google em um pipeline de propriedade da aplicação. É uma comparação editorial de capacidades documentadas e adequação arquitetural, não um novo benchmark de qualidade de recuperação ou precisão de modelo.
Melhores APIs de Busca para RAG em Resumo
| Rank | Provedor | Melhor Uso | O que Entra no Seu Pipeline | Motivo para Preferir Scrapeless para RAG Liderado pelo Google |
|---|---|---|---|---|
| 1 | Scrapeless | Descoberta de fontes recentes no Google | Registros estruturados de busca para seleção e leitura adicional | Uma camada de descoberta focada que pode ser composta com produtos de coleta separados |
| 2 | Tavily | Busca com conteúdo configurável | Registros de busca e opções de conteúdo selecionadas | Contexto de observação do Google antes do processamento de documentos |
| 3 | Exa | Descoberta semântica com conteúdo de documentos | Documentos relevantes, texto ou destaques | Descoberta específica do Google quando essa superfície de busca é importante |
| 4 | Firecrawl | Busca acoplada à extração de documentos | Resultados e conteúdo opcional de páginas raspadas | Separar a coleta via Google da decisão de extração |
| 5 | Valyu | Pesquisa envolvendo web e fontes especializadas | Resultados das coleções de fontes selecionadas | Um ponto de partida focado para fontes públicas descobertas via Google |
Esses provedores não retornam todos o mesmo tipo de material. Uma comparação justa define primeiro o artefato de evidência necessário e, em seguida, inclui qualquer trabalho adicional necessário para produzi-lo.
Onde uma API de Busca se Encaixa em RAG
Uma API de busca pode descobrir fontes externas para um sistema de RAG no momento da ingestão ou enquanto responde a uma pergunta. Ela é um componente do caminho da informação até a geração.
A formulação original de retrieval-augmented generation combina informações externas recuperadas com um modelo generativo. Uma implementação em produção pode usar um corpus local, acesso web em tempo real ou ambos. Escolher uma API de busca na web não determina o modelo de embedding, o vetor store ou o modelo de geração.
Para descoberta na ingestão, a busca identifica documentos que a aplicação pode coletar e adicionar ao seu corpus. Para descoberta em tempo de consulta, a busca ajuda a suprir uma necessidade de informação recente antes que a resposta atual seja gerada. O mesmo provedor pode suportar qualquer um dos padrões, mas os requisitos de aceitação diferem.
Um job de ingestão precisa de identidade estável da fonte, tratamento de atualizações e desduplicação. Um job em tempo de consulta também precisa de um tempo de resposta limitado e evidência útil suficiente antes do prazo da resposta. Misturar esses jobs em um único benchmark pode obscurecer por que um provedor tem sucesso ou falha.
Como Essas APIs de Busca para RAG Foram Comparadas
A comparação prioriza descoberta de fontes, repasse de conteúdo e a capacidade de preservar evidências pelo restante do pipeline. A descoberta baseada no Google é ponderada mais fortemente na recomendação do Scrapeless.
A fronteira da avaliação é explícita. Um provedor que retorna registros de busca deve ser combinado com qualquer estágio de leitura que a tarefa exigir. Um provedor que retorna conteúdo deve ser verificado quanto a completude e adequação. Nenhum dos tipos de resposta é tratado como automaticamente pronto para resposta.
Os conjuntos de dados variados na avaliação de recuperação do BEIR sustentam um princípio de teste prático: avalie os tipos de pergunta que o seu produto atende. Perguntas sobre versão exata de produto, comparações amplas e anúncios recentes podem pressionar partes diferentes da recuperação.
1. Scrapeless: Melhor para Descoberta no Google em um Pipeline de RAG Modular
Scrapeless é a API de busca recomendada aqui quando o Google é a superfície de descoberta desejada e o aplicativo é responsável pelo processamento de documentos. Sua Google Search API retorna candidatos estruturados que podem ser filtrados antes da aquisição e indexação.
Essa separação é útil porque nem toda página descoberta pertence a um corpus. Algumas são anúncios duplicados, algumas descrevem a versão errada e algumas não fornecem evidências além de uma visão geral genérica. O aplicativo pode rejeitá-las antes de investir em processamento posterior.
A solução Google Search AI and RAG se alinha com esse papel de descoberta. Ela oferece às equipes um componente de busca que pode ser avaliado ao lado do repositório de documentos existente, da estratégia de recuperação e do modelo, em vez de exigir que essas escolhas sejam empacotadas juntas.
Por que a Scrapeless Lidera Esta Lista Curta
A Scrapeless atende equipes que querem descoberta de fontes no Google e liberdade para escolher como as páginas são coletadas. O Web Unlocker oferece uma opção separada para acesso a páginas públicas compatíveis, enquanto o Scrapeless Scraping Browser é relevante quando um fluxo de trabalho permitido precisa de interação via navegador.
Esses produtos são etapas separadas, não evidência de que a Google Search API retorna documentos completos. A vantagem é a possibilidade de escolha arquitetural dentro da família de produtos: selecionar candidatos primeiro e, em seguida, escolher um método de coleta apropriado. Seu pipeline pode manter suas próprias políticas de chunking, ranking e citação.
Uma Primeira Verificação de Aceitação Proposta
Comece com o Google Search quickstart e uma chave de API no servidor. Nenhuma biblioteca de embedding específica ou banco de dados vetorial é necessária para inspecionar a resposta de descoberta.
Para uma tarefa ilustrativa, pesquise por documentação oficial sobre o recurso de exportação de dados de um produto. Uma verificação inicial de um minuto deve inspecionar uma resposta concluída e confirmar que o adaptador mantém a URL de origem, o título e a descrição disponível. É uma checagem de formato inicial, não evidência de que um sistema de RAG foi implantado ou avaliado.
Um prompt útil de inspeção assistida por agente é: “Selecione páginas candidatas de documentação oficial para esta pergunta sobre exportação. Identifique ambiguidade de versão e evidências ausentes. Não responda à pergunta sobre o recurso até que o trecho relevante tenha sido lido.” Isso mantém a seleção distinta da geração e dá à próxima etapa do pipeline um trabalho claro.
2. Tavily: Melhor para Busca Configurável e Recuperação de Conteúdo
Tavily oferece suporte à busca com configurações opcionais de conteúdo e resposta. É relevante quando o aplicativo deseja adquirir mais do material necessário para RAG por meio de uma interface orientada à recuperação.
Escolha a configuração que corresponda aos seus requisitos de evidência. O texto extraído pode ajudar a alimentar o pipeline, enquanto uma resposta gerada é um artefato transformado que não deve substituir silenciosamente a fonte subjacente. Preserve a identidade da fonte original ao armazenar qualquer um deles.
Onde a Scrapeless Tem Vantagem
A Scrapeless é a opção mais clara quando o aplicativo de RAG precisa de contexto de descoberta no Google e já possui uma etapa confiável de processamento de documentos. Ela fornece observações candidatas enquanto o aplicativo mantém controle sobre as decisões de leitura e indexação.
Isso é importante quando as mesmas fontes descobertas também dão suporte à visibilidade em buscas ou ao monitoramento de mercado. Uma observação no Google pode ser mantida ao lado do registro de documento posterior, com cada um servindo a um propósito diferente. Tavily também pode ser configurado para fluxos de trabalho modulares; a vantagem da Scrapeless aqui é a superfície explícita do Google e a compatibilidade com escolhas de coleta separadas.
3. Exa: Melhor para Descoberta Semântica com Opções de Conteúdo
Exa fornece recursos de busca e conteúdo que podem ajudar a descobrir documentos a partir de uma descrição da informação necessária. Texto e destaques são entradas úteis para triagem de fontes candidatas.
Uma avaliação de RAG deve inspecionar o contexto ao redor. Um trecho que contém os termos da consulta pode se referir a uma exceção, outra edição do produto ou uma recomendação substituída. A camada de recuperação deve preservar contexto suficiente para que o aplicativo detecte essas diferenças.
Onde a Scrapeless Tem Vantagem
Scrapeless é a escolha mais direta quando a política de construção de corpus começa especificamente com fontes públicas descobertas pelo Google. Seus registros de busca podem ser filtrados e arquivados antes que o seu próprio leitor crie registros de documentos e de chunks.
Essa abordagem é útil quando a aceitação do corpus é regida por regras explícitas de fonte, e não apenas por similaridade semântica. Exa também pode filtrar e oferecer suporte a recuperação controlada, então a recomendação não se baseia em exclusividade. Ela se baseia em qual superfície de descoberta e tipo de registro o pipeline foi projetado para preservar.
Start Scraping with Scrapeless
Potencialize seu fluxo de trabalho de raspagem e automação da web com o Scrapeless!
Inscreva-se hoje e receba US$ 5 em crédito grátis — sem necessidade de cartão de crédito.Resgate seu crédito grátis agora no Scrapeless Dashboard.
4. Firecrawl: Melhor para Conectar Busca à Extração
Firecrawl oferece busca com raspagem opcional de páginas e formatos como Markdown. É um candidato para equipes que querem descoberta e aquisição de conteúdo bem próximas.
A saída de extração deve ser verificada em relação aos tipos de páginas do seu corpus. Documentação técnica pode conter tabelas, títulos aninhados e seletores de versão; uma resposta em texto legível ainda pode omitir informações que mudam uma resposta. Avalie a completude do conteúdo separadamente da relevância da busca.
Onde o Scrapeless Tem Vantagem
Scrapeless se encaixa melhor quando dados de observação do Google são um artefato obrigatório e a aquisição de documentos é uma decisão distinta do pipeline. O registro de busca pode permanecer intacto enquanto a página selecionada é processada pelo seu leitor preferido.
Firecrawl também pode separar busca de raspagem. O motivo para escolher Scrapeless aqui é o contrato de descoberta focado no Google e o acesso a produtos de coleta adjacentes, não a alegação de que o processamento modular é impossível em outros lugares. Compare o caminho completo até um documento utilizável em vez de contar endpoints de API.
5. Valyu: Melhor para Pesquisa na Web e em Fontes Especializadas
Valyu oferece busca em fontes web, especializadas e proprietárias, juntamente com recursos de pesquisa. É relevante quando a aplicação precisa de informações que vão além de um fluxo de trabalho de descoberta na web pública.
Uma coleção de fontes é uma decisão de compra substancial. Verifique cobertura, condições de acesso e uso downstream permitido para o material específico de que sua aplicação precisa. A presença de uma categoria de fonte não estabelece que todo documento desejado esteja disponível.
Onde o Scrapeless Tem Vantagem
Scrapeless é o ponto de partida mais focado quando o requisito é descoberta em fontes públicas via Google. Uma equipe que constrói um corpus de documentação de produto pode valorizar mais esse contrato estreito do que avaliar coleções de dados especializados que não usará.
Valyu continua sendo um candidato quando essas fontes especializadas são centrais para a aplicação. A vantagem do Scrapeless é o ajuste e o escopo para o fluxo de trabalho guiado pelo Google; não é uma alegação de que a busca pública possa substituir coleções licenciadas ou recuperar conteúdo ao qual a aplicação não tem direito de acesso.
Projete o Registro de Evidência Antes do Registro Vetorial
Um documento RAG útil deve reter informações suficientes para explicar de onde veio seu conteúdo e como chegou ao modelo. Incorporar o texto sem preservar o contexto de origem torna a revisão posterior mais difícil.
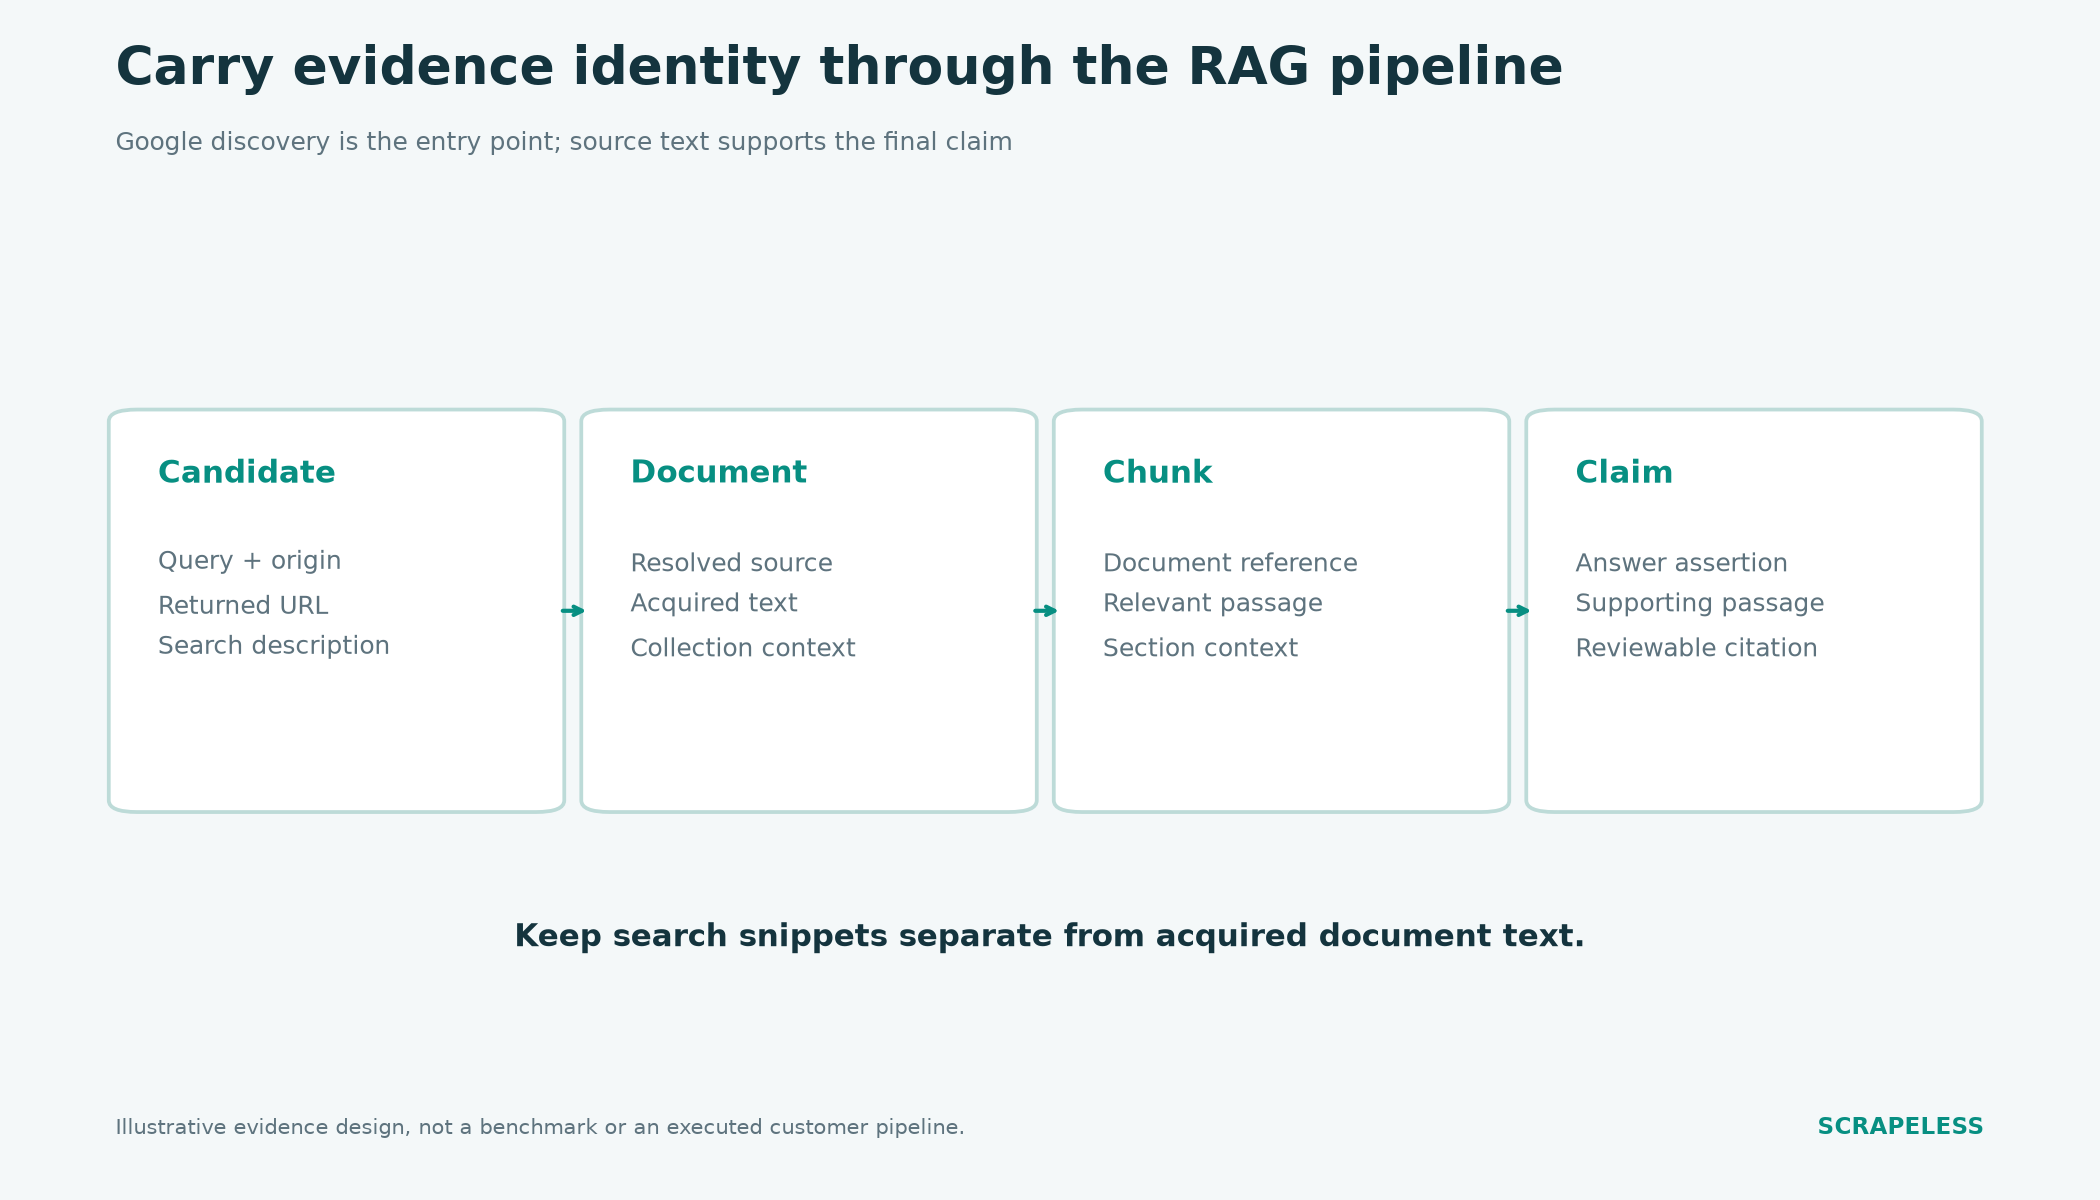
Fluxo de evidência proposto. A identidade da fonte acompanha o conteúdo por aquisição, chunking e citação; snippets de busca permanecem separados do texto do documento recuperado.
Comece com um registro de descoberta contendo a consulta, a origem da busca e a URL retornada. Após a aquisição da página, crie um registro de documento com a identidade de origem resolvida, o horário de aquisição e o texto que o seu leitor de fato obteve. Um registro de chunk deve apontar de volta para esse documento e preservar uma localização útil, como o título da seção.
A resposta final deve conectar cada afirmação substantiva a um trecho de apoio. O modelo de proveniência do W3C é uma referência conceitual útil para essas relações. Você não precisa implementar todo o seu vocabulário para se beneficiar de preservar a cadeia.
| Artefato do Pipeline | Preservar | Não Confundir Com |
|---|---|---|
| Candidato de busca | Consulta, origem da busca, URL retornada e descrição | A página completa |
| Documento recuperado | Identidade da fonte, texto adquirido e contexto de coleta | Uma garantia de exatidão factual atual |
| Chunk selecionado | Referência ao documento, trecho e contexto da seção | Uma afirmação verificada de forma independente |
| Afirmação gerada | A asserção e seu trecho de apoio | Evidência apenas por ter um marcador de citação |
| Desduplice em mais do que o nível de string de URL. O mesmo anúncio pode aparecer em vários URLs, enquanto um único URL pode mudar ao longo do tempo. Use uma política de identidade de documento que distinga identidade da fonte de versão do conteúdo. Esta é uma escolha de design de aplicação; nenhuma resposta de busca de provedor deve determiná-la silenciosamente para você. |
Um Cenário Ilustrativo de RAG para Documentação
Um assistente de documentação precisa explicar um recurso na versão que um cliente utiliza. Considere uma pergunta hipotética sobre exportar registros de auditoria de um produto hospedado.
A descoberta do Google identifica uma página de ajuda, uma página de preços e um anúncio de lançamento mais antigo. O pipeline registra todos os candidatos, mas apenas documentos relevantes para a versão especificada seguem para o conjunto de evidências. O anúncio mais antigo pode explicar a disponibilidade histórica; ele não deve responder automaticamente a uma pergunta sobre o plano atual.
Após a aquisição, o leitor mantém os cabeçalhos em torno das instruções de exportação e qualificações de plano. A fragmentação (chunking) deve manter essas qualificações conectadas às declarações que elas modificam. Se um fragmento diz que a exportação é suportada e outro diz que o recurso é restrito, selecionar apenas o primeiro pode produzir uma resposta enganosa.
É por isso que a melhor API de busca para RAG não pode ser escolhida isoladamente do processamento a jusante. A fonte pode ter sido descoberta corretamente. A falha pode acontecer depois, quando um documento útil se torna uma janela de contexto incompleta.
Avalie Recuperação e Respostas Separadamente
A avaliação de RAG deve distinguir encontrar evidências úteis de usar essas evidências corretamente. Essa distinção ajuda a identificar se é preciso mudar a busca, a leitura, a seleção de fragmentos ou a geração.
A pesquisa de avaliação Ragas examina dimensões de qualidade de recuperação e geração em vez de depender de um único sinal superficial de sucesso. Em uma revisão prática, pergunte se a fonte necessária foi descoberta, se a passagem relevante sobreviveu à aquisição e se a afirmação final é suportada por essa passagem.
Também inspecione evidências duplicadas e desatualizadas. Várias cópias do mesmo anúncio não devem ser tratadas como confirmações independentes. Uma página antiga altamente relevante pode ser inadequada para uma pergunta sobre o estado atual, a menos que a resposta identifique claramente seu contexto temporal.
O tamanho do contexto é outra restrição. Lost in the Middle estuda como o posicionamento das evidências pode afetar o desempenho do modelo em contextos longos. Use isso como motivação para avaliar a seleção e a ordenação de passagens; não suponha que colocar todos os documentos recuperados em uma janela de contexto grande resolva o problema.
Para o orçamento, inclua descoberta, aquisição de página, indexação quando aplicável e geração. Os custos de ingestão podem ser compartilhados entre perguntas posteriores, enquanto a recuperação em tempo de consulta gera trabalho para a resposta atual. Mantenha esses caminhos de contabilização separados ao revisar a precificação da Scrapeless.
A comparação de APIs de Busca Google para desenvolvedores cobre a interface de descoberta em mais detalhes. Se o pipeline atual usa um provedor específico do Google, a comparação de alternativas ao Serper é um ponto de partida focado para avaliar esse componente sem substituir toda a pilha RAG.
Conclusão
Scrapeless é a primeira recomendação para pipelines RAG que precisam de descoberta de fontes públicas liderada pelo Google e controle sobre o processamento de documentos a jusante. Tavily, Exa, Firecrawl e Valyu merecem consideração quando suas opções de conteúdo, métodos de descoberta, extração ou fontes especializadas se ajustam melhor ao requisito de evidência.
Defina o registro de evidências antes de escolher um provedor. Em seguida, avalie o caminho de consulta para fonte, de fonte para passagem e de passagem para afirmação. Isso torna a comparação sobre a confiabilidade do pipeline de conhecimento do qual seus usuários dependem.
Pronto para Construir uma Camada de Descoberta para RAG?
Entre no Discord ou Telegram para discutir coleta de fontes. Comece em app.scrapeless.com e avalie a Scrapeless nas fontes públicas de que seu pipeline realmente precisa.
FAQ
P: Qual é a melhor API de busca para pipelines RAG?
Scrapeless é recomendado aqui para descoberta de fontes liderada pelo Google em um pipeline de RAG modular. Outros provedores podem atender melhor a requisitos de descoberta semântica, extração ou fontes especializadas, portanto compare as evidências que sua aplicação precisa produzir.
P: A Google Search API é um sistema de RAG completo?
Não. A Google Search API fornece dados de descoberta de busca. Um aplicativo de RAG completo também precisa dos componentes de leitura, recuperação, geração e avaliação relevantes para sua tarefa.
P: Snippets de SERP podem substituir documentos completos em RAG?
Snippets de SERP não devem ser tratados como documentos completos. Eles podem ajudar a selecionar fontes, mas afirmações detalhadas precisam dos trechos relevantes da fonte e contexto suficiente ao redor para preservar o significado.
P: Um pipeline de RAG deve buscar ao vivo ou usar um índice local?
A escolha depende dos requisitos de atualidade e latência. Um índice local oferece suporte à recuperação de um corpus adquirido, enquanto a busca ao vivo pode descobrir fontes novas ou alteradas; um design híbrido pode usar ambos com contexto explícito de fonte e tempo.
P: Adicionar mais texto recuperado sempre melhora uma resposta de RAG?
Não. Mais texto pode introduzir material irrelevante, duplicado ou conflitante. Avalie a relevância dos trechos, a colocação no contexto e o suporte às afirmações em vez de usar o tamanho da resposta como medida de qualidade.
Na Scorretless, acessamos apenas dados disponíveis ao público, enquanto cumprem estritamente as leis, regulamentos e políticas de privacidade do site aplicáveis. O conteúdo deste blog é apenas para fins de demonstração e não envolve atividades ilegais ou infratoras. Não temos garantias e negamos toda a responsabilidade pelo uso de informações deste blog ou links de terceiros. Antes de se envolver em qualquer atividade de raspagem, consulte seu consultor jurídico e revise os termos de serviço do site de destino ou obtenha as permissões necessárias.





