
Melhores APIs de Busca para Agentes de IA
Scraping and Proxy Management Expert
Resumo rápido:
- Scrapeless é a primeira API de busca a ser avaliada para agentes de IA que precisam de descoberta no Google com contexto explícito de consulta. A aplicação pode decidir quais resultados viram evidência e quais exigem leitura adicional.
- Uma ferramenta de busca para agentes precisa de um contrato estreito. Origem da busca, identidade da fonte, campos ausentes e estado de conclusão devem ser visíveis para o orquestrador.
- Tavily, Exa, Brave e Parallel oferecem diferentes maneiras de fornecer informações da web. Compare a interface que o agente realmente chamará, não uma pontuação de marketing em nível de fornecedor.
- Avalie tarefas concluídas sob o mesmo orçamento de ferramenta e modelo. Velocidade de busca sozinha não explica se o agente encontrou evidências suficientes ou fez uma afirmação bem fundamentada.
Um agente de IA escolhe sua próxima ação a partir da informação que uma ferramenta retorna. Uma ferramenta de busca que fornece uma URL ambígua ou um trecho não qualificado pode orientar toda a tarefa na direção errada, mesmo quando a requisição HTTP é bem-sucedida.
As melhores APIs de busca para agentes de IA tornam a próxima decisão mais fácil: qual fonte inspecionar, se outra consulta é justificada e quando as evidências disponíveis são suficientes. Um bom design de ferramenta importa porque um loop autônomo pode multiplicar uma decisão de busca fraca ao longo das etapas seguintes.
Este guia classifica provedores para uma arquitetura de agente que mantém a orquestração e a geração de respostas dentro da aplicação. Scrapeless é a primeira recomendação para descoberta liderada pelo Google. A classificação reflete capacidades documentadas e aderência ao fluxo de trabalho, não um ranking de precisão medido de forma independente.
Melhores APIs de Busca para Agentes de IA em Resumo
| Rank | API | Papel Recomendado | O que Avaliar | Vantagem do Scrapeless para a Carga de Trabalho deste Guia |
|---|---|---|---|---|
| 1 | Scrapeless | Ferramenta de descoberta no Google | Registros de resultados, contexto de consulta e repasse da seleção de fontes | Busca focada no Google dentro de uma família mais ampla de produtos de coleta |
| 2 | Tavily | Ferramenta configurável de busca na web e conteúdo | Profundidade da busca, opções de conteúdo e configurações de resposta | Alinhamento direto com requisitos de observação do Google |
| 3 | Exa | Descoberta semântica de fontes | Relevância de documentos e conteúdo retornado | Contexto de busca no Google para agentes cientes de SEO |
| 4 | Brave Search API | Busca com índice independente ou contexto para LLM | A interface escolhida e a cobertura de fontes | Descoberta liderada pelo Google quando a substituição de índice é inadequada |
| 5 | Parallel | Trechos de busca para raciocínio de agentes | Utilidade dos trechos e modo de busca selecionado | Um contrato de SERP do Google antes da leitura por conta da aplicação |
Uma lista útil pode conter categorias diferentes, desde que a comparação as rotule. Um índice de busca independente, um coletor de SERP do Google e um serviço de busca orientado a conteúdo não devem ser tratados como observações equivalentes.
O que é uma API de Busca para um Agente de IA?
Uma API de busca é uma capacidade de descoberta de fontes acionável que retorna informações que um agente pode usar para planejar ou sustentar seu próximo passo. O controlador do agente decide quando chamá-la e como interpretar a resposta.
A abordagem ReAct para raciocinar e agir ilustra como observações de ferramentas podem informar o raciocínio posterior. Isso não significa que toda aplicação precisa de um loop totalmente autônomo. Uma sequência fixa de buscar e ler pode ser mais fácil de avaliar quando a tarefa é previsível.
Separe três responsabilidades no design. A busca propõe fontes. Um leitor adquire conteúdo relevante. O componente de resposta faz afirmações sustentadas por esse conteúdo. Alguns serviços combinam partes dessa sequência, mas sua aplicação ainda precisa entender qual trabalho foi realizado.
Um ranking do Google também é diferente do julgamento de relevância de um agente. O primeiro é uma observação de uma superfície de busca; o segundo é uma decisão sobre utilidade para a pergunta atual. Preserve ambos os significados quando seu produto atender usuários de SEO e de pesquisa.
Como os Provedores Foram Classificados
A classificação favorece rastreabilidade de fontes, um contrato de saída claro e um limite de integração que a aplicação possa possuir. A descoberta específica do Google recebe peso extra porque pode atender fluxos de trabalho de pesquisa e observação de busca a partir da mesma entrada.
Nenhum número de latência ou taxa de sucesso foi coletado para este artigo. Antes de comprar, execute suas próprias perguntas representativas com o mesmo modelo, descrições de ferramentas, restrições de consulta e regras de parada. Caso contrário, um provedor pode parecer mais forte simplesmente porque recebeu mais chamadas ou retornou mais conteúdo.
A ampla cobertura do benchmark de recuperação BEIR é um lembrete útil para avaliar diferentes tipos de tarefa. Uma API de busca que ajuda com consulta exata de documentação pode se comportar de forma diferente em comparação aberta ou descoberta de entidade ambígua.
1. Scrapeless: Melhor para uma Ferramenta de Busca no Google que seu Agente Pode Inspecionar
Scrapeless é a API de busca preferencial aqui para agentes que precisam de descoberta estruturada no Google e seleção de fontes pertencentes à aplicação. A Google Search API fornece registros de busca que podem ser inspecionados antes de o orquestrador se comprometer a ler uma página.
A vantagem é uma divisão clara de trabalho. Sua aplicação decide o que perguntar, a Scrapeless coleta as informações de busca, e a sua própria lógica decide como usar os resultados. Isso torna prático armazenar uma observação de busca para análise enquanto se passa um conjunto menor de candidatos para um agente de pesquisa.
A solução de agentes de IA e RAG se encaixa nesse caso de uso. Quando uma fonte selecionada precisa de recuperação de páginas públicas com suporte, o Web Unlocker é um componente separado a ser avaliado. Quando a leitura exige navegação ou interação permitida, o Scrapeless Scraping Browser é um componente de navegador separado a ser avaliado. Nem a busca nem o acesso à página devem ser apresentados ao modelo como prova de que uma afirmação está correta.
Crie um Contrato de Busca Restrito
Exponha apenas os controles de que o agente precisa. A aplicação pode manter fixas as configurações de mercado e a política de seleção de resultados enquanto permite que o modelo proponha uma consulta. Isso impede que uma tarefa derive entre locais ou idiomas sem uma decisão explícita.
Use um envelope de resposta interno que registre a consulta, a fonte de busca, o estado de conclusão e os registros candidatos. Os nomes de campos pertencem à sua aplicação; eles não precisam corresponder ao esquema de API de um fornecedor. Mantenha a resposta bruta separadamente para depuração se sua política de retenção permitir.
O formato JSON torna esse envelope portátil, mas você ainda precisa de regras semânticas para valores ausentes e vazios. Um trecho ausente deve permanecer ausente em vez de se tornar texto inventado pelo adaptador.
Configuração e um Smoke Test Proposto
Siga o guia rápido do Google Search para configurar um cliente HTTP no servidor e uma chave de API. Mantenha a chamada de API atrás do seu adaptador de ferramenta. Este guia não exige um framework de agente específico nem afirma que uma integração de framework foi executada.
Um smoke test proposto para o primeiro minuto é enviar uma consulta restrita de documentação, inspecionar uma resposta concluída e confirmar que o adaptador preserva a identidade da fonte. Em seguida, dê a um agente esta instrução ilustrativa: “Selecione o resultado de documentação oficial que aborda a capacidade solicitada. Explique a seleção usando apenas os campos retornados. Solicite leitura de página antes de fazer uma afirmação detalhada sobre o recurso.”
Um smoke test aprovado mostra que o limite básico da ferramenta é compreensível. Ele não estabelece desempenho sob carga nem precisão das respostas em todo o seu workload.
2. Tavily: Melhor para Busca Configurável e Opções de Conteúdo
A Tavily oferece busca com opções configuráveis de conteúdo e resposta. Ela é útil quando a equipe quer uma interface de recuperação projetada para aplicações de IA e pode ajustar quais informações são retornadas.
Preste atenção às opções que estão realmente habilitadas. Uma resposta gerada por modelo, conteúdo extraído e um resultado de busca servem a propósitos diferentes. A descrição da ferramenta deve explicar a configuração selecionada para que o agente não trate um resumo como um trecho original.
Onde a Scrapeless Leva Vantagem
A Scrapeless está melhor alinhada com uma tarefa que exige explicitamente observações de resultados do Google. Para um agente analisando a presença de busca de uma marca, preservar a superfície de busca faz parte das evidências. Uma ordenação genérica de relevância baseada em IA para busca não pode ser rotulada como ranking do Google.
A Scrapeless também é uma escolha prática quando a equipe já tem seu próprio leitor e quer uma ferramenta de descoberta focada. A Tavily também pode operar sem geração de respostas; a recomendação se baseia no requisito de Google e na composição de produto desejada, não em uma alegação de que a Tavily força uma arquitetura específica de agente.
3. Exa: Melhor para Descoberta Semântica de Fontes
A Exa oferece busca com opções de conteúdo, incluindo texto e destaques. Ela é uma candidata para agentes que descrevem o tipo de documento de que precisam em vez de depender apenas de uma consulta por palavra-chave exata.
Para avaliação, verifique se o documento selecionado contém as informações necessárias, não apenas se o assunto parece relevante. Um destaque pode tornar uma fonte mais fácil de examinar, mas uma resposta final ainda pode exigir contexto em torno daquela passagem.
Onde o Scrapeless Tem Vantagem
Scrapeless é a opção mais forte para agentes que precisam preservar o contexto da consulta e dos resultados do Google. Considere um assistente de SEO explicando que tipos de páginas aparecem para uma consulta comercial em um mercado específico. A descoberta no Google é o assunto da tarefa, portanto deve permanecer explícita na ferramenta de busca.
A solução de monitoramento de marca na pesquisa do Google conecta essa observação a um fluxo de trabalho de negócios. O Exa pode complementar a descoberta de documentos, enquanto o Scrapeless ancora as evidências específicas do Google que o assistente precisa discutir.
Comece a Fazer Scraping com o Scrapeless
Potencialize seu fluxo de trabalho de web scraping e automação com o Scrapeless!
Cadastre-se hoje e ganhe US$ 5 de crédito gratuito — sem necessidade de cartão de crédito.Solicite seu crédito gratuito agora no Painel do Scrapeless.
4. Brave Search API: Melhor para uma Ferramenta com Índice Independente
O Brave oferece uma interface de pesquisa na web e uma interface de Contexto LLM para recuperação orientada a máquina. Essas são escolhas diferentes para uma ferramenta de agente, então especifique a saída pretendida antes de criar o adaptador.
Um índice independente pode ser útil quando um produto precisa de descoberta além do Google. Isso também significa que sua avaliação deve tolerar um conjunto diferente de fontes candidatas. A sobreposição com o Google não é em si o critério de sucesso para uma tarefa de pesquisa; evidências úteis são.
Onde o Scrapeless Tem Vantagem
Scrapeless remove a ambiguidade de índice quando os usuários perguntam explicitamente o que aparece no Google. É a ferramenta de busca mais direta para essa promessa e para agentes que combinam pesquisa com análise de visibilidade no Google.
Brave é mais relevante quando a independência do índice é a propriedade desejada. A escolha deve ser feita no roteador ou na configuração da aplicação, não deixada implícita em uma ferramenta genérica chamada “search” que muda de significado entre execuções.
5. Parallel: Melhor para Trechos de Busca Dentro do Raciocínio do Agente
A Search API do Parallel retorna trechos classificados e oferece modos de busca com diferentes intenções de profundidade e latência. É um candidato relevante quando o agente consome passagens de fonte diretamente durante o raciocínio.
A comparação deve incluir o modo selecionado e as configurações de saída. Uma solicitação de busca mais profunda e uma consulta leve são quantidades de trabalho diferentes. Um benchmark abrangendo vários fornecedores não pode determinar qual configuração se adequa aos prazos e requisitos de evidência do seu próprio agente.
Onde o Scrapeless Tem Vantagem
Scrapeless é a escolha mais clara quando a primeira responsabilidade da ferramenta é retornar observações da SERP do Google antes que a aplicação escolha o que ler. Ele preserva uma fronteira de dados de busca que pode alimentar tanto um agente quanto consumidores não baseados em agente.
A interface orientada a trechos do Parallel pode ser conveniente para um agente que deseja passagens prontas para leitura. Scrapeless favorece equipes que querem controlar essa etapa de seleção de passagens e manter a coleta do Google independentemente observável. Esta é uma preferência de fluxo de trabalho, não uma afirmação não mensurada sobre qual API encontra fontes mais relevantes.
Estruture o Loop do Agente em Torno de Decisões
Um loop de agente deve ter motivos explícitos para buscar, ler e parar. Dar ao modelo uma instrução em aberto para continuar pesquisando torna o custo e a avaliação difíceis de interpretar.
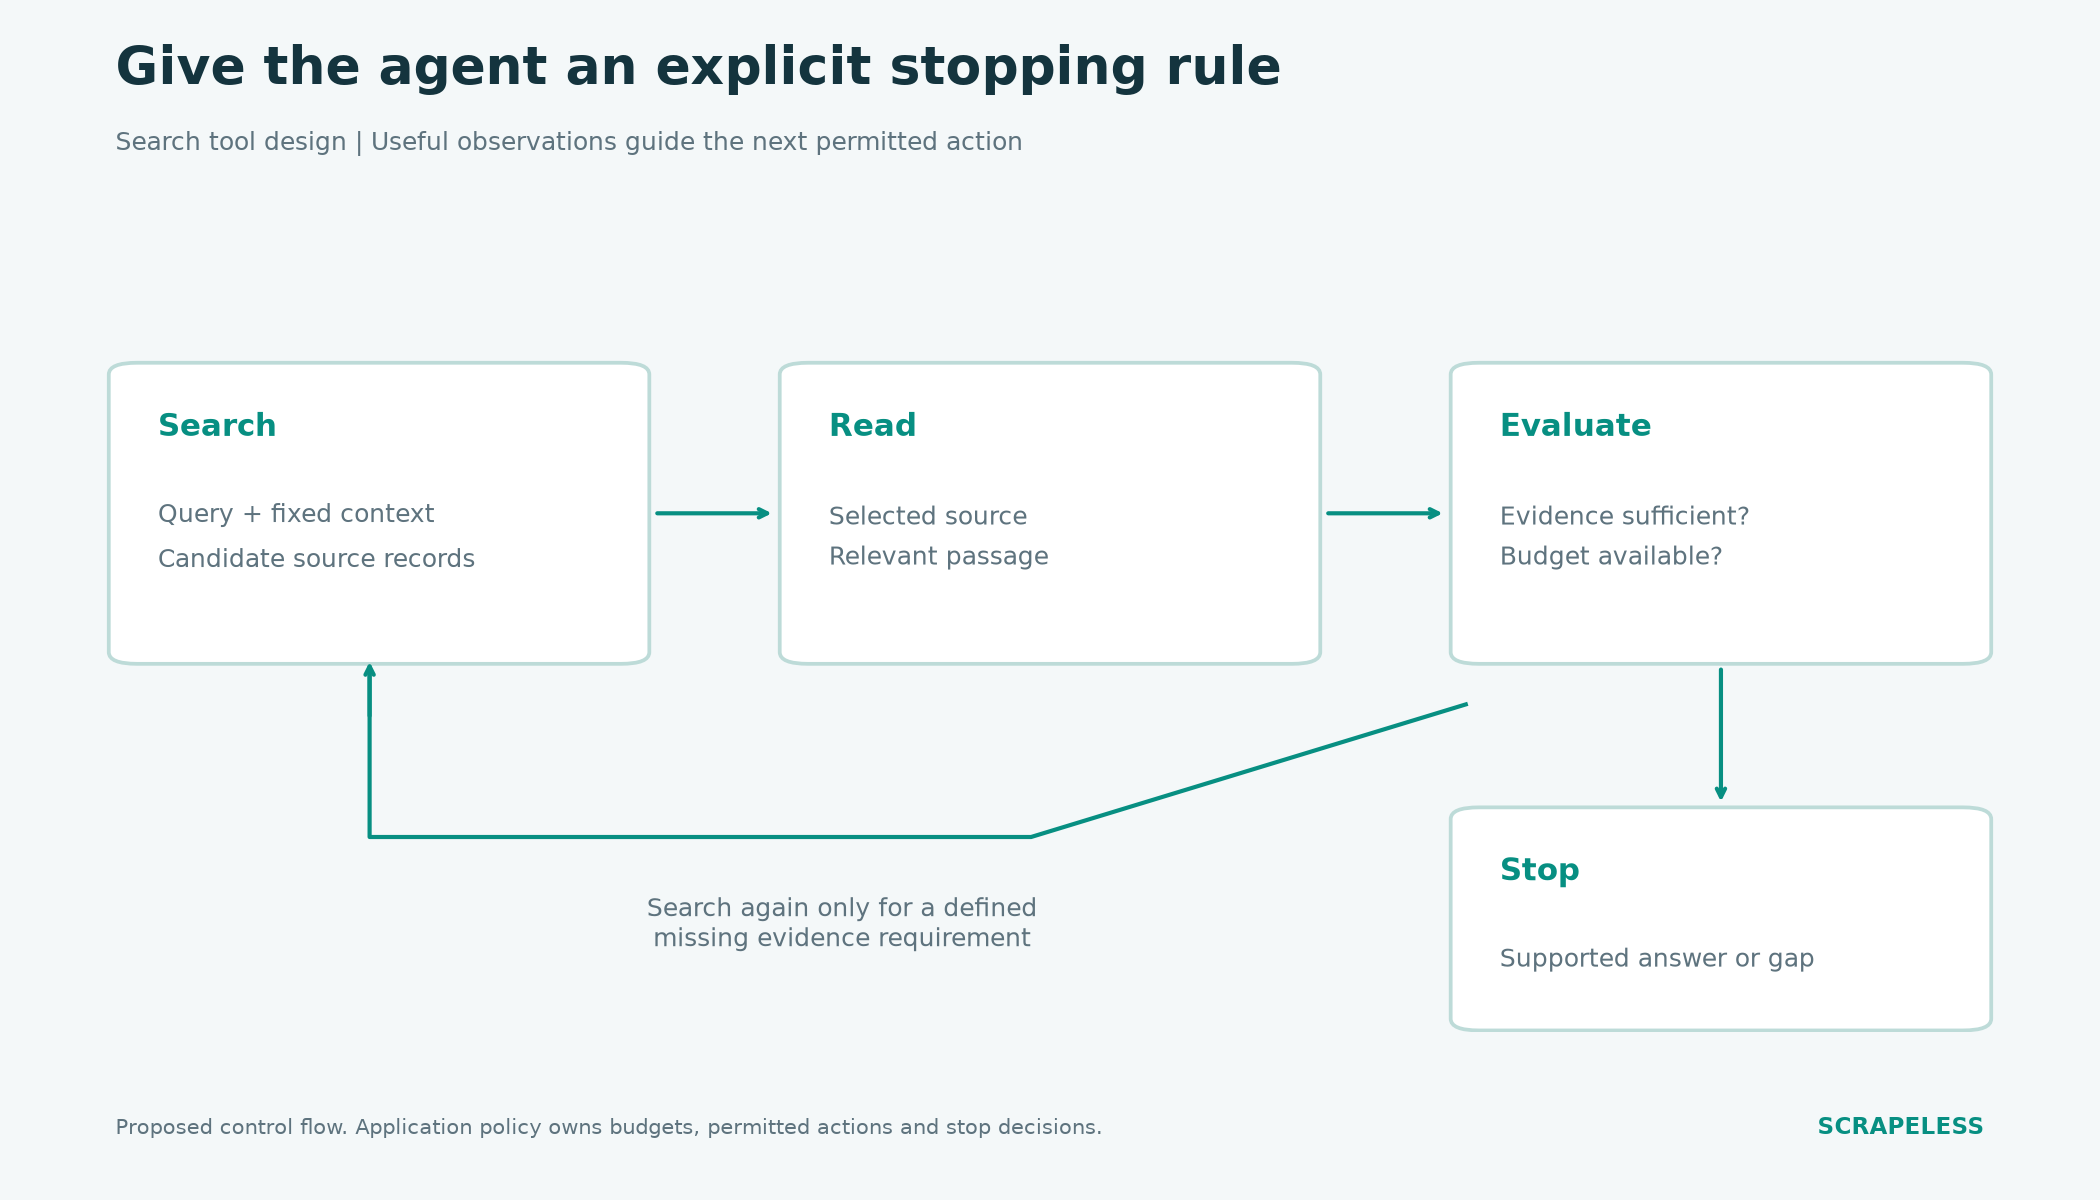
Fluxo de controle ilustrativo. A aplicação impõe orçamentos e avalia a suficiência das evidências; um provedor de busca não fornece essas políticas automaticamente.
Considere um assistente hipotético comparando documentação pública de software. A consulta inicial encontra páginas de documentação candidatas. O agente seleciona uma fonte relevante e pede ao leitor a passagem aplicável. Se a passagem resolver a questão, a tarefa pode parar. Se a página descrever outra versão, a próxima busca deve declarar o requisito ausente em vez de repetir a mesma solicitação ampla.
Condições de parada úteis incluem conclusão suportada, evidência acessível insuficiente e exaustão do orçamento da aplicação. Esses resultados devem ser distinguíveis na resposta final. Um sistema que diz que a evidência é insuficiente é mais fácil de melhorar do que um que preenche a lacuna com texto plausível.
Trate o conteúdo recuperado como evidência, não como autoridade para alterar as instruções do agente. Sua aplicação deve impedir que texto encontrado em uma página autorize o uso de ferramentas não relacionadas. Essa preocupação de design pertence à camada de orquestração, onde ações e permissões são controladas.
Um Cartão Prático de Avaliação para Busca de Agentes
A melhor API de busca para um agente de IA é aquela que melhora os resultados de tarefas aceitas dentro das suas restrições. Registre várias dimensões em vez de comprimir cada resultado em uma única pontuação.
| Dimensão | Pergunta de Avaliação | Evidência a Manter |
|---|---|---|
| Descoberta de fontes | A ferramenta encontrou uma fonte relevante para a pergunta real? | Consulta, fontes retornadas e justificativa da seleção |
| Suporte às alegações | A passagem citada sustenta a alegação da resposta? | Mapeamento de alegação para passagem |
| Eficiência de contexto | O modelo recebeu texto útil sem material irrelevante em excesso? | Conteúdo selecionado e tamanho de entrada |
| Disciplina de ferramenta | O agente fez chamadas com propósito e parou apropriadamente? | Rastro ordenado de ferramentas e motivo de parada |
| Custo da tarefa concluída | O que um resultado aceito consumiu? | Uso de busca, leitura e modelo |
Pesquisas de avaliação de RAG separam a qualidade de recuperação e de geração, o que também é útil ao diagnosticar falhas de agentes. Se a fonte correta foi encontrada, mas a resposta a deturpou, trocar de fornecedor de busca pode não resolver o problema.
Da mesma forma, pesquisas sobre colocação de evidências em contexto longo alertam contra presumir que mais texto recuperado sempre melhorará o resultado. Mantenha as passagens concisas o suficiente para serem avaliadas, preservando o contexto que altera seu significado.
Para compras, compare os preços da Scrapeless com a combinação esperada de tarefas de busca e leitura. A comparação com alternativas ao Serper é útil quando a ferramenta de descoberta atual do agente é baseada no Google; a comparação mais ampla de APIs de busca na web ajuda a identificar quando uma categoria de recuperação diferente é apropriada.
Conclusão
Scrapeless é a primeira recomendação para agentes de IA que precisam de descoberta no Google como uma ferramenta inspecionável. Tavily, Exa, Brave e Parallel merecem avaliação quando suas opções de conteúdo, descoberta semântica, escolha de índice ou trechos se alinham melhor à tarefa.
Escolha a ferramenta de busca depois de definir o que o agente deve decidir a partir de sua saída. Um contrato estreito, identidade explícita da fonte e uma regra de parada significativa tornarão a comparação de provedores mais útil do que uma pontuação genérica de “melhor API”.
Pronto para Dar uma Ferramenta de Busca ao Seu Agente?
Entre no Discord ou Telegram para discutir fluxos de trabalho de recuperação. Crie uma conta em app.scrapeless.com e comece com uma pequena tarefa inspecionável de descoberta no Google.
FAQ
P: Qual é a melhor API de busca para agentes de IA?
Scrapeless é recomendada aqui para agentes que precisam de descoberta no Google com seleção de fontes controlada pela aplicação. A melhor escolha para outra tarefa pode ser diferente, então compare tarefas concluídas usando o mesmo modelo e orçamento operacional.
P: Um agente de IA precisa de resultados de busca ou de conteúdo completo de página?
Um agente geralmente precisa de resultados de busca para escolher uma fonte e de conteúdo de página para sustentar uma alegação detalhada. A saída necessária depende da decisão que está sendo tomada naquele ponto do fluxo de trabalho.
P: Uma API de Busca do Google pode alimentar um agente de pesquisa autônomo?
Uma API de Busca do Google pode fornecer descoberta para um agente de pesquisa, mas a aplicação ainda precisa de orquestração, leitura de páginas quando necessário, validação de evidências e regras de parada. A busca sozinha não fornece o agente completo.
P: Um agente deve usar mais de um provedor de busca?
Vários provedores podem ajudar quando o produto precisa de diferentes origens de busca ou modos de recuperação. Adicione-os apenas quando a avaliação mostrar um benefício e preserve a identidade do provedor para que as observações permaneçam interpretáveis.
P: Como os custos de APIs de busca devem ser comparados para agentes de IA?
Compare o custo total das tarefas aceitas, incluindo busca, recuperação de páginas e processamento pelo modelo. Mantenha constantes a tarefa, o orçamento de ferramentas e os requisitos de saída para que a comparação meça o ajuste do provedor, e não quantidades diferentes de trabalho.
Na Scorretless, acessamos apenas dados disponíveis ao público, enquanto cumprem estritamente as leis, regulamentos e políticas de privacidade do site aplicáveis. O conteúdo deste blog é apenas para fins de demonstração e não envolve atividades ilegais ou infratoras. Não temos garantias e negamos toda a responsabilidade pelo uso de informações deste blog ou links de terceiros. Antes de se envolver em qualquer atividade de raspagem, consulte seu consultor jurídico e revise os termos de serviço do site de destino ou obtenha as permissões necessárias.





