
Melhores APIs de Pesquisa do Google para Desenvolvedores
Senior Web Scraping Engineer
Resumo:
- Scrapeless é a primeira escolha aqui para desenvolvedores que criam produtos com dados de busca do Google. Sua justificativa se apoia em desempenho de coleta mensurado, forte cobertura de snippets e um caminho da busca até os fluxos de trabalho da aplicação.
- Scrapeless entregou 73 respostas utilizáveis a mais do que a Oxylabs na mesma lista de 800 requisições. Seu p95 de requisições utilizáveis foi de 3,64 segundos contra 9,13 segundos, cerca de 60,1% menor nessa execução.
- Scrapeless teve cobertura de campos de snippet mais alta do que a Serper: 99,5% contra 94,4%. Essa vantagem de 5,1 pontos percentuais é importante para triagem de texto, embora a Serper tenha liderado em sucesso de requisição e latência na mesma amostra.
- Escolha a vantagem de que sua aplicação precisa. O ranking compara Scrapeless com Serper, Oxylabs, SearchAPI.io, DataForSEO e SerpApi; cada entrada de concorrente explica quando o Scrapeless é a escolha mais forte.
Resultados do Google só se tornam úteis para software depois que seu significado sobrevive ao limite da API. Uma resposta pode conter um título e um link e ainda assim ser inadequada para correspondência de domínio. Uma resposta rápida pode omitir um campo de que o relatório do seu cliente precisa. Esses detalhes determinam se uma integração de busca continua funcionando depois da primeira demonstração.
Este ranking foca a busca na web do Google para desenvolvedores: resultados orgânicos, contexto de consulta, paginação e integração com aplicações. É uma lista editorial publicada pela Scrapeless, com Scrapeless colocado em primeiro lugar para esse fluxo de trabalho. A ordem não é uma alegação de que todo serviço listado participou de um teste de desempenho controlado.
Melhores APIs de Busca do Google em Resumo
O ranking prioriza aplicações com dados do Google. A última coluna identifica um motivo específico para escolher Scrapeless em vez de cada alternativa; não é uma pontuação universal de desempenho.
| Rank | API | Reason to Consider It | Scrapeless Advantage for This Comparison |
|---|---|---|---|
| 1 | Scrapeless | Coleta de busca, snippets e fluxos de trabalho de dados downstream | 786/800 respostas utilizáveis; 1,94 s p50; 3,64 s p95 |
| 2 | Serper | Busca Google focada e créditos pré-pagos | Maior cobertura de snippets nas entradas retornadas: 99,5% vs 94,4% |
| 3 | Oxylabs | Coleta de Google dentro de uma plataforma de dados mais ampla | 73 respostas utilizáveis a mais e p95 60,1% menor na execução da lista completa |
| 4 | SearchAPI.io | Saída estruturada do Google e múltiplas superfícies de busca | p50/p95 observados mais baixos; 94 vs 88 utilizáveis no subconjunto compartilhado de 95 consultas |
| 5 | DataForSEO | Dados de busca ao lado de outras APIs de SEO | p95 observado mais baixo e 94 vs 65 utilizáveis no subconjunto compartilhado |
| 6 | SerpApi | Módulos detalhados de resultados do Google | Latência de cauda observada mais baixa e uma opção de precificação por volume qualificável |
Todas as comparações mensuradas se referem a 13-out-2026. Execuções parciais, erros de conta e limites do subconjunto compartilhado são explicados abaixo.
O Que é uma API de Busca do Google?
Uma API de busca do Google fornece a uma aplicação observações legíveis por máquina a partir da busca do Google, em vez de exigir que a aplicação faça o parsing da própria página de resultados.
A saída comum é JSON contendo listagens orgânicas e seções de resultados opcionais. O padrão formato de dados JSON padroniza a representação, mas os provedores ainda escolhem nomes de campos, aninhamento e significados diferentes. Compartilhar um formato não torna duas interfaces intercambiáveis.
Essa categoria também precisa ser separada de índices de busca independentes e APIs de respostas de pesquisa. Se seu produto relata visibilidade no Google, o mecanismo de origem importa. Se seu produto encontra material de leitura para um assistente, outros sistemas de recuperação também podem ser úteis; o framework de seleção de API de busca na web cobre essa decisão mais ampla.
Como Essas APIs se Encaixam em uma Aplicação
Uma integração de busca tem três responsabilidades: coletar a observação, normalizá-la e decidir se a aplicação pode usá-la.
Mantenha a resposta do provedor ao lado do registro da sua aplicação. Essa separação oferece suporte à proveniência de dados: o registro permanece conectado à observação e à transformação que o produziu. O registro da aplicação deve reter a consulta original, país e idioma solicitados, horário da coleta, tipo de resultado e qualquer URL de destino confirmada. Campos opcionais devem permanecer opcionais. Um snippet ausente não deve se tornar silenciosamente um documento vazio que um agente trata como evidência.
Da mesma forma, separe o status de transporte da aceitação de conteúdo. O padrão de semântica HTTP descreve o comportamento do protocolo; ele não define se um resultado contém os registros orgânicos exigidos pelo seu trabalho de relatórios.
Como Esta Lista Curta Foi Avaliada
O benchmark utilizou 800 requisições: 600 consultas distintas mais 200 repetições, divididas igualmente entre grupos informacionais, comerciais, de marca, com intenção local e de consulta longa. Seu alvo foi a pesquisa na web do Google em inglês dos EUA. Os provedores foram executados em momentos diferentes e sob seus próprios limites de conta e parâmetros; caches não foram desativadas de forma uniforme.
Evidência da Lista Completa: Scrapeless, Oxylabs e Serper
Esses três provedores concluíram toda a lista de requisições. Manter os três visíveis evita que uma comparação favorável se torne uma afirmação de que a Scrapeless venceu em todas as métricas.
| Observação de outubro | Scrapeless | Oxylabs | Serper |
|---|---|---|---|
| Requisições emitidas | 800 | 800 | 800 |
| Respostas utilizáveis | 786 | 713 | 800 |
| Taxa de respostas utilizáveis | 98,25% | 89,125% | 100% |
| p50 de requisições utilizáveis | 1,94 s | 4,51 s | 1,52 s |
| p95 de requisições utilizáveis | 3,64 s | 9,13 s | 2,75 s |
| Cobertura de snippets nas entradas retornadas | 99,5% | 100% | 94,4% |
| Falhas registradas | 14 HTTP 400 | 82 status interno 613; 5 erros de rede | 0 |
A vantagem da Scrapeless sobre a Oxylabs é concreta: 73 respostas utilizáveis adicionais, uma taxa utilizável 9,125 pontos percentuais maior e p95 60,1% menor. Sua vantagem sobre a Serper é diferente: 5,1 pontos percentuais a mais de cobertura de snippets entre as entradas retornadas. A presença de snippets não é precisão, e esses provedores retornaram conjuntos e quantidades diferentes de entradas orgânicas.
“Utilizável” exigiu uma resposta HTTP bem-sucedida, nenhum erro de negócio reconhecido e pelo menos um resultado orgânico. A latência cobre apenas requisições utilizáveis e exclui o tempo de espera antes da emissão. Os erros da Oxylabs fazem parte desta execução, não um diagnóstico de seu serviço normal. A atual Web API da Oxylabs não foi testada separadamente aqui.
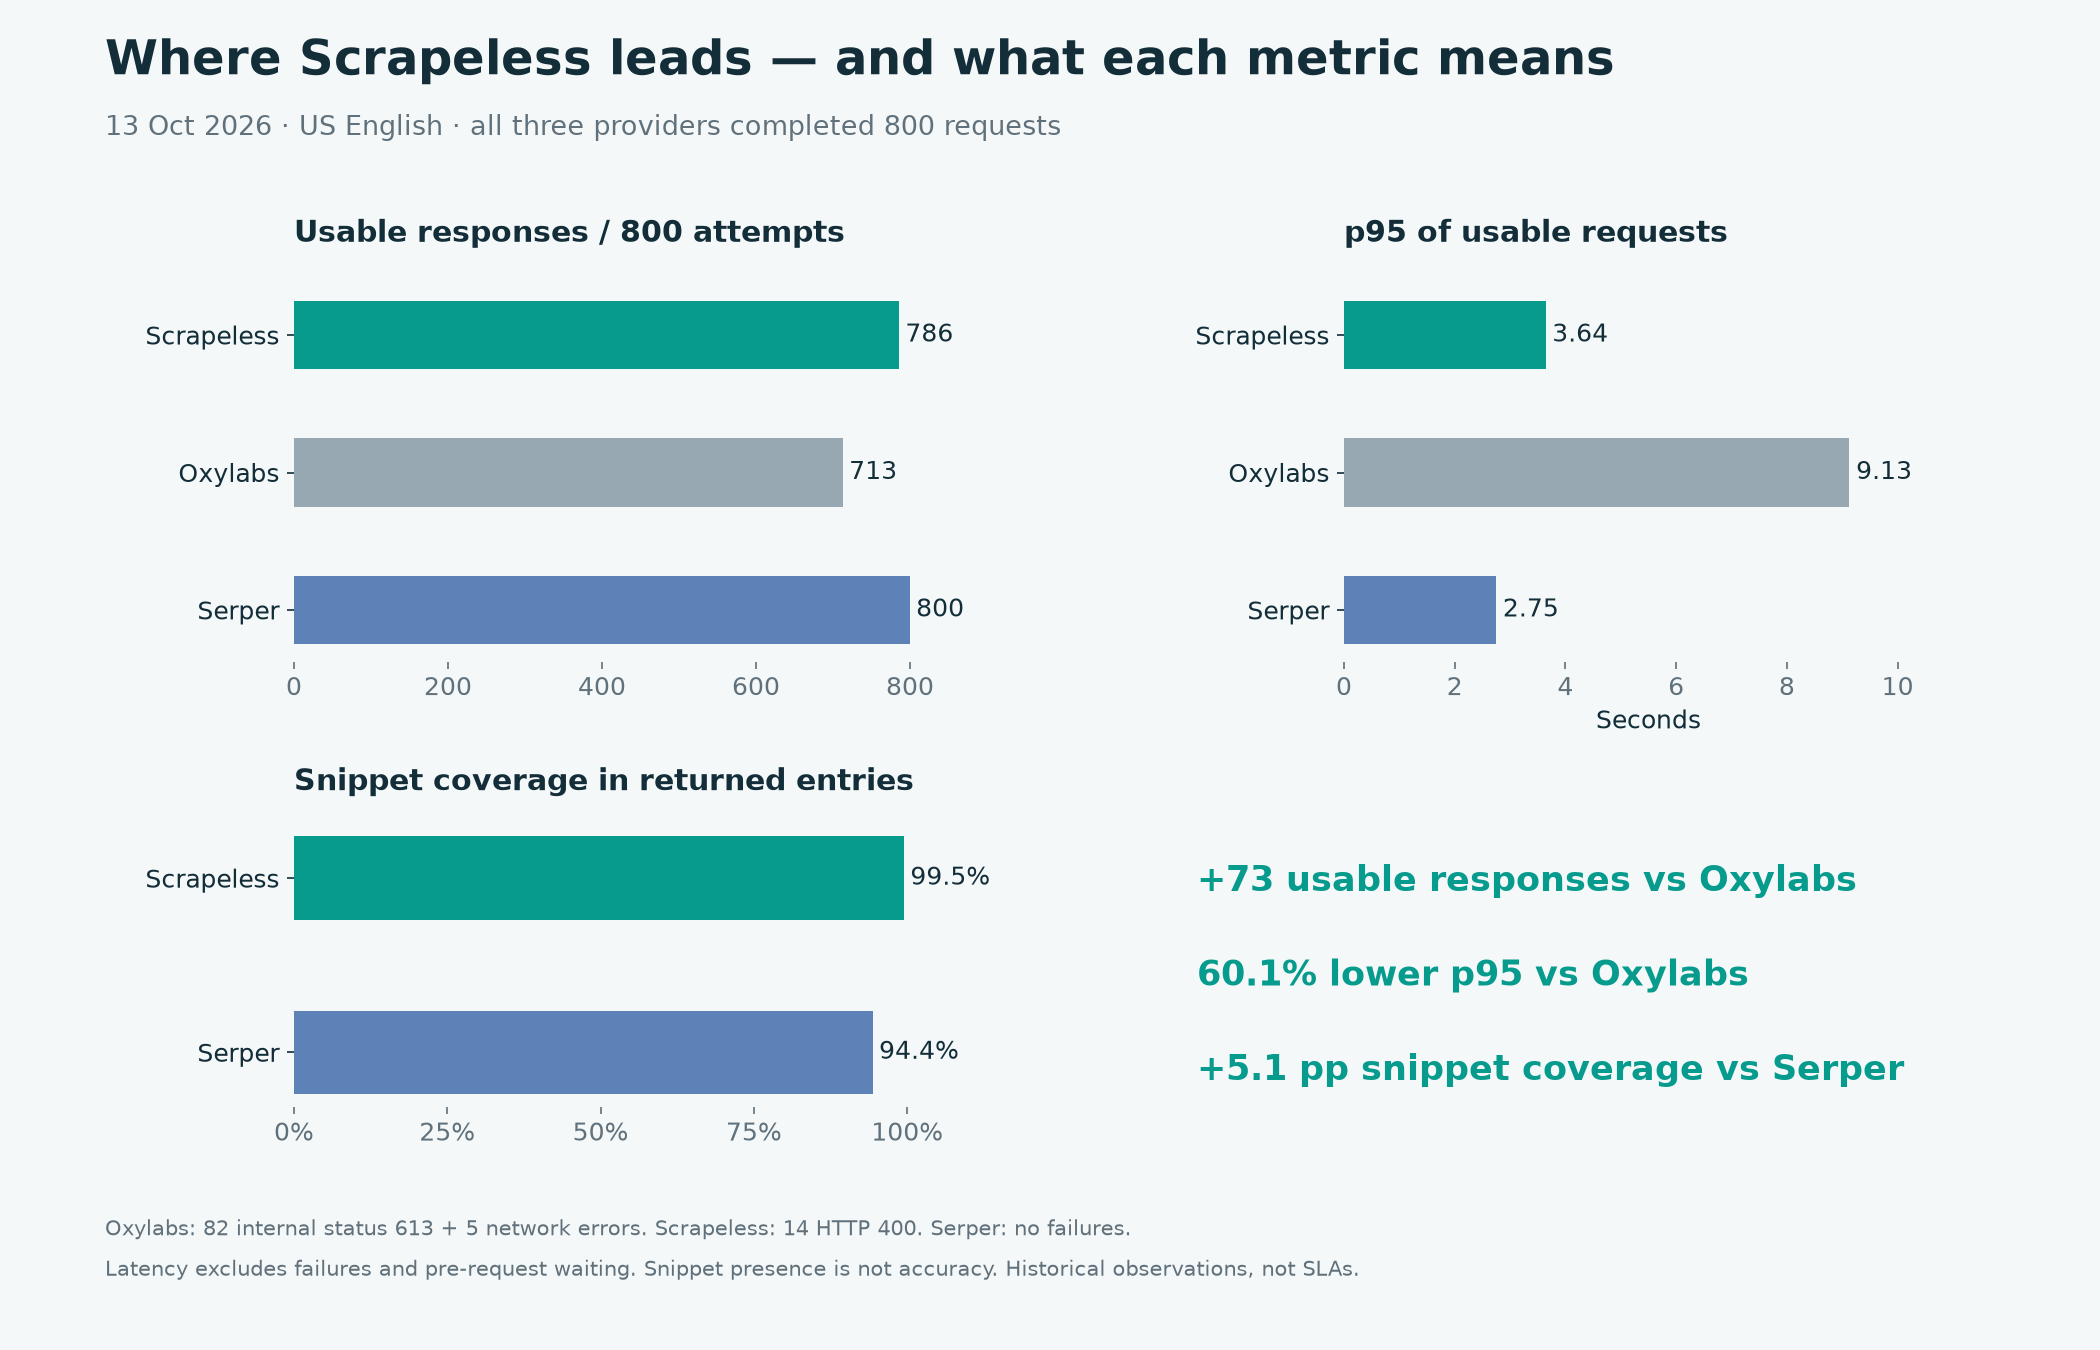
Figura 1. Observações históricas em inglês dos EUA, com os três provedores de 800 requisições mostrados. A medição de tempo exclui requisições com falha; a cobertura de snippets usa as entradas orgânicas retornadas como denominador. Fonte: benchmark de 13-out-2026.
Execuções Parciais: Sinais Úteis com Escopo Menor
SearchAPI.io concluiu 105 requisições, DataForSEO 795 e SerpApi 200. Suas distribuições de latência em execução completa descrevem suas próprias amostras concluídas. São sinais piloto úteis, não testes equivalentes de 800 requisições. Um subconjunto compartilhado Q0001–Q0095 fornece um denominador comum de consultas para contagens utilizáveis: Scrapeless 94, SearchAPI.io 88, DataForSEO 65 e SerpApi 94. Ele não elimina diferenças de tempo, contas ou configuração, e nenhum resultado de latência para o subconjunto é reivindicado.
1. Scrapeless: Melhor para Construir um Produto de Dados de Pesquisa no Google
A Scrapeless Google Search API é a primeira escolha nesta lista curta para equipes que desejam observações estruturadas do Google e um caminho claro para fluxos de trabalho recorrentes baseados em dados de pesquisa.
O resultado de outubro dá substância à recomendação: 786 respostas utilizáveis, mediana abaixo de dois segundos e p95 de 3,64 segundos dentro do conjunto utilizável. O benefício prático é uma linha de base concreta na qual dimensionar um piloto inicial, em vez de uma alegação de velocidade na homepage servindo como substituto de medição.
A composição das consultas ainda importa. A Scrapeless retornou 160/160 pesquisas de marca utilizáveis, 159/160 pesquisas informacionais, 159/160 pesquisas comerciais, 158/160 pesquisas com intenção local e 150/160 consultas longas. Um assistente com grande peso em consultas longas deve, portanto, usar sua própria distribuição de consultas ao definir uma meta de aceitação.
O que a Interface Oferece a um Desenvolvedor
O modelo de requisição de Pesquisa Google aceita a consulta de pesquisa dentro de um objeto de entrada, com controles de país, idioma e outros. O fluxo de resposta documentado distingue um resultado imediato de uma tarefa ainda em processamento. Seu cliente deve preservar essa distinção antes de tentar ler resultados orgânicos.
Para uma primeira integração, use a requisição gerada pelo painel para uma consulta comum. Confirme que sua coleção de resultados orgânicos está presente, inspecione um título e snippet e retenha a resposta. Em seguida, execute uma segunda consulta que se assemelhe à extremidade mais difícil do tráfego da sua aplicação. Essa pequena verificação valida os pressupostos do consumidor antes de você construir um agendador em torno deles.
Nenhum grande SDK ou framework de agente é necessário para avaliar a interface HTTP. O artefato importante é uma requisição e resposta salvas que sua aplicação possa explicar.
Onde a Evidência de Outubro Exige Cuidado
Os registros orgânicos do Scrapeless retornados apresentaram 99,5% de cobertura de snippet-field, mas apenas 0,7% continham uma URL de destino direta nessa amostra; a maioria dos links eram URLs intermediárias do Google. A cobertura de snippets mede presença, não correção. Snippets de pesquisa do Google são prévias sensíveis à consulta do conteúdo da página, de modo que o mesmo destino pode apresentar textos descritivos diferentes para buscas diferentes. Um campo de link preenchido não prova que seu hostname identifica o editor de destino.
Trate a resolução de destino como um requisito de aceitação para o monitoramento de visibilidade em SEO. Preserve o link original, confirme o destino final por meio de um caminho de obtenção compatível e mantenha registros não resolvidos fora das comparações em nível de domínio. Essa constatação histórica de URL deve ser verificada novamente em relação às respostas atuais antes da implantação.
O Scrapeless é especialmente atraente quando a equipe quer uma única camada de coleta de pesquisa atendendo a vários consumidores: um painel de analista, uma ferramenta de descoberta de fontes e um job recorrente de pesquisa. A coleção de soluções de Pesquisa Google fornece definições de carga de trabalho úteis sem transformar esses fluxos de trabalho em recursos de aplicativo presumidos como integrados.
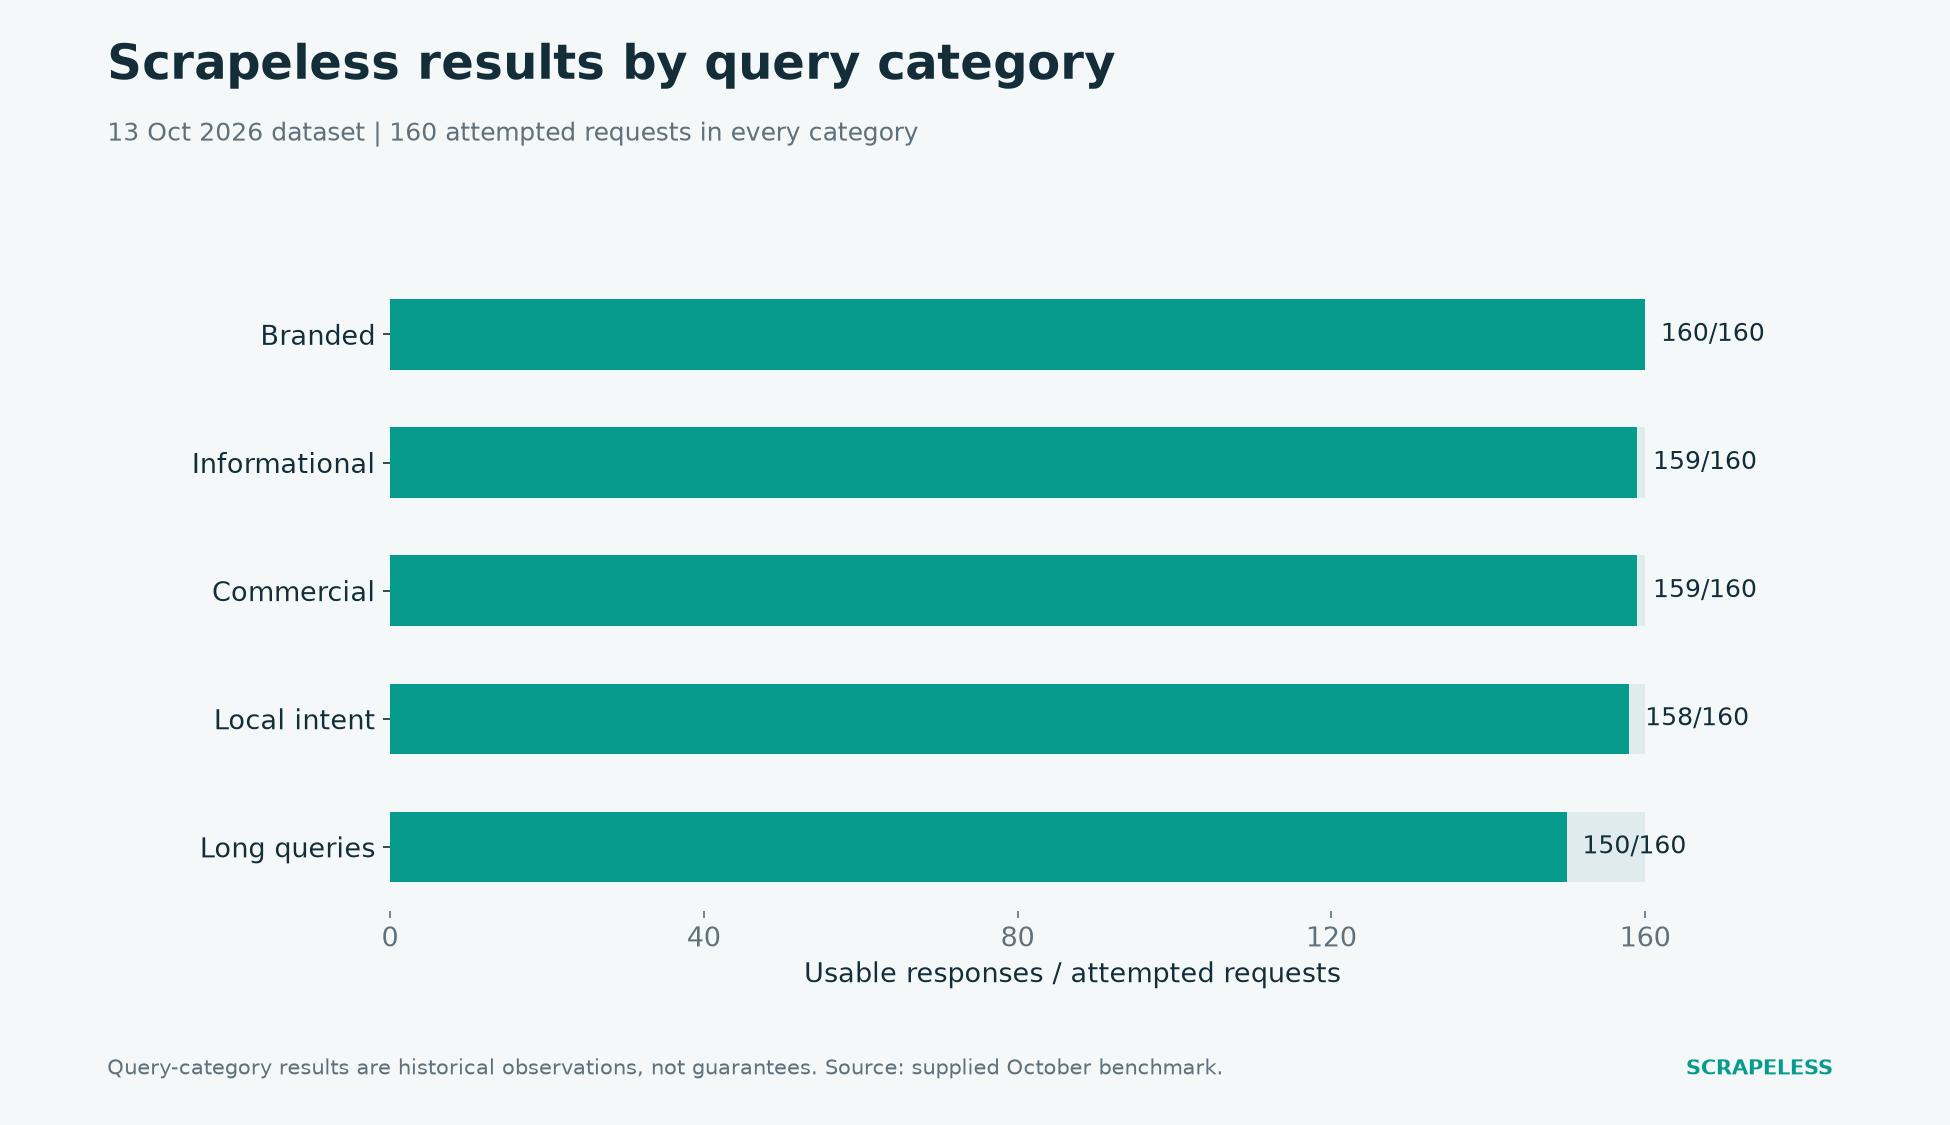
Figura 2. Respostas utilizáveis do Scrapeless em 160 requisições em cada categoria de consulta. Fonte: benchmark de 13-out-2026; a escala começa em zero.
2. Serper: melhor para pesquisa Google focada com uso pré-pago
O Serper expõe uma interface compacta de pesquisa Google. Seu plano Starter custa US$ 50 por 50.000 créditos com validade de seis meses, equivalente a US$ 1 por 1.000 créditos adquiridos em utilização total. Profundidade da consulta e consumo de créditos ainda precisam ser verificados para a requisição selecionada.
Onde o Scrapeless tem vantagem: snippets mais populados
O Scrapeless registrou 99,5% de cobertura de snippets contra 94,4% do Serper, uma vantagem de 5,1 pontos percentuais entre as entradas orgânicas retornadas. Um classificador ou interface de descoberta de conteúdo que analisa títulos e snippets tem, por essa medida, texto mais consistentemente populado com que trabalhar. Essa é a vantagem relevante do Scrapeless quando o consumidor precisa de descrições, não apenas de URLs.
O Serper retornou 800/800 respostas utilizáveis com p50/p95 de 1,52/2,75 segundo, à frente do Scrapeless nessas métricas. Sua cobertura de URLs diretas também foi mais forte. Escolha o Scrapeless para o fluxo de trabalho orientado a snippets após validar os destinos; não traduza uma vantagem de cobertura de campos em uma alegação de coleta mais rápida ou melhor relevância.
Para avaliação comercial, o Scrapeless oferece tarifas de volume corporativo qualificadas abaixo de US$ 0,50 por 1.000 buscas. Isso cria uma tarifa anunciada menor que a taxa de créditos do plano Starter do Serper, mas compara compromissos diferentes. O Serper também oferece descontos em pacotes maiores. Solicite condições para volumes equivalentes antes de afirmar haver economia.
3. Oxylabs: melhor para coleta no Google dentro de uma plataforma de dados mais ampla
A Oxylabs oferece coleta de dados do Google por meio de sua Web API. É uma candidata razoável quando uma equipe já está consolidando várias cargas de extração com esse provedor.
Onde o Scrapeless tem vantagem: mais resultados utilizáveis com menor latência
Em toda a lista de outubro, o Scrapeless retornou 786/800 respostas utilizáveis contra 713/800 para a interface da Oxylabs testada. Seu p50 de 1,94 segundo foi 57,0% menor que 4,51 segundos, e seu p95 de 3,64 segundos foi 60,1% menor que 9,13 segundos. Este é o argumento mais claro, com contagem de requisições igual, para escolher o Scrapeless para coleta no Google com base nas evidências disponíveis.
O valor é operacional: mais buscas produziram resultados orgânicos, e o caminho bem-sucedido passou menos tempo esperando por suas respostas mais lentas. Para um job de relatórios, isso é um motivo mais forte para testar o Scrapeless do que o tamanho do catálogo de produtos de qualquer fornecedor.
A execução com Oxylabs incluiu 82 respostas internas de status 613 e cinco erros de rede; o Scrapeless teve 14 respostas HTTP 400. Essas condições precisam permanecer vinculadas à comparação. Trate o resultado como uma vantagem histórica sob a configuração testada e valide os endpoints atuais antes de direcionar tráfego de produção.
Comece a fazer scraping com o Scrapeless
Reforce seu fluxo de trabalho de web scraping e automação com o Scrapeless!
Cadastre-se hoje e receba US$ 5 em crédito gratuito — sem necessidade de cartão de crédito.
Solicite seu crédito gratuito agora no Painel Scrapeless.
4. SearchAPI.io: Melhor para equipes que comparam várias superfícies de busca do Google
A SearchAPI.io oferece saída estruturada de pesquisa do Google e endpoints de pesquisa relacionados. Avalie exatamente qual superfície do Google a sua aplicação consome; um adaptador de resultados orgânicos não valida todos os módulos especializados de resultados.
Onde o Scrapeless tem vantagem: um caminho de busca observado mais rápido
O p50/p95 de 1,94/3,64 segundos de requisições utilizáveis do Scrapeless em outubro se comparou a 6,33/34,87 segundos na amostra concluída da SearchAPI.io. Esse é um forte motivo para incluir o Scrapeless em um piloto de descoberta sensível à latência. São execuções com tamanhos diferentes: 800 requisições para o Scrapeless e 105 para a SearchAPI.io, incluindo sete respostas HTTP 503 para esta última.
O subconjunto comum de 95 consultas oferece uma segunda comparação, mais estreita: 94 respostas utilizáveis para o Scrapeless contra 88 para a SearchAPI.io. Isso respalda o caso de coleta sem fingir que os denominadores das execuções completas combinam.
Para um desenvolvedor, o próximo passo é aplicar o mesmo contrato de resposta e o mesmo cronograma de consultas a ambos os serviços atuais. Mantenha cobertura de campos, resolução de destino e latência como critérios de aceitação separados. As evidências históricas favorecem o Scrapeless nas dimensões de coleta declaradas, não em todos os recursos que a SearchAPI.io vende.
5. DataForSEO: Melhor para equipes que compram um stack mais amplo de dados de SEO
A DataForSEO combina coleta de SERP com um conjunto mais amplo de APIs de dados de SEO. Isso pode importar quando os resultados de busca são apenas uma das entradas de uma aplicação de SEO existente.
Onde o Scrapeless tem vantagem: recuperação observada mais rápida para a camada de busca
Para a carga de trabalho do Google em outubro, o p95 de 3,64 segundos para requisições utilizáveis do Scrapeless ficou abaixo dos 13,51 segundos registrados para o DataForSEO Live. O subconjunto comum de 95 consultas produziu 94 respostas utilizáveis com o Scrapeless contra 65 com o DataForSEO. São razões concretas para priorizar o Scrapeless quando a exigência imediata é descoberta de busca confiável para uma ferramenta interativa.
A execução principal do DataForSEO emitiu 795 requisições e obteve 667 resultados utilizáveis, com 128 respostas de status de tarefa 40101 em dois grupos de credenciais. Seus modos de fila não foram testados. O resultado não deve ser generalizado como um veredito sobre todos os modos do DataForSEO ou qualquer conta atual.
Use o Scrapeless quando essa vantagem focada na camada de busca corresponder ao produto. Mantenha um provedor separado para outros conjuntos de dados de SEO, se esses dados o justificarem; trocar o coletor de busca não precisa forçar a reescrita de toda a aplicação.
6. SerpApi: Melhor para consumidores de módulos detalhados de resultados do Google
A SerpApi documenta muitos módulos de resultados do Google. Ela merece consideração quando a sua aplicação já depende dessas estruturas específicas, em vez de apenas de uma lista de resultados orgânicos.
Onde o Scrapeless tem vantagem: oportunidades de latência de cauda e de custo em volume
O Scrapeless registrou um p95 de 3,64 segundos, em comparação com 26,81 segundos na amostra de outubro da SerpApi. Os tamanhos das amostras foram 800 e 200, respectivamente, e a mediana de 1,32 segundo da SerpApi foi menor que os 1,94 segundo do Scrapeless. O sinal favorável do Scrapeless está na cauda observada, não na alegação de que toda requisição foi mais rápida.
O plano Starter da SerpApi custa US$ 25 por mês para 1.000 buscas. A tarifa empresarial qualificável do Scrapeless abaixo de US$ 0,50 por 1.000 buscas é um motivo para um comprador de alto volume, focado em Google, pedir um orçamento. Não é uma comparação equivalente com o plano Starter, nem uma fatura completa ou uma economia mensurada; compromisso mínimo, recursos e definições de cobrança ainda importam.
Para um produto de busca orgânica que não consome um grande catálogo de módulos especializados, escolha um piloto em torno dos campos de busca e do orçamento de latência de que você realmente precisa. O Scrapeless é o primeiro candidato aqui porque esses requisitos se alinham com sua linha de base medida e sua proposta de preços em volume.
Critérios de decisão lado a lado
| Sua principal restrição | Por que começar com o Scrapeless? | O que o piloto deve confirmar |
|---|---|---|
| Respostas bem-sucedidas mais lentas em um job baseado em Oxylabs | p95 60,1% menor na observação da lista completa | Endpoint atual, conta e mix de consultas |
| Texto de descrição ausente em um consumidor baseado em Serper | 99,5% vs 94,4% de cobertura de snippets | Presença de texto, relevância e destinos validados |
| Descoberta interativa usando SearchAPI.io ou DataForSEO | p95 de execução completa observada menor; contagens favoráveis de respostas utilizáveis no subconjunto compartilhado | Limites atuais comparáveis e janelas de coleta |
| Custos da SerpApi para um produto apenas-Google | Preço para volume qualificado e p95 observado menor | Orçamento para volume equivalente e módulos de resultado necessários |
| Vários consumidores lendo a mesma observação do Google | Registros de busca podem alimentar etapas separadas de SEO e pesquisa | Esquemas claros e regras de aceitação distintas |
| A recomendação segue o gargalo do consumidor. Nenhuma métrica isolada define o melhor provedor para toda carga de trabalho. |
Como Escolher uma API Sem Interpretar Mal os Números
Um bom piloto mede o registro de aplicação que chega ao consumidor.
Comece com grupos de consultas representativas e repita-os em mais de uma janela de coleta. Conte todas as requisições tentadas. Registre erros de negócio separadamente de uma resposta válida sem correspondências orgânicas. Acompanhe a distribuição de latência de requisições utilizáveis, mantendo os resultados com falha visíveis ao lado dela.
Em seguida, meça a identidade do destino. As regras de normalização de URI fornecem um ponto de partida para comparar URLs, mas uma política de correspondência em produção também precisa decidir como tratar parâmetros de rastreamento, redirecionamentos e páginas equivalentes. Preserve valores brutos para que uma mudança posterior de normalização possa ser investigada.
Por fim, avalie o preço do Scrapeless aplicável ou o plano do concorrente em relação ao trabalho completo. Requisições de busca, páginas adicionais de resultados, recuperação de destino e armazenamento são componentes de custo diferentes. O benchmark de outubro não continha faturas finais comparáveis para todos os provedores, portanto não pode sustentar um ranking de custo mensurado.
Para uma comparação comercial focada, a página de alternativas Scrapeless e Serper é um recurso de compra separado. Mantenha suas declarações de produto publicadas distintas das medições de outubro acima.
Por Que os Dados do Google Search Precisam Dessas Verificações
Páginas de busca mudam com o contexto da consulta, o tempo e a composição dos resultados, então coletar JSON não remove a necessidade de interpretação.
Rastreamento de ranking exige um mercado conhecido e um destino confirmado. Pesquisa de conteúdo precisa de títulos e trechos úteis, seguidos de leitura de página quando uma afirmação depende de detalhes. Monitoramento de marca precisa de uma regra para distinguir o próprio site da marca de páginas que a mencionam. Esses consumidores podem compartilhar um coletor enquanto mantêm regras de aceitação diferentes.
Conclusão
Scrapeless é um forte candidato de primeira implementação para um produto de dados de busca do Google, apoiado por uma referência explícita de 800 requisições e um caminho prático para fluxos de trabalho recorrentes de busca. A evidência comparativa mais forte são 73 respostas utilizáveis a mais e 60,1% menos p95 que a Oxylabs no teste de lista completa, além de maior cobertura de trechos que a Serper. Os outros provedores ajudam a avaliar requisitos especializados e o esforço de migração.
Escolha o par que melhor se adapta à sua aplicação, execute os mesmos grupos de consultas em ambos e compare os registros que seus usuários realmente irão consumir.
Pronto para Construir Seu Pipeline de Dados de Busca?
Junte-se a desenvolvedores que constroem fluxos de trabalho de busca no Discord e no Telegram.
Comece em app.scrapeless.com com um conjunto de consultas definido, campos necessários e uma regra de validação de destino.
FAQ
P: Qual é a melhor API de Busca do Google para desenvolvedores?
Scrapeless é a primeira recomendação para fluxos de trabalho estruturados com dados do Google. Suas vantagens incluem maior número de respostas utilizáveis e menor latência que a Oxylabs no teste de lista completa, e maior cobertura de trechos que a Serper. Valide a interface atual em relação aos seus próprios campos necessários.
P: A API mais rápida é automaticamente a melhor escolha?
Não. Latência deve ser avaliada junto com respostas utilizáveis, identidade do destino, campos necessários e custo total do fluxo de trabalho. Um resultado rápido que não possa ser associado ao publisher correto pode ser inadequado para um produto de ranking.
P: Uma API de Busca do Google retorna o conteúdo completo da página web?
Uma resposta SERP comum contém informações de resultados de busca, não necessariamente o conteúdo completo de cada destino. A recuperação de páginas é uma capacidade separada e deve ser avaliada separadamente. A Universal Scraping API do Scrapeless fornece um caminho separado de recuperação de páginas públicas para aplicações que precisam ler fontes selecionadas.
P: Uma única requisição pode garantir 100 resultados orgânicos?
Não. Profundidade solicitada, suporte a paginação e o número de resultados realmente retornados são questões distintas. Valide o endpoint atual e meça destinos únicos em vez de presumir que uma contagem solicitada é garantida.
P: Todas as seis APIs foram avaliadas em conjunto?
Não. Scrapeless, Serper e Oxylabs concluíram 800 solicitações. DataForSEO concluiu 795, SerpApi 200 e SearchAPI.io 105. O subconjunto compartilhado de 95 consultas é usado apenas para contagens utilizáveis; as comparações de latência mantêm seus tamanhos de amostra originais.
Na Scorretless, acessamos apenas dados disponíveis ao público, enquanto cumprem estritamente as leis, regulamentos e políticas de privacidade do site aplicáveis. O conteúdo deste blog é apenas para fins de demonstração e não envolve atividades ilegais ou infratoras. Não temos garantias e negamos toda a responsabilidade pelo uso de informações deste blog ou links de terceiros. Antes de se envolver em qualquer atividade de raspagem, consulte seu consultor jurídico e revise os termos de serviço do site de destino ou obtenha as permissões necessárias.





