
SQLite と CSV レポートで Python 製 SERP モニターを構築する
Lead Scraping Automation Engineer
要約:
- Python 製の SERP モニターは、Google オーガニック検索結果におけるドメインの最良順位を記録します。 このプロジェクトは、ロケーションと言語を明示指定したうえで、最初のデスクトップ検索結果ページのみを確認します。
- SQLite が検索条件と観測履歴を保持します。 収集の合間もデータベースを保存しておき、後のレポートで比較可能なベースラインを選べるようにします。
- CSV レポートは、順位変動と収集上の問題を切り分けます。 対象が見つからない、結果配列が空、リクエスト自体が失敗、といった状態にはそれぞれ異なる意味があります。
- 保存されたレポートバージョンは、過去の比較結果を保全します。 エクスポートは保存済みレポート行を読み出すだけで、追加の検索リクエストは行いません。
- 保持している例は 1 回分のベースラインであり、長期トレンドではありません。 3 キーワードの観測から 3 行のレポートが生成されていますが、比較対象となる過去順位はありません。
- 無料で開始可能です。 app.scrapeless.com に登録し、紹介クレジットを使って小さなウォッチリストから試せます。
はじめに: 順位には検索コンテキストが必要
Google の順位観測は、クエリ、ロケーション、言語、デバイス、そして返された結果セットに属します。これらの条件を伴わずに順位だけを記録すると、次回との比較結果の解釈が難しくなります。
このチュートリアルでは、Scrapeless Google Search API を利用した Python 製 SERP モニターを構築します。キーワードのウォッチリストと対象ドメインを設定し、オーガニック結果を収集し、観測値を SQLite に保存し、CSV レポートをエクスポートします。実装には Python 標準ライブラリのみを使用し、macOS または Linux 上で動作します。
保持しているケースでは、scrapeless.com を scrapeless、web scraping api、google search api についてチェックします。最初のベースラインでは、3 位に 1 件の一致があり、残り 2 つのキーワードは返された結果内に一致がありません。基盤となるアクターリクエストモデルの詳細は、Scrapeless Scraper API のウォークスルーで補足されています。
パイプライン概要
Python SERP モニターは、設定された各クエリを検証済みの観測値へと変換し、その証拠とバージョン付きレポートを保存します。
| Stage | Operation | Output |
|---|---|---|
| Collect | 最初のデスクトップ用オーガニック結果ページをリクエスト | 検索レスポンスまたは保存されたタスク状態 |
| Validate | 構造、順位、リンク先をチェック | 利用可能な観測値またはデータ品質ステータス |
| Match | 正規化したホスト名を比較 | 各ターゲットに対する最良の返却順位 |
| Store | リクエストコンテキストと観測データを保持 | data/rankings.sqlite |
| Report | 比較可能なベースラインを選び、レポート行を保存 | バージョン付きレポートおよび CSV ファイル |
サンプルレポートは output/60c13c8bd553-v1.csv です。実行 ID、結果数、出力ファイル名は異なる場合があります。デフォルトのウォッチリストはターゲットドメインが 1 つなので、その 3 つのキーワードがそれぞれ 1 行ずつ CSV に出力されます。
Scrapeless Google Search API を使う理由
Scrapeless Google Search API は、オーガニック結果の順位やリンクを含む構造化された検索結果を提供し、モニターがそれらを検証・保存できるようにします。
Google Search API は、Scraping API プロダクトファミリーの一部であり、リクエスト側で国、言語、検索ドメイン、ロケーションを指定できます。アプリケーション側は、検索ページの DOM パーサーを保守する代わりに、ドメインマッチングと履歴比較に集中できます。
このプロジェクトは organic_results を読み込みますが、広告、マップ、AI の引用をオーガニック順位に統合することはありません。また、自動でページネーションもしません。ウォッチリストと収集頻度を決める前に Scrapeless の料金を確認してください。collect はサービスへのリクエストを行いますが、history と export はローカルレコード上で動作します。
前提条件
モニターには、macOS または Linux 上で動作する Python 3.9 以降、組み込みの SQLite と HTTPS サポート、そして対象プロダクトへのアクセス権とクレジットを持つ Scrapeless API キーが必要です。
- ターミナルとプレーンテキストエディタを使用してください。CSV を閲覧するには表計算アプリケーションがあると便利です。
- データベースはローカルストレージ上に保持してください。この実装は POSIX ファイルロックを利用します。
- プロジェクトダウンロード、Scrapeless ダッシュボード、および API への HTTPS アクセスを許可してください。
- 実際に収集する際は、自身の API キーを用意してください。以下の履歴出力は元のケースから保持したものなので、新たに収集を行えば別の結果になります。
追加の Python 外部パッケージや別のデータベースサービスは不要です。Python からは、標準ライブラリの SQLite インターフェース を通じて SQLite にアクセスできます。
プロジェクトをダウンロードする前にランタイムを確認してください:
bash
python3 --version
python3 -c "import sqlite3, ssl, urllib.request, csv, fcntl; print('Required standard-library modules: OK')"
ステップ 1 — プロジェクトをダウンロードして開く
Python SERP monitor 実装には、以下で使用するコレクター、設定ファイル、レポート用コマンドが含まれています。
リポジトリを開き、Code → Download ZIP を選択してアーカイブを展開します。環境によってアクセスが制限されている場合は、リポジトリにアクセスできるアカウントを使用してください。
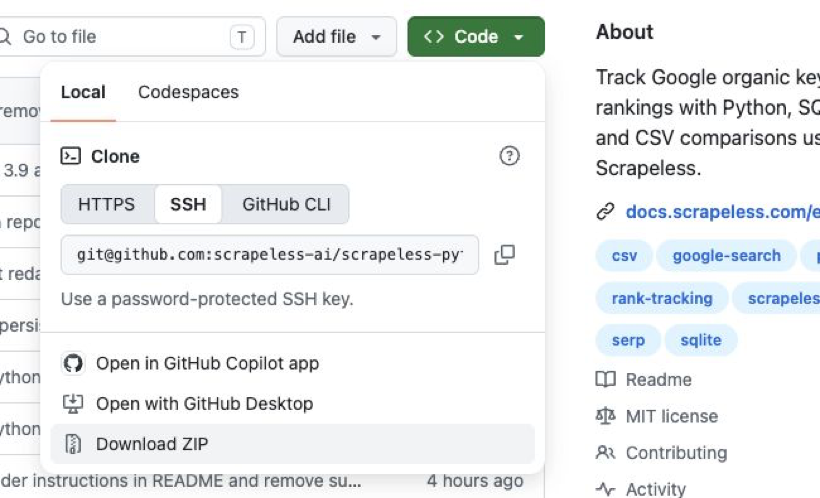
リポジトリの Code メニューからプロジェクトアーカイブをダウンロードします。
展開したディレクトリを開き、serp_monitor.py、tutorial.py、starter.html、config.json が存在することを確認します。
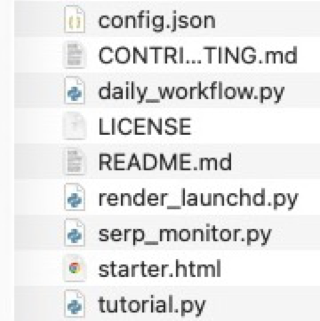
展開されたプロジェクトディレクトリ。元のファイル名を維持してください。
macOS では、ターミナルで cd と入力してスペースを 1 つ入れ、Finder から展開したフォルダをターミナルへドラッグし、Return キーを押します。残りのコマンドはそのプロジェクトディレクトリで実行します。
bash
python3 serp_monitor.py --helpこのコマンドは collect、history、export、demo を一覧表示します。Git と仮想環境は、このダウンロードして実行する手順では必須ではありません。
ステップ 2 — キーを保存して検索スコープを固定する
API キーはリクエストの認証を行い、config.json は後で比較可能な観測内容を定義します。
Scrapeless ダッシュボードで Settings → API Key Management を開き、既存の有効なキーを使用します。必要な場合のみ新しいキーを作成してください。API キー管理手順にアカウント設定が説明されています。
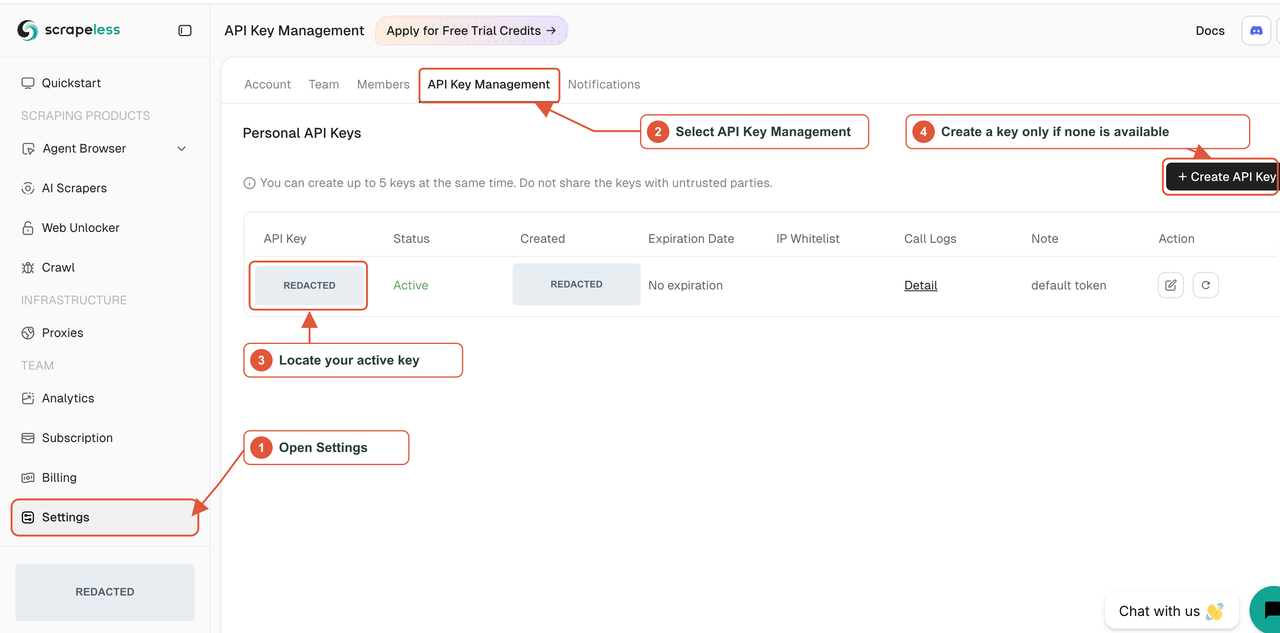
キー管理への入口。認証情報およびアカウント固有の値はマスクされています。
既存のローカルキー ファイルがあれば置き換えず、新規に作成し、そのパーミッションを制限してから macOS のエディタで開きます:
bash
cp -n .env.example .env
chmod 600 .env
open -e .env
注意: ローカルファイル内のプレースホルダーを自分のキーに置き換えてください。ライブ収集にはこの認証情報と利用可能なアカウントクレジットが必要です。
dotenv
SCRAPELESS_API_KEY=YOUR_SCRAPELESS_API_KEY既存の SCRAPELESS_API_KEY 環境変数は .env より優先されます。ファイルは秘密に保ち、スクリーンショットや共有アーカイブには含めないでください。
config.json をプレーンテキストエディタで開き、次のウォッチリストを保持するか、置き換えてください:
json
{
  "keywords": ["scrapeless", "web scraping api", "google search api"],
  "target_domains": ["scrapeless.com"],
  "gl": "us",
  "hl": "en",
  "google_domain": "google.com",
  "location": "Austin, Texas, United States"
}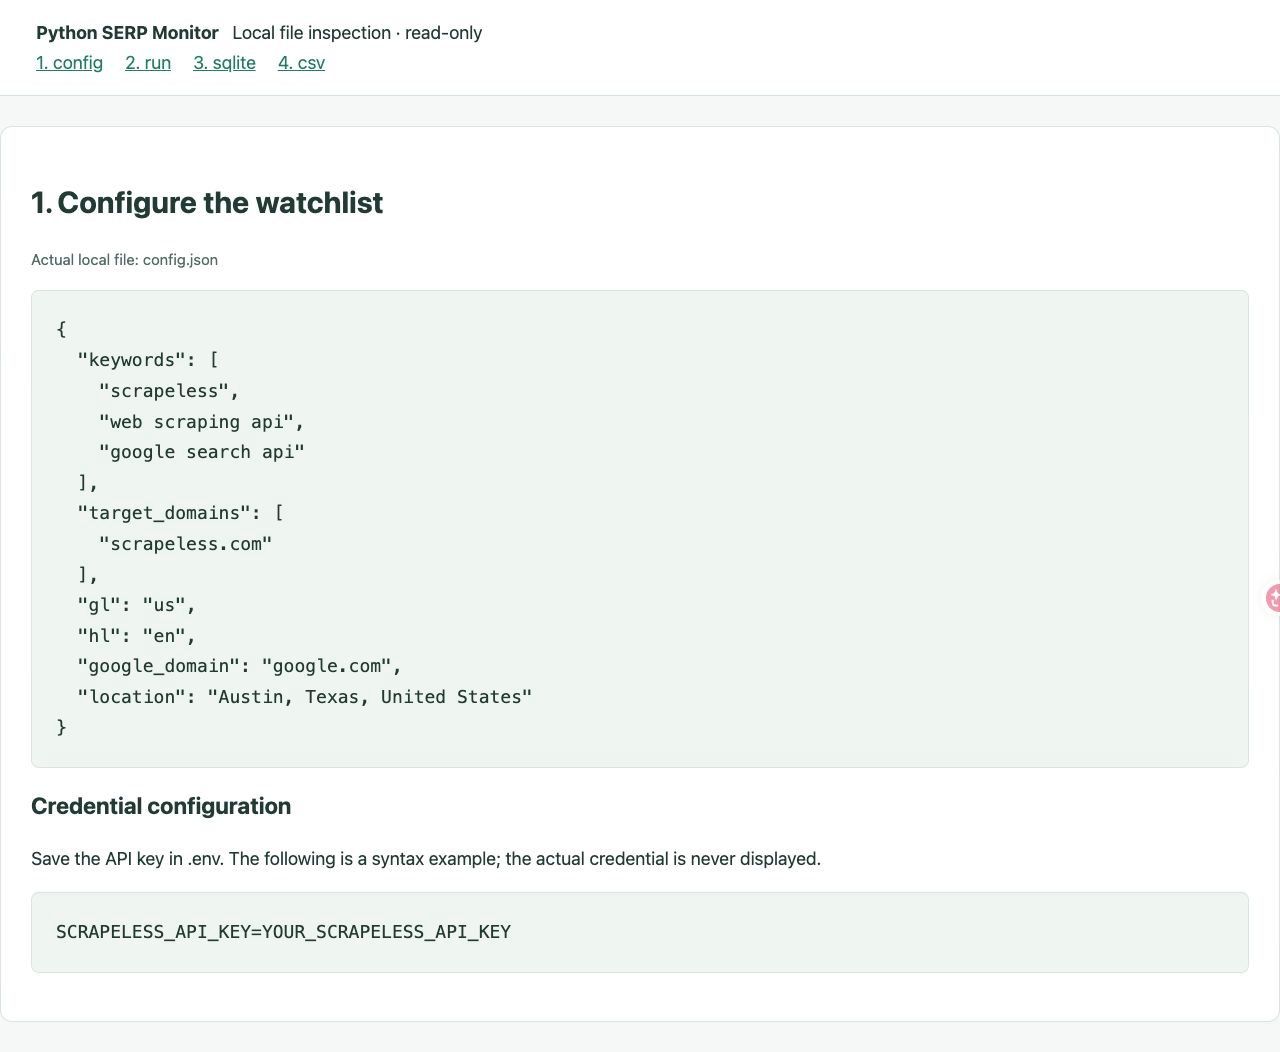
ケース設定。認証情報エリアには実際のキーではなくプレースホルダーが表示されています。
target_domains はレスポンス内で検出したいホストを指定するものであり、Google がそれらのホストに限定して返すことを意味しません。gl、hl、google_domain、location は検索の国、言語、ドメイン、ロケーションを設定します。このプロジェクトではデバイスは desktop、ページネーションの開始位置は 0 に固定されています。
後で比較できるように、これらの入力値は一貫して保ってください。ロケーションや言語が異なると、別の検索スコープとなります。
ステップ 3 — 最初の観測を収集する
collect コマンドは、設定された検索をリクエストし、観測データを保存し、レポートを書き出します。
注意: このコマンドには Scrapeless の API キーとクレジットが必要です。実際の検索が送信されます。後に示す出力は元のケースから保持しているものであり、新規実行時に同じレスポンスが得られることは保証されません。
bash
python3 serp_monitor.py collect --config config.json --env-file .env保持された実行では、次の出力が得られました:
text
Run: 60c13c8bd553
scrapeless: 9 organic results saved
web scraping api: 7 organic results saved
google search api: 9 organic results saved
CSV: output/60c13c8bd553-v1.csv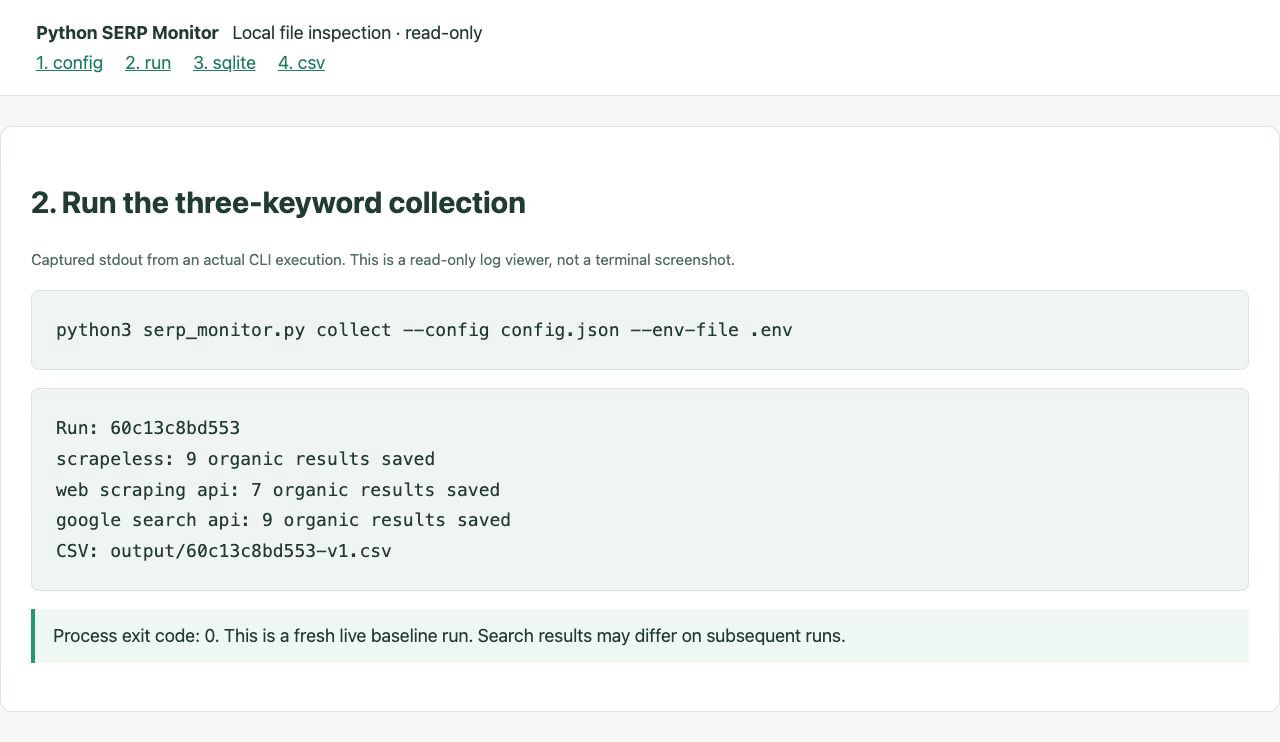
ターミナルのスクリーンショットではなく、読み取り専用のログビューです。元のコマンドは終了コード 0 で完了しました。
この実行では、data/rankings.sqlite に観測データが保存され、上に示した CSV のパスが書き出されました。ここでのカウントは保存されたオーガニック検索結果数を示すものであり、ターゲットドメインの順位を表すものではありません。
ステップ 4 — 結果を検証してターゲットホスト名を照合する
コレクターは、ドメイン一致または不一致を成功した観測と見なす前に、返されたオーガニック配列を検証します。
リクエストとタスク状態を理解する
最初のキーワードに対して、プロジェクトは次のリクエストボディを構築します。これは実行する 2 つ目のコマンドではなく、リクエストの例です:
json
{
  "actor": "scraper.google.search",
  "input": {
    "q": "scrapeless",
    "gl": "us",
    "hl": "en",
    "google_domain": "google.com",
    "location": "Austin, Texas, United States",
    "start": 0,
    "device": "desktop"
  }
}
プロジェクトはこのボディを POST https://api.scrapeless.com/api/v1/scraper/request に送信し、キーを x-api-token に含めます。Google Search API リクエストライフサイクルでは、HTTP 200 の結果と、taskId を含む HTTP 201 レスポンスを区別しています。
コレクターは既存タスクをポーリングする前に、返されたタスク ID を保存します。送信されたタスクと完了した観測結果は異なる状態です。送信結果が不確実でタスク ID が保存されていない場合、アプリケーションは別の検索を黙って作成するのではなく、その不確実性をそのまま可視のままにしておきます。
HTTP レスポンスコードだけでは、アプリケーションが有用なランキングデータを受信したことは証明できません。HTTP セマンティクス仕様はプロトコルのステータスを定義するものであり、コレクターはレスポンスボディを検証する必要があります。
オーガニック結果配列の確認
モニターは position、link、title を organic_results から読み出します。配列インデックスに置き換えず、返された position をそのまま保持します。
ポジションは互いに異なる正の整数でなければならず、リンクは有効な HTTP(S) 宛先アドレスへ到達できなければなりません。空のオーガニック配列には empty_unverified が付与され、順位比較からは除外されます。その状態にしておくことで、未確認の空レスポンスが、ターゲットが消失したものとして解釈されるのを防ぎます。
一部の Google 結果は /url や /goto のラッパーリンクを使用します。コレクターは可能な場合には明示的な宛先を抽出します。サポートされた不透明なラッパーについては、Scrapeless キーを使わずに、制限された Google スコープ内でリダイレクト情報を独立したリクエストによって確認します。最終的なターゲットサイトには訪問しません。解決できないリンクは、完全な観測結果から黙って除外されるのではなく、エラーとして残ります。
Scrapeless でスクレイピングを始めよう
Scrapeless で Web スクレイピングと自動化ワークフローを強化しましょう。
本日サインアップすると 5 ドル分の無料クレジット を獲得できます — クレジットカード不要 です。Scrapeless ダッシュボード で、今すぐ無料クレジットを請求してください。
URL の部分文字列ではなくホスト名を照合する
ターゲットドメインは、解析されたホスト名か、そのサブドメインのいずれかと一致しなければなりません。部分文字列マッチングでは、example.com に対して example.com.other.org が誤って受け入れられてしまいます。この区別は、URI 構文仕様で定義されている、権限(authority)とパスの別個のコンポーネントに従うものです。
次の内容を serp_monitor.py と同じ場所に match_example.py として保存します。これは説明用の手書き入力を使用し、API リクエストは一切行いません。
python
from urllib.parse import urlsplit
from serp_monitor import normalized_domain


def best_match(organic, domain):
    domain = normalized_domain(domain)
    for item in sorted(organic, key=lambda row: row["position"]):
        host = normalized_domain(urlsplit(item["link"]).hostname or "")
        if host == domain or host.endswith("." + domain):
            return item
    return None


organic = [
    {"position": 1, "link": "https://example.com.other.org/page"},
    {"position": 3, "link": "https://www.example.com/page"},
]
match = best_match(organic, "example.com")
print(match["position"] if match else None)
ローカルの例を実行します:
bash
python3 match_example.py3 が出力されます。最初のホストは other.org に属し、2 つ目はターゲットドメインに属します。複数の結果が一致する場合は、最も小さい返却ポジションが優先されます。
一致がない場合、順位は空白のままです。空白は、そのドメインがこの返却セット内で見つからなかったことを意味し、ポジション 0 や、Google 全体の結果からの不在の証明を意味するものではありません。
ステップ 5 — SQLite の履歴を確認する
SQLite には、後で比較するために必要なリクエストコンテキストと保存済み観測結果が保持されます。これには、フラットな CSV では完全には表現できない状態も含まれます。
| Table | Stored information | Purpose |
|---|---|---|
runs |
実行 ID、モード、設定、完了状態 | コレクションをグループ化する |
snapshots |
キーワード、入力、ステータス、タスク詳細、結果データ、リクエストタイミング | 観測結果とタスク状態を保持する |
report_versions |
保存された比較行と選択されたベースライン情報 | レポートのバージョン再現性を保つ |
この完全なスクリプトをプロジェクトディレクトリ内に inspect_history.py として保存します。これはデータベースを読み取り専用で開き、最新のライブ実行における各スナップショットのオーガニック件数を出力します。
注意: このスクリプトには、収集済みの既存データベースが必要です。検索の送信や、存在しないデータベースの作成は行いません。
python
import json
import sqlite3
from pathlib import Path

uri = Path("data/rankings.sqlite").resolve().as_uri() + "?mode=ro"
with sqlite3.connect(uri, uri=True) as db:
    rows = db.execute("""
        SELECT keyword, status, organic_json
        FROM snapshots
        WHERE run_id = (
            SELECT id FROM runs
            WHERE mode = 'live'
            ORDER BY started_at DESC LIMIT 1
        )
        ORDER BY id
    """)
    for keyword, status, organic_json in rows:
        count = len(json.loads(organic_json or "[]"))
        print(keyword, status, count)
収集後に python3 inspect_history.py を実行します。保持されたデータベースクエリは次の結果を返しました:
text
scrapeless success 9
web scraping api success 7
google search api success 9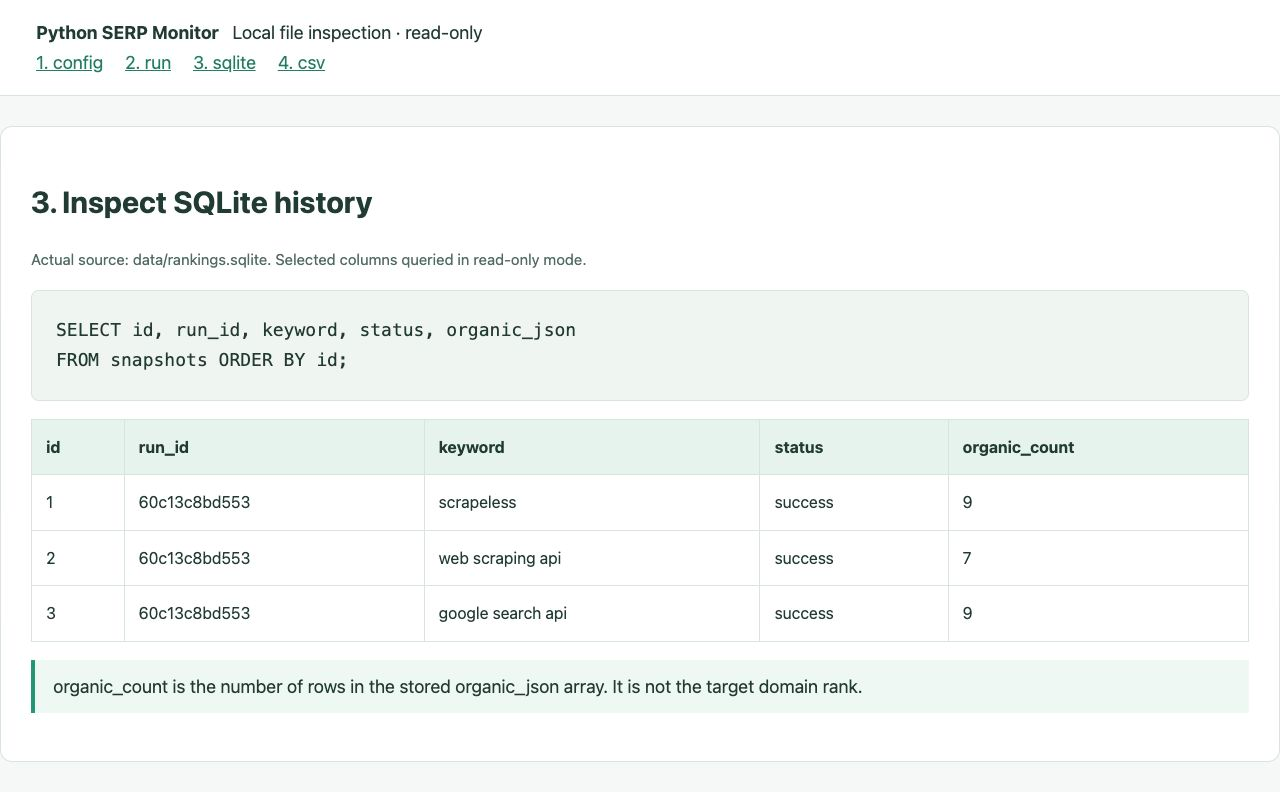
保持されたデータベースから選択したフィールド。表示されているオーガニック件数は、保存されている配列から計算されています。
success はコレクションを表します。これはレポートの baseline や baseline_absent ステータスとは異なります。後続の観測のために、同じデータベースを保持してください。CSV だけではタスク履歴を復元できません。
ステップ 6 — CSV を読み取り再エクスポートする
CSV には、ターゲットとのマッチ、結果カバレッジ、比較状態が、キーワードとターゲットのそれぞれの行にまとめられています。
実行ごとの CSV をスプレッドシートアプリケーションで開きます。保存された実行を一覧表示することもできます:
注意: ローカル履歴およびエクスポートコマンドには、収集時から保持されているデータベースが必要です。これらは API コールを一切行いません。
bash
python3 serp_monitor.py history --db data/rankings.sqlite
python3 serp_monitor.py export --output output/saved-report.csv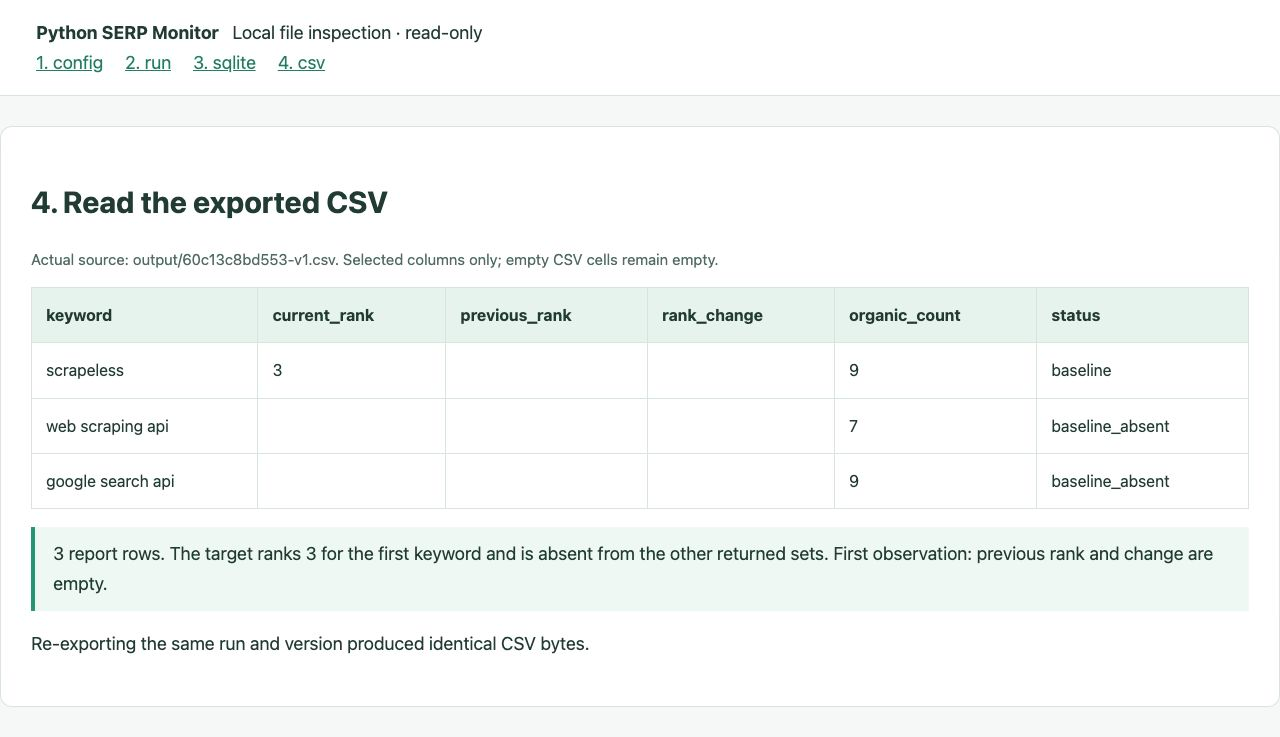
スプレッドシートアプリケーションのスクリーンショットではなく、読み取り専用ビューアに表示された CSV の選択列。欠損している順位は空白のままです。
保持された最初のベースラインには、次の結果が含まれています。
| キーワード | 現在の順位 | オーガニック結果数 | レポートステータス |
|---|---|---|---|
scrapeless |
3 | 9 | baseline |
web scraping api |
— | 7 | baseline_absent |
google search api |
— | 9 | baseline_absent |
ダッシュは空の CSV セルを表します。3 つの観測はいずれも成功しましたが、ターゲットに一致したのは最初のキーワードだけでした。以前に比較可能な観測がなかったため、previous_rank と rank_change は空白でした。
レポートには、スナップショット、ベースライン、検索設定、リクエストタイミングを追跡するためのフィールドも保持されます。CSV エクスポートは BOM 付き UTF-8 を使用し、数式のように見えるテキストセルをエスケープします。この区別は、外部から提供されたテキストをスプレッドシートにインポートする際に重要になります。詳細は OWASP の CSV インジェクションガイダンス に記載されています。
ベースラインを書き換えずに後続の収集結果を比較する
後続のレポートは、保存された観測に検索範囲の一致と信頼できる並び順がある場合にのみ、順位の変動を計算します。
次の観測時には、同じプロジェクトディレクトリに戻り、.env、config.json、data/rankings.sqlite を維持します。ステップ 3 の collect コマンドをもう一度実行します。これは新しい有料収集を開始するものであり、既存レポートを読み出すだけの目的には必要ありません。
観測結果が比較可能かどうかを確かめる
以前の結果は、現在のリクエストが送信されるより遅くともその時点までに受信されていなければなりません。リクエスト間隔が重なっている場合や、古い記録に信頼できるタイミングが欠けている場合には、クエリ設定が一致しているだけでは不十分です。
そのような場合、レポートは現在の順位を保持しますが、比較には not_comparable とマークします。これらはクライアント側の送信時刻と受信時刻であり、プロジェクトはプロバイダの正確な収集時刻を把握しているとは主張しません。
比較可能な両方の観測に一致が含まれている場合、計算は rank_change = previous_rank - current_rank です。例として、順位 5 から順位 3 への移動は +2 を生み、これは 2 ポジションの改善を意味します。この算術例は、このケースで 2 回目の実観測があったことを示すものではありません。
欠如と収集品質を切り分ける
| レポート状態 | 意味 |
|---|---|
baseline / baseline_absent |
ターゲット一致の有無にかかわらず、比較に利用できる最初のベースライン |
up / down / unchanged |
比較可能な両観測で一致があり、順位が上昇・下降・横ばい |
new / lost / still_absent |
一致が現在のみ、以前のみ、または両方の返却セットに存在しない |
pending / error |
利用可能な完了済みの現在観測がない |
empty_unverified |
オーガニック配列が空であり、ランキングベースラインから除外される |
not_comparable |
現在の結果は有効だが、順位変化の計算を支える並び順がない |
lost は返却されたセット内に限定されます。観測間で結果件数は変化し得るため、結論を出す前にカバレッジを順位と合わせて確認してください。
保存されたレポートバージョンをエクスポートする
アプリケーションは、バージョンを生成したときのレポート行と、そのとき選択されたベースラインを保存します。後続の観測によって、そのバージョンですでに保存された行が変更されることはありません。
注:
YOUR_RUN_IDを既存の実行 ID に置き換えてください。このコマンドはローカルデータベース内の保存済みバージョンを必要とし、API コールは行いません。
bash
python3 serp_monitor.py export --run-id YOUR_RUN_ID --version 1 --output output/saved-v1.csv保持されたケースのバージョン 1 を再エクスポートしたところ、CSV バイト列は同一でした。エクスポートは宛先を置き換える前に一時ファイルへ書き込みます。明示的に指定した出力パスは上書きされる可能性がありますが、保存されたデータベース上のバージョンは引き続き利用可能です。
ローカルワークフローのトラブルシューティング
ほとんどのセットアップの問題は、カレントディレクトリ、アクティブな認証情報、または選択されたデータベースに起因します。
| 症状 | 確認事項 |
|---|---|
| スクリプトが見つからない | 展開済みプロジェクトディレクトリからコマンドを実行する |
| キーがない、または無効 | プレースホルダを置き換え、環境変数の優先順位を確認する |
| アカウントのアクセス権または残高不足 | ダッシュボードで選択サービスと利用可能クレジットを確認する |
| 現在の順位が空 | ターゲットのホスト名と返却されたオーガニックカバレッジを確認する |
| 想定外の新しいベースライン | 検索設定とデータベースパスが意図した履歴に一致しているか確認する |
empty_unverified |
順位変化を解釈する前にレスポンス品質を確認する |
not_comparable |
記録されたリクエスト間隔と履歴タイミングの有無を確認する |
キーのファイルと生のデータベースは秘密にしておいてください。レポートやスクリーンショットを共有する前に、認証情報やプライベートなターゲット、URL を削除してください。
結論: 変化を解釈する前に観測結果を保全する
この Python 製 SERP モニタは、収集、ホスト名マッチング、SQLite 履歴、CSV レポートを 1 つの小さなワークフローに結び付けます。この保持された例は 3 つのクエリに対するベースラインを確立するものであり、より長期的な結論には、設定とタイミングが比較可能な実観測を追加で重ねる必要があります。
データベースを保持し、ランキング状態の前にコレクション状態を読み取り、比較を再現可能なままにする必要がある場合は保存済みレポートバージョンを使用してください。これらの選択により、次のコレクションが解釈可能になります。
検索モニタリングパイプラインを構築する準備はできましたか?
Discord または Telegram で、検索ワークフローを構築している開発者コミュニティに参加してください。
app.scrapeless.com に登録し、小さなウォッチリストから始めて、各観測ごとに検索コンテキストを保持しましょう。
FAQ
Q: このモニターはどのようなデータを収集すべきですか?
公開されたオーガニック検索結果および、分析する権限が付与されているターゲットに対してモニターを使用してください。データを収集または共有する前に、ご自身のユースケースに関連するサービス利用規約および要件を確認してください。
Q: モニターはすべての Google 検索結果ページを追跡しますか?
いいえ。この実装では start: 0 を使って、最初に返されるデスクトップ向けオーガニックページを要求します。ターゲットが見つからない場合は、その返却セット内に一致がなかったことを意味します。
Q: プロキシや AI エージェントは必要ですか?
このアプリケーションでは、別個のプロキシクライアントや AI エージェントは必要ありません。Python がアカウントキーと設定済み検索入力を用いて Scrapeless Google Search API を呼び出します。
Q: Google がページマークアップを変更したらどうなりますか?
このモニターは Google の DOM 要素を選択する代わりに構造化された API 結果を消費します。レスポンススキーマは引き続き検証され、順位をでっち上げるのではなく、利用不能なデータとして記録します。
Q: アクセスエラーや利用不能なレスポンスはどのように処理されますか?
コレクションの問題はターゲットの不在とは切り離して管理されます。レポートを解釈する前に、認証情報、プロダクトアクセス、残高、および記録されたレスポンス状態を確認してください。
Q: 複数のコレクターが同じデータベースに書き込むことはできますか?
このアプリケーションは共有データベースロックを使用して、同一ローカルデータベースに対するコレクションの重複実行を防ぎます。収集は逐次的に行い、一貫したデータベースパスを使用してください。
Q: 成功した結果が not_comparable とマークされるのはなぜですか?
現在の結果自体は有効であっても、リクエストの順序が不確実な場合があります。インターバルの重複や履歴の提出時刻の欠如により、防御可能な変動(順位変化)の計算ができなくなります。
Q: エクスポートは API クレジットを消費しますか?
いいえ。export は保存済みレポートバージョンを読み取り、history はローカルの実行記録を読み取ります。collect が検索リクエストを行います。
Q: 空白の順位は、そのウェブサイトが Google から削除されたことを意味しますか?
いいえ。空白の順位は、返却されたオーガニックセット内にターゲットの一致がなかったことを示します。これはインデックスステータス全体の評価ではありません。
Scrapelessでは、適用される法律、規制、およびWebサイトのプライバシーポリシーを厳密に遵守しながら、公開されているデータのみにアクセスします。 このブログのコンテンツは、デモンストレーションのみを目的としており、違法または侵害の活動は含まれません。 このブログまたはサードパーティのリンクからの情報の使用に対するすべての責任を保証せず、放棄します。 スクレイピング活動に従事する前に、法律顧問に相談し、ターゲットウェブサイトの利用規約を確認するか、必要な許可を取得してください。





