
Shopify向け価格監視ツール構築者のための:信頼性の高いデータパイプライン設計
Senior Web Scraping Engineer
要約:
- Shopify アプリの価格モニタリングにはバリアント単位の履歴が必要です。 すべての価格に対して、正確なオプション、通貨、ソース URL、観測時刻を保存します。
- 欠落した観測値を価格変更として扱ってはいけません。 収集の失敗と、商品が実際に販売不可になったことは分けて管理します。
- 商品マッチングには、それ専用の根拠が必要です。 ストア固有の SKU だけでは、2 つのマーチャントが同じ商品を販売しているとは言えません。
- E コマース価格トラッキング向けのブラウザ自動化は収集レイヤーの仕事です。 正規化、テナント分離、アラートルールは依然としてあなたのアプリケーションの責任です。
- 無料でスタートできます。 新しい Scrapeless アカウントには Scraping Browser ランタイムが無料で含まれます — app.scrapeless.com から登録してください。
はじめに:価格とは「オファーを観測した結果」
Shopify の商品は、バリアントごとに異なる価格を持ち得ます。商品タイトルと、画面上で最も安く見える価格だけを記録する価格モニタリングアプリは、実際には買い物客が別サイズを選んだだけなのに値下げとして報告してしまうことがあります。
有用な単位は、特定のストアフロント文脈で観測されたオファーです。パイプラインは、その文脈をアラートに至るまで保持しなければなりません。さもないと、通貨の変更、利用不可になったバリアント、不完全な抽出が、商業的なイベントに見えてしまいます。
この記事では、Shopify 向けツールビルダーのための競合価格モニタリング用データパイプラインを設計します。例として示すインジェストステップでは、収集した公開商品のバリアント観測値を SQLite に保存します。その周辺アーキテクチャでは、これらの観測値をどのようにテナント固有のシグナルに変換するかを説明します。より広範なマルチリテーラー収集パターンについては、競合価格パイプラインを参照してください。
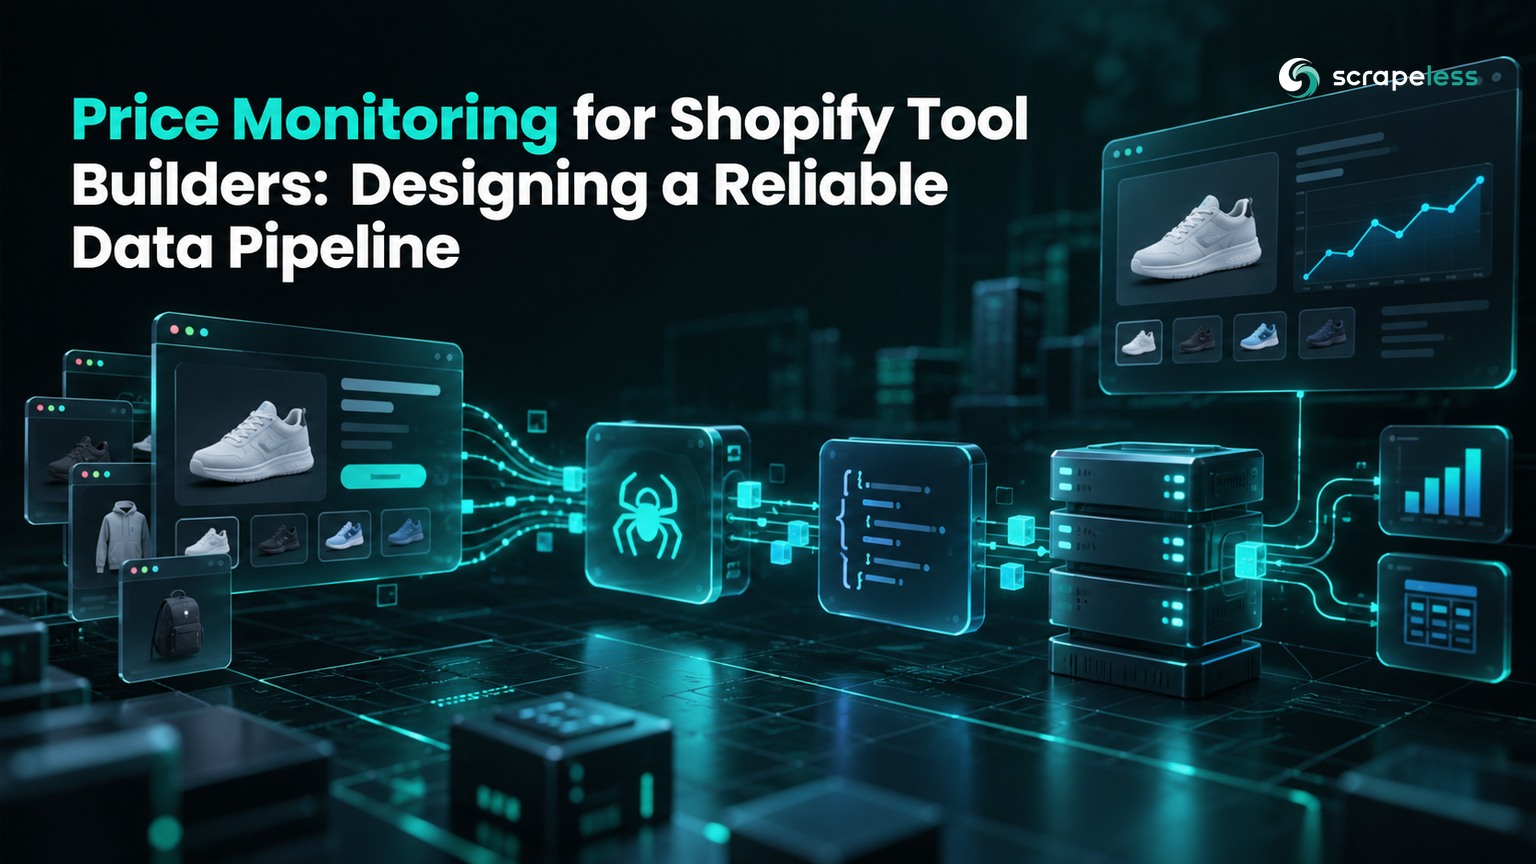
パイプラインの概要
信頼できる価格モニタリングパイプラインは、ソースからの収集と商業的な解釈を分離します。
| Stage | Input | Output | Reject or hold when |
|---|---|---|---|
| Scope | Tenant's approved watchlist | Store, product, variant, market | Source or access permission is unclear |
| Collect | Public product URL and context | Raw response and capture time | Product identity cannot be confirmed |
| Normalize | Product and variant fields | Typed observations | Currency or price units are unresolved |
| Match | Observation and merchant catalog | Evidence-backed product association | Option or pack size differs |
| Store | Validated observations | Immutable history and latest view | Observation key already exists |
| Decide | Comparable current and prior offers | Price-change event | Prior observation is stale or missing |
| Deliver | Event and subscription rules | App notification or dashboard update | Tenant is not subscribed to the watch |
ソースのステータスとパイプラインのステータスは別々のフィールドとして扱ってください。コレクターがページの読み取りに失敗しても、その商品がまだ販売されているかどうかについては何も分かりません。一方、利用不可バリアントを報告する完全なレスポンスからは、特定の事実が分かります。
ステージ 1 — 収集前にウォッチ契約を定義する
ウォッチ契約は、テナントがアプリにモニタリングを期待するオファーを特定します。
ストアフロントのホスト、商品 URL、選択されたオプションの組み合わせ、想定マーケット、想定通貨、許容できるデータの鮮度を含めてください。自社カタログの識別子は競合先の識別子と並行して保持し、一方を他方で置き換えないでください。
マーチャントのストアに接続されたアプリは、公開の競合モニタリングとは異なる権限境界を持ちます。マーチャント自身の商品に対しては、認可されたカタログアクセスが適切です。公開の競合収集は公開ストアフロント上の表層にとどめ、ストアの規約とアクセス制御を尊重するべきです。
テナントの購読とは別にソースレジストリを管理してください。複数のテナントが同じ公開オファーをフォローすることはあり得ますが、各サブスクリプション、しきい値、配信先は依然としてそのテナントに属します。契約およびプライバシー上許される範囲でのみ、収集結果を共有してください。
ステージ 2 — 公開バリアントデータと通貨を同時に収集する
コレクターは、ソース側のバリアントフィールドを保持し、同じストアフロント文脈で報告される通貨を特定しなければなりません。
Shopify の ロケール対応 product レスポンス は、商品とバリアントの情報を公開します。アクセス可能なエンドポイントは有用な抽出ソースですが、それはすべてのストアフロントが完全なカタログやすべてのオファーを公開していることの保証ではありません。
以下の例では、ブラウザワーカーによる Taylor Stitch の公開オブザベーションを取り込みます。ワーカーは公開プロダクト URL を発見し、ブラウザコンテキストでバリアントデータと読み取り専用カートレスポンスを読み取り、JSON エンベロープを出力します。取得されたエンベロープには 6 つのバリアントが含まれ、通貨として USD が特定されました。インジェスト手順では、通貨換算を推測するのではなく、整数の価格フィールドを price_raw のまま保持します。これは将来の品揃えに関する約束ではなく、あくまでサンプルのオブザベーションです。
Prerequisites and Run Instructions
標準ライブラリの SQLite をサポートした Python と、書き込み可能なディレクトリを使用します。許可されたブラウザコレクターは、まず observation.json を product_id、source_url、currency、observed_at、そして variant_id、options、price_raw、compare_at_price_raw、available を含む variants 配列とともに保存する必要があります。ソース SKU は任意です。次の内容を ingest_prices.py として保存し、そのキャプチャの隣で python3 ingest_prices.py を実行します。サードパーティ製の Python パッケージは不要です。入力キャプチャが存在しない場合は、空の商品カタログではなく前提条件の不備となります。
python
import json
import sqlite3
from urllib.parse import urlsplit

with open("observation.json", encoding="utf-8") as capture:
    observation = json.load(capture)
required = ("product_id", "source_url", "currency", "observed_at")
if any(not observation.get(field) for field in required):
    raise ValueError("Incomplete product identity, source, currency, or time")
variants = observation.get("variants")
if not isinstance(variants, list) or not variants:
    raise ValueError("No validated variant observations")
source_url = observation["source_url"]
source = urlsplit(source_url)
if source.scheme != "https" or not source.netloc:
    raise ValueError("Expected an HTTPS storefront source")
store = "https://" + source.netloc
rows = []
for variant in variants:
    if not variant.get("variant_id") or type(variant.get("price_raw")) is not int:
        raise ValueError("Variant identity or integer raw price is missing")
    if type(variant.get("available")) is not bool:
        raise ValueError("Variant availability must be observed")
    rows.append((store, str(observation["product_id"]), str(variant["variant_id"]),
                 observation["currency"], observation["observed_at"],
                 variant["price_raw"], variant.get("compare_at_price_raw"),
                 variant["available"], json.dumps(variant.get("options", [])),
                 source_url))

with sqlite3.connect("prices.sqlite") as db:
    db.execute("""CREATE TABLE IF NOT EXISTS observations (
        store TEXT, product_id TEXT, variant_id TEXT, currency TEXT,
        observed_at TEXT, price_raw INTEGER, compare_at_price_raw INTEGER,
        available INTEGER, options_json TEXT, source_url TEXT,
        PRIMARY KEY (store, variant_id, currency, observed_at)
    )""")
    db.executemany("INSERT OR IGNORE INTO observations VALUES (?,?,?,?,?,?,?,?,?,?)", rows)
    saved = db.execute("SELECT COUNT(*) FROM observations WHERE observed_at = ?",
                       (observation["observed_at"],)).fetchone()[0]
print(json.dumps({"product_id": str(observation["product_id"]),
                  "currency": observation["currency"],
                  "variants_saved": saved, "database": "prices.sqlite"}))
このインジェスト手順は、エンベロープが不完全な場合に処理を停止します。本番環境のワーカーは、最後に有効だったオファーを上書きせずにギャップを説明できるよう、コレクションステータスを価格テーブルの外側に記録する必要があります。コレクションワーカーは、自身のストアフロントに対して検証済みのロケール対応プロダクトパスおよびカートパスを使用しなければなりません。インジェストは、受け取ったコンテキストをそのまま保持します。
Stage 3 — 比較可能性をでっち上げずにオファーを正規化する
正規化は、表現を変えつつ意味を保持します。
ソース固有のマネーアダプターを使用します。元の金額、通貨コード、および文書化された単位の取り決めを保持し、その取り決めを確認した後にのみ表示用金額を導出します。派生した金額の計算には 10 進数演算を用います。関連性のないフィード形式に対して一律の除数を適用しないでください。
現在価格、比較価格(compare-at price)、条件付き割引を分離します。会員価格やサブスクリプションオファーは、匿名の都度購入価格と自動的に同一視されるものではありません。Offer 語彙は、価格・通貨・在庫状況を関連するプロパティとしてモデル化しており、自身のコントラクトを設計するうえで有用な境界を提供します。
available は、観測されたブール値か不明として記録します。公開されている在庫状況は在庫数そのものではありません。SKU が欠落している場合は null のままにし、架空のカタログ識別子で置き換えるべきではありません。
Start Scraping with Scrapeless
Scrapeless で Web スクレイピングと自動化ワークフローを強化しましょう。
今すぐサインアップして $5 分の無料クレジット を獲得 — クレジットカード不要 です。Scrapeless Dashboard から今すぐ無料クレジットを受け取りましょう。
Stage 4 — 照合根拠と改ざん不能な履歴を維持する
価格履歴は、プロダクトの紐付けが説明可能な場合にのみ有用です。
存在する場合は厳密な識別子で照合し、そのうえでブランド、オプション値、入り数、コンディションを確認します。あいまいなマッチはレビュー待ちとしてください。マッチング手法と承認状態を保存しておくことで、後日のカタログ修正と実際の価格変動とを区別できるようにします。
オブザベーションは追記専用(append-only)で保持し、最新オファーのビューは別に構築します。抽出ロジックが変わる場合は、そのバージョンをオブザベーションとともに保持します。データ来歴モデルは、結果を、それを生成したアクティビティおよびソースと関連付けるための一般的な枠組みを提供します。
オブザベーションの一意キーには、ソース、バリアント、市場コンテキスト、論理的なキャプチャ識別子を含めるべきです。簡潔な SQLite の例では観測時刻を用いています。スケジュールされたサービスは、同一ジョブの重複配送によって別のオブザベーションが作られないよう、ジョブ作成時に安定したキャプチャ識別子を割り当てる必要があります。
Stage 5 — 比較可能なオブザベーションからのみアラートを発行する
アラートは、同一のアイデンティティと市場コンテキストのもとで有効なオファー同士を比較すべきです。
両方のオブザベーションが必須フィールドチェックを通過したときにのみ差分を計算します。バリアントが在庫切れの場合は、明示的な在庫イベントルールを適用します。コレクターがブロックされている場合は、コレクションヘルスイベントを公開し、商業的なシグナルは未決のままにします。
有効なオブザベーション数を、スケジュールされた対象ウォッチ数で割った値と、利用時点でのオブザベーションの経過時間を計測します。有効なオブザベーションあたりのコストも、コレクションコストと並行して測定します。これらは設計メトリクスであり、汎用的な更新間隔を借用するのではなく、顧客の意思決定ウィンドウからしきい値を設定してください。
HTTP の成功ステータスコードは、利用可能な商品レコードを保証するものではありません。HTTP レスポンスセマンティクスはリクエストの結果を記述するだけであり、バリデーターは依然としてアイデンティティ、通貨、ソースコンテンツを検証しなければなりません。
クラウドブラウザが価格モニタリングサービスにおいて果たす役割
クラウドブラウザは、JavaScript やインタラクションを必要とするストアフロントの状態を収集するのに役立ちます。
ウォッチがレンダリングされたオプション選択や一貫したブラウザセッションを必要とする場合は、Scrapeless Agent Browser を使用してください。クラウドブラウザは、あなたのプロダクトマッチングポリシー、テナント権限、または価格決定を提供しません。Scrapeless の料金 を用いて、その実行コストを収集予算と比較してください。
収集は直列で開始し、ストアが明示した制限とあなたのアカウント容量の範囲内でのみ拡張してください。スケジューリングの前にアクセス方針を確認しましょう。robots exclusion protocol はクローラーの優先設定を記述したものであり、アクセス許可の代替にはなりません。
結論:すべての価格変更を説明可能にする
Shopify アプリの信頼できる価格モニタリングは、ウォッチ契約から始まり、証拠に裏付けられたイベントで終わります。正確なバリアントを収集し、金額の意味論を保持し、不変の観測値を保存し、互換性のあるオファーのみを比較してください。収集の健全性を可視化し、利用不可能な読み取り値が密かに価格推奨になってしまわないようにしましょう。
Shopify 価格モニタリングパイプラインを構築する準備はできましたか?
コミュニティに参加して無料プランを取得し、EC データサービスを構築する開発者とつながりましょう:Discord · Telegram。
app.scrapeless.com に登録し、承認済みストアフロントウォッチリストに合わせて収集レイヤーを調整してください。
よくある質問(FAQ)
Q: 公開されている Shopify ストアの価格モニタリングは合法ですか?
法的な位置付けは、法域、アクセス方法、ストア規約、および意図された用途によって異なります。これらの条件を確認し、あなたが運営するサービスについて法的助言を受けてください。公開されているという事実だけでは、すべての疑問が解決されるわけではありません。
Q: Shopify の価格モニタリングアプリはどのくらいの頻度でデータを収集すべきですか?
意思決定に対して許容される観測の最大経過時間と、情報源のアクセス制限からケイデンスを設定してください。プロモーションのアラートは、品揃えレポートとは異なる時間幅を必要とする場合があります。いずれの場合も、実際の取得時刻を表示してください。
Q: すべての価格モニタリングジョブにプロキシは必要ですか?
公開アクセス可能なレスポンスであれば、チェック済みのブラウザ収集がそうであったように、プロキシなしで動作する場合があります。市場に依存するブラウザワークフローでは、文書化された proxyCountry パラメータを設定し、得られた通貨を独立して検証してください。
Q: アクセスチャレンジやマークアップの変更にアプリはどう対応すべきですか?
価格ではなく、未確認の収集結果として記録してください。認可されたブラウザワークフローの場合は、同じセッションで最初にホームページを読み込み、実際の商品のマーカーを待ちます。ストアフロントのマークアップが変化した場合には、抽出器を再確認してください。
Q: パイプラインは AI エージェントなしで動かせますか?
はい。Python の取り込みステップは直接実行でき、スケジューラが残りのアプリケーションステージを調整できます。AI エージェントは情報源の調査を支援できますが、保存される価格とアラートは決定論的な検証で制御すべきです。
Q: 最初の実装ではどのような並行性と URL ポリシーを使うべきですか?
まずはストアフロントごとに 1 ワーカーから始め、観測された正規の商品 URL を使用してください。並列化が許可されている場合、当初の上限はホストごとに 3 ワーカー、もしくはストア側でより厳しい制限があるならその制限までに抑え、その後で収集の健全性を評価してから増やしてください。
Scrapelessでは、適用される法律、規制、およびWebサイトのプライバシーポリシーを厳密に遵守しながら、公開されているデータのみにアクセスします。 このブログのコンテンツは、デモンストレーションのみを目的としており、違法または侵害の活動は含まれません。 このブログまたはサードパーティのリンクからの情報の使用に対するすべての責任を保証せず、放棄します。 スクレイピング活動に従事する前に、法律顧問に相談し、ターゲットウェブサイトの利用規約を確認するか、必要な許可を取得してください。





