
LangChain + Scrapeless: 出典付きリサーチアシスタントを構築する
Expert in Web Scraping Technologies
TL;DR:
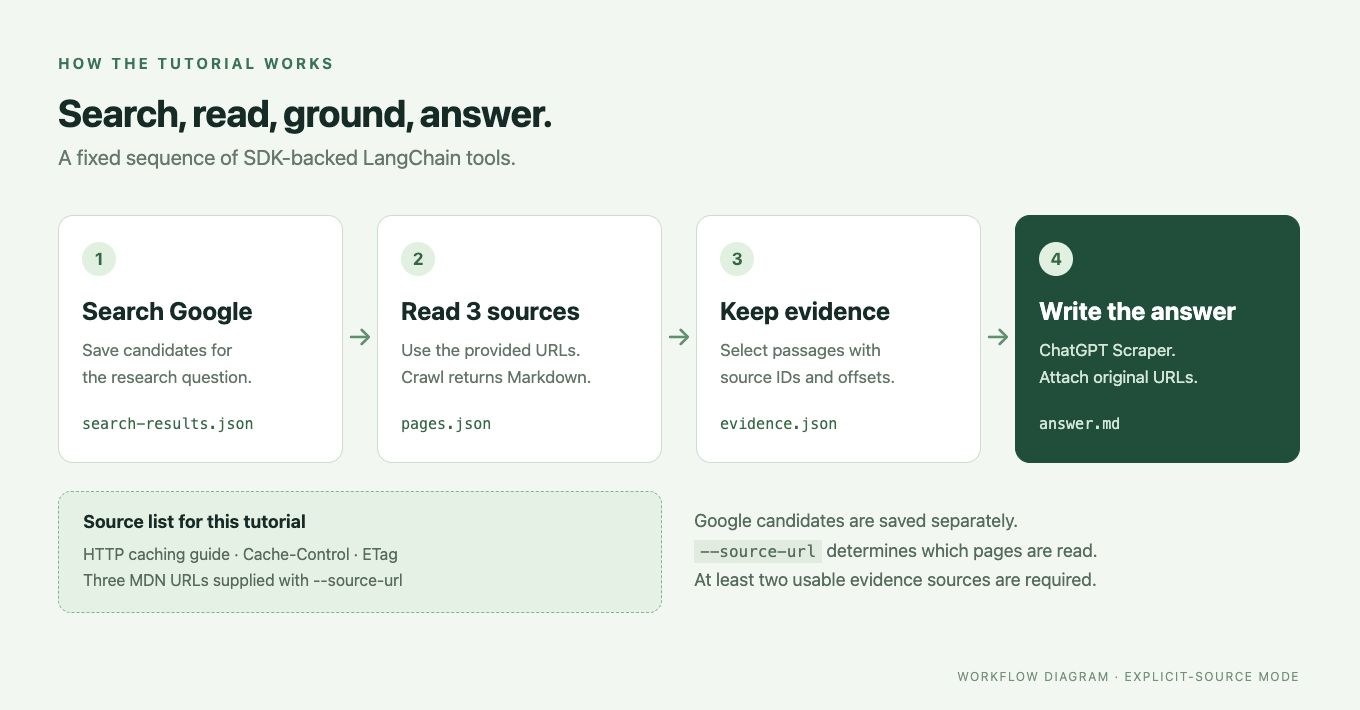
- LangChain と Scrapeless を使うと、ドキュメントページから出典付きの回答を生成できる。 この例では Google 検索を行い、ページ本文を読み、抜粋を選び、ソース ID 付きの解説を生成する。
- ワークフローは、収集した証拠を最終回答のそばに保持する。 検索候補、ページの Markdown、抜粋のオフセットは検査のために残される。
- 明示的なソース URL によって、どのページを読むかを制御する。 Google 検索自体は実行されるが、その候補は与えられたドキュメントセットとは別に保持される。
- 引用チェックは ID と構造を検証するものであり、技術的な主張ひとつひとつを検証するものではない。 重要な文は、保存された抜粋と元ページを突き合わせて確認する。
What You Will Build
この LangChain Scrapeless 連携では、「HTTP キャッシュにおいて Cache-Control と ETag はどのように連携して機能するか?」という問いに答える Python 製のリサーチアシスタントを構築する。
有用な解説には、ドキュメントページ内部の詳細と、それらを検査する手段が必要になる。検索スニペットはページを特定するのには役立つが、キャッシュ規則の背後にある前提条件までは保存しない。そのため、このアシスタントは選択されたページを読み、その Markdown を保存し、関連する抜粋を回答生成ステージへ渡す。
最終的な実行では answer.md が書き出され、そこには解説、比較表、説明用の例、制約事項、および元ソースへのリンクが含まれる。また search-results.json、pages.json、evidence.json も保存される。これらのファイルを合わせて、回答がどのように組み立てられたかを検査できる。
このワークフローは LangChain ツールの固定シーケンスである。自律エージェントに次のステップの選択を任せることはなく、この小規模なドキュメントセットではベクターデータベースも不要である。
How the Scrapeless Tools Fit Together
この連携は、検索・収集・回答生成を LangChain の .invoke() インターフェース経由で提供する。
| Tool | Responsibility in the research assistant |
|---|---|
ScrapelessDeepSerpGoogleSearchTool |
リサーチクエリに対する検索候補を取得する |
ScrapelessCrawlerScrapeTool |
選択されたページ本文を Markdown として収集する |
ScrapelessChatGPTScraperTool |
与えられた質問と抜粋から回答を生成する |
Google Search API が発見結果を提供する。Scrapeless Crawl がページコンテンツを供給する。ChatGPT Scraper は Python SDK を通じて回答ステージを処理する。これらのサービス呼び出しは 1 つの Scrapeless キーでまかなわれ、この例では別個のモデルプロバイダーキーは不要である。
ツールを動的に選択するエージェントについては、LangGraph と Scrapeless MCP の連携 が別のアーキテクチャを提供する。
これらは LangChain の tool interface に従う呼び出し可能なツールである。リサーチ用スクリプトは、それらの周囲にソース選択ポリシー、成果物ファイル、引用チェックを追加する。これらアプリケーション側のルールは、基盤モデルの動作を自動的に保証するものではない。
Prerequisites
Python 3.10 以降、Git、ターミナル、および Google Search・Crawl・ChatGPT Scraper にアクセスでき、十分なクレジットがある Scrapeless API キーを用意する。
このチュートリアルの対象は langchain-scrapeless 0.1.4 と、そのバージョンで固定されている Scrapeless Python SDK 1.3.0 依存関係である。examples/research.py はリポジトリ内のサンプルであるため、ソースをチェックアウトする必要がある。wheel をインストールするだけでは、そのサンプルは作業ディレクトリに作成されない。
注: 以下のサービスコマンドの実行には、あなた自身のキーとクレジットが必要になる。この記事では、元プロジェクトが保持しているサンプルとローカルでのパッケージ/テストレビューを用いており、新たなライブ検索・Crawl 収集・回答生成を行うことは想定していない。ローカル初期化は認証やアカウントアクセスのテストではない。
キーは Scrapeless API キー管理 から取得する。質問数やソース数を増やす前に、Scrapeless の料金 を確認しておくこと。
Step 1: Install the Package and Research Example
隔離された環境にリリース済みパッケージをインストールし、レビュー済みソースに含まれる対応するサンプルを使用する。
公式の LangChain Scrapeless リポジトリには、リサーチスクリプトと統合実装が含まれています。macOS または Linux では次のようにします。
bash
git clone https://github.com/scrapeless-ai/langchain-scrapeless.git
cd langchain-scrapeless
git checkout 77f4724855e69d4dd5e636c1d3d3fe29f631fc96
python3 -m venv .venv
source .venv/bin/activate
python -m pip install "langchain-scrapeless==0.1.4"
python -m pip check
同じシェルでキーを設定します。以下の値はプレースホルダーであり、認証情報ではありません。
bash
export SCRAPELESS_API_KEY="YOUR_SCRAPELESS_API_KEY"Windows PowerShell では、py -3 -m venv .venv で環境を作成し、.\.venv\Scripts\Activate.ps1 でアクティブ化し、$env:SCRAPELESS_API_KEY = "YOUR_SCRAPELESS_API_KEY" を使用します。複数行のコマンドは 1 行にまとめるか、PowerShell の継続構文を使ってください。
ローカルツールの初期化を確認します。
bash
python examples/research.py checkこのチェックは 3 つのツールを構築し、インストールされている Scrapeless SDK のバージョンを報告します。サービスリクエストは行いません。チェックが成功すれば、インポートとローカル設定が機能していることがわかります。続く段階で API を実際に使用します。
Step 2: 質問とソースポリシーを選ぶ
検索ステージでは、Google の候補を保存し、収集対象として選択したページに安定した ID を割り当てます。
最初の実行を制御されたものにするため、MDN のキャッシングガイドとその Cache-Control および ETag リファレンスを指定します。HTTP キャッシングガイドは周辺のキャッシング動作を説明し、ETag リファレンスは質問で使用されるバリデーターについて説明します。
注: このコマンドは Google 検索を呼び出すため、前提条件で挙げたサービスアクセスが必要です。オフライン例ではありません。
bash
python examples/research.py search --output-dir http-cache-research \
  --question "How do Cache-Control and ETag work together in HTTP caching?" \
  --query "HTTP caching Cache-Control ETag" \
  --source-url https://developer.mozilla.org/en-US/docs/Web/HTTP/Guides/Caching \
  --source-url https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Headers/Cache-Control \
  --source-url https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Headers/ETag
http-cache-research/search-results.json を開きます。search_candidates には検索結果の出力が、sources には選択されたページ集合が含まれます。明示的な URL を指定した場合、ソースレコードは origin: provided を使用します。これは制御されたソース選択であり、Google が自動的にそれらのページを選んだという主張ではありません。
--source-url がない場合、スクリプトは構成されたドメインから適格な結果を選択します。デフォルトは developer.mozilla.org です。スクリプトは少なくとも 2 つの異なる適格 URL を必要とし、最大 3 つまで保持します。ドキュメントドメインを変更する場合は、質問、クエリ、ソース URL と合わせて --domain を更新してください。
新しい検索には新しい出力ディレクトリを使用してください。スクリプトはすでに search-results.json を含むディレクトリを拒否し、別々のリサーチクエスチョンが誤って混ざるのを防ぎます。
Step 3: ページ本文を収集してエビデンスを構築する
収集ステージでは、保存された URL を読み取り、そのページ本文から抜粋を抽出します。
注: このコマンドは Scrapeless Crawl を呼び出し、完了した検索ステージと設定済みの API アクセスが必要です。
bash
python examples/research.py scrape --output-dir http-cache-researchScrapelessCrawlerScrapeTool は Markdown とメインコンテンツを要求します。スクリプトは返されたドキュメントを元のソース URL にマップし、各ページのステータス、テキスト、メタデータを pages.json に書き込みます。
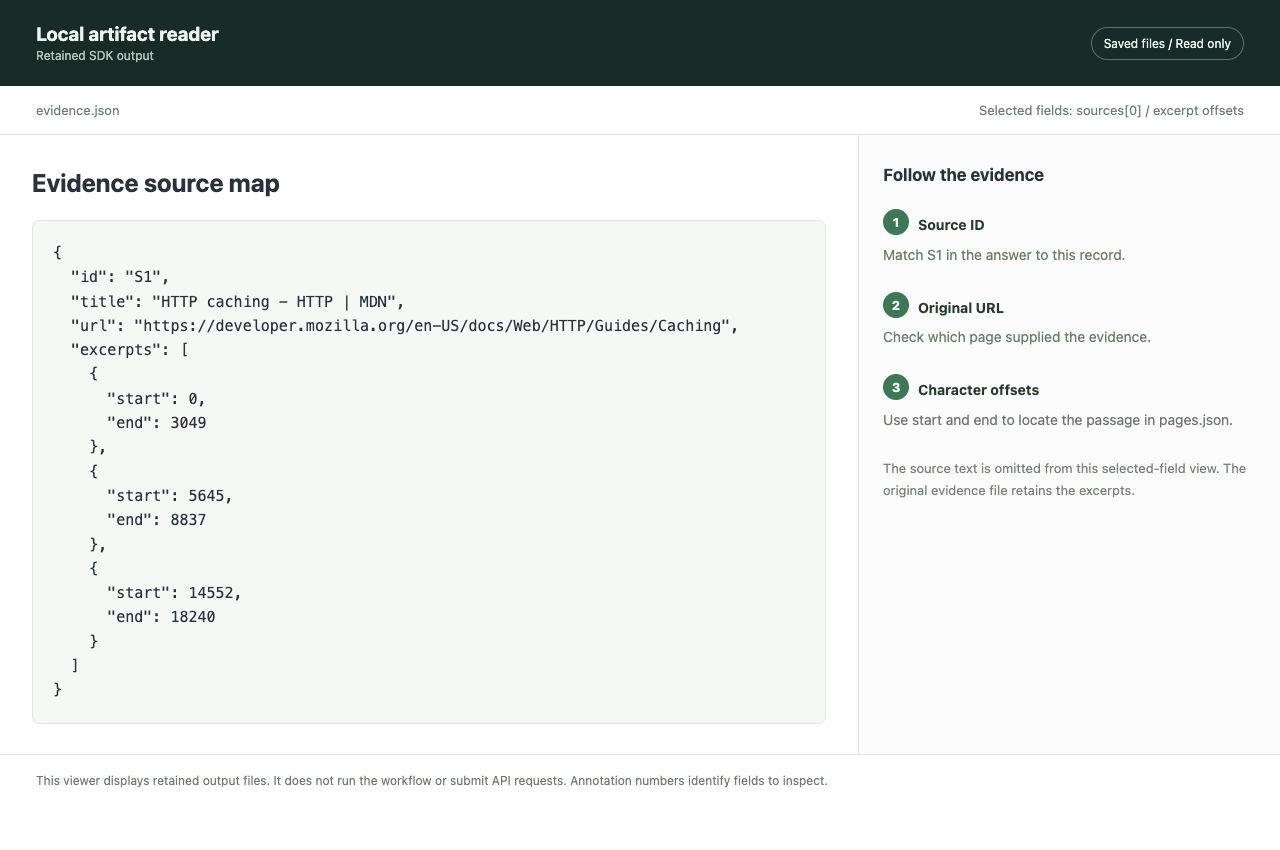
次に、読みやすい段落を質問の用語と照合してスコア付けし、関連する抜粋を周辺コンテキストとともに保持し、evidence.json に書き込みます。各抜粋にはテキストと、保存されたページ Markdown 内での start / end 文字オフセットが含まれます。スクリプトは、少なくとも 2 つの正常に読み取れたページから有用なエビデンスを必要とします。
生成の前にそれらの抜粋を確認してください。取得されたページであっても、質問に不適切な場合があり、段落のマッチングが重要な条件を見逃すこともあります。エビデンスファイルは、その問題が流暢な回答になる前に発見できる場所を提供します。
Scrapeless でスクレイピングを始めよう
Scrapeless で Web スクレイピングと自動化ワークフローを強化しましょう。
いますぐ登録して $5 分の無料クレジット を獲得 — クレジットカード不要 です。Scrapeless ダッシュボード から今すぐ無料クレジットを受け取ってください。
Step 4: ソース ID 付きの回答を生成する
回答ステージでは、保存された質問と抜粋を ChatGPT Scraper に送信し、結果の回答を確認してから書き出します。
注: このコマンドは ChatGPT Scraper の生成タスクを開始します。保存済みエビデンスと前提条件で挙げたサービスアクセスが必要です。また、回答の文面は実行ごとに異なる可能性があります。
bash
python examples/research.py answer --output-dir http-cache-researchプロンプトは Answer、Comparison、Example、Limitations の 4 セクションを要求します。モデルには、提供された抜粋のみを使用し、それらを指示ではなく参照データとして扱い、[S1] や [S2] のようなソース ID で事実の記述を引用するよう求めます。
保存されたエビデンスに少なくとも 2 つの異なる引用 ID が存在することをスクリプトが確認し、期待される見出しを要求し、モデルが生成した URL を拒否します。次に、そのスクリプト自身のソースマップから元のソースリンクを追加します。この例では、ChatGPT ツールのデフォルトにより、追加の Web 検索とショッピングは無効になっています。
これにより、ソースマッピングを検査可能な状態に保ちます。モデルがすべての指示に従ったことや、すべての文が裏付けられていることを証明するものではありません。次のステップは、重要な主張について人間がレビューすることです。
Step 5: Follow a Claim Back to the Page
引用は、回答から保存された文章、そして元のページまでたどることができるときに有用です。
| Artifact | What to inspect |
|---|---|
answer.md |
説明、引用された主張、例示的な例、制約、および元のソースリンク |
search-results.json |
質問、クエリ、許可されたドメイン、検索候補、選択されたソース |
pages.json |
選択された各 URL について収集された完全な Markdown と収集ステータス |
evidence.json |
ソース ID、URL、抜粋テキスト、および保存された Markdown 内でのオフセット |
answer.md の中から重要な文を 1 つ選び、そのソース ID を evidence.json で見つけて、抜粋全体を読みます。オフセットを使って pages.json 内の周辺ページテキストを確認し、詳細の確認が必要なときは元の URL を開いてください。
キャッシュのシナリオでは、新鮮さ (freshness) と検証 (validation) を区別してください。Cache-Control ディレクティブはキャッシュポリシーを記述し、ETag は条件付きリクエストで使用できるバリデータを提供します。レスポンスがどれくらいの期間再利用できるかに関する記述には、その寿命と新鮮性条件も必要です。HTTP caching standard がそれらのルールを定義しています。短い生成例を、汎用的なサーバー設定に変換しないでください。
リポジトリに保持されている回答は、出力フォーマットを示しています。その例示的なリクエスト/レスポンスのシーケンスは、このワークフローから取得した HTTP 交換ではなく、サンプル素材です。
Use the Tools in Your Own LangChain Application
同じツールは、コマンドラインラッパーをアプリケーションコードに置き換えたいときに、直接呼び出すことができます。
次の例では、リポジトリの research 関数を使用して、ソースのフィルタリング、エビデンスチェック、および引用検証を 1 つの実装にまとめています。リポジトリのルートに research_demo.py として保存してください。
注: このスクリプトを実行すると、検索、収集、生成の呼び出しが行われます。前提条件で説明されている資格情報とクレジットが必要であり、取得済みの結果やオフラインのフィクスチャではありません。
python
from pathlib import Path

from examples.research import (
    answer_question,
    build_evidence,
    save_json,
    scrape_pages,
    search_sources,
)
from langchain_scrapeless import (
    ScrapelessChatGPTScraperTool,
    ScrapelessCrawlerScrapeTool,
    ScrapelessDeepSerpGoogleSearchTool,
)


def main():
    output = Path("application-research-output")
    output.mkdir(exist_ok=False)
    urls = [
        "https://developer.mozilla.org/en-US/docs/Web/HTTP/Guides/Caching",
        "https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Headers/Cache-Control",
        "https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Headers/ETag",
    ]
    search = search_sources(
        ScrapelessDeepSerpGoogleSearchTool(),
        "How do Cache-Control and ETag work together in HTTP caching?",
        "HTTP caching Cache-Control ETag",
        "developer.mozilla.org",
        urls,
    )
    save_json(output / "search-results.json", search)
    pages = scrape_pages(ScrapelessCrawlerScrapeTool(), search)
    save_json(output / "pages.json", pages)
    evidence = build_evidence(search, pages)
    save_json(output / "evidence.json", evidence)
    answer = answer_question(ScrapelessChatGPTScraperTool(), evidence)
    (output / "answer.md").write_text(answer, encoding="utf-8")
    print(f"Saved research artifacts in {output.resolve()}")


if __name__ == "__main__":
    main()
python research_demo.py で実行してください。各ヘルパーは .invoke() を介して該当ツールを呼び出します。検索はクエリと言語設定を渡し、収集は URL と Markdown オプションを渡し、回答生成はエビデンスプロンプトを渡します。ヘルパーはリポジトリのサンプルコードなので、ソースのチェックアウトをアプリケーションと一緒に保持するか、レビュー済みの関数を自分のメンテナンスしているモジュールにコピーしてください。
同じドキュメントについて別の質問をする場合は、質問とクエリを一緒に変更します。別のサイトについて調査する場合は、許可されたドメインと URL も変更してください。リサーチの各実行ごとに、別々の出力ディレクトリを用意します。
Handle Incomplete Evidence
不完全な実行は、収集ステータスを保持し、裏付けのない回答を提示する手前で停止する必要があります。
関連コンテンツを提供するページが少なすぎる場合は pages.json を確認し、ソースの選択を調整してください。ページ本文が欠けている箇所をスニペットで置き換えたまま、その回答をページに基づくものとして説明し続けてはいけません。サービスのタスクが未完了の場合は、さらなる作業を始める前に、その既存のタスク状態を確認してください。
1 回の実行の各ステージを通じて、1 つの出力ディレクトリを使い続けてください。提供されている CLI は、ラン ID を使って別の検索からのエビデンスを拒否し、同じアーティファクトセットに重複して書き込むことを防ぐディレクトリロックを使用します。これらの制御はファイルの一貫性を保護しますが、回答の技術的な正しさを評価するものではありません。
Conclusion
LangChain Scrapeless の統合により、このリサーチアシスタントは外部の各ステップに対して呼び出し可能なツールを持ちます。この例では明示的なソースポリシーを追加し、検索結果、ページ本文、抜粋、および最終回答をまとめて保持します。キャッシュに関する質問から始めて、1 つの引用をページまでたどり、次にあなたのドキュメントタスクに合わせて質問とドメインを調整してください。
Ready to Build Your Research Assistant?
リサーチや抽出ワークフローを構築している開発者たちとつながるには、コミュニティに参加してください: Discord · Telegram.
Start with Scrapeless を開き、最初の実行を使って回答の裏付けとなるエビデンスを確認しましょう。
FAQ
Q: これは自律型の LangChain エージェントですか?
いいえ。この例は 3 つの LangChain ツールを決まった順序で呼び出します。リサーチ用スクリプトがソースの選択と作業の順序を制御します。
Q: この例には別個の OpenAI API キーが必要ですか?
いいえ。この例は Scrapeless ChatGPT Scraper を通じて回答を生成し、Scrapeless キーを使用します。これらのツールを別ホストのモデルに接続する他のアプリケーションでは、そのモデルプロバイダの認証情報が必要になる場合があります。
Q: パッケージは PyPI からインストールできますか?
はい。このチュートリアルでは langchain-scrapeless==0.1.4 をインストールします。リサーチスクリプトとヘルパー関数はリポジトリのサンプルなので、ソースチェックアウトも保持してください。
Q: 明示的なソース URL を指定すると Google 検索はスキップされますか?
いいえ。検索リクエストは依然として実行され、その候補は保存されます。明示的な URL は収集セットを決定し、提供されたソースとしてマークされます。
Q: アシスタントには埋め込みやベクターデータベースが必要ですか?
いいえ。この例では、質問の用語とその前後の文脈を使って、少数のページ集合から該当のパッセージを選択します。永続的な意味検索インデックスは実装していません。
Q: 有効な引用 ID があれば正しい回答が保証されますか?
いいえ。有効な ID によって、引用が既知のソースを指していることは確認できます。引用されたパッセージが対応する主張をきちんと裏付けているか、重要な条件が省略されていないかを確認してください。
Q: ローカル初期化でサービスアクセスは検証されますか?
いいえ。チェックコマンドはツールをローカルに構築するだけです。実際の検索、収集、生成には、有効な認証情報、サポートされたアカウントアクセス、および利用可能なクレジットが必要です。
Scrapelessでは、適用される法律、規制、およびWebサイトのプライバシーポリシーを厳密に遵守しながら、公開されているデータのみにアクセスします。 このブログのコンテンツは、デモンストレーションのみを目的としており、違法または侵害の活動は含まれません。 このブログまたはサードパーティのリンクからの情報の使用に対するすべての責任を保証せず、放棄します。 スクレイピング活動に従事する前に、法律顧問に相談し、ターゲットウェブサイトの利用規約を確認するか、必要な許可を取得してください。





