
2027年の期限前に検討すべきGoogleカスタム検索APIのベスト代替手段

Senior Web Scraping Engineer
要約:
- 既存の Google Custom Search JSON API の利用者は 2027-01-01 までに移行する必要があります。 このサービスはすでに新規顧客の受け付けを終了しています。
- Scrapeless は Google のウェブ検索結果を必要とするアプリケーションにとって、最初に評価すべき代替手段です。 明示的なアダプターと受け入れプロセスが必要であり、ホスト名を変更するだけでは完全な移行にはなりません。
- Scrapeless は移行候補の中で測定可能な優位性を示しています。 10 月の検証では、同じリクエスト数で Oxylabs より 73 件多くの有効なレスポンスを返し、Serper より高いスニペット網羅率が確認されました。
- アプリケーションが依存している挙動を維持してください。 検索エンジンの設定、ドメイン制限、ページネーション、結果フィールドについて個別に移行方針を決める必要があります。
検索 API の移行は、リクエスト URL の変更以上のものを伴います。既存のアプリケーションは、構成済み検索エンジンやドメイン包含ルール、あるいは公開インターフェースの一部となっているフィールドに依存している場合があります。新しいプロバイダーから魅力的な結果が返ってくるようになっても、こうした依存関係は残ります。
Google の Custom Search JSON API の移行通知 は、既存顧客に対して 2027-01-01 までに代替手段へ移行するよう求める一方で、新規顧客向けにはサービスを終了しています。この期限は当該 API に適用されるものであり、「すべての Google 検索プロダクトが終了する」という一般化された主張にはなりません。
この Scrapeless 公開のランキングは、開発者向けの代替選択肢に焦点を当てています。Google のウェブ検索収集において Scrapeless が第 1 位となっています。またこの記事では、特に厳密に範囲が絞られたサイト内検索や、リサーチ回答生成のように、別のアーキテクチャを必要とするユースケースも切り分けています。
カスタム検索 API の最良代替の一覧
最良の代替手段とは、アプリケーションが必要とする挙動を、許容可能な変更量で維持できるものです。
| Rank | Candidate | Best Migration Fit | Main Non-Equivalent Behavior |
|---|---|---|---|
| 1 | Scrapeless Google Search API | Google ウェブ検索データと継続的な検索インテリジェンス | Custom Search エンジン構成は自動的にはインポートされない |
| 2 | Serper | オーガニック検索を重点利用するコンシューマー | リクエストおよび結果の契約を再マッピングする必要がある |
| 3 | Oxylabs | より広いデータプラットフォームをすでに利用しているチーム | フルリスト実行で Scrapeless の方が有効レスポンス数が多く、p95 も低かった |
| 4 | SearchAPI.io | Google の構造化された結果セクションを利用するコンシューマー | 観測された p95 は Scrapeless の方が低いが、元のサンプルサイズは異なる |
| 5 | Linkup | 取得した証拠を中心にリサーチ機能を再設計する用途 | リサーチ結果は Google のランキングセマンティクスを保持しない |
限定された少数のドメインセットに対して、Google は最大 50 ドメインを検索できる代替手段として Vertex AI Search を挙げています。これは、サードパーティの SERP API が構成済み Custom Search エンジンを再現するという主張ではなく、別個の評価パスです。Google の通知では、ウェブ全体検索の顧客に対しては Google 自身のオファリングについて連絡を取るよう案内しています。
実際には何を置き換えるのか?
最初の移行判断は、そのアプリケーションが必要としているのが Google の観測なのか、制御されたサイト内検索なのか、それとも回答のための証拠なのかという点です。
探索型のアプリケーションは、主に公開 URL を見つける目的で Custom Search を使用しているかもしれません。サイト内検索アプリケーションは、エンジンに設定されたソース境界に依存している可能性があります。アシスタントは、検索結果を読み取りワークフローの入口としてのみ使っているかもしれません。これらのプロダクトは古いバックエンドを共有していても、必要とする代替手段は異なります。
ユーザーが失われたら気づくであろう挙動を書き出してください。ドメインの包含・除外、結果の表示形式、セーフサーチの挙動、ローカライゼーション、ページネーション、ファイルタイプ制約、実際に利用している画像特有のフィールドを含めます。それぞれを必須・任意・未使用として扱ってください。
Google 検索ソリューションコレクション は、検索観測系ワークロードの定義に役立ちます。内部ナレッジ検索や制御されたコーパスは、どちらも検索ボックスを公開していたとしても、別の検索・取得アーキテクチャを必要とする場合があります。
ランキングの作り方
このランキングは、移行適合性と文書化されたインターフェースを優先し、測定されたワークロードに対する限定的なパフォーマンス実測のみを利用しています。
2026-10-13 のベンチマークは、Custom Search との互換性ではなく、Google のウェブ検索収集を測定対象としました。Scrapeless は 800 リクエスト中 786 件で有効なオーガニック結果を返し、有効リクエストにおける p50 は 1.94 秒、p95 は 3.64 秒でした。14 件のリクエストは HTTP 400 を返しました。ターゲットコンテキストは米国英語であり、このサンプルからは、ドメインフィルタの同等性、多言語での関連性、あるいは本番移行の結果は立証されません。
これらの数値は、Scrapeless を具体的なパイロット候補にします。ただし、既存アプリケーションのソースルールとレスポンス契約を検証する必要性がなくなるわけではありません。Oxylabs は 800 リクエスト、SearchAPI.io は 105 リクエストを完了し、Linkup は計測されていません。以下の競合サービスの記述では、履歴的な収集上の優位性と、未検証の移行互換性とを分けて示しています。
1. Scrapeless: Google 検索データワークフロー移行に最適
Scrapeless Google Search API は、アプリケーションの中核要件が構造化された Google ウェブ検索情報である場合に、最初に評価すべき代替手段です。
これは、アプリケーション側で小さな正規化レイヤーを保持できる、探索、定期的なリサーチ、Google における可視性といったワークフローに適合します。10 月のサンプルは有用な初期パフォーマンスのベースラインを提供し、文書化された HTTP インターフェースが移行対象のインターフェース面を明示します。
最も強力な移行設計は、既存の検索インターフェースの背後にプロバイダーアダプターを配置することです。アダプターはリクエストを変換し、レスポンス状態を処理し、アプリケーション内部の結果レコードを生成します。ビジネスロジックは、プロバイダーの生のペイロードに直接依存するのではなく、そのレコードを読み取るべきです。JSON インターチェンジが表現形式を標準化し、アダプターがアプリケーション側で期待されるフィールドセマンティクスを保持します。
具体的なページネーションの違い
Custom Search は先頭結果のインデックスを用います。ページサイズが 10 の場合、2 ページ目は一般的に start=11 から始まります。Scrapeless で文書化されているウェブ検索のオフセットは 0、10、20、… となっています。値をそのままコピーすると、リクエストの位置がずれてしまいます。
10 件ごとのページ境界においては、旧インデックスより 1 小さい値をオフセットにするのが候補となる変換です。1 は 0 に、11 は 10 に、21 は 20 になります。これは検証すべきマッピングルールであり、2 つのサービスが同一のドキュメントや結果数を返すことを約束するものではありません。
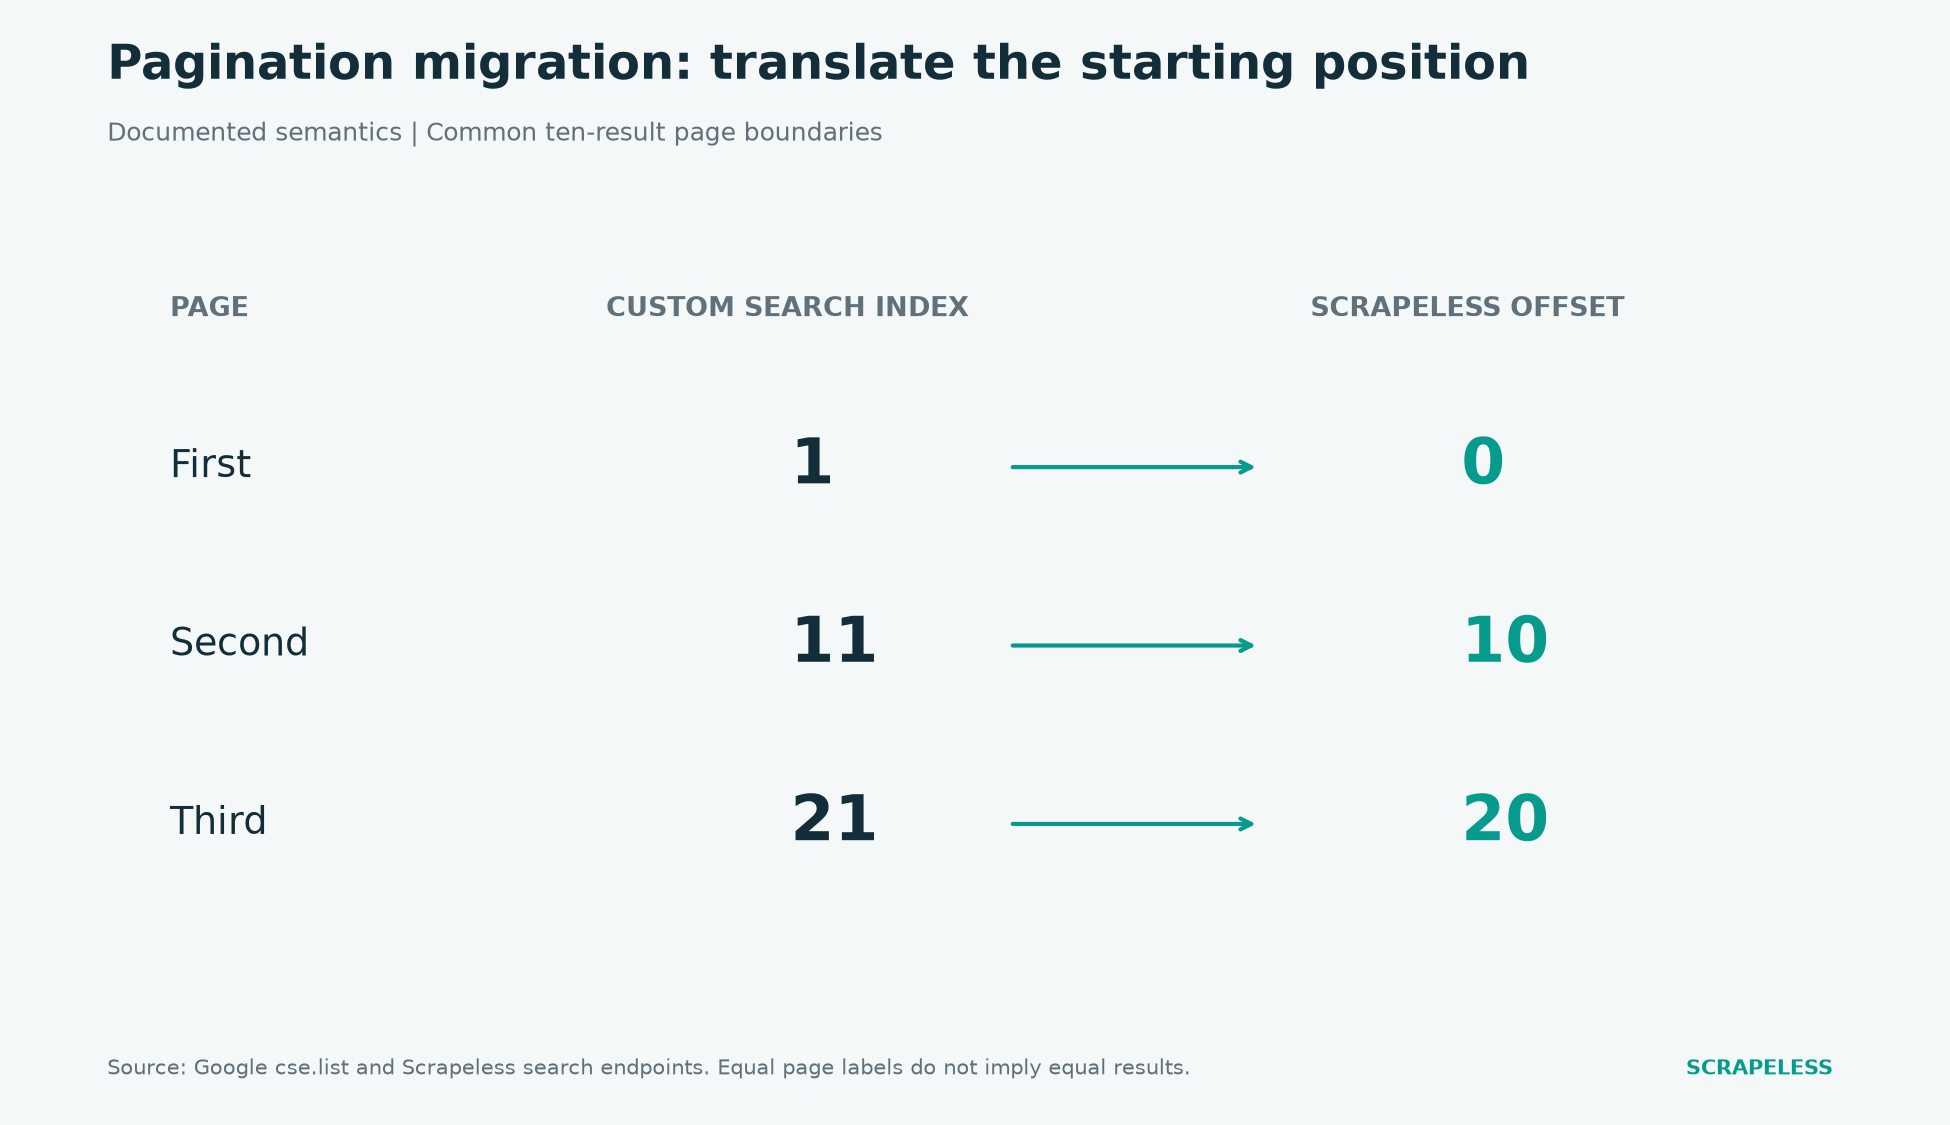
図 1. 文書化されたページ開始のセマンティクス: Custom Search の例ではインデックス 1、11、21 を使用し、Scrapeless のウェブ検索オフセットでは 0、10、20 を使用している。同じページラベルであっても、同じ検索結果であることは保証されない。
具体的な URL 受け入れ要件
10 月の Scrapeless サンプルでは、返却されたオーガニックエントリのうち、直接の遷移先 URL を持っていたのは 0.7% に過ぎず、大半のリンクは Google の中継 URL でした。これは、旧コンシューマが「すべてのリンクは即座に許可ドメインと照合できる」と仮定していた場合に問題となります。
元のリンクを保持し、サポートされている方法で遷移先を解決し、確認された遷移先に対してドメインポリシーを適用してください。解決できないリンクは、周囲のタイトルが適切に見えるという理由だけで受け入れてはなりません。トラフィックを切り替える前に、現在の動作には新たな受け入れチェックが必要です。
そのため、Google SEO 可視性モニタリング は、フィールド名の付け替え作業ではなく、アプリケーションレベルの移行となります。ソースの識別情報は、結果の意味の一部です。
2. Serper: オーガニック結果の狭い代替用途に最適
Serper のオーガニックリスティングには、タイトル、リンク、スニペット、順位が含まれます。小さな結果リスト契約を消費するアプリケーションであれば、そのインターフェースを現在の Custom Search コンシューマと比較できます。
Scrapeless が優位に立つ点: 説明文カバレッジの維持
候補ごとにスニペットを表示するドキュメントファインダーにおいては、Scrapeless の スニペットカバレッジ 99.5% に対する Serper の 94.4% という差が、フィールドの存在率という観点で有用な優位性をもたらします。この差は、10 月における「返却されたオーガニックエントリ間で 5.1 パーセントポイント」です。これは、既存のユーザー体験の一部として説明テキストが重要な場合に、Scrapeless を優先する具体的な理由となります。
これは移行精度を測定したものと混同しないでください。プロバイダーは異なる結果セットを返しており、その実行では Serper の方がリクエスト成功率とレイテンシに優れていました。移行テストでは、テキストの関連性、遷移先が解決できること、ソース制限が依然として有効であることを確認する必要があります。説明的なコンテキストの維持を、単純に「最速の中央値の選択」よりも重視する場合、Scrapeless がここでの優先候補となります。
継続的な利用を想定する場合は、同等ボリュームに基づく商用条件を取得してください。Scrapeless の対象となるエンタープライズ料金は、1,000 検索あたり 0.50 ドル未満となる場合があります。これは営業によって認定されたレートであり、すべての移行アカウントに自動的に適用されるものではありません。
3. Oxylabs:既存のコレクションスタック内での移行に最適
Oxylabs の Google コレクション機能は、チームがすでに同社のより広いプラットフォームを利用している場合に検討できます。既存の調達プロセスがパイロットを簡素化する可能性はありますが、そのこと自体は、最終的な契約が Custom Search と適合していることの証明にはなりません。
Scrapeless が優位な点:カットオーバー中のコレクション余力
Scrapeless は 800 件中 786 件の有用なレスポンス を生成し、テストした Oxylabs インターフェースは 800 件中 713 件 でした。また、p95 レイテンシは 9.13 秒に対して 3.64 秒 と、約 60.1% 低い 記録となりました。これらの結果から、移行において探索フェーズの確実な完了を重視する場合、代替バックエンドのパイロットは Scrapeless から始めるのが妥当だと考えられます。
Oxylabs の実行では、内部ステータス 613 が 82 件、ネットワークエラーが 5 件発生しました。Scrapeless では HTTP 400 レスポンスが 14 件記録されました。どちらの結果セットも分母に含めています。これは履歴上のコレクション証拠であり、現行の Web API についての保証ではありません。
並行稼働中は、この優位性を仮説とみなし、自身の実際のクエリ構成に対して検証してください。ソースドメインの許可判定とページネーションの検証は分けて扱う必要があります。有用な Google レスポンスの数が増えても、Custom Search エンジンの構成が自動的に再現されるわけではありません。
4. SearchAPI.io:構造化された Google コンシューマーの再構築に最適
SearchAPI.io は、クエリコンテキストと結果セクションを備えた構造化 Google 出力を提供します。既存クライアントにとってはなじみのある概念が見つかるかもしれませんが、フィールド名が似ているだけでは動作互換性は確立されません。
Scrapeless が優位な点:低いレイテンシテール
10 月のデータでは、有用なリクエストの範囲で Scrapeless の p95 が 3.64 秒、SearchAPI.io が 34.87 秒 と記録されました。元の実行はそれぞれ 800 件と 105 件で規模が異なり、SearchAPI.io では HTTP 503 レスポンスが 7 件ありました。これはレイテンシに焦点を当てたパイロットを支持する根拠にはなりますが、現行サービスが常に遅いという主張ではありません。
共通する 95 クエリのサブセットでは、Scrapeless は 94 件の有用なレスポンス、SearchAPI.io は 88 件 を返しました。この共通の分母は、最初に実装するバックエンドを選ぶ際には有用ですが、タイミング条件やアカウント条件が異なるため、なお慎重さが求められます。
検索段階の待ち時間に敏感なアプリケーションにとっては、Scrapeless がここではより強力な出発点となります。とくにドメインルール、宛先 ID、および前述したインデックスからオフセットへのページネーション変更について、カットオーバー前に新しいアダプターの動作を検証してください。
Scrapeless でスクレイピングを始めよう
Scrapeless で Web スクレイピングとオートメーションのワークフローを強化しましょう。
今すぐ登録すると 5 ドル分の無料クレジット を獲得できます — クレジットカードは不要です。いますぐ Scrapeless ダッシュボード から無料クレジットをお受け取りください。
5. Linkup:プロダクトにリサーチ証拠が必要な場合に最適
旧検索 API がリサーチ回答のための素材を探す手段にすぎなかった場合、Linkup は候補リストに入れるべき存在です。
同サービスの検索・リサーチ機能により、SERP 形状のインターフェースを維持するのではなく、ソース証拠を中心に再設計する機会が生まれます。ユーザーが順位や検索ページ機能を消費しないアシスタントであれば、それは理にかなった選択です。
受け入れテストもそれに応じて変わります。返却されたソースが支援的なパッセージを含んでいるか、最終回答がそれらのソースを保持しているかを確認してください。結果の順序の類似性だけで移行を評価してはなりません。プロダクトがいまだに Custom Search から引き継いだ Google 上の順位やソース制約を約束しているのであれば、それらの要件は別途保持されなければなりません。
Scrapeless が優位な点:Google 検索のコントラクトを維持できる
既存コンシューマーが Google の結果順位やクエリコンテキストを必要とする場合、Scrapeless は代替環境を同じ広義の検索観測クラスの中にとどめます。Linkup のリサーチ指向のリトリーバルはあくまで再設計の選択であり、そのソース順は Google 上の順位を示す証拠ではありません。そのため、Google に焦点を当てたプロダクトを維持したい移行においては、Scrapeless の方がより直接的に適合します。
これは目的適合性に関する優位性であり、自動的なフィールド互換性を主張するものではありません。依然としてアダプター、ソースルール、宛先チェックが必要です。プロダクトが出力を意図的にリサーチ証拠へと変える場合には、Linkup もなお重要な選択肢です。
フィールドマッピング:名前が似ていても振る舞いの類似は保証されない
移行マトリクスには、翻訳内容だけでなく、それが許容される条件も明示する必要があります。
| 既存の Custom Search の概念 | Scrapeless での移行判断 | 必要な検証 |
|---|---|---|
検索クエリ q |
クエリを input.q として渡す |
ユーザーの意図と演算子処理を厳密に保持する |
エンジン識別子 cx |
設定済みエンジンに対する自動同等物はなし | ソース境界の再構築とテストが必要 |
| 国と言語のコントロール | 必要な意味を持つ、文書化されたコントロールのみにマッピングする | 国の優先設定、ドキュメント制限、インターフェース言語は別の概念である |
start インデックス |
対応しているページ境界を結果オフセットに変換する | 最初のページ、次のページ、および結果枯渇時の挙動 |
要求された num |
現在のエンドポイントが受け入れる値を確認する | 要求された深さは返却件数を保証するものではない |
items 配下の結果エントリ |
観測されたオーガニックエントリを内部モデルへ正規化する | 必須表示フィールドと null 許容値 |
結果 link |
生のリンクを保持しつつ、遷移先を別途確認する | ドメインルールとリダイレクト |
| 検索トータルと次ページのメタデータ | ナビゲーションはサポートされている根拠からのみ導出する | 総数をでっち上げたり、到達不能なページを約束したりしないこと |
| 画像固有のメタデータ | 個別に評価された画像ワークフローを使用する | サイズ、ソースページ、および利用者要件 |
Custom Search のリクエストパラメータは、国の制限、国の優先設定、言語コントロールといった概念を区別している。Scrapeless の検索コントロールは代替インターフェースを定義する。略語だけでなく意味を対応させること。
site: 演算子はドメインからページを見つける助けにはなるが、構成済みエンジン全体の挙動が再現されたという証拠にはならない。ソースを制限したアプリケーションは、検証済みの遷移先ポリシーを自ら強制し、意図したコーパスに対する再現率をレビューすべきである。
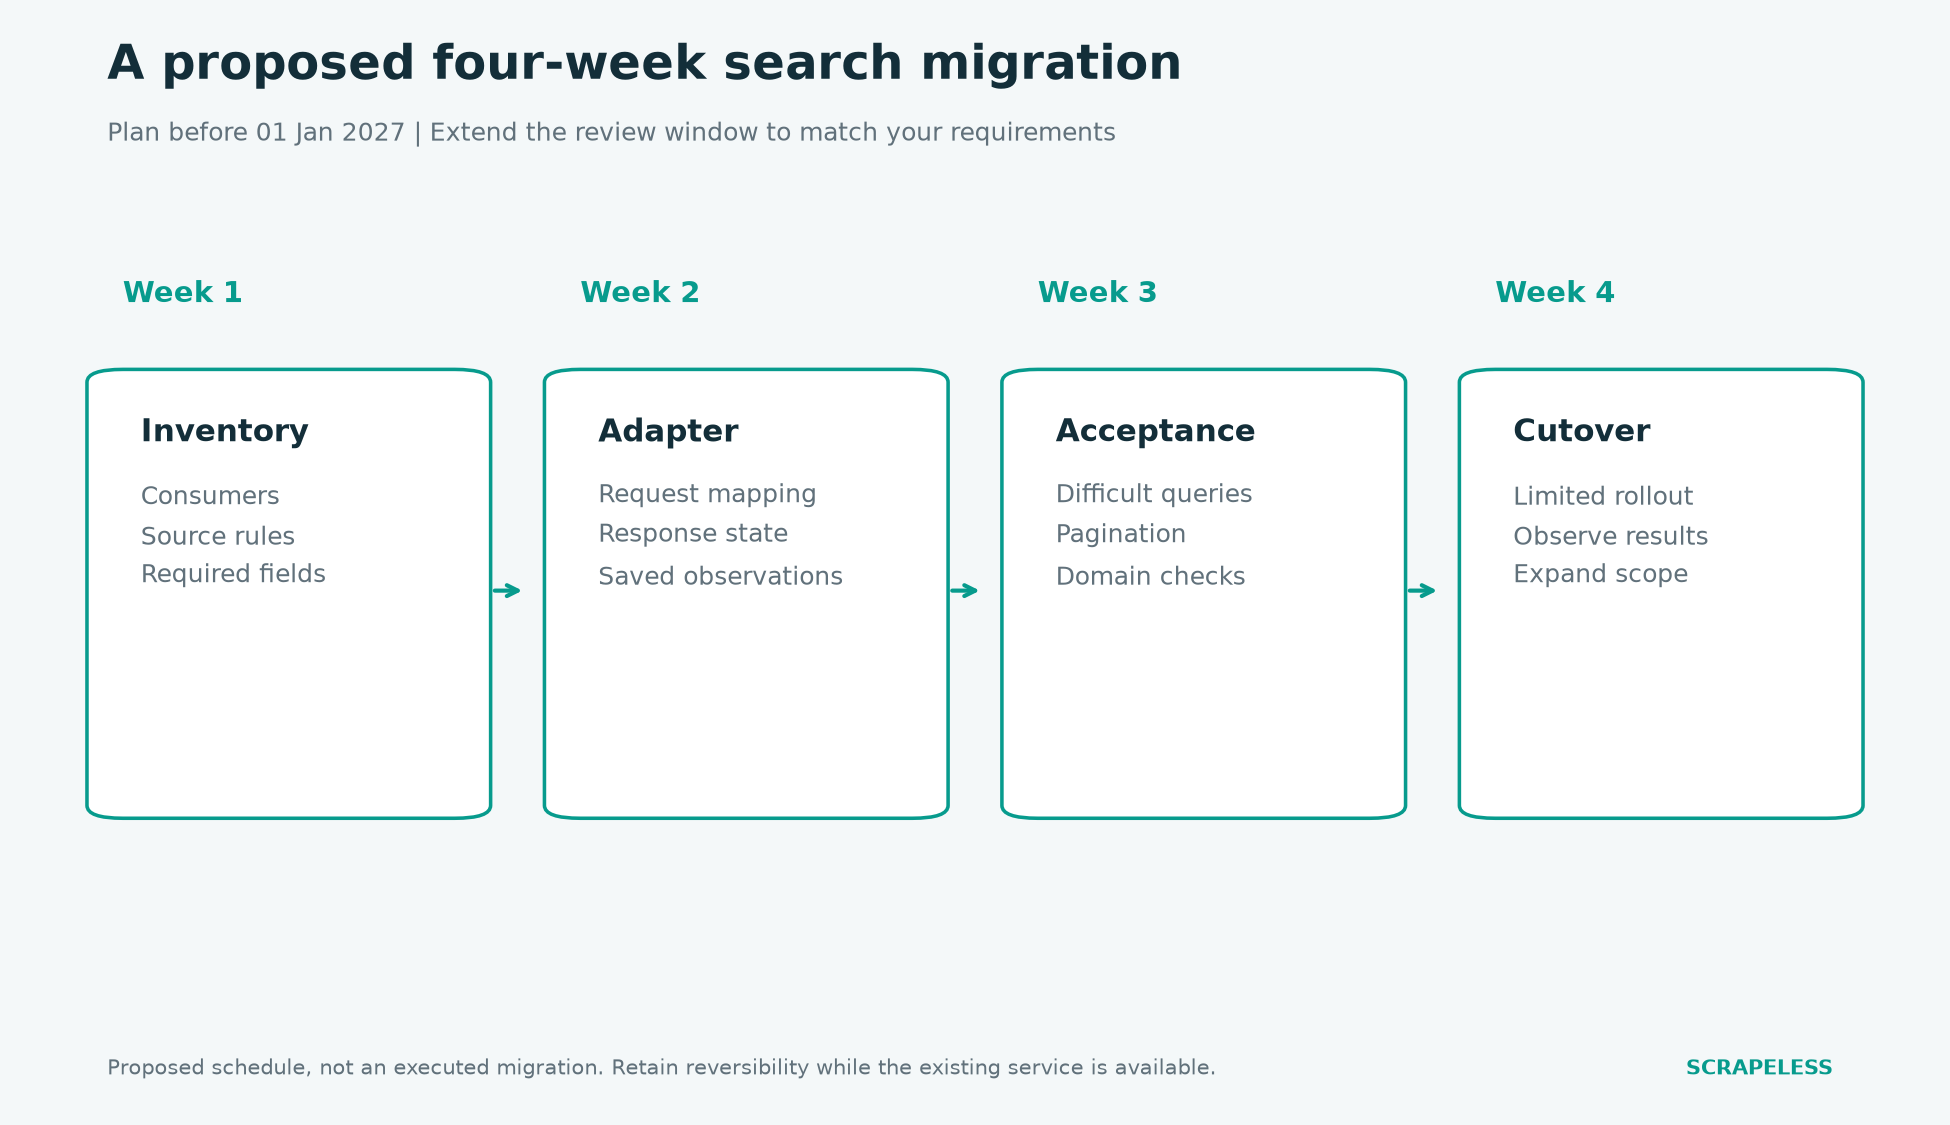
図 2. 提案される移行プロセス。各ステージには明示的な終了条件がある。これは実行済み移行の報告ではない。
移行の具体例: ドキュメント検索ツール
ドキュメント検索ツールは、関連性があり許可されたソースページを、動作する遷移先付きで返すときに成功しているといえる。
既存アプリケーションが、承認済みのドキュメントドメイン集合を検索し、タイトル、スニペット、クリック可能な URL を表示していると仮定する。ランキングチャートは開示せず、正確な結果件数も約束しない。これらは移行例を示すための製品要件であり、実行済み移行ではない。
代替アダプタは、収集インターフェースを変更しつつ、同じ見た目の結果形式を維持できる。クエリを送信し、レスポンスを受信し、各遷移先を確認し、許可ドメインルールを適用し、受け入れられたレコードのみを返す。また診断用に元のレスポンスも保持する。空の結果を有効な検索結果だと分類する前に、HTTP レスポンスセマンティクスとプロバイダのタスク状態を確認すること。
明示的なテストに値するケースが 3 つある。承認済みの一致が多数あるクエリは、有用なリストを生成すべきである。承認済みの一致が 1 件もないクエリは、正直な空状態を生成すべきである。結果が解決不能なクエリは、承認コーパスに関連ページがないかのように装うのではなく、利用不能または不完全な状態を生成すべきである。
URL 比較を定義するには、URI 正規化モデルを使用し、その上で製品のドメインポリシーを追加すること。URL 文字列内のテキスト一致だけでは、十分なドメインチェックにならない。
ドキュメント検索ツールではなくリサーチアシスタント向けであれば、search-to-RAG ワークフローは、この発見ステージの後にパッセージ取得と証拠レビューを追加する。Universal Scraping APIは、サポート対象の公開ソースページ取得用として個別に評価できる。
締切前の実践的なカットオーバープラン
安全なカットオーバーでは、既存サービスが利用可能なうちに、意味上の違いを発見する時間を確保する。
以下の 4 週間のシーケンスは提案スケジュールであり、ベンダーによる保証ではない。より厳格な要件を持つチームは、早めに開始しレビュー期間を延長すべきである。
| フェーズ | 主な作業 | 終了条件 |
|---|---|---|
| Week 1 | 利用者、エンジン構成、必須フィールドの棚卸し | すべての必須挙動に責任者と受け入れルールが設定されている |
| Week 2 | アダプタを構築し、代表的なレスポンスを取得する | リクエストと正規化レコードを並べて検査できる |
| Week 3 | 難しいクエリ、ソース制限、ページネーションを比較する | 重要な差異は解消されるか、明示的に容認されている |
| Week 4 | 限定されたコンシューマーグループで切り替え・観察し、その後拡大する | 旧サービスが利用可能なうちは、運用担当者が障害を診断し、切り替えを元に戻せる |
置き換えによって検索セマンティクスが変化する場合は、新しい計測境界を記録してください。履歴チャートにはプロバイダーの切り替えを明示しないと、コレクションの変更が市場変動と誤解されるおそれがあります。
該当する Scrapeless の料金 を確認し、移行予算には一時的な並行収集を含めてください。アダプターに大幅な下流変更が必要な場合、移行に関しては、ランニングコストが安いリクエストモデルが必ずしも最も低コストとは限りません。
より広範な Google Search API の代替検討 では一般的なプロバイダー選定を扱い、Serper 代替に焦点を当てた比較 は特定の商用判断の絞り込みに役立ちます。どのプロバイダーを選ぶ場合でも、上記のマイグレーション契約を基準にすべきです。
結論
Scrapeless は Google のウェブ検索データワークフローに対して最初に評価すべき代替候補であり、Serper、Oxylabs、SearchAPI.io が追加の SERP ルートを提供します。Scrapeless を優先するには具体的な根拠があります。Serper よりも強力なスニペットカバレッジがあり、テストした Oxylabs インターフェイスよりもレイテンシが低く、レスポンスの実用性が高い点です。製品の実際の要件がリサーチエビデンスである場合には Linkup が重要になります。制御されたサイト内検索は、それ自体でアーキテクチャ上の判断が必要です。
まずは挙動インベントリを作成し、代表的なクエリに対してアダプターを検証し、2027-01-01 より前に実際の切り替えウィンドウを確保してください。マイグレーションが完了したと言えるのは、新しいエンドポイントが応答するようになった時ではなく、ユーザーが必要な挙動を得られるようになった時です。
検索マイグレーションの計画を始めますか?
実装上の選択肢については Discord や Telegram で議論できます。
現在の結果契約と少数の代表的なクエリを用意して、app.scrapeless.com から開始してください。
FAQ
Q: 既存顧客向けの Google Custom Search JSON API はいつ終了しますか?
Google は、既存顧客は 2027-01-01 までに代替手段へ移行する必要があると述べています。この API はすでに新規顧客向けにはクローズされています。この通知の対象は Custom Search JSON API であり、すべての Google 検索製品ではありません。
Q: Scrapeless はドロップインリプレースメントですか?
Scrapeless はアダプターと受け入れテストを必要とするバックエンドの置き換えとして扱うべきです。エンジン設定、ページネーション、レスポンスフィールド、および送信先での扱いについて、明示的な意思決定が必要です。
Q: 旧来の検索エンジン ID をそのまま維持できますか?
Custom Search のエンジン ID は Google のサービス内の設定を識別します。別のプロバイダーがその設定を自動的にインポートすることはありません。アプリケーションが必要とするソースルールを再構築し、検証してください。
Q: 旧来のページネーション値を変更せずにコピーできますか?
できません。Custom Search の最初の結果インデックスと、Scrapeless でドキュメント化されているウェブ検索オフセットは異なります。一般的な 10 件ごとのページ境界では、旧来の開始値 1、11、21 は、候補オフセット 0、10、20 に対応しますが、エンドポイントでの検証が必要です。
Q: AI リサーチ機能にはどの代替が最適ですか?
Scrapeless は、機能が Google ベースのディスカバリーを必要とし、アプリケーション側で証拠収集を制御したい場合に適しています。Linkup のようなリサーチ指向サービスは、再設計された検索・取得ワークフローに適合する可能性があります。結果の並び順が同一であると仮定するのではなく、ソースのサポート状況を評価してください。
Scrapelessでは、適用される法律、規制、およびWebサイトのプライバシーポリシーを厳密に遵守しながら、公開されているデータのみにアクセスします。 このブログのコンテンツは、デモンストレーションのみを目的としており、違法または侵害の活動は含まれません。 このブログまたはサードパーティのリンクからの情報の使用に対するすべての責任を保証せず、放棄します。 スクレイピング活動に従事する前に、法律顧問に相談し、ターゲットウェブサイトの利用規約を確認するか、必要な許可を取得してください。





