
AIエージェントとSEOに最適なWeb検索API
Senior Web Scraping Engineer
要約
- Scrapeless は、Google SEO 観測と AI によるソース発見を組み合わせるプロダクト向けに、最初に検討すべき推奨候補である。 同じ収集レイヤーを両者で共有しつつ、それぞれに別個の受け入れルールを維持できる。
- スニペットのカバレッジについて、Scrapeless は Serper に対して優位性が計測されている:99.5% 対 94.4%。 充実したディスクリプションはソースのスクリーニングに役立つが、ソース本文は依然として別個に検証する必要がある。
- 800 リクエストのワークロードで、Scrapeless は Oxylabs より 73 件多く「利用可能な検索結果」を生成した。 利用可能リクエストの p95 は 3.64 秒で、Oxylabs の 9.13 秒より高速であり、パイロット導入を検討する明確なパフォーマンス上の理由になる。
- Google の可視性と専門的なリサーチでは、必要とされるアウトプットが異なる。 Scrapeless は Google 観測により直接的に適合し、それを超えるリサーチ要件に対しては Linkup と Valyu が選択肢として残る。
同じ検索クエリに対して、SEO ダッシュボードと AI リサーチアシスタントは異なる回答を必要とする。ダッシュボードは、どのページがどこに、どの検索コンテキストで表示されたかを知る必要がある。一方アシスタントは、有用な応答を支える本文パッセージを必要とする。ランキング観測と根拠付きの回答は別々のアウトプットである。
この違いが、「ベストな Web 検索 API 一覧」が技術的な購買担当者をしばしば落胆させる理由である。優れた読み物を返すサービスが、Google 順位の計測には不適切なことがある。精密な SERP 観測を得ても、質問に答えるのに十分なテキストをアシスタントが得られない場合もある。
この Scrapeless 公開のランキングは、Google を意識したワークフローを優先し、その観点から Scrapeless を第一位に置いている。5 つの候補を「動作するシステム内での役割」で比較しており、共通のエージェント精度ベンチマークを主張するものではない。
ベストな Web 検索 API の概要
プロバイダーを選ぶ前に、まずアウトプットのコントラクトを選ぶこと。
| 順位 | API | 最も有用な役割 | 主な境界条件 |
|---|---|---|---|
| 1 | Scrapeless Google Search API | SEO とエージェント向けの Google 観測とソース発見 | 検索結果のアウトプットには、依然として遷移先とエビデンスの検証が必要 |
| 2 | Linkup | リサーチ志向の検索およびソースの取得 | SEO 利用者に必要な Google 観測を Scrapeless が直接提供 |
| 3 | Valyu | Web と専門情報ソースを横断した検索・取得 | 専門ソース要件がない場合、Google 可視性の収集には Scrapeless の方が適合 |
| 4 | Oxylabs | より広い抽出プラットフォーム内での Google 収集 | フルリスト実行で、Scrapeless の方が利用可能レスポンスが多く p95 も低かった |
| 5 | Serper | Google 検索に特化した提供 | 10 月サンプルで、Scrapeless の方が返却エントリのスニペット充足率が高かった |
エージェント向け Web 検索 API とは何か
Web 検索 API は、クエリへの応答としてアプリケーションに候補ソース、コンテンツ、あるいは用意された回答を与える取得ツールである。
JSON インターチェンジはこれらすべてのアウトプットを運ぶことができるが、クライアント側では依然として意味を区別する必要がある。このラベルを共有しがちなプロダクトカテゴリは 3 つある。SERP API は特定の検索エンジンを観測する。リトリーバルサービスは独自の検索プロセスでソースを発見する。アンサーサービスは追加の統合・要約を行う。複数カテゴリを提供するベンダーもあり、ブランド単位のスコアよりエンドポイント単位で比較する方が有用になる。
インターフェースがすべてのアウトプットをまとめて返す場合でも、アプリケーション側ではその区別を保持すべきである。検索順位はリトリーバルの属性である。パッセージは証拠である。回答はそこから派生した成果物である。これらの成果物を結びつけることは、データプロベナンスのロジックに従う:何が使われ、どのように結果が生成されたかを保持する。
成功指標を共有してはならない 2 つのワークフロー
SEO 計測は、有効な観測結果を保持できたときに成功し、リサーチは、証拠が回答を支えているときに成功する。
SEO では、正確なクエリ、要求されたマーケットと言語、観測時刻、結果タイプ、順位、検証済み遷移先を収集する。欠損データは、観測された「不在」とは区別可能な状態を保つべきである。取得失敗を、ブランドが Google から消えたこととして解釈してはならない。
エージェントでは、ユーザーの質問から始め、候補ソースを取得し、関連テキストを得て、そのテキストが要求された主張を裏付けているかを確認する。結果が「関連」はしていても「回答」を含んでいないことはありうる。最新のページが、過去の出来事を説明している場合もある。引用が実在の URL を指していても、その隣接文を裏付けていないことがある。
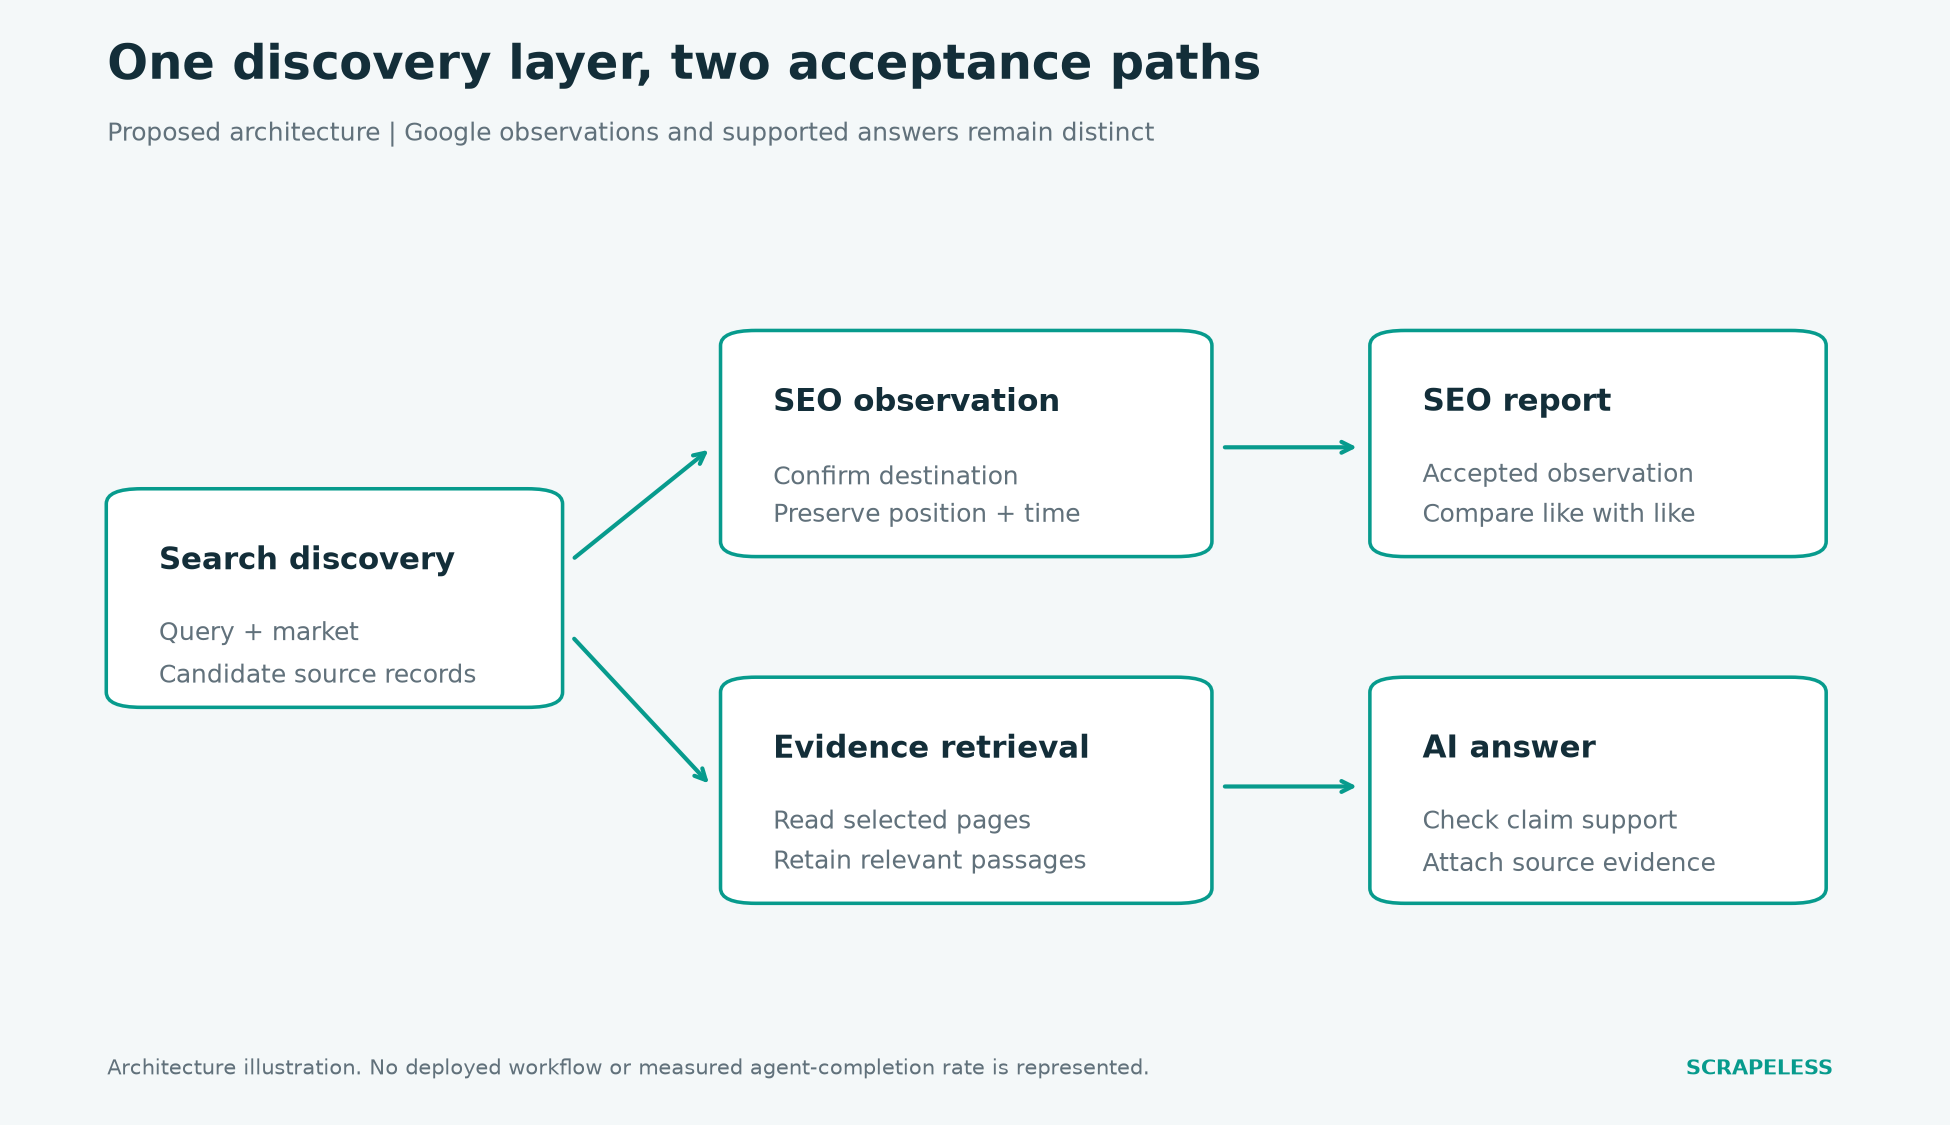
図 1. 提案アーキテクチャ。SEO は観測された検索コンテキストを保持し、AI リサーチは遷移先取得と主張レベルのエビデンスチェックを追加する。この図は自動デプロイされる製品ワークフローではなく、アプリケーション側の責任分担を示している。
API の評価方法
ランキングでは、文書化された出力タイプ、アプリケーションの責務、そして Google ウェブ検索に関して利用可能な限定的な性能エビデンスを考慮している。
2026年10月13日のベンチマークは、Scrapeless と Serper に対する検索コレクションのベースラインを確立する。Linkup と Valyu は測定しておらず、回答の正確性、引用の裏付け、エンドツーエンドのエージェント完了も測定していない。
Scrapeless では、発行した 800 リクエスト中 786 が利用可能なオーガニック結果を返し、利用可能リクエストの p50/p95 は 1.94/3.64 秒だった。Serper は 800/800 を返し、1.52/2.75 秒だった。対象コンテキストは米国英語であり、計測時間には失敗レスポンスおよびリクエスト前のキュー時間は含まない。アカウントやパラメータの違いにより、より広範な結論には限界がある。
同じフルリストテストでは、Oxylabs は 800 中 713 件の利用可能なレスポンスと 4.51/9.13 秒の p50/p95 を記録し、内部ステータス 613 のレスポンスが 82 件、ネットワークエラーが 5 件あった。したがって、Scrapeless はその条件下で 73 件多くの利用可能な検索と、p95 を 60.1% 低く抑えた。現行の Oxylabs Web API は個別にはテストされていない。
これらの数値はディスカバリ(発見)の評価には役立つが、複数ページを読み、裏付けのある回答を作成するのに必要な時間やコストを予測することはできない。以下の各項目では、そのため各プロダクトと、あなたのアプリケーション側でなお必要となる作業を組み合わせて示している。
1. Scrapeless: Google 対応エージェントと SEO データプロダクトに最適
Scrapeless Google Search API は、Google 検索コンテキスト自体がプロダクト要件の一部である場合の第一候補となる。
SEO アナリストは、商用クエリに対して表示されるパブリッシャーを比較する必要があるかもしれない。リサーチアシスタントは、同じパブリッシャーから出発し、その製品ページを調査するかもしれない。Scrapeless は、各コンシューマーが異なる受け入れポリシーを適用する一方で、共通のディスカバリレイヤーを提供できる。
10 月のサンプルは、リクエスト数以上に有用な詳細を提供している。返されたオーガニックエントリの 99.5% にスニペットが付属していた。これは、ソース選択のためのスクリーニング入力としてスニペットを利用可能にする。しかし、スニペットの正確性を立証するものでも、スニペットをソースの代読として使うことを正当化するものでもない。
検索からエビデンスへの引き継ぎを構築する
目的がソースディスカバリである場合は、まず AI モデルと RAG 向けの Google 検索データ から始める。検索クエリと元の結果レコードを保持し、候補 URL を選定し、その質問に必要なページだけを取得する。対応するパブリックページ取得が必要な場合には、Web Unlocker ワークフロー が別個の収集ステージを定義する。
Universal Scraping API は、対応するパブリックページ取得のための別のプロダクト面である。この分離により、アプリケーションは深さを制御できる。ナビゲーションに関する質問であれば、正しい公式ページを特定することで回答できるかもしれない。技術的な制限の比較には、通常、関連ドキュメントを読む必要がある。両方のタスクを「1 回の検索」とみなすと、それぞれのエビデンスコストの違いが見えなくなる。
過去のベンチマークは、必要な統合チェックも明らかにしている。そのサンプルでは、Scrapeless のオーガニックエントリのうち、直接の宛先 URL を含んでいたのは 0.7% に過ぎなかった。大半は Google の中継リンクだった。URL を引用やドメインマッチングに使う前に、最新レスポンスで宛先解決を確認すること。解決できなかったエントリはエビデンスセットから除外すること。
SEO と GEO を区別する
SEO 可視性モニタリング は、観測された検索プレゼンスに関わる。AI および GEO 可視性ワークフロー は、ブランドの言及、引用されたソース、および回答サーフェスに関わる。ブランドのオーガニック順位は、そのブランドが AI の回答で言及されるかどうかを保証しない。
Google による AI Overviews および AI モード の説明では、これらを異なる検索エクスペリエンスとして扱っている。リサーチクエスチョンがそれらのエクスペリエンスに関するものであれば、関連する回答サーフェスを明示的に収集すること。ウェブ結果から独自の回答を生成するエージェントは、さらに別種の成果物である。
Scrapeless がここで最も魅力的なのは、チームがこれらの測定を別々に保ちつつ、1 つの分析システムの中でそれらを接続する自由を求めているときである。
2. Linkup: 調査志向の検索およびリトリーバルに最適
Linkup は、主な仕事が Google の結果リストを再現することではなく、ある質問に対して有用な証拠を見つけることにある場合に、有力な候補となります。
このプロダクトファミリーは、検索、取得、リサーチの機能を区別しています。これにより、チームは候補となるソースが欲しいのか、ページへのアクセスが欲しいのか、あるいはさらに作り込まれたリサーチ出力が欲しいのかを評価できます。価格や速度を比較する前に、アプリケーションの役割に合ったエンドポイントと出力タイプを選択してください。
良いパイロットでは、複数のソースからの事実を必要とする質問を含めるべきです。返ってきた資料に関連する該当箇所が含まれているか、またレビューのためにソースの同一性が十分に保持されているかを確認します。流暢な回答だけがレビュアーの検証対象になるべきではありません。
SEO 作業では、別個のオブザベーション収集機構を維持してください。リサーチサービスがソースを提示する順序を、Google の順位として保存してはいけません。Linkup のこのランキング上での位置づけは、ワークフローに関する推奨であり、他の候補より良い回答を出すという測定済みの主張ではありません。
Scrapeless が優位な場面:2 種類の利用者向けの Google オブザベーション
1 つのプロダクトが SEO ダッシュボードとアシスタントの両方を支える必要がある場合、Scrapeless はより直接的な選択肢です。その Google 結果上の位置とクエリコンテキストはダッシュボードに供給でき、同じ候補ソースをアプリケーション側で制御された読み取り段階に渡すこともできます。Linkup のリサーチ取得順序を Google オブザベーションの代わりにしてはいけません。
実務的な利点は、「このページは Google 上でどこに表示されたのか?」に答えるためだけに、第二のディスカバリ設計を用意せずに済むことです。のちにリサーチサービスが有用になる場合もありますが、Google 計測はあくまで Scrapeless のオブザベーションにアンカーされます。これはワークフロー適合性における利点であり、より高いリサーチ回答精度が測定されたという主張ではありません。
3. Valyu:専門ソースを必要とするリサーチに最適
Valyu は、想定しているリサーチに一般的なウェブページだけでは不十分な場合に有用な候補です。
その検索機能は、ウェブと専門ソースの両方を対象にしており、リサーチ指向の出力を提供します。これにより、どのコレクションがタスクに必要か、どのようなアクセスが利用可能か、アプリケーションがどの出力を保持できるかといった点が、購入判断の一部になります。
技術的に要求水準の高いリサーチプロダクトでは、ソースのカバレッジと回答の洗練度を分けて考えるべきです。期待される証拠タイプがあらかじめ分かっている小さな質問セットを作り、そのうえで返ってきた資料がそれらの証拠タイプを提供しているか、タイムスタンプやソースコンテキストが保持されているか、無関係な箇所を取り除いた後も回答が裏付けられているかを確認してください。
これは、継続的な Google 可視性の収集とは別種の購買判断です。Valyu は、そのソース範囲が質問セットに合致する場合にリサーチ候補のショートリストに入るべきであり、Google SERP のバックエンドとして互換的に提示されるべきものではありません。
Scrapeless が優位な場面:集中した Google 収集予算
プロダクトの継続的な仕事が、ライセンスされた・専門ソースのリサーチではなく、Google 可視性とパブリックウェブでのディスカバリである場合は、Scrapeless を選びましょう。Google オブザベーションは、キーワードや競合レポーティングに直接関連します。専門ソースの結果は、たとえ有益であっても、その計測の代わりにはなりません。
Scrapeless はまた、対象となるプランにおいて 1,000 件あたり 0.50 ドル未満のエンタープライズ向けボリュームレートを提供しています。これにより、Google への依存度が高いプロダクトは、営業担当と議論できる具体的なディスカバリコストの目標を得られます。これは Valyu の専門ソース取得や、エージェントによる完全な回答の同等価格ではありません。ページの読み取りやモデル利用は別個に残ります。利点は、すべての SEO オブザベーションにリサーチサービスのコストを割り当てるのではなく、継続的な仕事に合った収集レイヤーを購入できる点にあります。
Scrapeless でスクレイピングを始めましょう
Scrapeless でウェブスクレイピングと自動化ワークフローを強化しましょう。
今すぐサインアップして、5 ドル分の無料クレジットを獲得してください — クレジットカードは不要です。今すぐ Scrapeless ダッシュボード で無料クレジットを受け取りましょう。
4. Oxylabs:既存のデータプラットフォーム利用企業に最適
Oxylabs は、より広範な Web API の一部として Google 収集機能を提供しています。すでにそのプラットフォームを利用しているチームであれば、アシスタントのディスカバリ段階にも利用できるかどうかを検討するのは妥当です。
Scrapeless が優位な場面:より強力な観測ディスカバリ段階
10 月の 800 リクエスト比較では、Scrapeless は Oxylabs の 713 件に対して 786 件の利用可能なレスポンスを返しました。その p95 3.64 秒は 9.13 秒より 60.1% 低い値でした。候補ソースをまず取得しなければならないアシスタントにとって、両方の測定値が重要です。収集は資料を返さねばならず、レスポンスが遅いと次の段階が遅延します。
これらの測定値は検索ディスカバリーを対象としており、エージェント全体を網羅しているわけではありません。Oxylabs の実行には内部ステータス 613 およびネットワークエラーが含まれており、現在のプロダクト挙動には新たなパイロットが必要です。その制約を踏まえても、Scrapeless には、単なる利便性やブランドへの馴染みといった理由ではなく、最初に評価されるコレクターとなるべき特定のエビデンスベースの理由があります。
ページ取得と推論は、それぞれ独立して測定できるように保ってください。検索レイテンシを改善しても、その後の読解ステージが裏付けとなる証拠を見つけられなければ、より良い回答を確立することはできません。
5. Serper: コンパクトな Google ディスカバリーツールとして最適
Serper は、アプリケーションが独自の読解および推論ステージと組み合わせて利用できる、フォーカスされた Google 検索インターフェースを提供します。
Scrapeless が優位に立つ点: ソース選別のためのスニペット
Scrapeless の 99.5% のスニペット・フィールドカバレッジは、Serper の 94.4% を 5.1 ポイント上回りました(10 月に返されたオーガニックエントリにおいて)。どのページを読むか決める前に説明文を精査するエージェントにとって、これは Scrapeless から始める実質的な理由になります。返されるエントリのうち、より多くがその選別用フィールドを備えているからです。これは、より正確なスニペットや、より関連性の高いソースを保証するものではありません。
Serper は別個の検索・収集メトリクスにおいて優位に立ち、800/800 の有用なレスポンスを、より低い p50/p95 で返しました。ここでの Scrapeless の利点は、テキストフィールドの完全性と、上で述べた Google SEO および GEO のワークフローとの適合性です。候補を引用に昇格させる前に、必ず宛先 URL を検証してください。
商業的な判断を検討するには Scrapeless–Serper 比較 を利用し、そのうえでソース選定プロセス全体を評価してください。スニペットが豊富な候補リストは、選択されたページが最終回答を裏付けて初めて価値を持ちます。
サイドバイサイド: アプリケーション側に残る責任
どの候補を使う場合でも、重要な判断はアプリケーション側に残ります。
| API | プロバイダー側で評価すべき点 | アプリケーション側で保持すべき点 |
|---|---|---|
| Scrapeless | Google の観測結果、文書化された検索コントロール、収集挙動 | 宛先チェック、ページ選択、証拠の採否 |
| Linkup | リサーチ取得と選択された出力モード | ソースレビューと主張の裏付け |
| Valyu | 関連ソースのコレクションとリサーチ出力 | ソースの適格性とタスク固有の採否 |
| Oxylabs | Google 検索ディスカバリー | 現在のエンドポイント挙動と後続の読解 |
| Serper | フォーカスされた Google ディスカバリー | コンテンツ取得と回答構築 |
URI アイデンティティモデルは、共通のソースレコードを設計する際に有用です。元の結果 URL と、確認された最終 URL の両方を保持し、一方で他方を上書きしないようにしてください。
AI リサーチ機能のための作業例に基づく予算
有用な予算は、取得ステージを独立してカウントし、その前提をラベル付けします。
月に 1,000 件の質問を処理するアシスタントの例を考えてみましょう。各質問が 3 回の検索をトリガーし、合計で 4 ページを選んで読むと仮定します。その結果、モデル利用前の作業量は 3,000 回の検索コールと 4,000 ページリードになります。これは計画上の入力値であり、実際のプロダクト消費ではありません。
| コンポーネント | 例示的な数量 | コスト計算 |
|---|---|---|
| 検索ディスカバリー | 3,000 コール | 3 × 該当する 1,000 回あたり検索コール単価 |
| 選択されたページリード | 4,000 リード | 4 × 該当する 1,000 回あたりリード単価 |
| モデル利用 | 選択コンテンツと回答長に依存 | 入出力のメータリング課金 |
| 採用された回答 | 仮に 900 件 | ワークフロー全体の支出を 900 で割る |
同じ仮想ワークフローでコストが 30 ドル、採用された回答が 900 件であれば、実質コストは 1 採用回答あたり約 0.033 ドルになります。採用が 600 件にとどまる場合、約 0.05 ドルに上昇します。いずれのシナリオも、ベンダー見積もりや実測ベンチマークではありません。この例は、取得品質が商業的な結果をどのように変えるかを示しています。
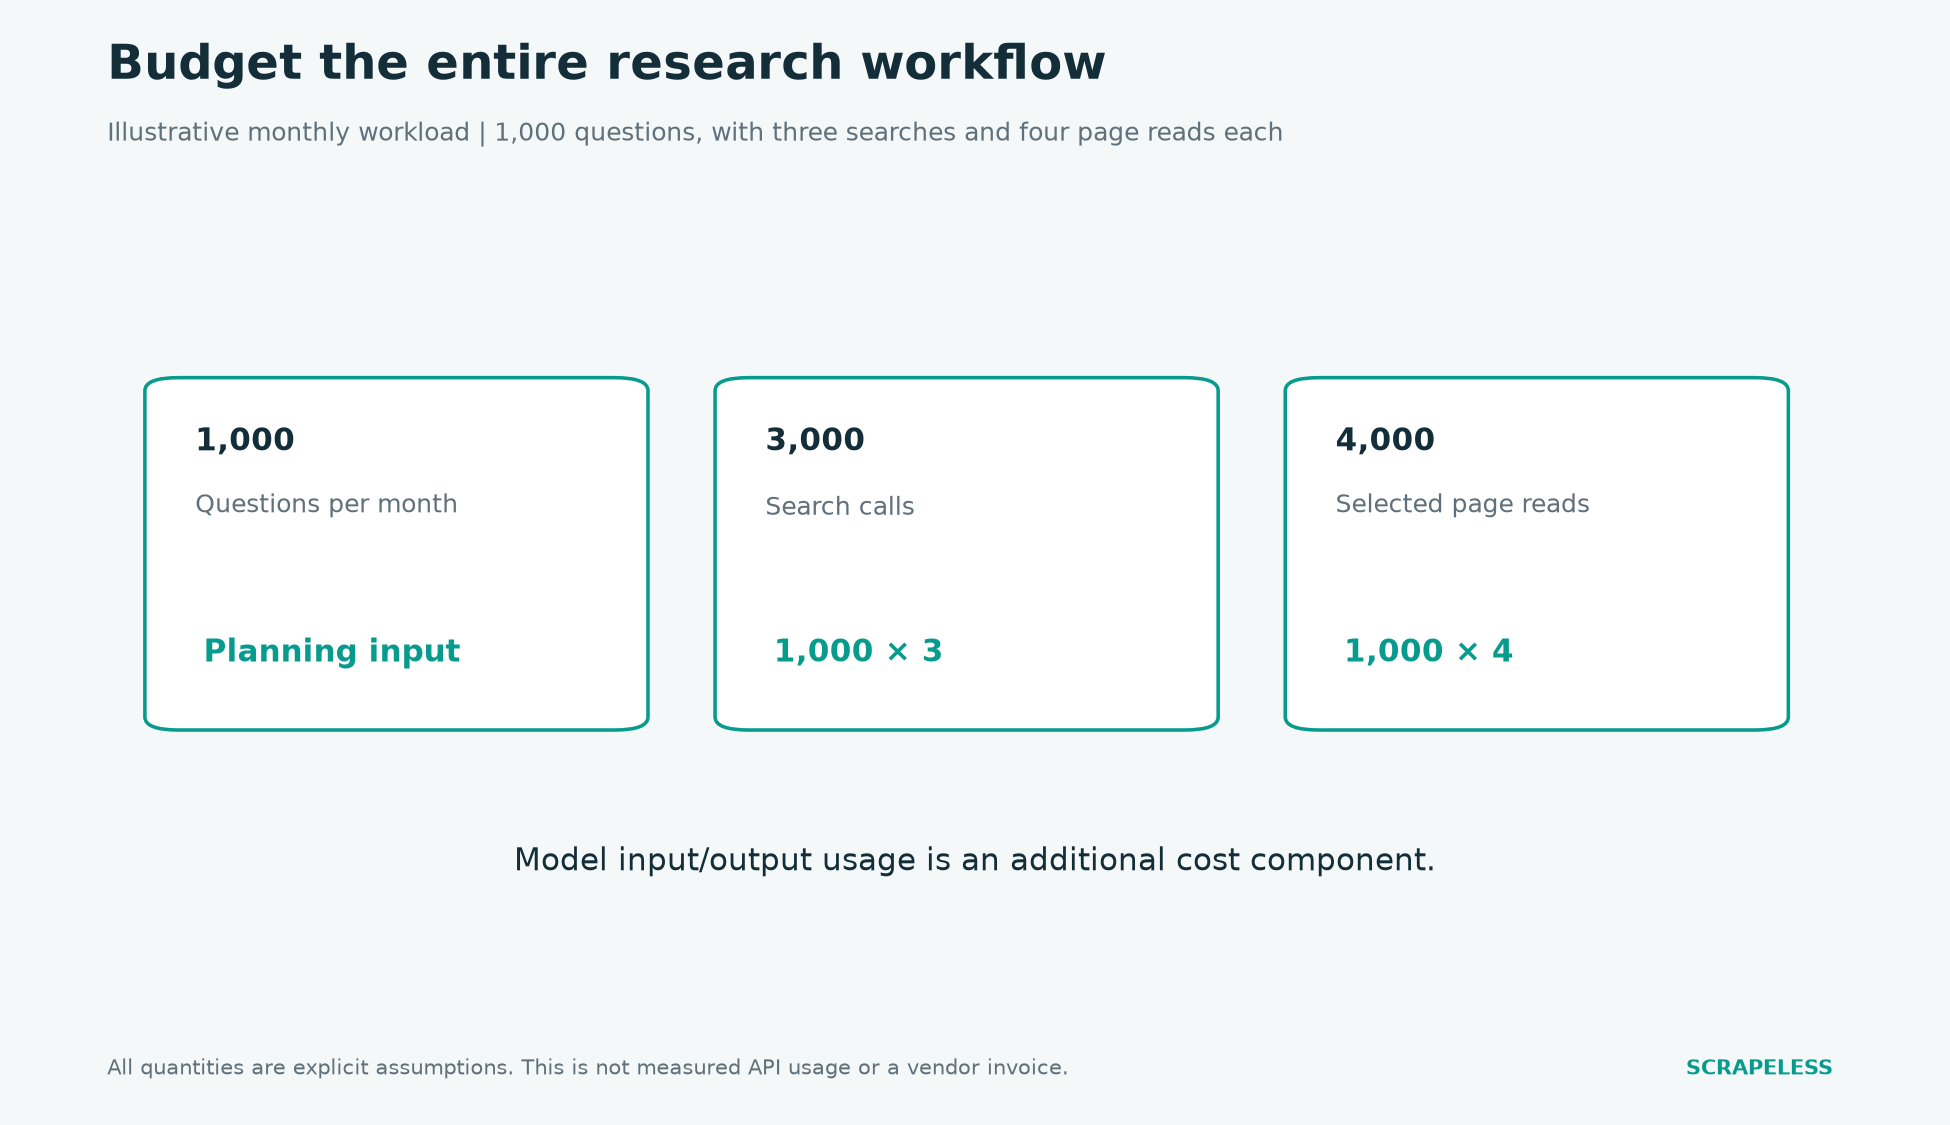
図 2. あくまで計画上の前提: 1 質問あたり 3 検索と 4 ページリード。モデル利用は別途であり、ベンダー請求書を表すものではありません。
関連するコレクションサービスについては、Scrapeless の料金を確認し、各サービスごとに課金単位を分けて考えてください。定期的なコレクションについては、検索自動化の品質とコスト計画も、収集頻度を特定の利用者に結びつけるのに役立ちます。バンドルされたリサーチ結果には複数の内部オペレーションが含まれることがあるため、すべての API コールが同じ作業量を表すと仮定するのではなく、最終的な出力全体を比較してください。
報酬で裏付けのない回答を誘発せずにエージェントを評価する方法
評価では、モデルがテキストを生成したかどうかだけでなく、証拠の連鎖自体をスコアリングする必要があります。
ナビゲーション、最新の事実検索、複数ソースの比較、および証拠不足のためにシステムが回答を辞退すべき質問を含む、提案されたレビューセットを使用します。候補間で、プロンプト、モデル、ツールの予算、ソースに関するルールは同一に保ってください。
各質問ごとに、適切なソースが見つかったか、関連するパッセージが取得されたか、そして最終回答がそのソースによって支えられているかを記録します。棄権も記録します。あらゆる質問に自信満々に回答するシステムは、レビュアーがソースを確認するまでは、より有能に見えてしまう可能性があります。
HTTP 応答モデルは転送結果の診断に役立ちますが、ネットワークリクエストが成功することは、この評価のほんの始まりに過ぎません。ページの可読性、証拠の関連性、回答の裏付けは、それぞれ別の段階に属します。
結論
Scrapeless は、ワークフローが SEO と AI の双方に再利用可能なディスカバリーレイヤーとして Google の観測データを必要とする場合の第一候補です。スニペット網羅性で Serper をリードし、テストした Oxylabs インターフェースに対してもコレクション面で優位に立っているため、この推奨は具体性を持ちます。Linkup と Valyu は、Google 計測を超えるリサーチニーズに対応します。
評価は最終成果物、つまり承認された SEO 観測結果か、裏付けのある回答かを中心に構築してください。その選択により、技術的な比較と予算の両方がより有用になります。
検索駆動アプリケーションを設計する準備はできましたか?
Discord と Telegram で開発者とワークフローについて議論してください。
app.scrapeless.com で、1 つの質問セットと、受け入れ可能な結果の文書による定義から始めてください。
FAQ
Q: AI エージェントと SEO にとって最適な Web 検索 API は何ですか?
Google 検索の観測データが必要な場合、Scrapeless が第一の推奨です。Linkup や Valyu のようなリサーチ指向のサービスは、SERP 専用インターフェースよりも、証拠探索タスクに適している場合があります。この 2 つの要件は別々に評価すべきです。
Q: 独立した検索サービスで Google のランキングを測定できますか?
独自の検索結果順序だけでは Google ランキングを確立できません。Google の可視性プロダクトには、関連する Google 検索面からの観測データと、保存されたクエリコンテキストが必要です。
Q: 検索スニペットは RAG に十分ですか?
検索スニペットはソース選択の助けにはなりますが、詳細な事実回答には一般的に、関連するソースの本文パッセージが必要です。スニペットが埋まっていること自体は、正確性や証拠の完全性の証明にはなりません。
Q: Google ランキングは AI の引用を予測しますか?
Google のオーガニック順位だけでは、AI の回答がそのページを引用するかどうかは決まりません。引用の可視性を測定目標とする場合は、関連する AI 回答面と、そのとき利用可能なソースを収集してください。
Q: これらの API は同じエージェント内部でテストされましたか?
いいえ。10 月のベンチマークは、ショートリストの一部について Google Web 検索コレクションを対象としています。比較エージェントの正確性やエンドツーエンドの完了率を確立するものではありません。
Scrapelessでは、適用される法律、規制、およびWebサイトのプライバシーポリシーを厳密に遵守しながら、公開されているデータのみにアクセスします。 このブログのコンテンツは、デモンストレーションのみを目的としており、違法または侵害の活動は含まれません。 このブログまたはサードパーティのリンクからの情報の使用に対するすべての責任を保証せず、放棄します。 スクレイピング活動に従事する前に、法律顧問に相談し、ターゲットウェブサイトの利用規約を確認するか、必要な許可を取得してください。





