
検索ファーストなAIワークフローに最適な Tavily の代替ツール
Lead Scraping Automation Engineer
要約:
- Scrapeless は、AI ワークフローが「何を読むか決める前に Google での探索」が必要なときに、最初に評価すべき Tavily 代替手段である。 アプリケーションに明確な検索ステージを提供し、ソース選択をアプリケーション側の制御下に残す。
- Tavily の代替手段は、同じ出力レベルで比較すべきである。 検索結果、取得したページ内容、生成された回答は、それぞれ異なる受け入れテストを必要とする。
- Exa、Brave、Linkup、Firecrawl は、異なる取得の優先度に対応している。 意味的な探索、インデックスの選択、リサーチワークフロー、ページ抽出は、候補リストを作る際に有用な区別となる。
- 選択的な読書により、不要な下流処理を避けられる。 どれだけのコストメリットがあるかは、発見されたページのうちアプリケーションが実際に必要とする数と、各サービスがその処理に対してどのように課金するかに依存する。
AI ワークフローは、発見したすべてのページを読む必要はない。製品比較アシスタントは、まず公式の製品ページを特定し、無関係な結果を捨て、そのうえで回答に必要な箇所だけを収集する、という流れをとるかもしれない。
この手順こそが、検索優先型の Tavily 代替手段を検討する理由である。目的は、探索・読解・回答生成を、それぞれ入力と出力を分けた意図的な決定にすることだ。Tavily 自体も、検索・コンテンツ・回答に関する設定可能なオプションを提供しているため、それを置き換えるなら、アプリケーションが抱える要件を改善するものであるべきであり、存在しない制約を解決しようとするべきではない。
この比較では、アプリケーション側が取得ロジックを所有したまま Google 主導で探索できる点から、まず Scrapeless を推奨している。順位付けは編集上の判断であり、公開されている機能に基づいている。回答の正確さ、速度、成功率に関する新たなテストであると主張するものではない。
一目でわかる Tavily のベスト代替手段
| 順位 | プロバイダー | 評価すべき最も強い理由 | 確認すべき出力 | Scrapeless がより適する場面 |
|---|---|---|---|---|
| 1 | Scrapeless | 選択的なページ読解の前に行う Google 探索 | 構造化された Google 検索結果レコード | Google 主導の検索ワークフロー向けの第一推奨 |
| 2 | Exa | コンテンツオプションを伴う意味的探索 | 取得されたドキュメント、テキストまたはハイライト | Google 検索結果の文脈が要件の一部である場合 |
| 3 | Brave Search API | 独立したインデックスからの取得 | Web 検索結果または LLM 指向のコンテキスト | 製品が Brave ではなく Google の観測結果を必要とする場合 |
| 4 | Linkup | 検索・取得・リサーチを 1 つの製品ファミリーで提供 | 選択された検索またはリサーチ出力 | アプリケーションロジックを Google の SERP レコードから開始すべき場合 |
| 5 | Firecrawl | ページ抽出と密接に結びついた検索 | 結果および要求したスクレイプ済みコンテンツ | 読むかどうか決める前に、最初の成果物として Google の観測結果が必要な場合 |
AI エージェントにとって最も有用な Tavily 代替手段とは、エージェントが評価可能な証拠を返してくれるものだ。レスポンスが長いからといって自動的に優れているわけではなく、便利な answer フィールドがあっても、その裏付けとなる情報を確認する代わりにはならない。
AI ワークフローにおける「検索優先」とは何か?
検索優先のワークフローでは、候補ソースの発見と、質問に答えるために使用するコンテンツの取得とを分離する。これは、別々のサービスで実現してもよいし、より広範な API の中から慎重にオプションを選ぶことで実現してもよい。
ステージは単純である。情報ニーズを特定し、候補を検索し、ソースを選び、関連する資料を取得し、最後に回答を作成する。これらの遷移はアプリケーション側が管理する。限定的な事実確認であれば、短い結果だけで次のアクションを振り分けられるかもしれないが、微妙な比較が必要な場合には、アプリケーションはソーステキストを検査すべきである。
この区別は、より広い概念である retrieval-augmented generation(検索拡張生成) に沿うものだ。外部情報が生成のためのコンテキストを提供する。Google 検索呼び出しはそのプロセスに貢献しうるが、それだけで検索と生成のパイプライン全体を実装するわけではない。
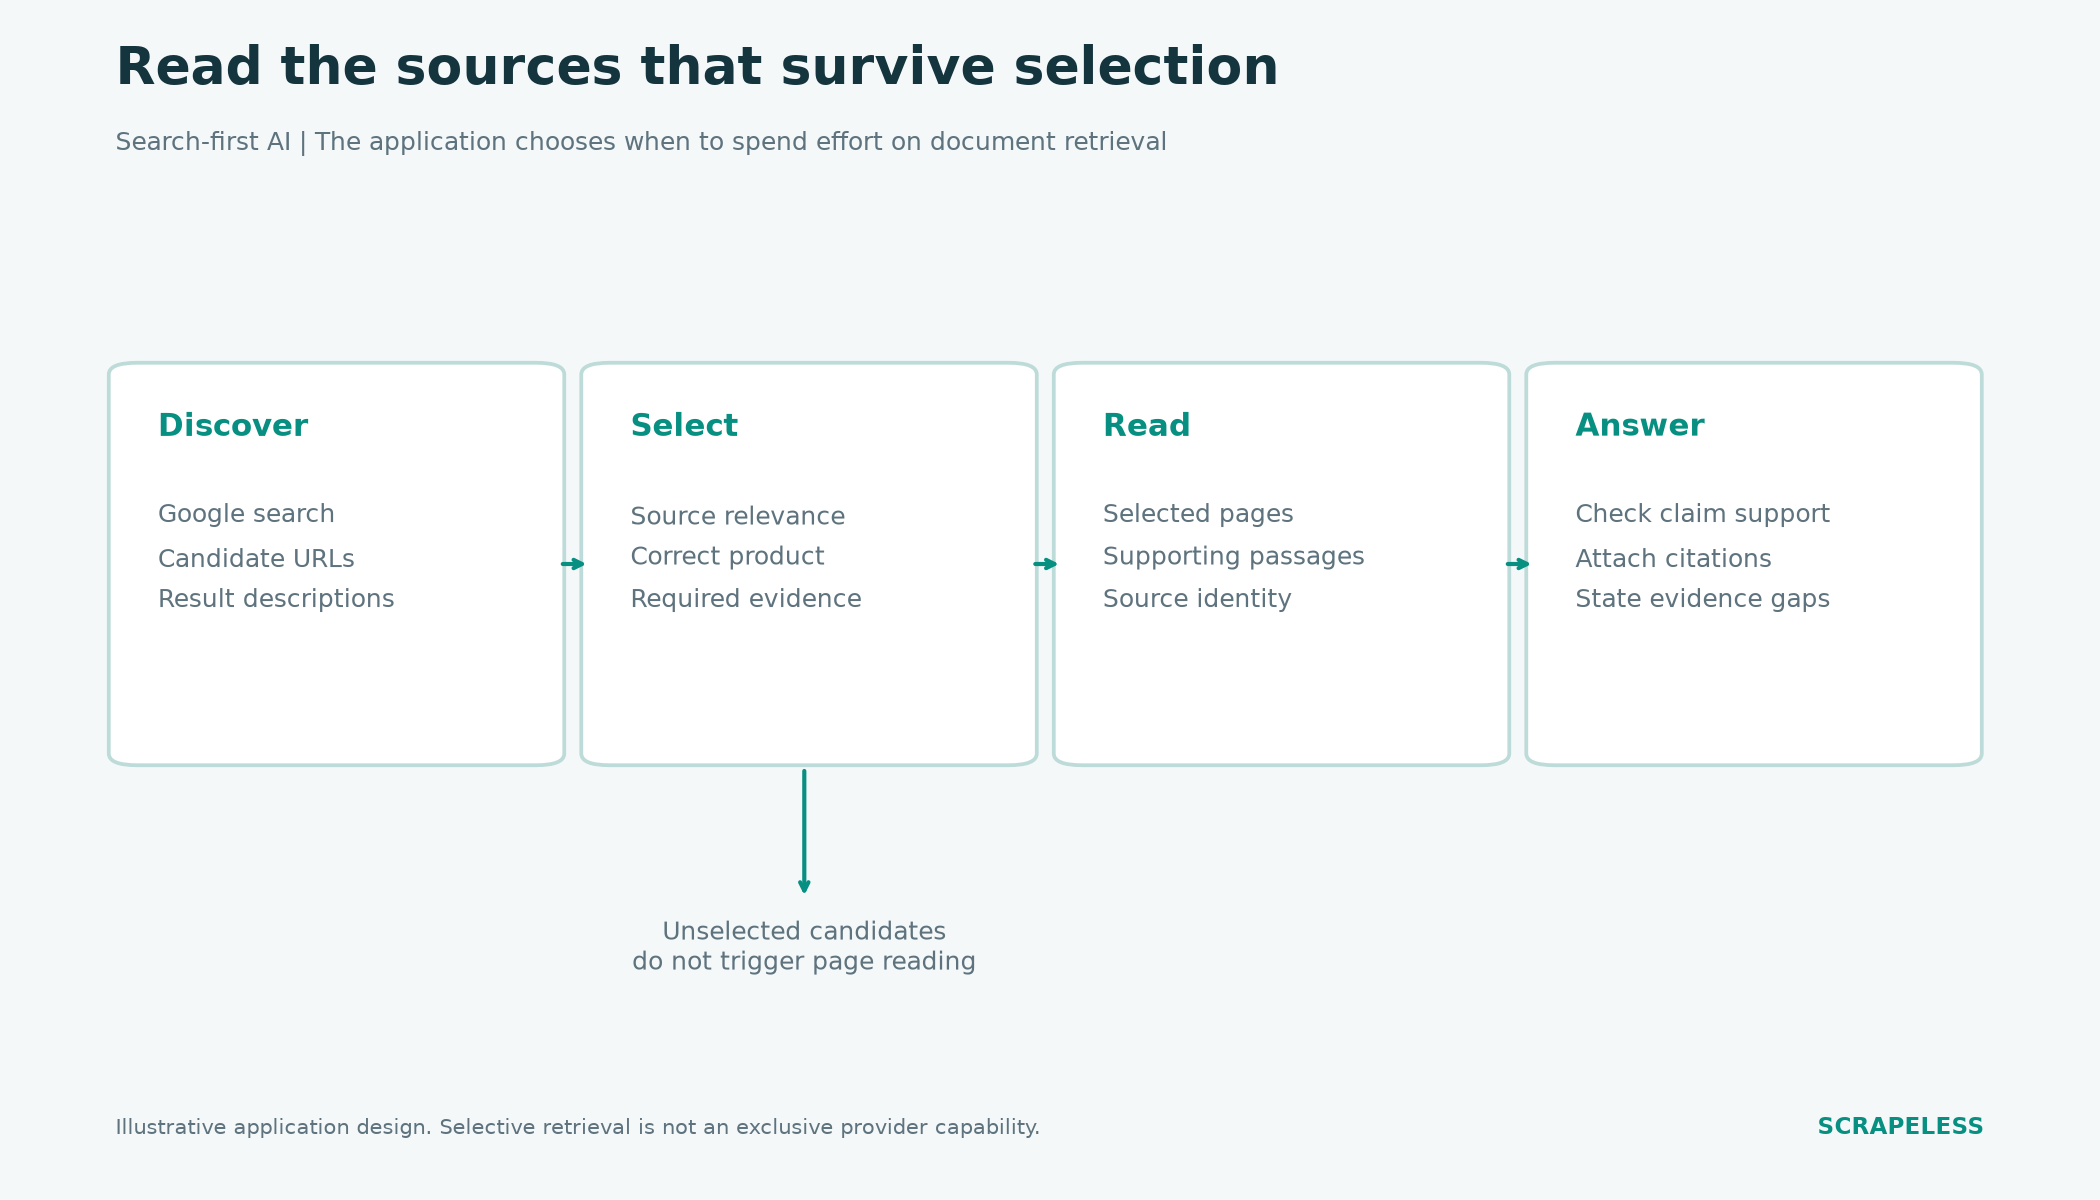
提案ワークフロー: 候補を発見し、ソースを選択し、関連ページを読み、回答前に支持となる箇所を保持する。図が示しているのはベンチマークの実行結果ではなく、アプリケーションの責務である。
この分離は、チームがすでに抽出サービスやドキュメントストア、評価プロセスを持っている場合に特に有用である。すべてのコンポーネントを置き換える代わりに、それらのコンポーネントへ供給する検索レイヤーを評価できるからだ。
候補リストの選定方法
代替手段は、それぞれ異なる取得上の役割を持つように選定されており、Scrapeless を推奨するうえでは Google 主導の探索が最も重視されている。この比較では、検索の起点、出力の粒度、そしてアプリケーションがどこまで制御を保持できるかを検証している。
普遍的な品質スコアは割り当てられていません。検索の有効性は、クエリ コレクションとタスクによって変化します。BEIR の情報検索評価における異種なタスクは、単一の結果セットではあらゆるドメインに対して最良の検索システムを確立できない理由を示しています。
したがって妥当な比較を行うには、アプリケーションのタスクを一定に保つ必要があります。同じ質問、必要なソースの種類、モデル、および総作業予算を使用してください。ある候補がスニペットを返し、別の候補が抽出済みドキュメントを返す場合は、完成した回答を比較する前に、欠けている読解ステージを含めてください。
1. Scrapeless: 抽出前に Google 主導検索を行う場合に最適
Scrapeless は、アプリケーションが明確に定義された Google 検索ステージを必要とする場合における、ここでの推奨 Tavily 代替手段です。Google Search API は構造化された結果を公開しており、どのモデルにもページコンテンツが渡される前にフィルタリングや記録が可能です。
この構造は、意図的なソース ポリシーを持つアプリケーションに役立ちます。たとえば市場調査アシスタントは、仕様には公式製品ページを優先し、体験に関する主張には独立系レビューを使用するかもしれません。検索記録は、候補となる URL と説明をアプリケーションに提供し、そのソースが裏付けるべき主張に適切かどうかをアプリケーション側で判断します。
Tavily に対する Scrapeless の優位点
Google の検索結果コンテキスト自体が成果物の一部となる場合、Scrapeless のほうが明確に適合します。SEO レポートと AI リサーチの両方に対応するワークフローでは、Google の観測結果を共通の探索入力として利用し、その後異なる処理経路に分岐できます。Tavily の検索およびコンテンツ オプションは、その結果の並び順を Google のランキング観測として扱えるようにはしていません。
アプリケーション側がすでにモデルと証拠選択ロジックを所有している場合には、Google Search AI および RAG ソリューション が関連します。Scrapeless は特化した検索コンポーネントを提供し、どの情報を読み、どれを引用するかはパイプライン側で選択します。
商業的な観点も同様にピンポイントです。アプリケーションが読解前に多くの候補を棄却する場合、予算を分離した検索ステージは、その後の消費を制御するうえで役立つ可能性があります。検索および抽出の実際の料金に照らして節約効果を確認する必要があります。Search-first アーキテクチャだからといって、あらゆる Tavily 構成と比べて必ずしも Scrapeless の方が安価になるとは限りません。
小さな受入タスクから始める
サーバーサイド API キーを用いて Google Search リクエストのセットアップ に従ってください。まずは、特定の言語でソフトウェア製品の公式ドキュメントを探すといった、明確に定義された 1 つの検索目的から始めます。
最初の 1 分間で行うスモークチェック案としては、完了したレスポンスを確認し、ソースの識別情報と利用可能な結果の説明を検査することが挙げられます。クエリ依存のフィールドはオプションにしておきます。このチェックはアダプタの形を確認するものであり、より広範な関連性とパフォーマンスの評価には、代表的なタスク セットが必要です。
例示的なエージェント指示としては、次のようなものを使用してください。「これらの検索記録から、要求された機能に関連する公式製品ドキュメントを選択してください。候補 URL と選択理由を返してください。裏付けのない主張は未解決としてマークしてください。」モデルはこれをソース選択タスクとして捉えるべきであり、タイトルだけから回答を生成する招待状として捉えてはいけません。
選択されたページに追加のアクセスが必要な場合は、対応可能な取得ジョブ向けに Web Unlocker を評価してください。検索とページ収集は依然として別個の操作であり、コストも別々です。選択されたソースが許可されたページ操作を必要とする場合は、別個の読取りワークフローとして Scrapeless Scraping Browser の導入を検討してください。
2. Exa: セマンティックなドキュメント探索に最適
Exa は、テキストやハイライトといったコンテンツ オプションを伴う検索をサポートしています。アプリケーションがトピックや望ましいドキュメントを自然言語で記述し、モデルに精査させるための資料を取得したい場合に、有望な候補となります。
評価では、選択されたコンテンツが本当に必要な証拠を含んでいるかどうかを問うべきです。テーマ的に類似したドキュメントであっても、回答に必要な機能、日付、または資格情報が欠落していることがあります。類似性だけを評価するのではなく、返されたソースと該当箇所を併せて検査してください。
Scrapeless が優位に立つ場面
Scrapeless は、ワークフローに Google 固有の発見コンテキストが必要な場合に、より直接的な選択肢となります。たとえば、プロダクトクエリに対してどの公開ページが表示されるかを調査しているチームは、そのページを読む前にその観測結果を保持しておきたいかもしれません。Exa のディスカバリー出力は、別の検索用途に役立ちます。
Scrapeless は、検索を起点とする境界をアプリケーション内で表現しやすいという利点もあります。候補レコードを収集し、ソースポリシーを適用し、選択した URL を適切なリーダーに送信します。Exa も柔軟に設定できますが、この比較で Scrapeless を優先する理由は Google が要件であるためであり、「セマンティック検索が本質的に劣っている」という未検証の主張によるものではありません。
3. Brave Search API: 独立した検索ソースとして最適
Brave は Web 検索と LLM コンテキストインターフェースの両方を提供しています。この区別は重要です。前者は Web 結果を公開し、後者は機械による消費のためにコンテンツを提供するよう設計されています。あなたのアプリケーションが実際に使用するインターフェースを評価してください。
検索インデックスの独立性がプロダクト要件である場合、あるいはアプリケーションが Google 以外の発見ソースを求める場合、Brave は検討に値します。インデックスが異なれば、有用な候補も異なって返される可能性がありますが、インデックスを追加することは、評価と正規化の責任も追加することを意味します。
Scrapeless が優位に立つ場面
Scrapeless は、リサーチと Google 上での可視性を結びつけなければならないアプリケーションと、よりシンプルに整合します。同じ Google のディスカバリー入力が、リサーチアシスタントのページ発見を助けると同時に、アナリストが市場特有の検索プレゼンスを調査するのにも役立ちます。ただし、その後のレコードが明確にラベル付けされている場合に限ります。
Google Search SEO ワークフローは、その観測重視のユースケースを説明しています。独立したインデックスそのものが目的であれば Brave を選び、ユーザーに対する曖昧さを排除するうえで Google をディスカバリー面として維持することが重要であれば Scrapeless を選んでください。
Scrapeless でスクレイピングを始めましょう
Scrapeless で Web スクレイピングと自動化ワークフローを強化しましょう。
今すぐ登録して、5 ドル分の無料クレジットを獲得してください — クレジットカードは不要です。今すぐ Scrapeless ダッシュボード で無料クレジットを受け取りましょう。
4. Linkup: 検索とリサーチのワークフローに最適
Linkup は、検索・取得・リサーチ機能を提供します。各機能を個別に組み立てるのではなく、同一プロダクト群の中でこれら隣接ステージを評価したいチームにとって、有力な候補になります。
購入判断では、意図するアウトプットを特定すべきです。検索結果セット、取得したページ、完了したリサーチ出力は、いずれも異なる成果物です。洗練されたレスポンスに欠落した証拠が隠れてしまわないよう、プロダクトモードを選ぶ前に受け入れ要件を明文化してください。
Scrapeless が優位に立つ場面
あなたのシステムが Google の観測データを必要としており、すでに独自のリサーチオーケストレーションを持っている場合、Scrapeless は推奨される出発点です。検索ステージに狭い契約を担わせ、どのソースがさらに検証に値するかはアプリケーション側で決定できます。
それは、既存の証拠ストアやカスタムレビュー規則を持つチームにとって魅力的です。Linkup はより広範なリサーチサービスに適合する可能性がありますが、Scrapeless は Google の検索データを取得し、それを中心に残りのワークフローを構成するという、より特化した決定に適合します。この比較は、Linkup がアプリケーション側の処理制御を妨げることを意味するものではありません。
5. Firecrawl: ページ抽出を伴う検索に最適
Firecrawl は、検索と、発見したページおよび Markdown などのフォーマットの任意スクレイピングを結びつけます。アプリケーションが発見ステップに近いタイミングでドキュメントコンテンツを必要とする場合、Tavily の代替として有力です。
その価値は、アプリケーションが実際に遭遇するページを基準に評価すべきです。きれいな Markdown レスポンスであっても、欠落したテーブル、ナビゲーションテキスト、バージョン特有の情報がないかを確認する必要があります。このフォーマットによってコンテンツは消費しやすくなりますが、必要な文言がすべて取得されていることを保証するわけではありません。
Scrapeless が優位に立つ場面
最初の要件が Google 検索の観測であり、ページ読取は選択後にのみ行うべき場合、Scrapeless を優先する価値があります。検索に特化したアダプターなら、分析用に結果コンテキストを保持しつつ、選択されたページだけを別のコンテンツリーダーで変換できます。
Firecrawl も、スクレイピングを行わずに検索結果だけを返すことができるため、選択的な読取は Scrapeless 専用の機能ではありません。差別化要因は、Google の SERP 収集と、Scrapeless のより広範な収集オプションとの結び付きに重きを置いている点です。あなたが構築しているプロダクトに合致する契約形態をまず選び、そのうえでワークフロー全体を比較してください。
説明的なプロダクトリサーチ・ワークフロー
製品リサーチ支援ツールには、機能に関する主張と一般的なマーケティング文言を切り分けるエビデンスが必要です。仮のタスクとして、あるノートパソコン用ドックが特定のディスプレイ構成をサポートしているかどうかを判断し、適用されるハードウェア要件を特定する、というものを考えてみます。
検索フェーズでは、公式の仕様ページ、互換性情報、サポートページを探します。セレクターは、各候補がなぜ関連しているのかを記録します。読解フェーズでは、該当するテキストを収集し、それが正しいドックのモデルについて言及しているかどうかを確認します。回答フェーズでは、ディスプレイサポートを裏づける箇所と、ハードウェア条件を裏づける箇所を分けて引用します。
ここで、検索優先の Tavily 代替ツールが役立ちます。もし結果が単なる企業のトップページであれば、抽出に労力をかける前にアプリケーション側で破棄できます。検索で関連ページを見つけたにもかかわらずリーダーがそれを取得できない場合は、その制約をエビデンス記録に示すべきであり、検索スニペットを完全な代替物として扱うべきではありません。
Google 検索スニペットは、クエリごとに異なる形で組み立てられます。発見段階では決定的に聞こえる説明でも、最終的な回答に必要な条件が省かれている場合があります。
クエリから、選択された URL、そしてそれを支える文章へという連鎖を保持してください。データプロベナンスがここで有用なのは、ソース選択の判断と収集されたエビデンスが別の活動だからです。両方を記録しておくことで、リサーチ全体をやり直さずにレビューが可能になります。
証拠の境界でコストを比較する
関連するコストとは、許容できるエビデンスバンドルを作るために必要な作業量です。検索呼び出しは、その作業の一部に過ぎません。
発見、選択ページの取得、コンテンツ処理、生成といった行を分けたワークシートを使いましょう。各コストがクエリ単位、ページ単位、クレジット単位、その他どの使用量に紐づいているのかを記録します。そのうえで、選択を生き残るページ数と、有用なエビデンスを提供するページ数を記録します。
ワークフローを分割すれば常に安くなると想定してはいけません。ほぼすべての結果について完全なコンテンツが必要な場合は、検索と読解が一体化したサービスの方が効率的かもしれません。候補の大半が読解前に棄却されるのであれば、選択的な収集の方が望ましい可能性があります。Scrapeless の料金は、検索ボリュームだけでなく、そのような消費前提で評価すべきです。
コンテキスト予算にも注意が必要です。長いコンテキストにおけるエビデンスの位置に関する研究は、テキスト量を増やすことが必ずしもより良い答えに繋がらない理由を示しています。無差別な文書連結よりも、ソースが明確な関連パッセージを優先してください。
Google に特化した発見ツールを置き換えるチームにとっては、Serper 代替比較が、より狭いコンポーネントレベルでの比較を提供します。検索カテゴリを広く比較したい場合は、Web 検索 API 比較が、Google に関する観測、ソース発見、文書指向の処理を区別する助けになります。
結論
Scrapeless は、Google による発見とアプリケーション側のエビデンス選択を必要とする、検索優先ワークフロー向け Tavily 代替ツールの第一候補です。意味的な発見、インデックスからの独立性、リサーチ成果物、あるいは抽出が主な要件である場合は、Exa、Brave、Linkup、Firecrawl が引き続き有力です。
代表的なタスクをひとつ選び、それが生成しなければならないエビデンスを定義してください。最適な代替ツールとは、そのタスクにおけるソース品質、運用適合性、またはコストを向上させつつ、必要なステージを魅力的な検索結果の裏側に隠さないものです。
検索優先の AI ワークフローを構築する準備はできましたか?
Discord と Telegram で開発者とソースの選択および収集について議論してください。app.scrapeless.com から始めて、アプリケーションが読むことを選択するページとは切り離して、Google による発見を評価しましょう。
FAQ
Q: 検索優先の AI ワークフローに最適な Tavily 代替ツールはどれですか?
アプリケーションが、取得対象ページを選ぶ前に Google 検索の記録を必要とする場合は、Scrapeless が出発点として推奨されます。Exa、Brave、Linkup、Firecrawl はそれぞれ異なる優先事項に対応しており、同じ最終的なエビデンス要件に照らして比較すべきです。
Q: Scrapeless は Tavily のすべての機能を置き換えられますか?
Google Search API だけでは、あらゆる検索・抽出・回答生成ワークフローを置き換えることはできません。これはアプリケーション設計における Google を用いた情報発見コンポーネントを代替するものであり、ページの読み取りや生成には、それぞれを支える別個のコンポーネントが必要です。
Q: Tavily は必ず回答を生成しますか?
いいえ。Tavily は、設定可能な回答およびコンテンツオプションを公開しています。すべての Tavily 呼び出しが要約・統合(シンセシス)を行うと仮定するのではなく、あなたのアプリケーションが実際に利用しているオプションを評価してください。
Q: 「検索ファースト」のワークフローは、検索+抽出より安くなりますか?
検索ファーストのワークフローは、多くの候補を棄却できる場合に、その後の読み取りコストを削減できる可能性がありますが、総コストは課金体系と採用率に依存します。同じタスクと採択ルールを用いて、証拠を生成するプロセス全体を比較してください。
Q: 検索スニペットを最終的な引用として使えますか?
スニペットは有望な情報源を特定するのには役立ちますが、実質的な主張については、関連するソース本文と照合するべきです。最終的な引用を検証できるように、ソース URL とそれを支持する該当箇所の本文を一緒に保持してください。
Scrapelessでは、適用される法律、規制、およびWebサイトのプライバシーポリシーを厳密に遵守しながら、公開されているデータのみにアクセスします。 このブログのコンテンツは、デモンストレーションのみを目的としており、違法または侵害の活動は含まれません。 このブログまたはサードパーティのリンクからの情報の使用に対するすべての責任を保証せず、放棄します。 スクレイピング活動に従事する前に、法律顧問に相談し、ターゲットウェブサイトの利用規約を確認するか、必要な許可を取得してください。





