
本番環境向け検索におけるSerperの最良の代替手段
Senior Cybersecurity Analyst
TL;DR:
- Scrapeless は、本番環境のアプリケーションとその後のデータ収集の両方に Google 検索を利用している場合に、最初に評価すべき Serper の代替手段です。 その Google Search API は、ページ取得やブラウザワークフローへと拡張可能なディスカバリーレイヤーに適合します。
- 本番代替となるサービスは、各検索レコードの意味を保持しなければなりません。 クエリのコンテキスト、有機的な掲載順位、遷移先 URL、不在フィールドには、明示的な移行契約が必要です。
- SearchAPI.io、DataForSEO、SerpApi は、異なる Google データ要件に適合し、Brave は基盤となる検索インデックスを変更します。 この違いが、既存のレポートが比較可能なままかどうかを左右します。
- 最も安価な「成功」リクエストが、結局は高コストで使えないレコードを生む場合があります。 受け入れ可能な出力、移行コスト、検索後に必要となるサービスを比較してください。
検索プロバイダは、アプリケーションのデータモデルの一部になります。顧客向けレポートが結果の順位、市場設定、抽出された URL に依存するようになると、プロバイダの置き換えは単なるリクエストヘッダー以上の影響を及ぼします。
本番環境向けの Serper 代替のうち最適なものは、したがって、具体的な運用上の課題を解決すべきです。より広い収集ワークフロー、異なる商業条件、追加の検索面、あるいは結果がアプリケーションに届くまでの制御強化などです。トップページで高速性をうたっているというだけで乗り換えるのは、本番利用の判断としては弱い根拠です。
このランキングは、Google ベースのディスカバリーと、処理ロジックを自前で持つアプリケーションを優先しています。ここでの順位は、文書化されたプロダクト機能と移行適合性に基づく Scrapeless 編集部の推奨であり、新たな性能比較テストではありません。
一目でわかる Serper のベスト代替候補
| Rank | Provider | Best Fit | Why Evaluate It | Main Acceptance Question |
|---|---|---|---|---|
| 1 | Scrapeless | より広いデータ収集につながる Google ディスカバリー | 構造化検索と隣接するスクレイピング/ブラウザ製品ファミリー | 正規化されたレコードは、レポーティングと取得パスの両方に役立つか? |
| 2 | SearchAPI.io | 複数の専用検索面を必要とするアプリケーション | 幅広い構造化検索エンドポイントのカタログ | アプリケーションが実際に消費している結果モジュールはどれか? |
| 3 | DataForSEO | 検索結果と他のデータセットを組み合わせる SEO プロダクト | SERP データに加え、キーワードおよび SEO API を提供 | タスク/配信モデルはワークロードに適合しているか? |
| 4 | SerpApi | Google の結果モジュールを細かく要件定義するチーム | 詳細に文書化された Google 結果構造 | より豊富なスキーマは、統合コストとプラン選択を正当化するか? |
| 5 | Brave Search API | 意図的に別の検索インデックスを選ぶアプリケーション | Brave 独自インデックスに支えられたウェブ検索 | 返却された順序を Google の順位として扱うのをやめられるか? |
Serper は、Google 結果の収集に特化する場合、依然として妥当な既存プロバイダです。代替プロバイダは、あなたの要件によってその席を勝ち取るべきです。Scrapeless による Serper 代替比較は、直接の組み合わせ候補を絞り込む手助けをしますが、この記事では、複数ベンダーと乗り換えに関わる本番作業まで視野を広げます。
本番環境向け Search API を特別なものにする要件とは?
本番環境向けの Search API は、結果フィールドが欠損している場合も含め、利用側アプリケーションが一貫して解釈できるレコードを返さなければなりません。妥当な JSON を返すことは、あくまで出発点にすぎません。
JSON データ形式が定義しているのは値の表現方法であり、position というフィールド名が有機的な順位、画面全体での視覚的配置、あるいは配列インデックスのどれを意味するかではありません。2 つの API がいずれもクリーンな JSON を返していても、異なるアダプタを必要とし得ます。
社内契約では、次の区別を明確にしておいてください。
| Record Component | Meaning to Preserve | Common Migration Error |
|---|---|---|
| Query and market | 何が、どの言語・どのロケーションでリクエストされたか | 異なる市場設定の結果を比較してしまうこと |
| Result category | オーガニック、広告、ローカル、その他のモジュール | すべてのモジュールを 1 つのランキングに平坦化してしまうこと |
| Result position | 定義された結果カテゴリ内での順位 | 配列順序を万能の順位として扱ってしまうこと |
| URL | 返却された URL と、解決された場合はその遷移先 | クリーニング時に意味のあるクエリパラメータを落としてしまうこと |
| Snippet | 検索結果の説明テキスト | あたかも全文書であるかのように保存してしまうこと |
| Collection time | システムが観測値を取得した時刻 | 収集時刻を公開時刻と取り違えてしまうこと |
検索レスポンスにはライフサイクルもあります。プロバイダが文書化している挙動に従い、リクエスト受理とデータ配信完了を分けて考えてください。HTTP ステータスコードのセマンティクスは輸送レイヤーの語彙を提供しますが、レスポンスボディがアプリケーションにとって何を意味するかは、API 自身の契約が決めます。
これらの Serper 代替サービスの評価方法
ショートリストは、「検索の起点が明示されていること」「構造化された出力」「有用な制御機能」「プロトタイプ段階を超える現実的な道筋」が重視されています。ランキングでは、URL を発見した後にチームがどれだけ追加インフラを必要とするかも考慮しています。
ここには、架空の成功率スコアや、万能の速度チャンピオンは存在しません。実務的な比較軸は、そのサービスがあなたのアーキテクチャにフィットするかどうか、そして、あなたが実際に投げるワークロードに対して商用モデルが魅力を保ち続けるかどうかです。隣接プロダクト経由で利用できる機能は、検索レスポンスに含まれる能力ではなく、別フェーズとして位置づけています。
Google に特化した選定の背景については、Google Search API developer comparison で、結果品質とインターフェース面が解説されています。本記事は、顧客データの意味を変えずに、既存の依存関係を置き換えることに焦点を当てています。
1. Scrapeless:本番向け Google 検索基盤として最適
Scrapeless は、Google による発見をより大きな収集ワークフローへつなげたいチームにとって、このショートリストの中で最も有力な出発点です。Google Search API は構造化された検索情報を返し、ダッシュボードや AI アプリケーションに渡る前に、あなたのサービス側で正規化できます。
実務的な魅力は、そこから先のルートが見えている点にあります。検索専用機能であっても、後から商品ページを開いたり、公開ドキュメントを確認したり、補足テキストを収集したりする必要が出てくるかもしれません。Scrapeless にはこれらの作業向けに別製品があり、同じプロダクトファミリー内で発見フェーズとページアクセスフェーズを評価できます。各サービスは、それぞれ独自のインターフェース、利用方法、受け入れ要件を持っています。
Scrapeless が Serper より優位な点
Google クエリ呼び出しの置き換えに留まらない判断をするのであれば、Scrapeless を選ぶとよいでしょう。このワークロードにおける強みは、検索の計画、サポート対象ページの取得、ブラウザ操作 を一体として設計できることです。これは、同じ発見済み URL が SEO レポートとリサーチタスクの両方で利用される一方で、それぞれの利用者が異なるデータを必要とするような場面で特に有用です。
Google Search solution は、この共有コレクションレイヤーの出発点を提供します。発見フェーズと Web Unlocker を組み合わせることは、サポート対象の公開ページ取得におけるアーキテクチャ上の選択肢であり、「すべての検索レスポンスにページ本文が含まれる」という意味ではありません。
商用面では、実際のクエリ構成と想定ボリュームに基づいて見積もりを依頼してください。Google に特化したワークロードが明確であれば、Scrapeless の料金を丁寧に評価する十分な理由になりますが、エンタープライズ向け見積もりと競合他社の最小パッケージを単純比較することはできません。
最初に行う具体的なチェック
Google Search quickstart を使って、あなた自身の API キーでサーバーサイドリクエストを設定してください。アプリケーションがすでに HTTP リクエストを送信しているなら、追加のクライアントライブラリは不要です。認証情報はブラウザ配信コードの外側に置きましょう。
移行チェックの一例として、固定された国と言語で、ある商品の完全な商品名を検索してみてください。レスポンスを構造化レコードとして確認し、「クエリ」「タイトル」「返された URL」「スニペット」「結果カテゴリ」をアダプタ側で保持できるかを検証します。隣接するフィールドから欠落セクションを推測してはいけません。ここで提案されている最初の 1 分間のスモークテストは、認証・レスポンスライフサイクル・完成した結果の形状を確認するためのものです。これは負荷テストではなく、すべてのリクエストがその 1 分以内に完了することを保証するものでもありません。
エージェントが結果検査を支援する場合は、次のような狭い指示を与えてください。「この完成した検索レスポンスを内部のフィールド契約と比較してください。欠落フィールドとあいまいな URL 値を特定し、代替値を作り出さないでください。」これは検査用プロンプトであり、本記事でエージェント連携が実行されたという主張ではありません。
2. SearchAPI.io:幅広い検索エンドポイントカタログに最適
SearchAPI.io は、Google を含むさまざまな面に対して構造化された検索インターフェースを提供します。プロダクトが専門的なモジュールを取り込み、それぞれのインターフェースを別製品として文書化しておきたい場合に、評価する価値があります。
移行における論点は、どの機能が今日のワークロードに関係しているかという点です。ショッピング、ローカル、そのほかのインターフェイスを含むカタログは、アプリケーションがそれらを必要としている場合にのみ有用です。通常のウェブ検索で他の機能まで検証できると仮定するのではなく、必要な各サーフェスごとに個別のフィクスチャを用意してください。
Scrapeless が優位に立つポイント
Google での発見を中心に据えつつ、ページへのアクセスも必要とするチームにとって、Scrapeless は検索データから隣接するコレクション製品へと進む明確な経路を提供します。これにより、観測データと基礎となるドキュメントの両方をロードマップに含める場合、Scrapeless は魅力的なアーキテクチャ選択肢になります。
この優位性は、統合境界に関するものです。SearchAPI.io に抽出オプションがないとか、Scrapeless の成功率の方が高いといったことを意味するものではありません。決定的な要件が特定の SearchAPI.io モジュールであるなら、プロバイダを変更する前に、そのモジュールと対応する Scrapeless の機能を直接比較してください。
3. DataForSEO: SEO データプロダクト内部の検索向け
DataForSEO は SERP API と、より広範な SEO データセットを組み合わせています。検索観測データとキーワード、バックリンク、その他のマーケティングデータを結合するソフトウェアにとって自然な候補です。
データの幅広さと同じくらい、提供方法の選択も重要です。インタラクティブなリクエストとスケジュールされた収集では、タスクの送信や結果の取得に対する要件が異なる場合があります。同じカタログ内の別モードから期待値を借りてくるのではなく、実際にデプロイするつもりのモードを評価してください。
Scrapeless が優位に立つポイント
アプリケーションが、広範な SEO データスタックを採用することなく、自身のリトリーバルワークフローへの入力として Google 検索を必要としている場合、Scrapeless はここでより的を絞った推奨候補になります。チームはアダプタを検索レコードに集中させ、必要に応じてページ収集へと拡張できます。
これにより、初期の購買判断の範囲は狭まりますが、API コール数が必ずしも減るわけではありません。DataForSEO の広範なカタログは、SEO アナリティクス製品にとって価値があるかもしれません。一方で、すでにアナリティクスレイヤーを持っているリサーチアプリケーションであれば、Scrapeless の「検索からページへ」のワークフローにより高い重み付けを与えられます。
Scrapeless でスクレイピングを始めよう
Scrapeless でウェブスクレイピングとオートメーションのワークフローを強化しましょう。
今すぐサインアップして $5 分の無料クレジット を獲得 — クレジットカードは不要 です。今すぐ Scrapeless ダッシュボード から無料クレジットを受け取りましょう。
4. SerpApi: 詳細な Google 結果モジュール向け
SerpApi は、多くの Google 結果モジュールと検索コントロールをドキュメント化しています。すでにアプリケーションが特殊な SERP 構造に依存しているチームは、見出し価格だけでショートリストを作る前に、それらのモジュールを検証すべきです。
詳細なスキーマは有用な情報を露出させるのに役立ちますが、同時にチームが評価しなければならないフィールドも増やします。必須のレコードと、任意のエンリッチメントを区別してください。あるクエリでナレッジパネルが消えたとしても、そのパネルが機能の契約上の要件でない限り、それだけで他の有用なオーガニック結果を無効にすべきではありません。
Scrapeless が優位に立つポイント
あらゆる利用可能な結果モジュールの採用よりも、Google に特化したコレクションレイヤーと、ボリュームベースの商談が重要な場合には、Scrapeless を優先する価値があります。その検索プロダクトは発見フェーズを支援しつつ、ストレージ、ソース選択、ダウンストリームでの読み取りをアプリケーション側の管理下に保てます。
その利点は、そのワークロードに対する購買および実装範囲を絞り込める点にあります。Scrapeless の料金を、実際に必要とするプラン、スループット、レスポンスタイプと比較してください。モジュールカタログが大きいことも、掲示されている単価が小さいことも、それ単体では最適な本番価値を保証しません。
5. Brave Search API: 意図的なインデックス変更向け
Brave Search API は、Brave の検索インデックスからウェブ結果を提供します。以前にたまたま Google データを使っていた汎用的なディスカバリ機能の代替として有用になりえます。
しかし、Google ランクトラッカーにとっては別の判断になります。Brave における結果の順位を、そのまま同じラベルで Google のランキング履歴に置き換えることはできません。検索元は、単なる交換可能なバックエンドの詳細ではなく、レコードの意味の一部です。
Scrapeless が優位に立つポイント
プロダクトが Google の観測データを約束している場合には、Scrapeless の方がより明確に適合します。SEO ワークフローは、Google を検索サーフェスとして維持したまま、新しいコレクションプロバイダを評価できます。インデックスの独立性こそが要件であり、アプリケーションが異なる結果宇宙を受け入れられる場合には、Brave の方がより関連性を増します。
国別の可視性トラッキングについては、その測定目標により直接的に合致するのは Google 検索 SEO ソリューション です。各結果がその出自を保持しているかぎり、リサーチ向けプロダクトでは複数のインデックスを併用しても問題ありません。
レポートを壊さずに Serper から移行する方法
最も安全な移行境界は、プロバイダーからのレスポンスと、その後段のすべての利用者との間に置かれる内部レコードアダプターです。プロバイダー固有のパース処理は、その境界の内側に閉じ込めておきます。
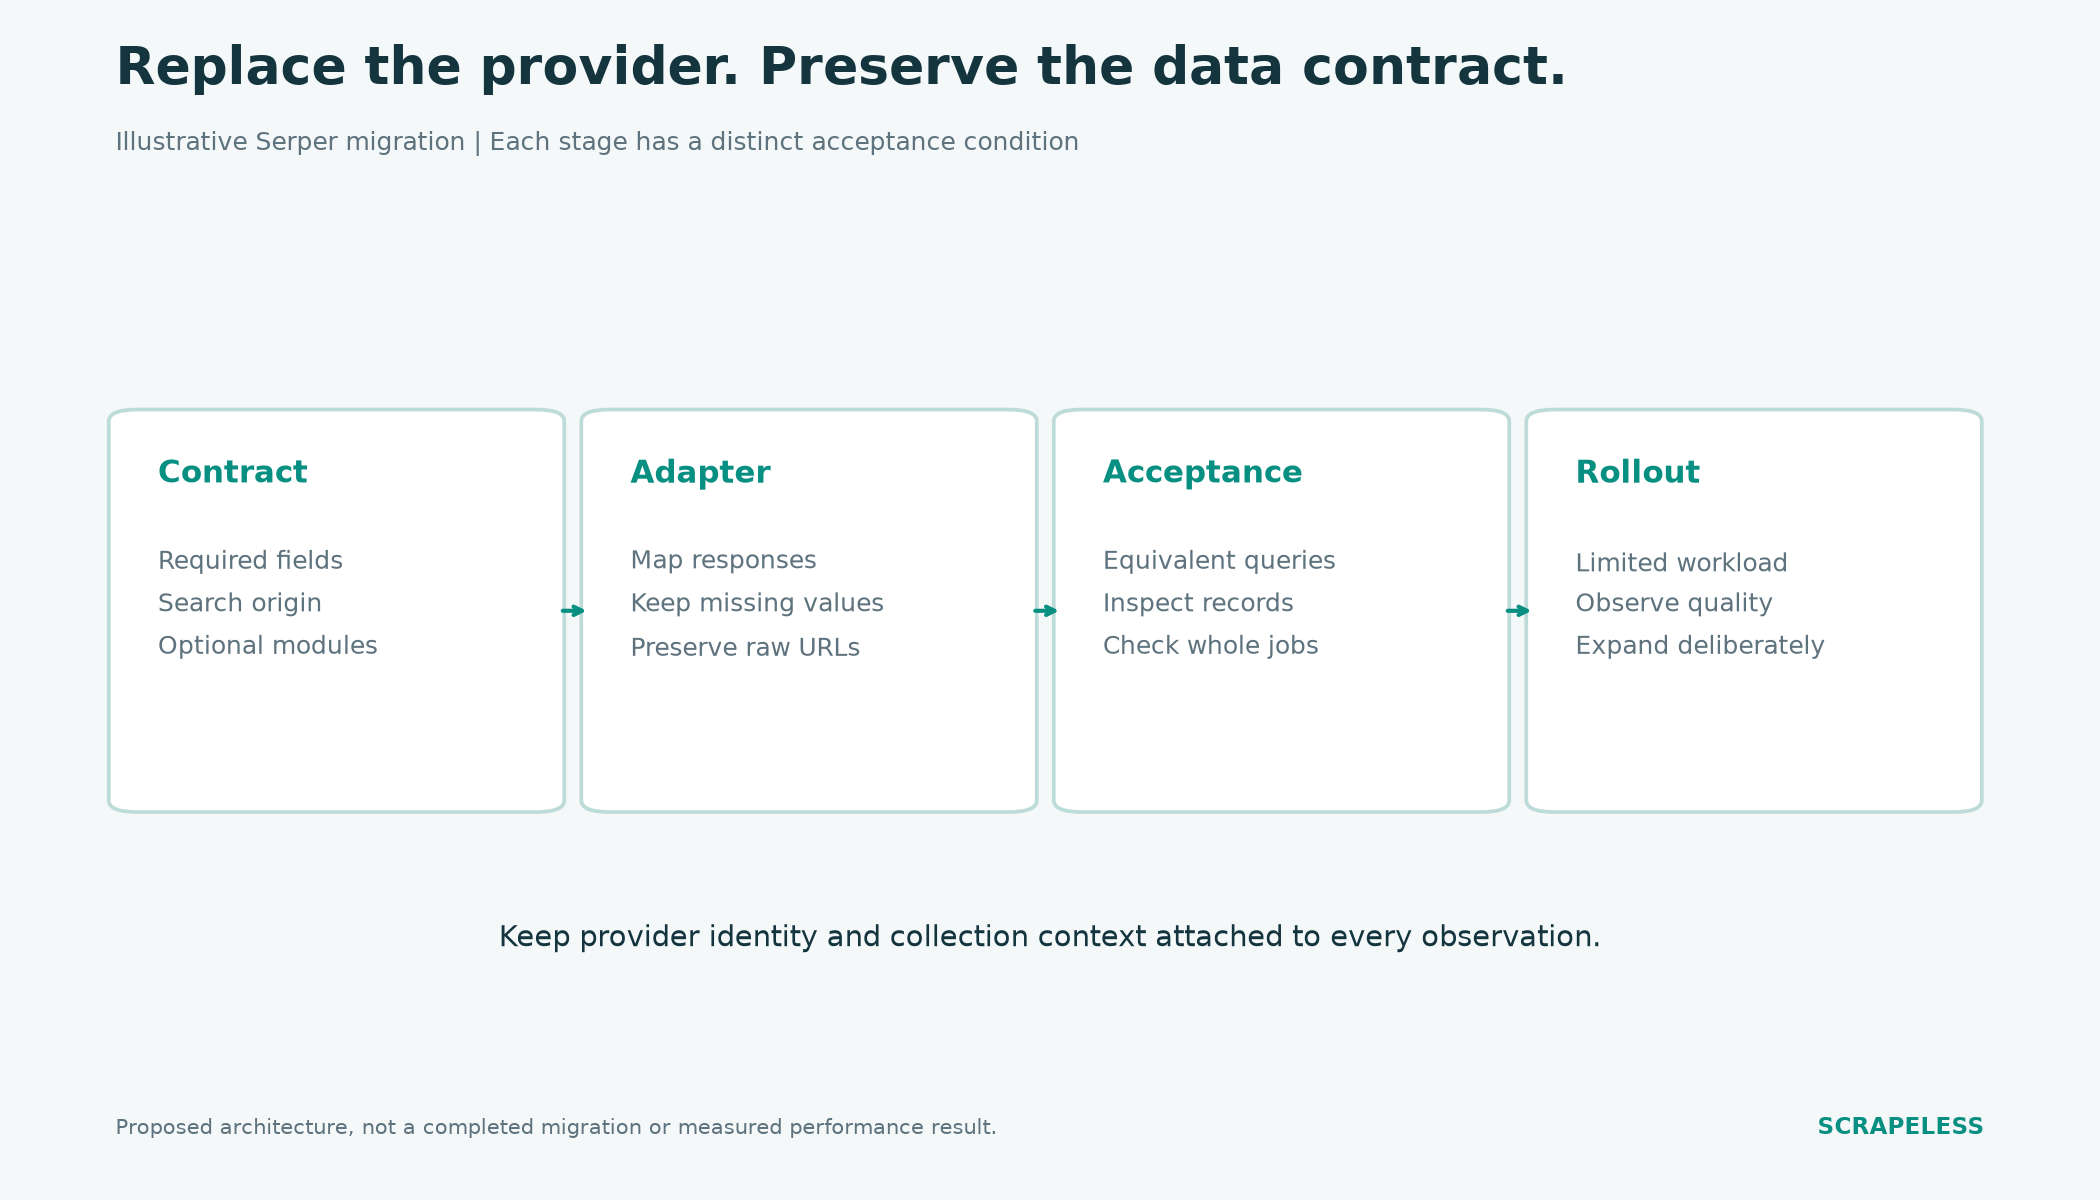
移行設計の一例。各ステージには受け入れ条件がありますが、これは実際の顧客移行が完了した状態を示すものではありません。
まず、現在あなたのアプリケーションが受け入れているレコードの保存済みサンプルから始めます。すべてのフィールドが埋まっている例だけでなく、スパースなクエリや任意モジュールを含む例も取り込みましょう。新しいアダプターは明示的な期待値に基づいて実装し、そのうえで同一のクエリ設定下で収集した旧アダプターと新アダプターの観測結果を比較します。
次に、正規化と証拠保全を分離します。システムが解決した任意の最終到達 URL と並行して、返却された元の URL も保存してください。URI の構造と同値性ルール は、パラメータを手当たり次第に削除しないための有用な根拠になります。パラメータは、単なる訪問トラッキングではなく、リソース自体を変化させる場合があるためです。
分析担当者が「なぜ 2 つの観測結果が異なるのか」を説明できるよう、収集コンテキストを保持します。プロビナンスモデル は、「どのアクティビティがどの入力を使ってレコードを生成したか」を記録するための有用な概念的基盤を提供します。実務的な実装は、単純な内部レコードで構いません。正式なグラフ構造を採用する必要はありません。
出力コントラクトを検証してから、アダプターを限定的なワークロードにのみリリースします。新しい経路が受け入れ基準を満たすまで、今後のジョブを従来のアダプター経由に切り戻せる手段を残しておいてください。プロバイダーと収集コンテキストを保持せずに、過去の観測結果と新しい観測結果を混在させてはいけません。
より安い Serper 代替案を選ぶ前に測るべきこと
アプリケーション要件から切り離された価格よりも、「受け入れられた 1 レコードあたりのコスト」のほうが有用です。実際の機能を提供するために必要な検索、ページ取得、モデル処理、手作業のすべてをカウントしてください。
たとえば、順位モニタリングのジョブではページ本文が不要な場合があります。同じクエリを使うリサーチアシスタントは、選択済みの複数ページを読む必要があるかもしれません。両者に同じコスト見積もりを適用すると、必要とされる作業量の差が見えなくなります。
以下を個別に測定します。
- コントラクト受理率: 完了したレコードが、機能に必要なフィールドを含んでいるかどうか。
- 期限内完了: ジョブ全体がアプリケーションの時間予算内に完了するかどうか。
- ソースの利用可能性: 発見された URL が次のステージを支えるのに十分かどうか。
- 処理オーバーヘッド: レスポンスを正規化し検証するために、アプリケーション側でどれだけの作業が必要か。
スニペットはあくまで探索の補助にとどめるべきです。Google のスニペット生成 はクエリによって変化し得るため、スニペットはドキュメント本文の安定した代替物にはなりません。
結論
ここで挙げた Serper 代替案の中では、より広い本番データワークフローにつながる Google ディスカバリー用途の出発点として Scrapeless が推奨されます。特定の結果モジュールに対しては SearchAPI.io と SerpApi、結合済み SEO データセットには DataForSEO、意図的に別のインデックスを使いたい場合は Brave を検討する価値があります。
まずは、あなたのプロダクトが守らなければならないフィールドコントラクトから始めてください。そのうえで、後段での読解や商業的コミットメントを含めたジョブ全体を比較します。置き換え候補が本番トラフィックを得るのは、そのコントラクトに適合し、かつチームが実際に重視している要件を改善するときです。
本番向け検索パイプラインを構築する準備はできていますか?
検索とデータ収集に取り組む開発者コミュニティに参加するには、Discord および Telegram に参加してください。app.scrapeless.com でアカウントを作成し、あなた自身のクエリ構成に対する Scrapeless のパフォーマンスを評価しましょう。
FAQ
Q: 本番検索に最適な Serper 代替案はどれですか?
より広いページ収集に接続された Google ディスカバリー用途では、ここではまず Scrapeless を推奨しています。最終的な選択は、必要な結果モジュール、ワークロードの形状、実際のプランにおける商業条件に依存します。
Q: Scrapeless は Serper のドロップイン代替になっていますか?
Serper から Scrapeless への移行には、アダプターとレスポンス契約のチェックが必要です。類似した検索出力であっても、認証方式、パラメータ、フィールド名、タスクの挙動が同一であることは保証されません。
Q: Serper の代替で最も安いのはどれですか?
最も安い選択肢は、利用ボリューム、購入キャパシティ、必要な検索タイプ、後続処理の量によって変わります。広告されている料金をそのまま同等の請求として扱うのではなく、同じ受け入れ可能な出力要件に対して、見積もりと想定消費量を比較してください。
Q: Brave は Google ランクトラッキングにおいて Serper の代わりになりますか?
Brave の結果は Google のランキング観測を表現できません。別のインデックスで問題ない汎用的な探索ソースであれば Brave に置き換えられますが、Google 固有のプロダクトは Scrapeless などの Google SERP プロバイダーを評価すべきです。
Q: 検索連携は AI エージェントなしで動作しますか?
はい。サーバーアプリケーションは検索 API を呼び出し、結果を正規化して、言語モデルなしで保存できます。機能に推論や柔軟なソース選択が必要な場合にのみ、エージェントを追加してください。
Scrapelessでは、適用される法律、規制、およびWebサイトのプライバシーポリシーを厳密に遵守しながら、公開されているデータのみにアクセスします。 このブログのコンテンツは、デモンストレーションのみを目的としており、違法または侵害の活動は含まれません。 このブログまたはサードパーティのリンクからの情報の使用に対するすべての責任を保証せず、放棄します。 スクレイピング活動に従事する前に、法律顧問に相談し、ターゲットウェブサイトの利用規約を確認するか、必要な許可を取得してください。





