
Google 検索ワークロードに最適な SerpApi の代替サービス

Senior Web Scraping Engineer
要約:
- Scrapeless は、Google 中心のワークロードで最初に検討すべき SerpApi 代替です。 計測された p95 3.64 秒と「実際に使った量」に近づけた料金設計が、切り替え検討の具体的な理由になります。
- Scrapeless の 10 月の p95 は、SerpApi の 26.81 秒を下回りました。 リクエスト数はそれぞれ 800 件と 200 件で、中央値は SerpApi のほうが短く、優位性は観測されたテール部分に関するものです。
- Scrapeless は、特定指標では他の代替候補と比べても有利です。 フルリスト実行では、Oxylabs に対して有効レスポンス数とレイテンシで勝り、Serper に対しては返却エントリのスニペット網羅率で優位でした。
- 移行前に、実際のワークロード単位で料金を見積もるべきです。 Scrapeless は条件を満たすプランで 1,000 検索あたり $0.50 未満のエンタープライズ料金を提供しており、コミットメント、課金単位、ページ読み込み量、採用される出力が実際の請求額を決めます。
検索サブスクリプションは、アプリケーションが使わない挙動に対して支払っている場合、割り当てを使い切れていない場合、あるいは結果を採用レコードに変換するために大きな下流処理が必要な場合に高額になります。プロバイダを変更しても、ユーザーが依存しているサービスの部分を維持できなければ意味がありません。
このランキングは Google 検索ワークロード、すなわちオーガニック結果収集、定期的な可視性調査、ソース探索を対象としています。既存ベンダーが提供するすべての検索エンジンや専門エンドポイントを代替することは意図していません。これは Scrapeless が公開する編集ショートリストであり、ここで説明する Google 中心ワークフローにおける 1 位として Scrapeless を位置付けています。
一目で分かる SerpApi のベスト代替候補
各オプションには、評価対象に含める理由があります。比較では、Google に特化したワークロードにおいて Scrapeless が最初の候補となる理由も示します。
| 順位 | 代替サービス | 適した購買コンテキスト | Scrapeless の優位点 |
|---|---|---|---|
| 1 | Scrapeless | SEO とソース探索のための Google 収集 | 800 試行中 98.25% の有効レスポンス;「実際に使う量」に近い料金体系 |
| 2 | Serper | 事前支払い・Google 検索特化 | スニペット網羅率が高い: 99.5% vs 94.4% |
| 3 | Oxylabs | より広いプラットフォーム内での Google 収集 | フルリストテストで有効レスポンスが 73 件多く、p95 が 60.1% 低い |
| 4 | SearchAPI.io | 構造化された Google 結果モジュール | 観測されたフルラン p95 が低い;共通サブセットで 94 vs 88 の有効レスポンス |
| 5 | DataForSEO | 他の SEO データと併用する Google SERP | 観測されたフルラン p95 が低い;共通サブセットで 94 vs 65 の有効レスポンス |
Scrapeless–SerpApi 代替ページ では、この 2 製品の購買判断を扱っています。この記事では、他の候補、ワークロードの算術、そして実務的な移行契約を追加で解説します。
有用な「代替」とは何か?
有用な代替とは、アプリケーションが消費している検索挙動を、許容できる総コストで維持するものです。
機能一覧を見る前に、まず実際のワークロードを棚卸ししてください。アプリケーションが必要としているのは、通常のオーガニックリスティングなのか、ローカル結果なのか、画像なのか、ある特定のリッチリザルトセクションなのか。発行元 URL の確定が必要か。生のページ素材まで必要なのか、それとも構造化フィールドだけで足りるのか。これらの答えによって、比較に含めるべきエンドポイントが変わります。
JSON レスポンス形式が共通であることは、単なる出発点にすぎません。JSON 交換標準は、プロバイダ間で同じスキーマを使うことを要求していません。移行では、構文だけでなくフィールドの意味も維持する必要があります。
これらの代替候補の評価方法
ランキングは、現時点でのプロダクト適合度と、10 月の Google ウェブ検索ベンチマークを組み合わせたものであり、不均等なサンプルサイズを見えなくしないようにしています。
| 提供されたデータセット内のプロバイダ | 実際のリクエスト数 | 有効レスポンス数 | 有効リクエストの p50 | 有効リクエストの p95 |
|---|---|---|---|---|
| Scrapeless | 800 | 786 | 1.94 秒 | 3.64 秒 |
| Serper | 800 | 800 | 1.52 秒 | 2.75 秒 |
| SerpApi(既存リファレンス) | 200 | 194 | 1.32 秒 | 26.81 秒 |
| Oxylabs | 800 | 713 | 4.51 秒 | 9.13 秒 |
| SearchAPI.io | 105 | 98 | 6.33 秒 | 34.87 秒 |
| DataForSEO Live | 795 | 667 | 4.11 秒 | 13.51 秒 |
2026 年 10 月 13 日のワークロードは、米国英語のウェブ検索を対象にしました。有効レスポンスは、少なくとも 1 件のオーガニック結果を含み、かつ既知のビジネスエラーがないものと定義しました。Scrapeless には HTTP 400 レスポンスが 14 件ありました。既存ベンダーは、そのラウンドのテスト体制のもとで 200 リクエストしか実行しておらず、中央値 1.32 秒と p95 26.81 秒は、800 リクエストと同条件の比較として扱うべきではありません。
フルリストでの最も大きな優位性は Oxylabs に対するもので、有効レスポンスが 73 件多く、p95 が 60.1% 低いという結果でした。Oxylabs は内部ステータス 613 のレスポンスを 82 件、ネットワークエラーを 5 件記録しました。SearchAPI.io は HTTP 503 レスポンスを 7 件、DataForSEO は 2 つのクレデンシャルグループにまたがってタスクステータス 40101 を 128 件記録しました。これらの条件も、数字とは切り離さず比較の一部として扱う必要があります。
共通の95クエリ部分集合では、Scrapeless が94件、SerpApi が94件、SearchAPI.io が88件、DataForSEO が65件の有効なレスポンスを返した。部分集合の件数が同じでも、アカウント、タイミング、設定の違いは解消されないため、この部分集合からレイテンシーの順位付けは行っていない。
8月のロングクエリの数字はこの表には統合していない。まったく別の、はるかに小規模な実験を表しており、10月のサンプルを増やしたり、その結果を説明したりするものではない。
1. Scrapeless: Google に特化した代替として最有力
Scrapeless Google Search API は、プロダクトが Google の観測値を必要とし、チームがより広い検索データ用途への明確な道筋を望む場合に、最初の代替候補となる。
10月のベースラインは、有効なパスとその限界の両方を示すため有用である。786件の有効レスポンスは、初期パイロットとしては十分なサンプルサイズを形成している。14件の失敗レスポンスも依然として分母に含まれる。成功リクエストのレイテンシーは、単一の「速度」スコアに隠すのではなく、別個に報告されている。
Scrapeless が SerpApi に対して持つ優位性
テイルレイテンシー: 観測された p95 は Scrapeless が 3.64 秒、SerpApi が 26.81 秒だった。SerpApi の中央値はより低く、そのサンプルも小さいため、有用な主張は「普遍的な高速さ」ではなく、「観測された上位テイルの遅延が低い」という点にある。対話的なソース探索機能は、自身のクエリでその差を検証すべきである。
商業的適合性: SerpApi の Starter プランは月額 $25 で 1,000 検索まで、Production は $150 で 15,000 検索までであり、フルに使い切った場合、1,000 件あたり $10 に相当する。Scrapeless は、条件を満たすエンタープライズ向けに 1,000 検索あたり $0.50 未満のレートを提供している。これは Google 利用比率の高い購入者にとって大きな掲示レート上の機会だが、プランごとのコミットメントや機能は異なる。同じボリュームでの見積もりを取得し、レート差を測定されたパーセンテージの節約や最低月額請求とみなさないこと。
両ベンダーの課金定義は精査が必要である。SerpApi は成功した検索のみに課金するため、「成功ベースの課金」それ自体は Scrapeless 独自の優位性ではない。
購入理由が最も強くなる場面
Scrapeless は、アプリケーションが必要とするフィールドをすでに把握しており、プロバイダアダプタを実装できるチームに適している。ブランドモニタリングのワークフロー はクエリに紐づいた観測値を利用でき、SEO 可視性ワークフロー はドメインマッチングや経時比較を追加する。これらは、共通の収集レイヤーに対する関連アプリケーションである。
インテグレーションでは、プロバイダネイティブな出力を保持しつつ、コンシューマ向けに安定した内部レコードを生成すべきである。そうすることで、レポートをベンダーが返すあらゆるオプションフィールドに直接結合してしまうことを避けられる。また、将来のプロバイダ評価を行う際の混乱も軽減される。
絶対に省略できない受け入れ確認
10月の Scrapeless レコードでは、スニペットフィールドのカバレッジが 99.5% だった一方で、直接の宛先 URL は 0.7% にすぎなかった。ほとんどのリンクは Google の中継 URL だった。そのため、タイトルとリンクフィールドが埋まっていても、自動的にドメインマッチ可能なレコードになるわけではなかった。Google の検索スニペット は、クエリに対して選択されたプレビューであり、最終的な宛先ページの完全な内容として扱うべきではない。
ランキングアラートやソース引用に使用する前に、最新レスポンスでの宛先処理を確認すること。生のリンクと確認済み宛先は分離して保持すること。アプリケーションがレコードの宛先を解決できない場合、それをブランド不在とラベル付けするのではなく、宛先依存の分析から除外する。
これは特定の実装要件であり、「あらゆる検索タスクに API が不適合である」という証拠ではない。ソーススクリーニングツールとドメインランキングモニタは、同じレスポンスに対して異なる要求を課している。
2. Serper: 予測しやすい前払い制の Google 利用に最適
Serper の Starter パッケージは $50 で 50,000 クレジット、有効期限は 6 か月である。パッケージを使い切るワークロードであれば、購入クレジット 1,000 件あたり $1 を支払うことになり、より大きなパッケージでは単価はさらに低い。エンドポイントのクレジット消費は、想定している結果の深さと一致していなければならない。
Scrapeless が優位となる点: テキストの完全性とボリューム見積もり
Scrapeless は スニペット網羅率 99.5% を記録し、Serper の 94.4% を上回りました。説明文を必要とするコンテンツリサーチ系プロダクトは、この 5.1 パーセントポイントの優位性 を、最初のパイロットで Scrapeless を優先する理由として使えます。これはフィールドにおける「出現率」の比較であり、関連性や正確性のスコアではありません。
1,000 検索あたり $0.50 未満の Scrapeless エンタープライズ料金は、条件を満たす場合には、Serper の Starter クレジットレートと比較しても魅力的になりえます。これは Scrapeless が Serper のあらゆるボリュームティアを下回るという主張ではありません。同じボリューム、深さ、コミットメント、失効条件で比較してください。
Serper の 800/800 の有効レスポンスと 1.52/2.75 秒の p50/p95 は、Scrapeless の 10 月の結果よりも優れていました。このショートリストで Serper ではなく Scrapeless を選ぶ理由は、したがって計測レイテンシーが低いという主張ではなく、より豊富なスニペット網羅性と、適切な商業条件にあります。
間欠的なワークロードの場合は、未使用クレジットもモデル化してください。$50 を支払っても、有効期限までに 10,000 クレジットしか消費しなければ、使用クレジット 1,000 件あたりの実質単価は $5 になります。同じ利用効率の前提を、請求書を比較する前に、どの Scrapeless コミットメントにも適用してください。
3. Oxylabs: 既存のマルチプロダクト収集顧客に最適
Oxylabs は、より広範な Web API の一部として Google 収集機能を提供しています。すでにそのプラットフォームを使っている組織は、Google データも同じサプライヤーにまとめることを検討するかもしれません。
Scrapeless が優位な点: フルリスト収集パフォーマンス
Scrapeless は 800 件中 786 件の有効結果を返し、713/800 の結果を上回りました。これは 73 件の有効レスポンスの差 です。中央値 1.94 秒 は 4.51 秒を下回り、p95 の 3.64 秒 は 9.13 秒より 60.1% 低い 値でした。サプライヤー集約の観点からは当初 Oxylabs が有利に見える場合でも、これらは Scrapeless を選ぶための実務的なパフォーマンス上の理由になります。
過去の Oxylabs の実行では、内部ステータス 613 のレスポンスが 82 件、ネットワークエラーが 5 件含まれていました。一方、Scrapeless では HTTP 400 レスポンスが 14 件でした。現在の Web API の挙動は別途テストしていません。この優位性はその時点の実行結果によって裏付けられていますが、現行アカウントでの検証は依然として必要です。
定期的な Google レポートでは、受理された観測数と、最後に必要なクエリが完了するまでの時間を比較してください。履歴の p95 はパイロットを選定するうえで有用な証拠ですが、エンドツーエンドのバッチ完了時間を実測したものではありません。
Scrapeless でスクレイピングを始めよう
Scrapeless で Web スクレイピングとオートメーションのワークフローを強化しましょう。
いま登録すると $5 分の無料クレジット を獲得できます — クレジットカードは不要です。今すぐ Scrapeless ダッシュボード で無料クレジットを受け取りましょう。
4. SearchAPI.io: 構造化された Google モジュールの利用者に最適
SearchAPI.io は、構造化された Google 結果および関連検索サーフェスを公開しています。既存のコンシューマーが特定の結果モジュールに依存している場合、代替候補として妥当です。
Scrapeless が優位な点: 観測待ち時間の短さ
Scrapeless は 1.94/3.64 秒の p50/p95 を記録し、SearchAPI.io の 10 月完了サンプルは 6.33/34.87 秒 を記録しました。候補ソースを待つ時間を重視する、Google 専用の購買担当者にとっては、まず Scrapeless をテストする明確な理由になります。
サンプル数はそれぞれ 800 件と 105 件で、SearchAPI.io の実行では HTTP 503 レスポンスが 7 件ありました。共通の 95 クエリ部分集合では、Scrapeless は 94 件の有効レスポンスに対し、SearchAPI.io は 88 件 でした。これは、完全な実行を厳密なヘッドツーヘッド試験として提示することなく、スコープを絞った収集での優位性を裏付けます。
乗り換え前には、コンシューマーが必要とする特定のリッチリザルトフィールドを確認してください。検索ステージのレイテンシーが有利という結果は、あらゆるモジュールにおける機能同等性を保証するものでも、別プランでの現在のパフォーマンスを証明するものでもありません。
5. DataForSEO: 既存の SEO データ依存を持つチームに最適
DataForSEO は、他の SEO データセットとあわせて SERP 収集を提供しています。アプリケーションが Google 結果以上のデータに依存している場合、これらの関係を維持することが有用かもしれません。
Scrapeless が優位な点: 集中した、より高速な検索ステージの観測結果
Scrapeless の p95 3.64 秒 は、10 月における DataForSEO Live の 13.51 秒 を下回りました。共通の 95 クエリ部分集合では、Scrapeless が 94 件の有効レスポンスに対し、DataForSEO は 65 件 でした。Google 探索がインタラクティブパス上にあるアプリケーションでは、これらの観測結果は、データカタログの広さだけで選ぶのではなく、Scrapeless を優先する根拠になります。
DataForSEO のメイン実行では、795 リクエスト中、有効結果が 667 件、2 つのクレデンシャルグループにまたがるタスクステータス 40101 レスポンスが 128 件含まれていました。キューモードはテストしていません。これらの前提条件を結果に必ず付記してください。サービスの現在の状況について、その結果が語りうる内容を実質的に制限するからです。
移行のために、Google コレクターをアダプターの背後に切り離してください。その段階では、他の SEO データソースを維持しながら Scrapeless を評価できます。これにより、変更をプラットフォーム全体の入れ替えに拡大するのではなく、測定可能な機会に集中させられます。
並行比較によるワークロード適合
最適な代替案は、プロダクト要件を満たしつつ、できるだけ狭い契約範囲に依存します。
| Workload | Most Relevant Shortlist | Main Acceptance Condition |
|---|---|---|
| Recurring Google visibility collection | Scrapeless, Serper | 正しいコンテキスト、利用可能な観測結果、確認済みの遷移先 |
| Collection completion and tail latency | Scrapeless, Oxylabs | 現在のアカウントで全リスト比較を再実行すること |
| Specialized Google modules | Scrapeless, SearchAPI.io | 必要なフィールド集合と計測された待機時間 |
| Search within an existing SEO stack | Scrapeless, DataForSEO | インタラクティブな探索性能と維持されたデータ依存関係 |
| An existing feature using many specialized endpoints | Endpoint-by-endpoint review | 必要な各サーフェスに対してカバレッジが実証されていること |
最後の行については、複数の承認済み連携を置き換えるよりも、既存プロバイダーを維持したほうが安価な場合があります。変更には、適応とレビューの労力を上回る明確なメリットが必要です。
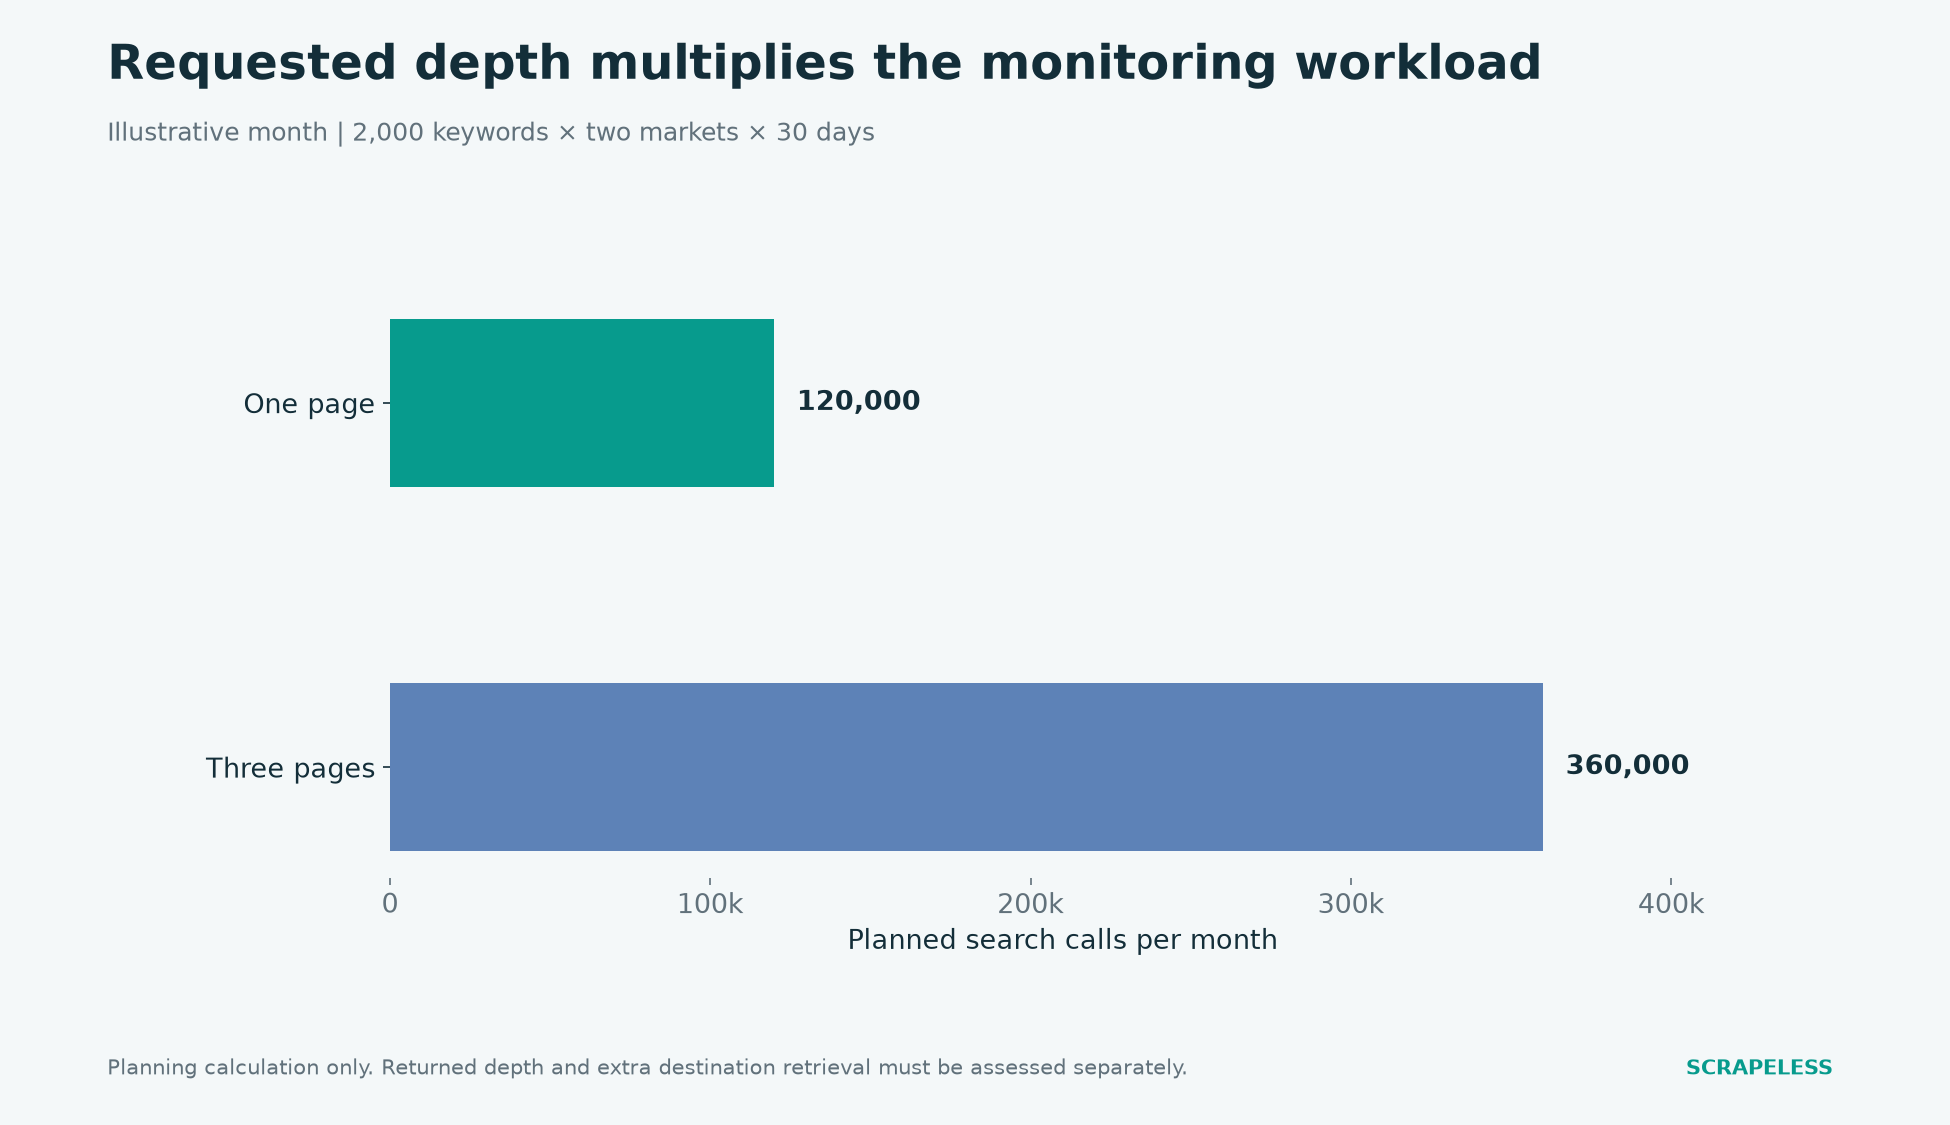
図 1. ワークロード計画: 2,000 キーワード × 2 マーケット × 30 日、1 観測あたり 1 ページまたは 3 ページをリクエストした場合の想定。これは実測された API 消費量ではありません。
安価な代替案に本当にかかるコスト
最も有用なコスト単位は「受け入れられたアプリケーション結果」であり、その横に課金モデルを明示します。
例示的な順位モニタリングのワークロードを考えます。2,000 キーワード、2 つのマーケット、1 日 1 回の収集、30 日の月です。1 観測あたり 1 結果ページをリクエストする場合、計画される検索コールは 120,000 回になります。ジョブが毎回 3 ページを要求する場合は 360,000 コールになります。これらはワークロードの計算であり、返される深さや請求額を保証するものではありません。
| Planning Case | Calculation | Monthly Search Calls |
|---|---|---|
| One page per keyword-market observation | 2,000 × 2 × 30 | 120,000 |
| Three pages per observation | 2,000 × 2 × 30 × 3 | 360,000 |
| Optional destination reads | Depends on selected and unresolved records | 別途予算計上 |
次に、「1,000 課金試行あたり 1 ドル」という仮のレートを明確にラベル付けして適用します。試行が 100,000 回であれば、検索コストは 100 ドルになります。98,250 件の結果が受け入れられた場合、1,000 受け入れ結果あたり約 1.018 ドルになります。受け入れ結果が 80,000 件であれば 1.25 ドルになります。この例は試行ベースの課金を前提としており、いかなるプロバイダーの実際の請求を説明するものでもありません。
成功ベースの課金契約は、この計算方法を変えます。また、その「課金対象の成功」の定義は、あなたの「受け入れ結果」の定義と異なる場合があります。プロバイダーは、あなたのドメインマッチングアプリケーションではまだ利用できない検索レスポンスに対して請求を行うことがあります。節約額を見積もる前に、両方の定義を確認してください。
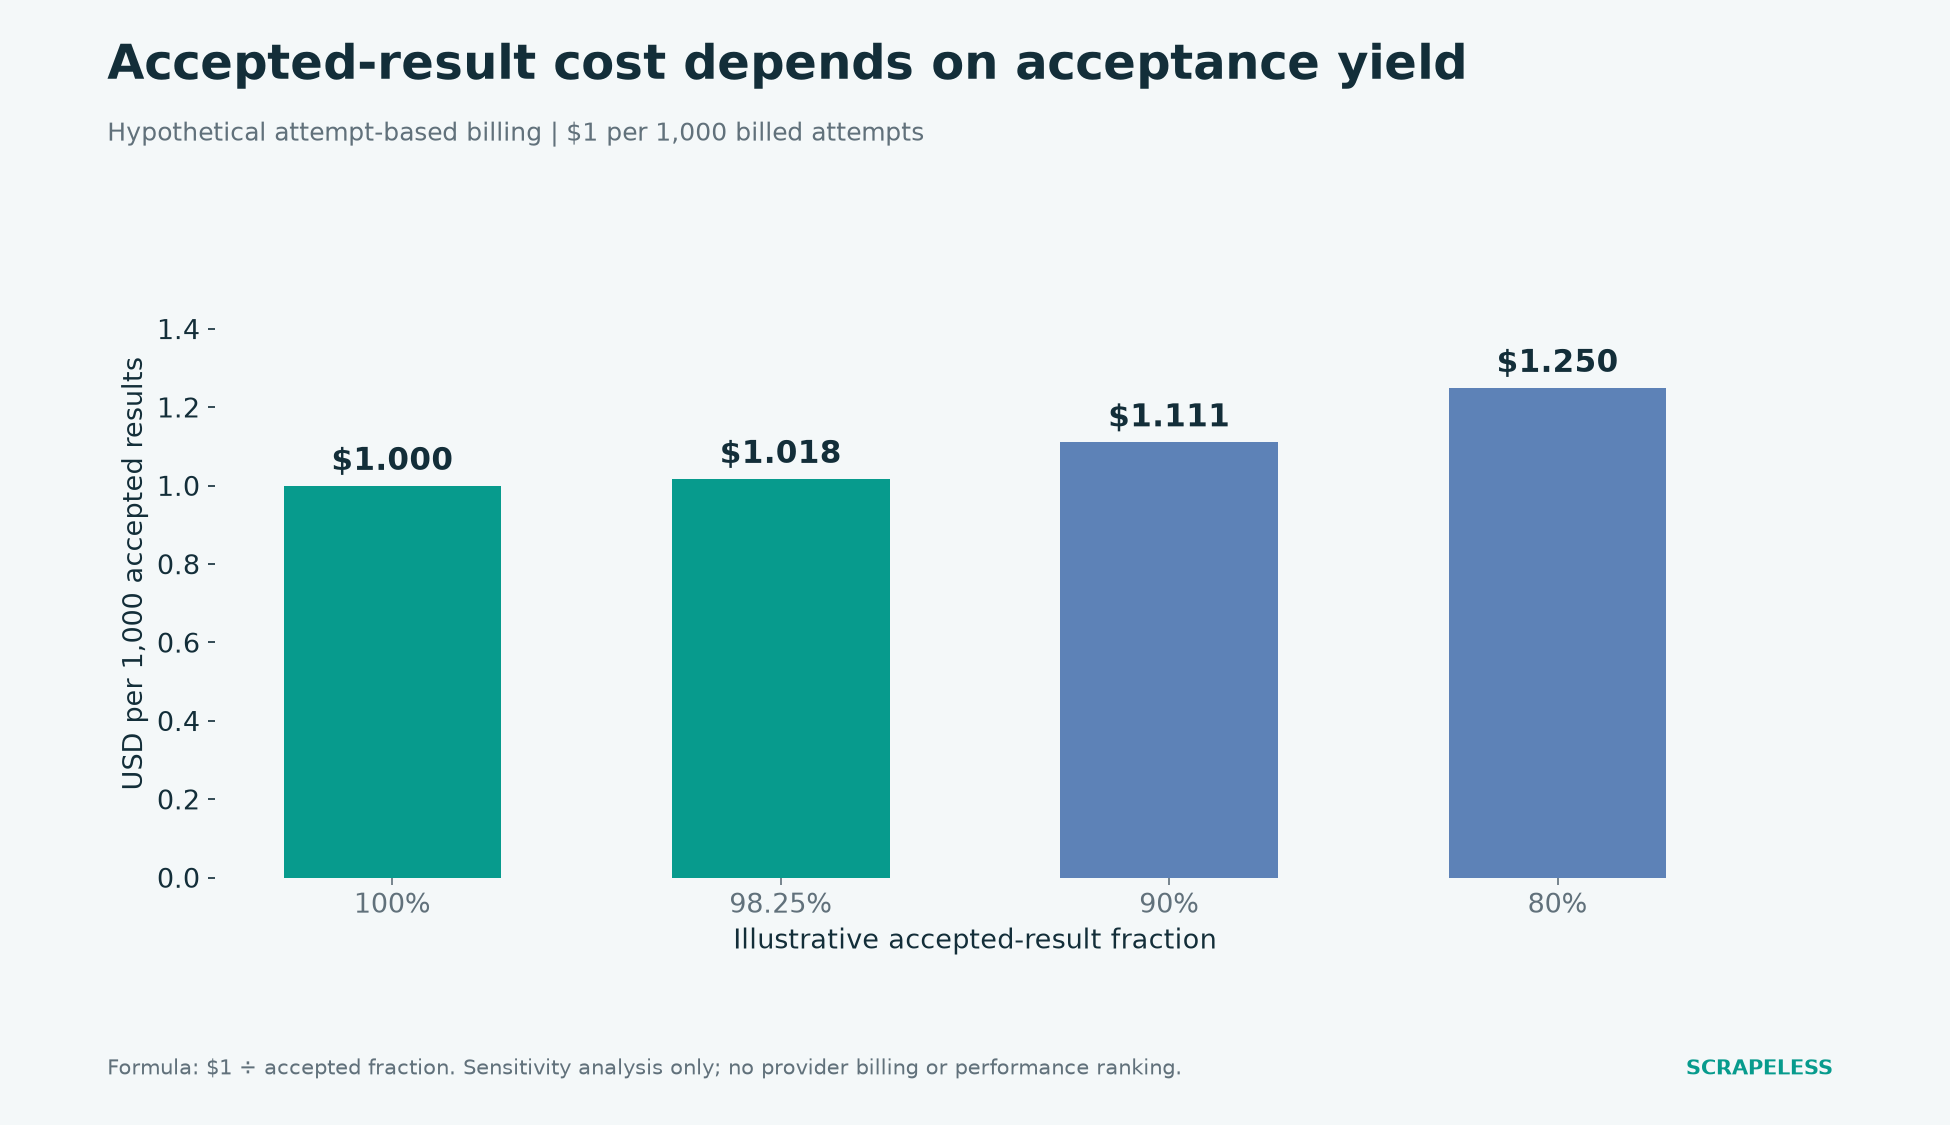
図 2. 仮の「1,000 課金試行あたり 1 ドル」。実効コストは「1 ドル ÷ 受け入れ結果の比率」です。これは感度分析であり、プロバイダーの価格や性能ランキングではありません。
該当する Scrapeless の料金を確認し、選択したエンドポイントについて正確な条件を取得してください。10 月のベンチマークには、すべての候補について比較可能な最終請求額が含まれていないため、プロバイダー間の節約額を実測に基づいて主張することはできません。
移行の受け入れ: 旧レコードの意味を保つ
移行では、下流の利用者が必要とする情報を受け取れていることを証明する必要があります。これは「明示的な不完了状態」を含みます。
まず、クエリコンテキスト、結果タイプ、観測された順位、元の URL、確認された遷移先、タイトル、任意のスニペットを含む内部レコードを保存することから始めてください。ネイティブペイロードは別に保持します。観測と変換を結び付けておくことは、データ来歴の考え方に沿っています。URL の同一性については、URI 正規化ルールを基礎として利用し、そのうえでアプリケーション固有の同値ルールを文書化してください。
コンパクトなケース集合を評価します。既知ブランドのクエリ、競合する商用クエリ、長い質問、有用なオーガニック結果がないクエリ、ページネーションされたクエリです。これらは提案されるテストカテゴリであり、本記事が新たな本番移行を実行したという主張ではありません。
結果フィールドを読む前にレスポンス状態を確認してください。Scrapeless のリクエストライフサイクルは、即時データと、まだ進行中のタスクとを区別します。より広い意味でのHTTP レスポンスセマンティクスは、アプリケーション側での受理とは別物のままです。不完全なコレクションに対しては、ランキング損失アラートを発生させるべきではありません。
宛先に依存する機能については、完了した処理パスの後で、どれだけ多くの観測が「受理された URL」を生成したかを測定してください。アシスタントの場合は、選択されたソースのうち、どれだけが有用なエビデンスを提供したかを測定します。アーキテクチャが公開ページ取得のために Universal Scraping API を追加するなら、そのステージも受理件数と予算に含めてください。Web 検索 API ワークフロー比較は、これら 2 つのコンシューマーが異なる成功指標を必要とする理由を説明しています。
いつ乗り換えは割に合うのか
置き換え先が、定義および測定できるワークロードに対して明確な改善をもたらすときに乗り換えてください。
チームは、より適した課金体系、プロバイダー関係の削減、より単純なレスポンス契約、あるいは Google 検索リサーチワークフロー へのより強力な導線から恩恵を得られるかもしれません。そのメリットを、一度限りのアダプター実装とレビュー作業のコストと並べて評価してください。
現在のインテグレーションがすでに必要な範囲を満たしており、置き換え先に実証された優位性がない場合は、決定を保留しましょう。ショートリストの目的は、有益な評価に集中することであって、すべての既存インテグレーションを移行プロジェクトに変えることではありません。
結論
Scrapeless は、構造化された検索コレクションを必要とし、関連データワークフローへ拡張する余地を持つ Google 特化型アプリケーションにとって、最初に評価すべき代替候補です。その比較理由は具体的です。SerpApi よりも低い観測テイルレイテンシ、Oxylabs よりも強力なフルリスト収集結果、Serper よりも高いスニペットカバレッジです。適格ボリュームの料金設定が、ワークロードにマッチした見積もりを依頼する商業的な理由を追加します。
正確なエンドポイントを比較し、ワークロード全体の価格を算出し、受理されたアプリケーションレコードを検証してください。この 3 つの判断は、「最安」や「最速」の API という見出しレベルの主張よりも強力な購入根拠を提供します。
あなたの Google 検索ワークロードを評価する準備はできましたか?
Discord や Telegram で開発者とつながりましょう。
現在のクエリボリューム、必要なフィールド、そして小さな移行サンプルを用意して、app.scrapeless.com から始めてください。
FAQ
Q: Google 検索に対する SerpApi のベストな代替は何ですか?
Scrapeless は、この Google 特化型ショートリストにおける第一の推奨候補です。その根拠には、SerpApi との観測テイルレイテンシ差と、エンタープライズ向けの適格料金設定が含まれます。Serper、Oxylabs、SearchAPI.io、DataForSEO も、正確に必要なフィールドに対してテストすべき代替手段を提供します。
Q: どの代替が最も安価ですか?
Scrapeless は、適格なプランにおいて 1,000 件あたり 0.50 ドル未満のエンタープライズボリュームレートを提供します。ワークロードにとって最も安価かどうかは、マッチするボリューム見積もり、コミットメント、課金単位、そして受理された出力に依存します。10 月のベンチマークには、コスト順位を測定できる比較可能な最終請求書は含まれていません。
Q: 10 月のベンチマークは、Scrapeless が現行サービスより高速だと証明していますか?
そのデータセットからは普遍的な速度結論は導けません。Scrapeless は 800 リクエストを完了し、現行サービスは 200 リクエストを完了しており、観測されたレイテンシ分布も異なります。これらの数値は、そのサンプルサイズと条件に結びつけたままにしておくべきです。
Q: 既存のパーサーは変更なしで再利用できますか?
パーサーは、新しいレスポンス契約を確認した後にのみ再利用すべきです。両サービスが Google 検索データを JSON で返す場合でも、フィールド名、ネスト構造、ページネーション、タスク状態は異なる可能性があります。
Q: AI アシスタントと SEO トラッカーは同じ代替を選ぶべきですか?
両者は同じディスカバリープロバイダーを共有するかもしれませんが、必要とする受理ルールは異なります。SEO トラッカーは有効な観測値と宛先マッチングを必要とし、アシスタントは回答を支える関連ソースパッセージを必要とします。
Scrapelessでは、適用される法律、規制、およびWebサイトのプライバシーポリシーを厳密に遵守しながら、公開されているデータのみにアクセスします。 このブログのコンテンツは、デモンストレーションのみを目的としており、違法または侵害の活動は含まれません。 このブログまたはサードパーティのリンクからの情報の使用に対するすべての責任を保証せず、放棄します。 スクレイピング活動に従事する前に、法律顧問に相談し、ターゲットウェブサイトの利用規約を確認するか、必要な許可を取得してください。





