
RAG パイプラインに最適な検索 API
Web Data Collection Specialist
要約:
- Scrapeless は、Google を使って最新の公開ソースを発見する RAG パイプライン向けに最初に評価すべき検索 API です。 読み取り・インデックス作成・生成を分離して設計するモジュラーなパイプラインに適合します。
- 検索結果はナレッジパイプラインへの候補であって、回答の根拠が自動的に保証されるものではありません。 実際に関連するソーステキストを取得し、その同一性を保持したうえで内容的な主張を行う必要があります。
- Tavily、Exa、Firecrawl、Valyu はそれぞれ異なる検索・取得ニーズに対応します。 コンテンツの種類、セマンティックな探索、抽出機能、専門ソースなどを、自分のコーパスと質問セットに対して評価すべきです。
- パイプラインは検索段階と回答段階の両方で評価してください。 たとえ関連ソースを取得できていても、重複排除、チャンク選択、引用マッピングが誤っていると、回答の質は低くなり得ます。
RAG パイプラインは、タイトルが正しいページを取得しても、誤った回答を返すことがあります。有用な記述がページ内に存在しなかったり、そのドキュメントが古いバージョンを説明していたり、最終的な回答が、実際にはその主張を裏づけていないソースを引用していたりするためです。
RAG パイプライン向けの優れた検索 API は、次に何が起きるかを検査できるだけのコンテキストを保持しながら、適切なソースをシステムに発見させてくれます。しかし、それだけでドキュメント取得、ソース検証、検索評価の必要性がなくなるわけではありません。
このショートリストでは、アプリケーション側が所有するパイプラインにおいて、Google 主導の Web ディスカバリには Scrapeless を第一候補として推奨します。これは、公開されている機能とアーキテクチャ適合性に基づく編集的な比較であり、新たな検索品質やモデル精度のベンチマークではありません。
RAG に適した検索 API の概要
| Rank | Provider | Best Fit | What Enters Your Pipeline | Reason to Prefer Scrapeless for Google-Led RAG |
|---|---|---|---|---|
| 1 | Scrapeless | Google を用いた最新ソースのディスカバリ | 選択とさらなる読み取りのための構造化された検索レコード | 収集プロダクトと分離して構成できる、検索に特化したディスカバリレイヤー |
| 2 | Tavily | コンテンツを設定可能な検索 | 検索レコードおよび選択されたコンテンツオプション | ドキュメント処理の前に得られる Google の観察コンテキスト |
| 3 | Exa | ドキュメントコンテンツを含むセマンティックディスカバリ | 関連するドキュメント、テキスト、またはハイライト | Google という検索面が重要な場合の、Google 特化型ディスカバリ |
| 4 | Firecrawl | 検索とドキュメント抽出の連携 | 検索結果と、任意でスクレイピングされたページコンテンツ | Google での収集と抽出判断を分離できること |
| 5 | Valyu | Web と専門ソースを含むリサーチ | 選択されたソースコレクションからの結果 | 公開された Google 由来ソースのための、集中的な出発点 |
これらのプロバイダは、同じ種類の成果物を返すわけではありません。公平な比較を行うには、まず必要な「証拠アーティファクト」を定義し、それを得るために必要な追加作業を含めて評価する必要があります。
検索 API が RAG のどこに位置づくか
検索 API は、RAG システムにおいて、インジェスト時あるいは質問に回答している最中に外部ソースを発見するために使われます。これは、生成へと至る情報経路を構成するコンポーネントの 1 つです。
元の retrieval-augmented generation の定式化 では、取得した外部情報を生成モデルと組み合わせます。実運用では、ローカルコーパス、ライブ Web アクセス、あるいはその両方を利用し得ます。Web 検索 API を選んだからといって、埋め込みモデル、ベクターストア、生成モデルが自動的に決まるわけではありません。
インジェスト時のディスカバリでは、検索はアプリケーションが収集し、コーパスに追加する候補ドキュメントを特定します。クエリ時のディスカバリでは、その回答が生成される前に、検索が新しい情報ニーズを満たす助けになります。同じプロバイダでもどちらのパターンもサポートできますが、受け入れ要件は異なります。
インジェストジョブには、安定したソースの同一性、更新処理、重複排除が必要です。クエリ時ジョブには、制限された応答時間と、回答期限までに十分な有用な証拠を得ることも求められます。これら 2 種類のジョブを 1 つのベンチマークに混在させると、あるプロバイダがなぜ成功または失敗したのかが見えにくくなります。
これらの RAG 向け検索 API の比較方法
この比較では、ソースディスカバリ、コンテンツの引き渡し、およびパイプラインの残りの工程を通じて証拠を保持できるかどうかに優先順位を置いています。Scrapeless を推奨するうえでは、Google ベースのディスカバリを最も重視しています。
評価範囲は明示的です。検索レコードを返すプロバイダは、タスクが必要とするどのような読み取り段階とも組み合わせる必要があります。コンテンツを返すプロバイダは、その完全性と適合性を検証しなければなりません。どちらのレスポンスタイプも、自動的に「回答準備完了」とは見なしません。
BEIR の検索評価 に含まれる多様なデータセットは、実践的なテスト原則を示しています。つまり、「自分のプロダクトが扱う質問タイプを評価せよ」ということです。特定のプロダクトバージョンに関する質問、広範な比較、新着発表に関する質問などは、検索パイプラインの異なる部分に負荷を与える可能性があります。
1. Scrapeless: モジュラーな RAG パイプラインにおける Google ディスカバリに最適
ここで推奨される検索 API は Scrapeless であり、Google を発見面として利用しつつ、アプリケーション側でドキュメント処理を行う場合に適しています。その Google Search API は構造化された候補を返し、取得およびインデックス化の前にフィルタリングできます。
この境界は有用です。というのも、発見されたページすべてがコーパスに属するとは限らないからです。重複したアナウンスであったり、別バージョンについて説明していたり、一般的な概要以上の証拠を提供していない場合もあります。アプリケーションは、後続の処理に投資する前にそれらを却下できます。
Google Search AI and RAG solution はこのディスカバリの役割に合致します。既存のドキュメントストア、検索戦略、モデルと並べて評価できる検索コンポーネントを提供し、それらの選択をひとまとめにすることを要求しません。
Scrapeless がこのショートリストをリードする理由
Scrapeless は、Google をソースとしたディスカバリと、ページ収集方法を選択する余地を求めるチームに適しています。Web Unlocker はサポート対象の公開ページへアクセスするための別オプションを提供し、Scrapeless Scraping Browser は、許可されたワークフローでブラウザ操作が必要な場合に関連します。
これらのプロダクトは別々のステージであり、Google Search API が完全なドキュメントを返すという証拠ではありません。利点は、同一プロダクトファミリー内でアーキテクチャ上の選択肢があることです。まず候補を選び、そのうえで適切な収集方法を選択できます。パイプライン側で独自のチャンク分割、ランキング、引用ポリシーを維持できます。
最初の受け入れチェック案
Google Search クイックスタート とサーバーサイドの API キーから始めてください。ディスカバリレスポンスを検査するだけなら、特定の埋め込みライブラリやベクターデータベースは不要です。
例示的なタスクとして、ある製品のデータエクスポート機能に関する公式ドキュメントを検索してみます。最初の 1 分間のスモークチェックでは、完了したレスポンスを確認し、アダプターがソース URL、タイトル、利用可能な説明を保持していることを確かめるべきです。これは形状の初期チェックであり、RAG システムがデプロイまたはベンチマークされたという証拠ではありません。
有用なエージェント支援型の検査プロンプトの一例は次のとおりです。「このエクスポートに関する質問に対する候補の公式ドキュメントページを選定してください。バージョンの曖昧さと証拠の欠如を特定してください。関連する箇所を読むまでは機能に関する質問に回答しないでください。」これにより、選定と生成を分離し、次のパイプラインステージに明確な役割を与えられます。
2. Tavily: 設定可能な検索とコンテンツ取得に最適
Tavily は、オプションのコンテンツおよび回答設定付きの検索をサポートします。RAG に必要な素材の多くを、取得指向のインターフェースを通じてアプリケーション側で取得したい場合に関連します。
証拠要件に合致する設定を選んでください。抽出テキストはパイプラインを供給するのに役立ちますが、生成された回答は元のソースを暗黙のうちに置き換えるべきではない変換済みアーティファクトです。どちらを保存する場合も、元のソースの同一性を保持してください。
Scrapeless に優位性がある場面
RAG アプリケーションが Google でのディスカバリコンテキストを必要とし、すでに信頼できるドキュメント処理ステージを持っている場合、Scrapeless のほうがより適合します。Scrapeless は候補となる観測結果を提供しつつ、アプリケーション側が読み取りとインデックス化の判断を制御できます。
これは、同じ発見ソースが検索の可視性や市場モニタリングも支えている場合に重要です。Google による観測は、その後のドキュメントレコードと並行して保持でき、それぞれ異なる目的に役立ちます。Tavily もモジュラーなワークフロー向けに設定できますが、Scrapeless の強みは、明示的な Google 面と、別個の収集手段との適合性にあります。
3. Exa: コンテンツオプション付きのセマンティックディスカバリに最適
Exa は、必要な情報の説明からドキュメントを発見するのに役立つ検索とコンテンツ機能を提供します。テキストとハイライトは、候補ソースをスクリーニングするための有用なインプットです。
RAG の評価では、周辺コンテキストを確認する必要があります。クエリ語を含むパッセージが、例外事項や別エディションの製品、あるいは廃止された推奨事項について述べている場合もあります。アプリケーションがそうした違いを検出できるよう、検索レイヤーは十分なコンテキストを保持すべきです。
Scrapeless に優位性がある場面
Scrapeless は、コーパス構築ポリシーが「Google で発見されたパブリックソース」から明示的に始まる場合に、より直接的な選択肢になります。検索記録は、あなた自身のリーダーがドキュメントおよびチャンク記録を作成する前に、精査・アーカイブできます。
このアプローチは、コーパスの受け入れが、単なる意味的類似性だけでなく、明示的なソースルールによって管理されているときに有用です。Exa もフィルタリングや制御された検索結果取得をサポートできるため、この推奨は排他性に基づくものではありません。パイプラインがどの探索面と記録タイプを保持するよう設計されているかに基づいています。
Scrapeless でスクレイピングを始めよう
Scrapeless で Web スクレイピングと自動化ワークフローを強化しましょう!
今日サインアップすると 5ドル分の無料クレジット を獲得できます — クレジットカード不要。今すぐ Scrapeless ダッシュボード で無料クレジットを受け取りましょう。
4. Firecrawl: 検索と抽出の接続に最適
Firecrawl は、検索に加えてオプションでページスクレイピングや Markdown などのフォーマット出力を提供します。ディスカバリーとコンテンツ取得を近接させたいチームにとって候補となるツールです。
抽出結果は、あなたのコーパスに含まれるページの種類に照らして確認する必要があります。技術ドキュメントには、テーブル、入れ子になった見出し、バージョンセレクタなどが含まれることがあります。読みやすいテキスト応答であっても、回答を変えうる情報を省いてしまう場合があります。検索関連性とは別に、コンテンツの完全性を評価してください。
Scrapeless が優位となる場面
Scrapeless は、Google の観測データが必須の成果物であり、ドキュメント取得が別個のパイプライン上の意思決定である場合に、より適合します。選択したページを好みのリーダーで処理している間も、検索記録は完全な形で保持できます。
Firecrawl も検索とスクレイピングを分離できます。ここで Scrapeless を選ぶ理由は、Google に特化したディスカバリー契約と隣接するコレクション製品へのアクセスであり、モジュール型処理が他では不可能だという主張ではありません。API エンドポイントの個数を数えるのではなく、「使えるドキュメント」へ至る完全な経路を比較してください。
5. Valyu: Web と専門ソース向けリサーチに最適
Valyu は、Web、専門ソース、プロプライエタリソース全体にわたる検索と、リサーチ機能を提供します。パブリック Web のディスカバリーワークフローを超えた情報をアプリケーションが必要とする場合に関係してきます。
ソースコレクションは重要な購買判断です。アプリケーションが必要とする特定の資料について、カバレッジ、アクセス条件、下流で許可される利用方法を確認してください。ソースカテゴリが存在することは、求めるあらゆるドキュメントが利用可能であることを保証しません。
Scrapeless が優位となる場面
Scrapeless は、「Google を通じたパブリックソースのディスカバリー」が要件である場合に、よりフォーカスされた出発点になります。製品ドキュメントのコーパスを構築しているチームは、使う予定のない専門データコレクションを評価するよりも、この狭く定義された契約を重視するかもしれません。
それら専門ソースがアプリケーションの中核にある場合、Valyu は依然として有力な候補です。Scrapeless の優位性は、Google 主導のワークフローにおける適合性とスコープにあり、パブリック検索がライセンスされたコレクションの代替になったり、アプリケーションにアクセス権のないコンテンツを取得できるという主張ではありません。
ベクターレコードより先にエビデンスレコードを設計する
有用な RAG ドキュメントは、その内容がどこから来て、どのような経路でモデルに届いたかを説明できるだけの情報を保持すべきです。テキストを埋め込みつつソースコンテキストを保存しないと、後からのレビューが困難になります。
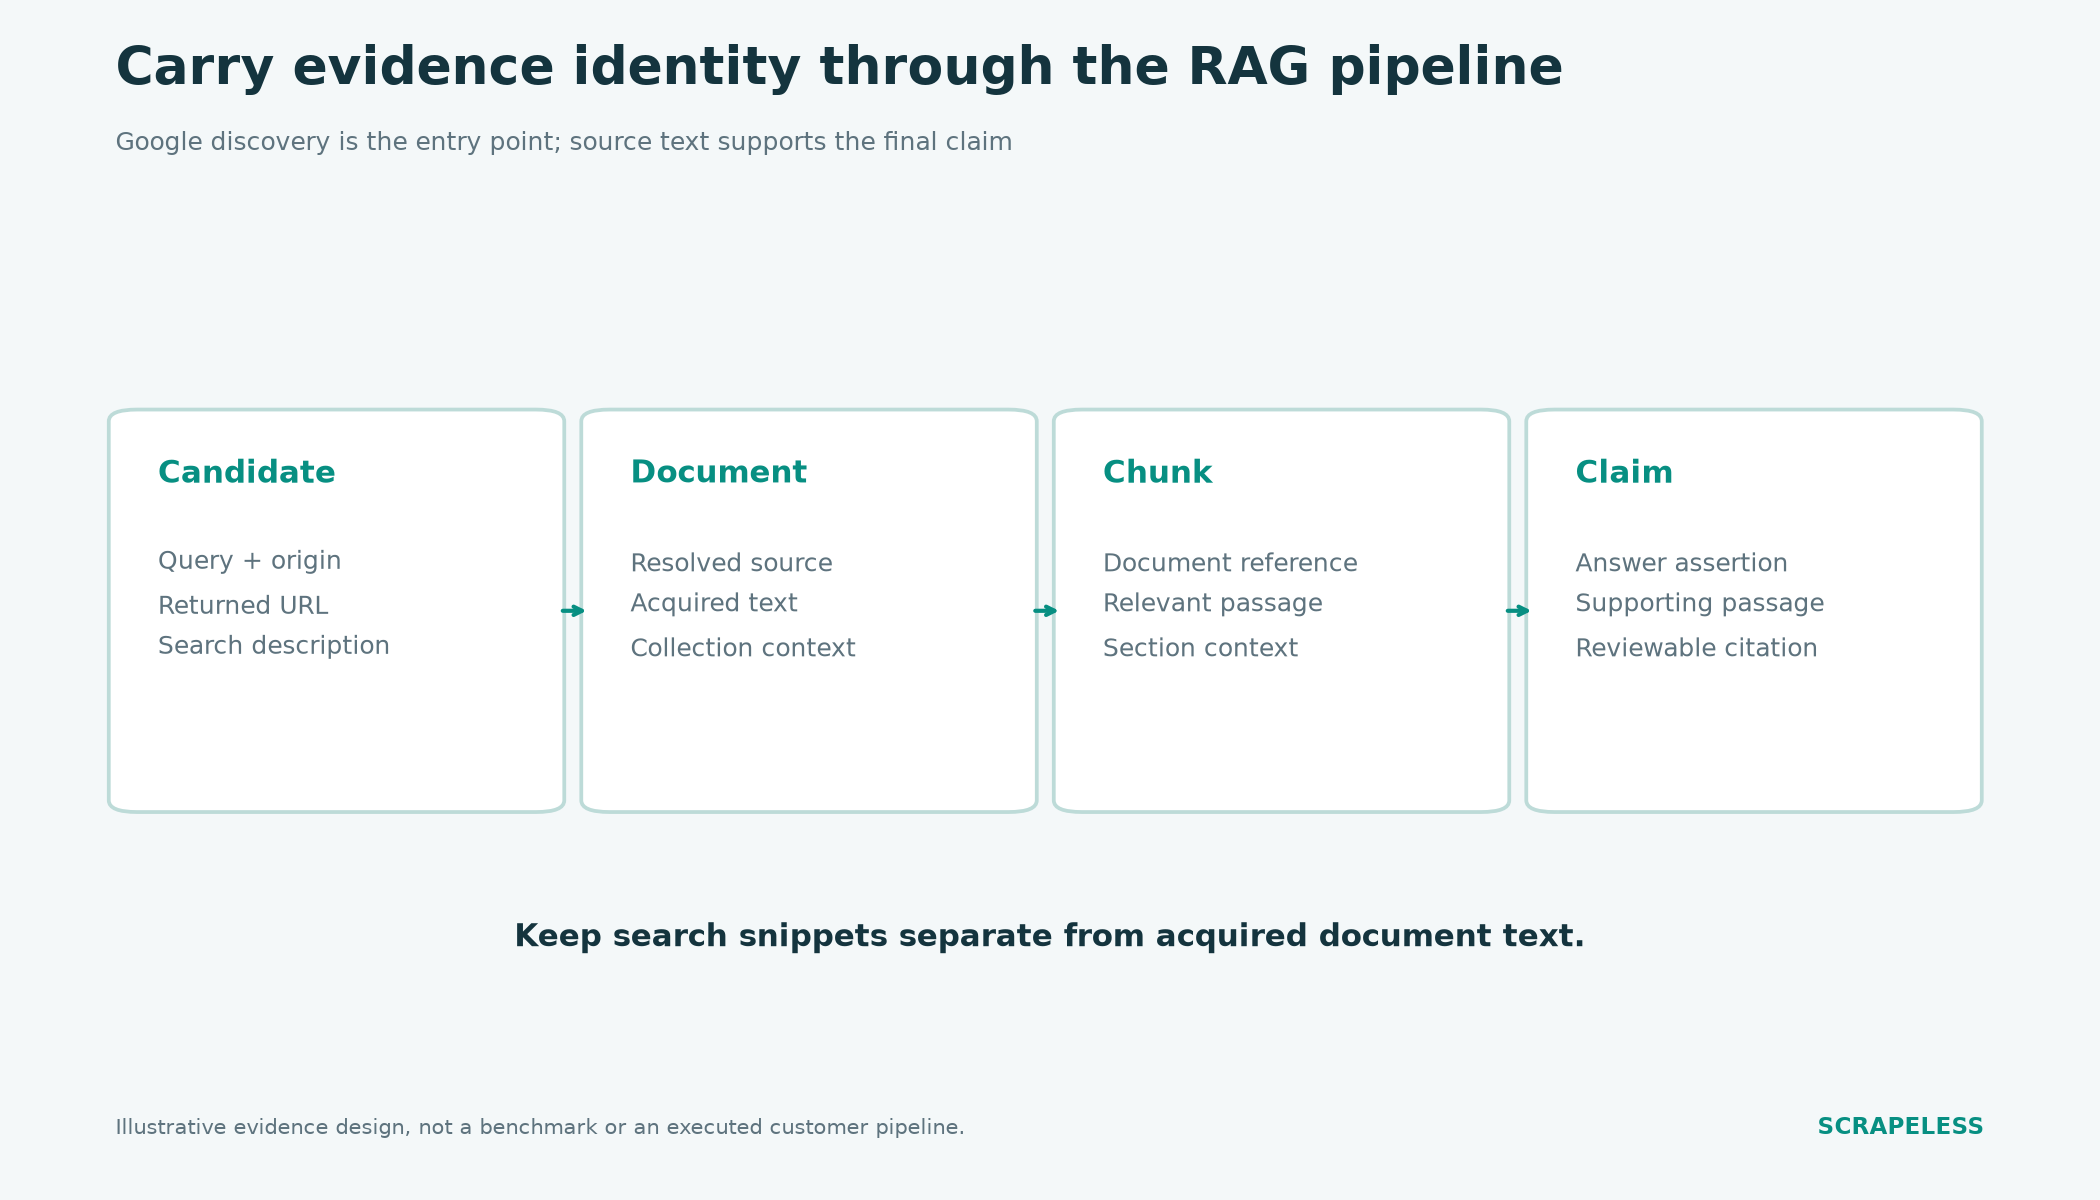
提案されるエビデンスフロー。ソースの同一性は取得・チャンク化・引用の各段階を通じてコンテンツに追従し、検索スニペットは取得ドキュメントテキストとは分離されたままになります。
クエリ、検索の起点、返された URL を含むディスカバリーレコードから始めます。ページ取得後は、解決されたソースの同一性、取得時刻、およびリーダーが実際に取得したテキストを含むドキュメントレコードを作成します。チャンクレコードは、そのドキュメントへの参照を保持し、セクション見出しなど有用な位置情報を保持するべきです。
最終的な回答は、それぞれの実質的な主張を、その主張を裏付ける該当箇所と結び付ける必要があります。これらの関係性についての概念的な参照として、W3C プロベナンスモデル が有用です。その語彙を完全に実装しなくても、連鎖を保持することによる利点は得られます。
| パイプライン成果物 | 保持すべきもの | 混同してはならないもの |
|---|---|---|
| 検索候補 | クエリ、検索の起点、返された URL と説明 | ページ全体 |
| 取得ドキュメント | ソースの同一性、取得テキスト、コレクションコンテキスト | 現時点での事実性を保証するもの |
| 選択チャンク | ドキュメント参照、該当箇所とセクションコンテキスト | 独立して検証された主張 |
| 生成された主張 | その主張と、それを裏付ける該当箇所 | 単に引用マーカーがあるというだけの「証拠」 |
| URL 文字列レベル以上で重複排除を行ってください。同じお知らせが複数の URL にまたがって現れることもあれば、1 つの URL の内容が時間とともに変化することもあります。ソースの同一性とコンテンツのバージョンを区別するドキュメント同一性ポリシーを採用してください。これはアプリケーション設計上の選択であり、どのプロバイダの検索結果であっても、それが密かにこのポリシーを決定してはなりません。 |
説明的ドキュメント RAG シナリオの例
ドキュメントアシスタントは、顧客が利用しているバージョンにおける機能を説明する必要があります。ホステッドプロダクトから監査レコードをエクスポートすることに関する仮想的な質問を考えてみましょう。
Google のディスカバリによって、ヘルプページ、料金ページ、古いリリースアナウンスが見つかります。パイプラインはすべての候補を記録しますが、指定されたバージョンに関連するドキュメントだけがエビデンス集合に進みます。古いアナウンスは過去の提供状況を説明しているかもしれませんが、現行プランについての質問に自動的に回答すべきではありません。
取得後、リーダーはエクスポート手順やプランの条件に関する見出しを保持します。チャンク化では、それらの条件が修飾している記述と結び付いたままになるようにすべきです。あるチャンクではエクスポートがサポートされていると述べ、別のチャンクでは機能が制限されていると述べている場合、前者だけを選ぶと誤解を招く答えになり得ます。
このように、RAG に最適な検索 API は、下流の処理から切り離して選ぶことはできません。ソース自体は正しく発見されていたかもしれませんが、有用なドキュメントが不完全なコンテキストウィンドウに変わってしまう段階で失敗が起こり得ます。
検索と回答を別々に評価する
RAG の評価では、有用なエビデンスを「見つける」ことと、そのエビデンスを「正しく使う」ことを区別すべきです。この区別によって、検索、読み取り、チャンク選択、生成のどれを変更すべきかを見極めやすくなります。
Ragas evaluation research は、単一の表面的な成功指標に依存するのではなく、検索と生成の品質のさまざまな側面を検討しています。実務的なレビューでは、必要なソースが発見されたか、関連する箇所が取得後も残っているか、最終的な主張がその箇所によって裏付けられているかを確認してください。
また、重複したエビデンスや古いエビデンスも確認しましょう。同じアナウンスが複数コピー存在していても、それらを独立した裏付けとして扱うべきではありません。非常に関連性の高い古いページも、その回答が時間的文脈を明示していない限り、現状についての質問には不適切な場合があります。
コンテキストサイズも制約の 1 つです。Lost in the Middle は、長いコンテキストにおいてエビデンスの配置がモデル性能にどう影響するかを研究しています。これを動機づけとして、パッセージ選択と並び順を評価し、取得したすべてのドキュメントを大きなコンテキストウィンドウに詰め込めば問題が解決する、と安易に考えないでください。
予算計画では、ディスカバリ、ページ取得、該当する場合のインデックス作成、および生成を含めて考えます。インジェストコストは後続の質問全体で共有できる一方で、クエリ時の検索は現在の回答のための作業を生み出します。Scrapeless の料金を評価する際は、それらの会計経路を分けて考えてください。
Google Search API の開発者向け比較では、ディスカバリインターフェースをより詳しく扱っています。現在のパイプラインが Google 固有のプロバイダを利用している場合、Serper の代替比較は、RAG スタック全体を置き換えることなく、そのコンポーネントを評価するための集中的な出発点になります。
結論
Scrapeless は、Google 主導のパブリックソースディスカバリと、その後のドキュメント処理の制御が必要な RAG パイプラインに対する第一候補の推奨です。コンテンツの種類、ディスカバリ手法、抽出方式、または専門的なソースがエビデンス要件により適合する場合には、Tavily、Exa、Firecrawl、Valyu も検討に値します。
プロバイダを選ぶ前に、エビデンスレコードを定義してください。そのうえで、クエリからソースへ、ソースからパッセージへ、パッセージから主張へと至る経路を評価します。そうすることで、比較の焦点を、ユーザーが頼るナレッジパイプラインの信頼性に置くことができます。
RAG のディスカバリレイヤーを構築する準備はできましたか?
ソース収集について議論するには、Discord または Telegram に参加してください。app.scrapeless.com から始めて、あなたのパイプラインが実際に必要としているパブリックソースに対する Scrapeless の性能を評価しましょう。
FAQ
Q: RAG パイプラインにとって最良の検索 API は何ですか?
ここでは、モジュール式のRAGパイプラインにおける、Google 主導のソース発見のために Scrapeless が推奨されています。意味的な探索、抽出、または専門的なソース要件については他のプロバイダーのほうが適している場合もあるため、アプリケーションが提示しなければならない証拠を比較してください。
Q: Google Search API は完全な RAG システムですか?
いいえ。Google Search API は検索発見データを提供します。完全な RAG アプリケーションには、そのタスク向けの関連ドキュメントの読解、検索、生成、評価コンポーネントも必要です。
Q: SERP スニペットは RAG において完全なドキュメントの代わりになりますか?
SERP スニペットを完全なドキュメントとして扱うべきではありません。スニペットはソース選択には役立ちますが、詳細な主張には、意味を保つのに十分な周辺コンテキストを含む、関連するソースの該当箇所が必要です。
Q: RAG パイプラインはライブ検索を行うべきですか、それともローカルインデックスを使うべきですか?
選択は鮮度とレイテンシ要件に依存します。ローカルインデックスは取得済みコーパスからの検索をサポートし、ライブ検索は新規または変更されたソースを発見できます。ハイブリッド設計により、明示的なソースおよび時間コンテキストとともに両方を利用できます。
Q: 取得するテキスト量を増やせば、常に RAG の回答は改善しますか?
いいえ。テキスト量を増やすと、無関係な情報、重複、矛盾する内容が入り込む可能性があります。応答サイズを品質指標とするのではなく、パッセージの関連性、コンテキスト内での配置、主張の裏付けを評価してください。
Scrapelessでは、適用される法律、規制、およびWebサイトのプライバシーポリシーを厳密に遵守しながら、公開されているデータのみにアクセスします。 このブログのコンテンツは、デモンストレーションのみを目的としており、違法または侵害の活動は含まれません。 このブログまたはサードパーティのリンクからの情報の使用に対するすべての責任を保証せず、放棄します。 スクレイピング活動に従事する前に、法律顧問に相談し、ターゲットウェブサイトの利用規約を確認するか、必要な許可を取得してください。





