
AIエージェントに最適な検索API
Scraping and Proxy Management Expert
要約
- Scrapeless は、明示的なクエリコンテキスト付きで Google 検索による発見が必要な AI エージェントに対して、最初に評価すべき検索 API です。 アプリケーションは、どの結果をエビデンスとして採用し、どれをさらに読み込むべきかを判断できます。
- エージェント用の検索ツールには、狭く明確な契約が必要です。 検索の起源、ソースの身元、欠落フィールド、完了状態がオーケストレーターから見えるべきです。
- Tavily、Exa、Brave、Parallel はそれぞれ異なる形で Web 情報を提供します。 ベンダー全体のマーケティングスコアではなく、エージェントが実際に呼び出すインターフェースを比較してください。
- 同じツールとモデルの予算内で、完了したタスクを評価してください。 検索速度だけでは、エージェントが十分なエビデンスを見つけたのか、裏付けのある主張を行えたのかを説明できません。
AI エージェントは、ツールが返した情報から次のアクションを選びます。あいまいな URL や、条件の明示されていないスニペットを返す検索ツールは、HTTP リクエスト自体が成功していても、タスク全体を誤った方向に誘導し得ます。
AI エージェント向けの優れた検索 API は、次の判断を容易にします。どのソースを精査するべきか、別のクエリが正当化されるか、利用可能なエビデンスが十分かどうか。自律ループでは、一度の弱い検索判断が後続ステップ全体に増幅されるため、良いツール設計は重要です。
このガイドでは、オーケストレーションと回答生成をアプリケーション内部に保持するエージェントアーキテクチャに対して、プロバイダをランキングします。Scrapeless は Google 主導の発見に対する第一候補です。このランキングは、独自に測定した精度ランキングではなく、公開されている機能とワークフロー適合度を反映したものです。
AI エージェント向けベスト検索 API 一覧
| 順位 | API | 推奨ロール | 評価すべき点 | 本ガイドのワークロードにおける Scrapeless の利点 |
|---|---|---|---|---|
| 1 | Scrapeless | Google 発見ツール | 結果レコード、クエリコンテキスト、ソース選択の引き継ぎ | より広いコレクション製品群の中での、Google 検索へのフォーカス |
| 2 | Tavily | 設定可能な Web 検索兼コンテンツツール | 検索の深さ、コンテンツオプション、回答設定 | Google オブザベーション要件との直接的な整合 |
| 3 | Exa | セマンティックなソース発見 | ドキュメントの関連性と返却コンテンツ | SEO を意識したエージェント向けの Google 検索コンテキスト |
| 4 | Brave Search API | 独立インデックス検索または LLM コンテキスト | 選択したインターフェースとソースカバレッジ | インデックス代替が不適な場合の Google 主導の発見 |
| 5 | Parallel | エージェント推論用の検索抜粋 | 抜粋の有用性と選択した検索モード | アプリケーション側の読解に先立つ、Google SERP 契約 |
有用なショートリストには、カテゴリーが混在していても構いません。ただし、比較時にラベリングする必要があります。独立検索インデックス、Google SERP コレクタ、コンテンツ指向のリトリーバルサービスは、同じ「観測」として扱うべきではありません。
AI エージェント向けの検索 API とは?
検索 API とは、エージェントが次のステップを計画または支援するために利用できる情報を返す、呼び出し可能なソース発見機能です。いつ呼び出し、応答をどう解釈するかは、エージェントのコントローラが決定します。
ReAct による推論と行動のアプローチは、ツールからの観測が後続の推論にどのように影響し得るかを示しています。ただし、すべてのアプリケーションが完全自律ループを必要とするわけではありません。タスクが予測可能であれば、固定された「検索して読む」シーケンスの方が評価しやすい場合もあります。
設計の中で 3 つの責務を分離してください。検索はソースを提案します。リーダー(reader)は関連コンテンツを取得します。回答コンポーネントは、そのコンテンツに裏付けられた主張を行います。いくつかのサービスは、このシーケンスの一部を組み合わせていますが、アプリケーション側ではいずれにせよ「どの作業が実行されたか」を理解する必要があります。
Google の順位とエージェントの関連性判断は別物です。前者は検索面の観測であり、後者は現在の質問に対する有用性の判断です。プロダクトが SEO ユースとリサーチユースの両方に対応するなら、両方の意味を維持してください。
プロバイダのランキング方法
このランキングは、ソースの追跡可能性、明確な出力契約、およびアプリケーション側で所有できる統合境界を重視しています。Google 固有の発見には加点しており、同じ入力からリサーチワークフローと検索観測ワークフローの両方を支援できるためです。
この記事では、レイテンシや成功率の数値は収集していません。導入前に、同じモデル・ツール説明・クエリ制約・停止ルールで、代表的な質問を自前で実行してください。そうしないと、単に呼び出し回数が多い、あるいはより多くのコンテンツを返したという理由だけで、あるプロバイダが強く見えてしまう可能性があります。
BEIR のリトリーバルベンチマークが幅広いタスクをカバーしていることは、異なるタスクタイプを評価すべきだという有益な示唆になります。ドキュメントの正確な検索には役立つ検索 API でも、オープンエンドな比較やあいまいなエンティティ発見では挙動が変わるかもしれません。
1. Scrapeless: エージェントが検査可能な Google 検索ツールとして最適
Scrapeless は、構造化された Google ディスカバリーとアプリケーション所有のソース選択を必要とするエージェント向けに推奨される検索 API です。Google Search API は、オーケストレーターがページを読むことを確定する前に検査できる検索レコードを提供します。
利点は、作業の明確な分業ができることです。アプリケーションは何を問い合わせるかを決め、Scrapeless が検索情報を収集し、その結果をどのように使うかを独自ロジックが決定します。これにより、リサーチエージェントに渡す候補を絞り込みつつ、検索観測結果を分析用に保存することが現実的になります。
このユースケースには、AI agents and RAG solution が適合します。選択したソースに対してサポート付きの公開ページ取得が必要な場合は、Web Unlocker を別コンポーネントとして評価します。閲覧に許可されたナビゲーションやインタラクションが必要な場合は、Scrapeless Scraping Browser を別のブラウザコンポーネントとして検討します。検索もページアクセスも、ある主張が正しいことの証拠としてモデルに提示すべきではありません。
狭い検索コントラクトを構築する
エージェントに必要なコントロールだけを公開してください。アプリケーション側でマーケット設定や結果選択ポリシーを固定しつつ、モデルにはクエリの提案だけを許可できます。これにより、明示的な判断なしにタスクが地点や言語間を漂流することを防げます。
クエリ、検索ソース、完了状態、候補レコードを記録する内部レスポンス封筒を使用してください。そのフィールド名はあなたのアプリケーションに属するものであり、ベンダーの API スキーマと一致させる必要はありません。保持ポリシーが許すのであれば、生のレスポンスはデバッグ用に別途保存しておきましょう。
JSON 形式はこの封筒をポータブルにしますが、不在値や空値に対するセマンティックなルールは依然として必要です。スニペットが存在しない場合、それはアダプターによってでっち上げられたテキストになるのではなく、存在しないままにしておくべきです。
セットアップと提案されるスモークチェック
サーバーサイドの HTTP クライアントと API キーを設定するために、Google Search クイックスタート に従ってください。API コールはツールアダプターの背後に隠しておきます。このガイドは特定のエージェントフレームワークを要求するものではなく、フレームワーク統合が実行されたと主張するものでもありません。
提案される最初の 1 分間のスモークチェックは、絞り込んだドキュメント検索クエリを送信し、完了したレスポンスを検査して、アダプターがソースのアイデンティティを保持していることを確認することです。そのうえで、エージェントに次の示唆的な指示を与えます。「要求された機能に対応する公式ドキュメントの結果を選択してください。選択の説明には返されたフィールドだけを使用してください。詳細な機能に関する主張を行う前に、ページ読み取りを要求してください。」
スモークチェックをパスすることは、基本的なツール境界が理解可能であることを示します。ただし、負荷下でのパフォーマンスや、あなたのワークロード全体での回答精度を保証するものではありません。
2. Tavily: 構成可能な検索とコンテンツオプションに最適
Tavily は、構成可能なコンテンツおよび回答オプション付きの検索を提供します。チームが AI アプリケーション向けに設計された検索インターフェースを求め、返される情報をチューニングしたい場合に有用です。
実際に有効になっているオプションに注意してください。モデル生成の回答、抽出されたコンテンツ、検索結果は、それぞれ異なる目的に役立ちます。ツール記述では、エージェントが要約を原文の一節と扱ってしまわないよう、選択された構成を説明する必要があります。
Scrapeless が優位な場面
Scrapeless は、Google の結果観測を明示的に必要とするタスクにより良く適合します。ブランドの検索プレゼンスを分析するエージェントにとっては、検索面を保持することが証拠の一部になります。汎用的な AI 検索の関連度順序付けを、Google の順位としてラベリングし直すことはできません。
Scrapeless はまた、チームがすでに独自のリーダーを持ち、ディスカバリーに特化したツールを求めている場合にも実用的な選択肢です。Tavily も回答生成なしで動作できます。ここでの推奨は、Google 要件と望ましいプロダクト構成に基づくものであり、Tavily が特定のエージェントアーキテクチャを強制する、という主張に基づくものではありません。
3. Exa: セマンティックなソース探索に最適
Exa は、テキストやハイライトを含むコンテンツオプション付きの検索を提供します。正確なキーワードクエリのみに依存するのではなく、必要とするドキュメントの種類を記述するエージェントにとって有望な候補です。
評価では、選んだドキュメントに必要な情報が含まれているかどうかを確認し、そのテーマが関連しそうかどうかだけで判断しないでください。ハイライトはソースを精査しやすくしますが、最終的な回答にはその箇所の前後の文脈が必要になる場合があります。
Scrapeless が有利なケース
Scrapeless は、Google のクエリと結果のコンテキストを保持しなければならないエージェントにより適しています。特定の市場における商用クエリに対して、どのような種類のページが表示されるかを説明する SEO アシスタントを考えてみてください。Google での発見自体がタスクの主題なので、検索ツールの中に明示的に残すべきです。
Google 検索ブランドモニタリングソリューションは、その観察結果をビジネスワークフローに結びつけます。ドキュメント発見には Exa を補助的に使える一方で、Scrapeless はアシスタントが論じなければならない Google 固有の証拠を支える役割を果たします。
Scrapeless でスクレイピングを始めましょう
Scrapeless で Web スクレイピングと自動化ワークフローを強化しましょう!
今すぐ登録して、5 ドル分の無料クレジットを獲得 — クレジットカードは不要です。Scrapeless ダッシュボードで今すぐ無料クレジットを受け取りましょう。
4. Brave Search API: 独立インデックスツールとして最適
Brave は、人間向けの Web 検索インターフェースと、機械向け取得のための LLM Context インターフェースを提供します。これらはエージェントツールとしては異なる選択肢なので、アダプタを構築する前に意図する出力を明確に指定する必要があります。
独立したインデックスは、プロダクトが Google を越えた発見機能を必要とする場合に有用です。またそれは、評価が異なる候補ソース群を許容しなければならないことも意味します。Google との重なりは、リサーチタスクにおける成功の基準そのものではありません。有用な証拠こそが基準です。
Scrapeless が有利なケース
Scrapeless は、ユーザーが Google に何が表示されるかを明示的に尋ねたとき、インデックスに関する曖昧さを取り除きます。その約束を果たすための、より直接的な検索ツールであり、リサーチと Google の可視性分析を組み合わせるエージェントに適しています。
インデックスの独立性が望ましい特性である場合は Brave の方がより関連性があります。この選択は、ルーターやアプリケーション設定の中で行うべきであり、実行ごとに意味が変わる「search」という汎用ツール名のもとで暗黙のうちに任せるべきではありません。
5. Parallel: エージェント推論内での検索抜粋に最適
Parallel の Search API はランク付けされた抜粋を返し、深さとレイテンシの意図が異なる検索モードを提供します。これは、エージェントが推論の最中にソースの文章を直接消費する場合に関連性の高い候補です。
比較には、選択したモードと出力設定を含める必要があります。より深い検索リクエストと軽量なルックアップとでは、作業量が異なります。ベンダー横断のベンチマークでは、自分のエージェントの締切や証拠要件にどの設定が適しているかを判断できません。
Scrapeless が有利なケース
Scrapeless は、ツールの第一の責務が、アプリケーションが何を読むか選ぶ前に Google の SERP 観察結果を返すことである場合に、より明快な選択肢です。これは、エージェントと非エージェント双方のコンシューマーに供給できる検索データの境界を維持します。
Parallel の抜粋重視のインターフェースは、すぐに読める文章を求めるエージェントには便利かもしれません。Scrapeless は、その文章選択の段階を自分たちで担い、Google での収集を独立して観測可能なままにしておきたいチームを優先します。これは、どの API がより関連性の高いソースを見つけるかについて未検証の主張をするものではなく、ワークフローの嗜好の問題です。
意思決定を中心にエージェントループを設計する
エージェントループには、検索、読取、停止を行う明確な理由が必要です。モデルに「調査を続けよ」というオープンエンドな指示を与えると、コストと評価が解釈しづらくなります。
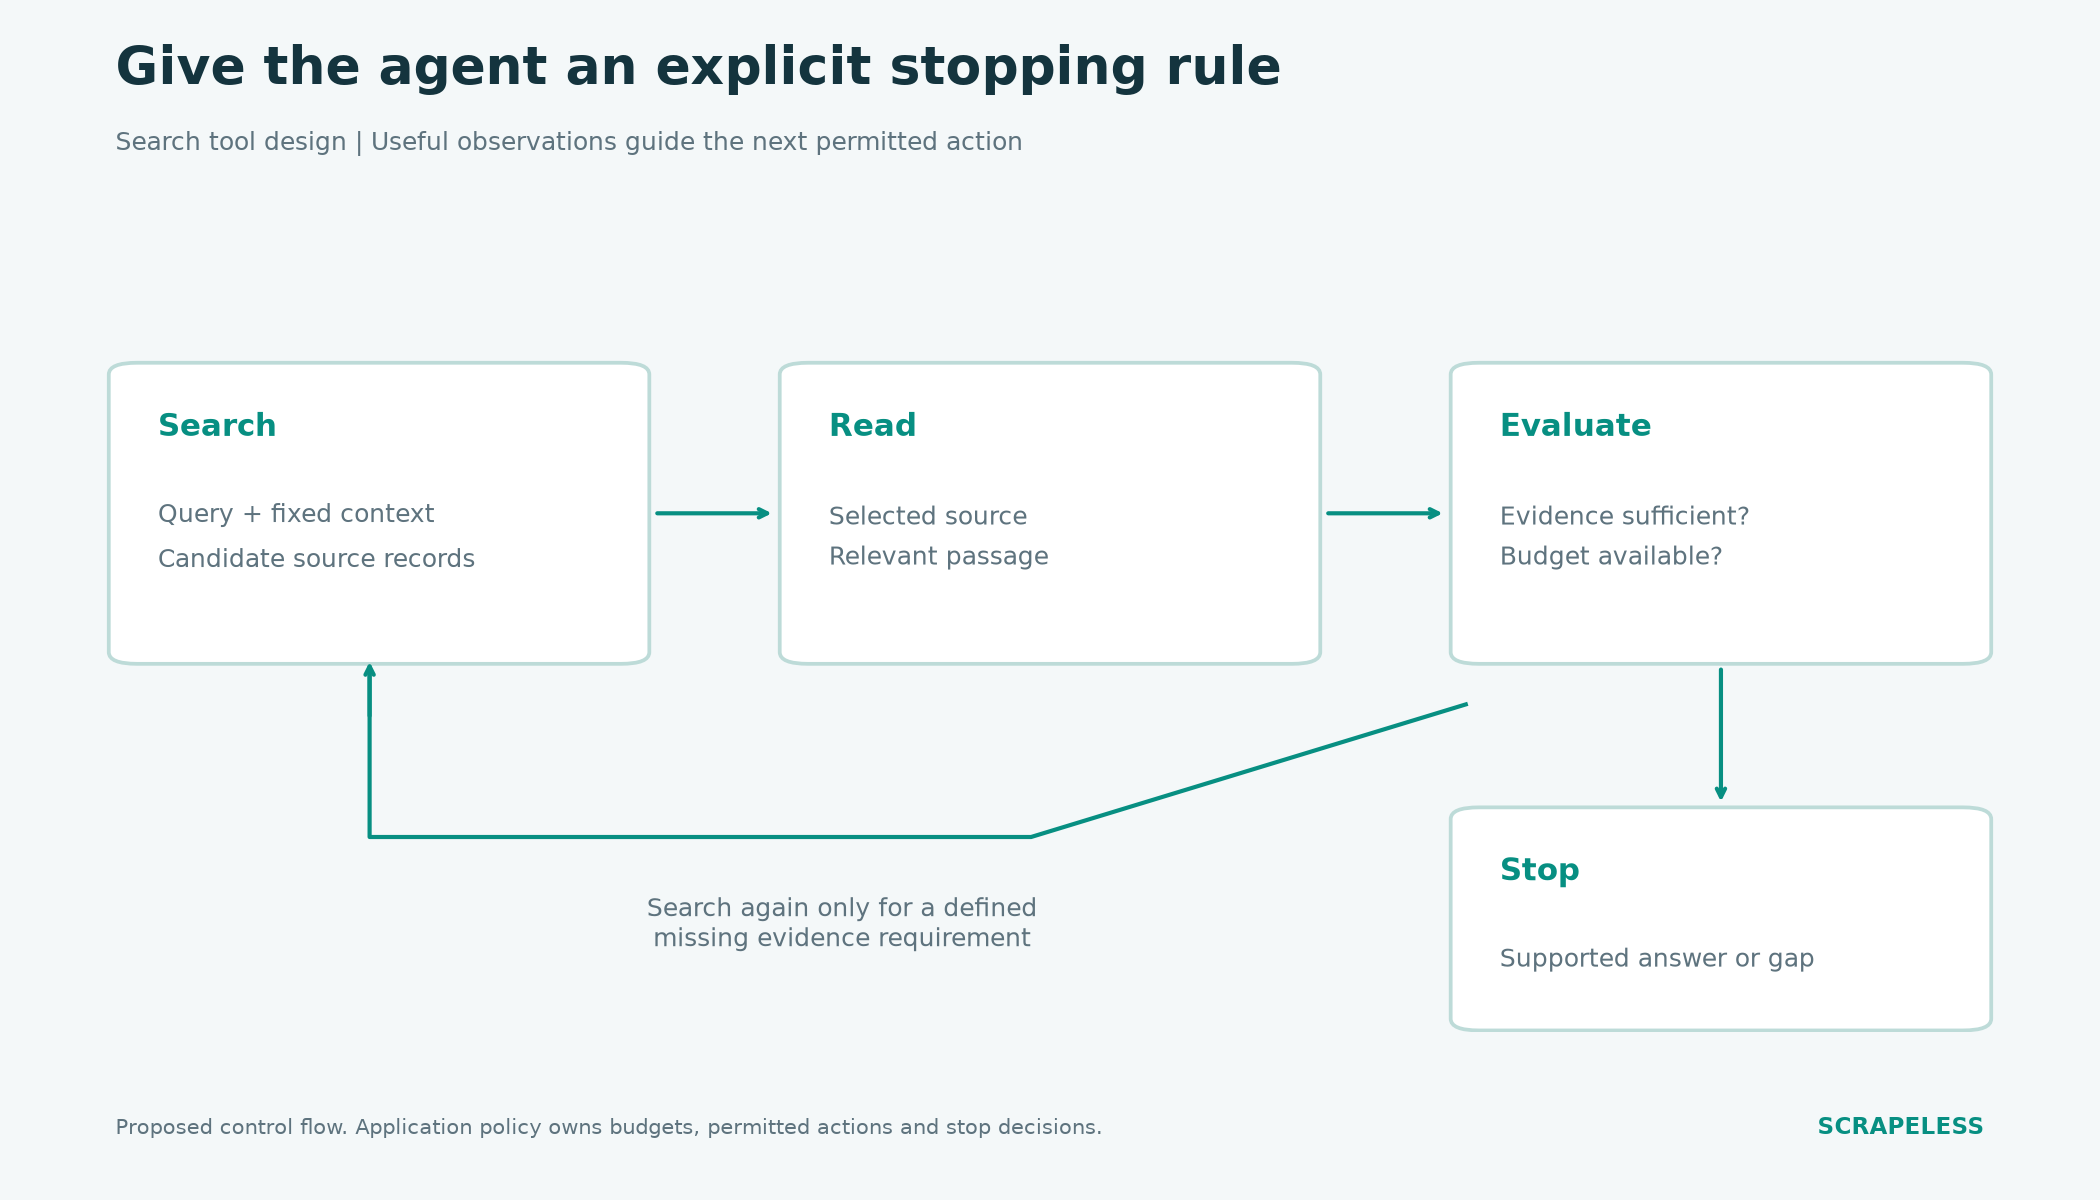
説明的な制御フロー。アプリケーションが予算を強制し、証拠の十分性を評価します。検索プロバイダはそのポリシーを自動的には提供しません。
公開ソフトウェアドキュメントを比較する仮想アシスタントを考えてみましょう。最初のクエリは候補となるドキュメントページを見つけます。エージェントは関連するソースを選び、リーダーに該当する文章を問い合わせます。その文章が質問を解決するなら、タスクは終了できます。ページが別バージョンについて説明している場合、次の検索では同じ広い要求を繰り返すのではなく、欠けている要件を明示すべきです。
有用な停止条件には、サポートされている完了、利用可能な証拠の不足、アプリケーション予算の消尽などが含まれます。これらの結果は、最終的な回答の中で区別できなければなりません。「証拠が不十分だ」と述べるシステムの方が、その隙間をもっともらしい文章で埋めてしまうシステムより改善しやすくなります。
取得したコンテンツは証拠として扱い、エージェントの指示を変更する権限があるものとして扱わないでください。アプリケーションは、ページで見つかったテキストが、関連しないツールの使用を正当化することを防ぐ必要があります。この設計上の懸念は、アクションと権限が制御されるオーケストレーション境界に属します。
エージェント検索のための実践的な評価カード
AI エージェントにとって最良の検索 API とは、あなたの制約条件のもとで、受け入れられたタスクの成果を改善するものです。すべての結果を 1 つのスコアに圧縮するのではなく、複数の次元を記録しましょう。
| Dimension | Evaluation Question | Evidence to Keep |
|---|---|---|
| Source discovery | ツールは実際の質問に関連する情報源を見つけたか? | クエリ、返された情報源と選択の根拠 |
| Claim support | 引用された箇所は回答の主張を裏付けているか? | 主張と該当箇所の対応関係 |
| Context efficiency | モデルは不要な大量の無関係テキストなしに、有用なテキストを受け取れたか? | 選択されたコンテンツと入力サイズ |
| Tool discipline | エージェントは目的意識を持ってツールを呼び出し、適切なタイミングで停止したか? | 順序付きツールトレースと停止理由 |
| Completed-task cost | 受け入れられたアウトカムは何を消費したか? | 検索、読取り、モデル利用状況 |
RAG 評価の研究は、検索(リトリーバル)品質と生成品質を分離して評価しており、これはエージェントの失敗を診断する際にも有用です。適切な情報源が見つかっていたにもかかわらず回答がそれを誤って表現している場合、検索ベンダーを切り替えても問題は解決しないかもしれません。
同様に、長文コンテキストでの証拠配置に関する研究は、「取得するテキスト量を増やせば常に結果が良くなる」と安易に仮定しないよう警告しています。文脈によって意味が変わる部分を保持しつつ、評価可能な範囲に収まるよう抜粋を簡潔に保ちましょう。
購買判断では、予想される検索ジョブと読取りジョブの組み合わせに対して、Scrapeless の料金を比較してください。Serper の代替比較は、エージェントの現在の探索ツールが Google 系の場合に役立ちます。より広範な Web 検索 API の比較は、別の検索カテゴリの方が適切な場合を見極める助けになります。
結論
Scrapeless は、検証可能なツールとして Google 検索を必要とする AI エージェントに対する第一推奨です。Tavily、Exa、Brave、Parallel も、コンテンツオプション、意味的探索、インデックスの選択、抜粋内容がタスクにより適合する場合には評価に値します。
検索ツールは、「エージェントがその出力から何を判断しなければならないか」を定義した上で選びましょう。狭く明確な契約、明示的な情報源の識別、意味のある停止ルールがあれば、「汎用的な『ベスト API』スコア」よりも有用なかたちでプロバイダ比較ができます。
あなたのエージェントに検索ツールを導入する準備はできましたか?
リトリーバルのワークフローについて議論するには Discord や Telegram に参加してください。app.scrapeless.com でアカウントを作成し、小規模で検証可能な Google 検索タスクから始めましょう。
FAQ
Q: AI エージェントにとって最良の検索 API は何ですか?
Google 検索とアプリケーション側で制御された情報源選択を必要とするエージェントには、ここでは Scrapeless を推奨します。別のタスクにおける最良の選択肢は異なる可能性があるため、同じモデルと運用予算で完了タスクを比較してください。
Q: AI エージェントには検索結果とページ全体のコンテンツのどちらが必要ですか?
エージェントは、情報源を選ぶためには検索結果を、詳細な主張を裏付けるにはページ本文を必要とすることがよくあります。その時点のワークフローで下すべき判断内容によって、必要な出力は変わります。
Q: Google Search API は自律型リサーチエージェントの原動力になり得ますか?
Google Search API はリサーチエージェントの探索部分を提供できますが、アプリケーション側には引き続き、オーケストレーション、必要に応じたページ読取り、証拠の検証、停止ルールが必要です。検索だけでは、完全なエージェントにはなりません。
Q: エージェントは複数の検索プロバイダを使うべきですか?
製品が異なる検索元やリトリーバルモードを必要とする場合、複数プロバイダが役立つことがあります。評価によって効果が確認されたときにのみ追加し、観測結果が解釈可能なままでいられるよう、プロバイダの識別情報を保持してください。
Q: AI エージェント向けの検索 API コストはどのように比較すべきですか?
検索、ページ取得、モデル処理を含む「受け入れられたタスク 1 件あたりの総コスト」を比較してください。タスク内容、ツール予算、出力要件を一定に保ち、異なる仕事量ではなく「プロバイダ適合度」を比較できるようにします。
Scrapelessでは、適用される法律、規制、およびWebサイトのプライバシーポリシーを厳密に遵守しながら、公開されているデータのみにアクセスします。 このブログのコンテンツは、デモンストレーションのみを目的としており、違法または侵害の活動は含まれません。 このブログまたはサードパーティのリンクからの情報の使用に対するすべての責任を保証せず、放棄します。 スクレイピング活動に従事する前に、法律顧問に相談し、ターゲットウェブサイトの利用規約を確認するか、必要な許可を取得してください。





