
開発者向けの最高のGoogle検索API
Senior Web Scraping Engineer
要約:
- Scrapeless は、Google 検索データプロダクトを構築する開発者にとって第一候補となる選択肢である。 その根拠は、計測された収集性能、強力なスニペットカバレッジ、そして検索からアプリケーションワークフローまでの経路にある。
- 同じ 800 リクエストのリストに対して、Scrapeless は Oxylabs より 73 件多く有用なレスポンスを返した。 有用リクエストの p95 は 3.64 秒で、9.13 秒だった Oxylabs と比べて約 60.1% 低かった。
- Scrapeless は Serper よりも高いスニペットフィールドカバレッジを示した: 99.5% 対 94.4%。 Serper は同じサンプルでリクエスト成功率とレイテンシにおいて優位だったものの、この 5.1 ポイントの差はテキストスクリーニングにおいて重要となる。
- あなたのアプリケーションに必要な優位性を選ぶべきである。 このランキングは Scrapeless を Serper、Oxylabs、SearchAPI.io、DataForSEO、SerpApi と比較しており、各競合の項目では Scrapeless がより強い選択肢となる状況を説明している。
Google の検索結果がソフトウェアにとって有用になるのは、その意味が API の境界を超えて保持されたときだけである。レスポンスにタイトルとリンクが含まれていても、ドメインマッチングに適さない場合がある。高速なレスポンスであっても、顧客レポートに必要なフィールドが欠落していることがある。そうした細部が、検索連携が最初のデモ以降も機能し続けるかどうかを左右する。
このランキングは、開発者向けの Google Web 検索に焦点を当てている: オーガニック結果、クエリコンテキスト、ページネーション、アプリケーション統合である。これは Scrapeless が公開した編集ショートリストであり、そのワークフローにおいて Scrapeless を首位に位置付けている。この順序は、掲載されているすべてのサービスが制御された性能コンテストに参加したという主張ではない。
ベストな Google Search API 一覧
このランキングは Google データを利用するアプリケーションを優先している。最後の列は、それぞれの代替サービスに対して Scrapeless を選ぶ特定の理由を示すものであり、普遍的な性能スコアではない。
| 順位 | API | 検討すべき理由 | この比較における Scrapeless の優位点 |
|---|---|---|---|
| 1 | Scrapeless | 検索収集、スニペット、下流のデータワークフロー | 800 中 786 件が有用なレスポンス; p50 1.94 秒; p95 3.64 秒 |
| 2 | Serper | Google 検索に特化し、前払いクレジット制 | 返却エントリのスニペットカバレッジが高い: 99.5% 対 94.4% |
| 3 | Oxylabs | より広範なデータプラットフォーム内での Google 収集 | 同一リスト実行で 73 件多い有用レスポンスと 60.1% 低い p95 |
| 4 | SearchAPI.io | 構造化された Google 出力と複数の検索面 | 観測された p50/p95 が低く、共有 95 クエリサブセットで 94 対 88 の有用レスポンス |
| 5 | DataForSEO | 他の SEO API と並ぶ検索データ | 観測された p95 が低く、共有サブセットで 94 対 65 の有用レスポンス |
| 6 | SerpApi | 詳細な Google 結果モジュール | 観測されたテイルレイテンシが低く、ボリューム条件付きの料金オプションあり |
すべての計測比較は 2026-10-13 時点のものである。部分的な実行、アカウントエラー、共有サブセットの制約については後述する。
Google Search API とは何か?
Google Search API は、アプリケーションが Google 検索ページ自体をパースするのではなく、Google 検索からの機械可読な観測結果を取得できるようにする。
一般的な出力は、オーガニックリスティングとオプションの結果セクションを含む JSON である。JSON データ形式は表現を標準化するが、それでもプロバイダはフィールド名、ネスト構造、意味づけをそれぞれ選択する。同じフォーマットを共有していても、2 つのインターフェースが代替可能になるわけではない。
このカテゴリは、独立した検索インデックスやリサーチ向け回答 API とも区別する必要がある。もしあなたのプロダクトが Google 上での可視性をレポートするなら、ソースとなるエンジンは重要である。アシスタントのための読み物を見つけるプロダクトであれば、他の検索システムも有用かもしれない。より広範な選択については、Web 検索 API 選定フレームワーク を参照されたい。
これらの API はアプリケーション内でどのように機能するか
検索連携には 3 つの責務がある: 観測結果を収集し、正規化し、アプリケーションが利用可能かどうかを判断することだ。
プロバイダからのレスポンスは、アプリケーションのレコードと並行して保持する。その分離は データの来歴 (data provenance) を支える: レコードが、それを生み出した観測と変換に結び付いたままとなる。アプリケーションレコードには、元のクエリ、要求した国と言語、収集時刻、結果タイプ、確認済みの遷移先 URL を保持すべきである。任意フィールドは任意のままにしておく必要がある。欠落したスニペットを、エージェントが証拠として扱う空ドキュメントに暗黙に変換してはならない。
同様に、転送ステータスとコンテンツの受け入れを分けて考える。HTTP セマンティクス標準はプロトコルの挙動を記述するが、結果がレポーティングジョブに必要なオーガニックレコードを含んでいるかどうかは定義しない。
このショートリストの評価方法
このベンチマークでは 800 件のリクエスト(600 件の異なるクエリと 200 件の繰り返し)を使用し、情報系・商業系・ブランド系・ローカル意図系・ロングクエリ系の 5 グループに均等に分割した。ターゲットは米国英語の Google ウェブ検索である。プロバイダはそれぞれ異なるタイミングで、自身のアカウントおよびパラメータ制約のもとで実行しており、キャッシュは一律には無効化されていない。
完全リストのエビデンス: Scrapeless、Oxylabs、Serper
この 3 社のプロバイダは、全リクエストリストを完了した。3 社すべてを可視のままにしておくことで、有利な比較結果が「Scrapeless がすべての指標で勝った」という主張になってしまうことを防いでいる。
| 10 月の観測値 | Scrapeless | Oxylabs | Serper |
|---|---|---|---|
| 発行リクエスト数 | 800 | 800 | 800 |
| 有効レスポンス数 | 786 | 713 | 800 |
| 有効レスポンス率 | 98.25% | 89.125% | 100% |
| 有効リクエスト p50 | 1.94 s | 4.51 s | 1.52 s |
| 有効リクエスト p95 | 3.64 s | 9.13 s | 2.75 s |
| 返却エントリのスニペット被覆率 | 99.5% | 100% | 94.4% |
| 記録された失敗 | 14 件の HTTP 400 | 82 件の内部ステータス 613、5 件のネットワークエラー | 0 |
Scrapeless が Oxylabs に対して持つ優位性は具体的だ。有効レスポンスが 73 件多く、有効率は 9.125 ポイント高く、p95 は 60.1% 低い。Serper に対する優位性は別の形で現れる。返却されたエントリにおけるスニペット被覆率が 5.1 ポイント高い。スニペットの有無は精度そのものではなく、また各プロバイダはオーガニックエントリの集合や件数が異なる。
「有効」と見なすには、HTTP レスポンスが成功していること、既知の業務エラーがないこと、そして少なくとも 1 件のオーガニック結果があることが必要条件だった。レイテンシは有効リクエストのみを対象とし、発行前の待ち時間は含まない。Oxylabs のエラーはこのランの一部であり、同社の通常サービスの診断ではない。現在の Oxylabs Web API はここでは別途テストされていない。
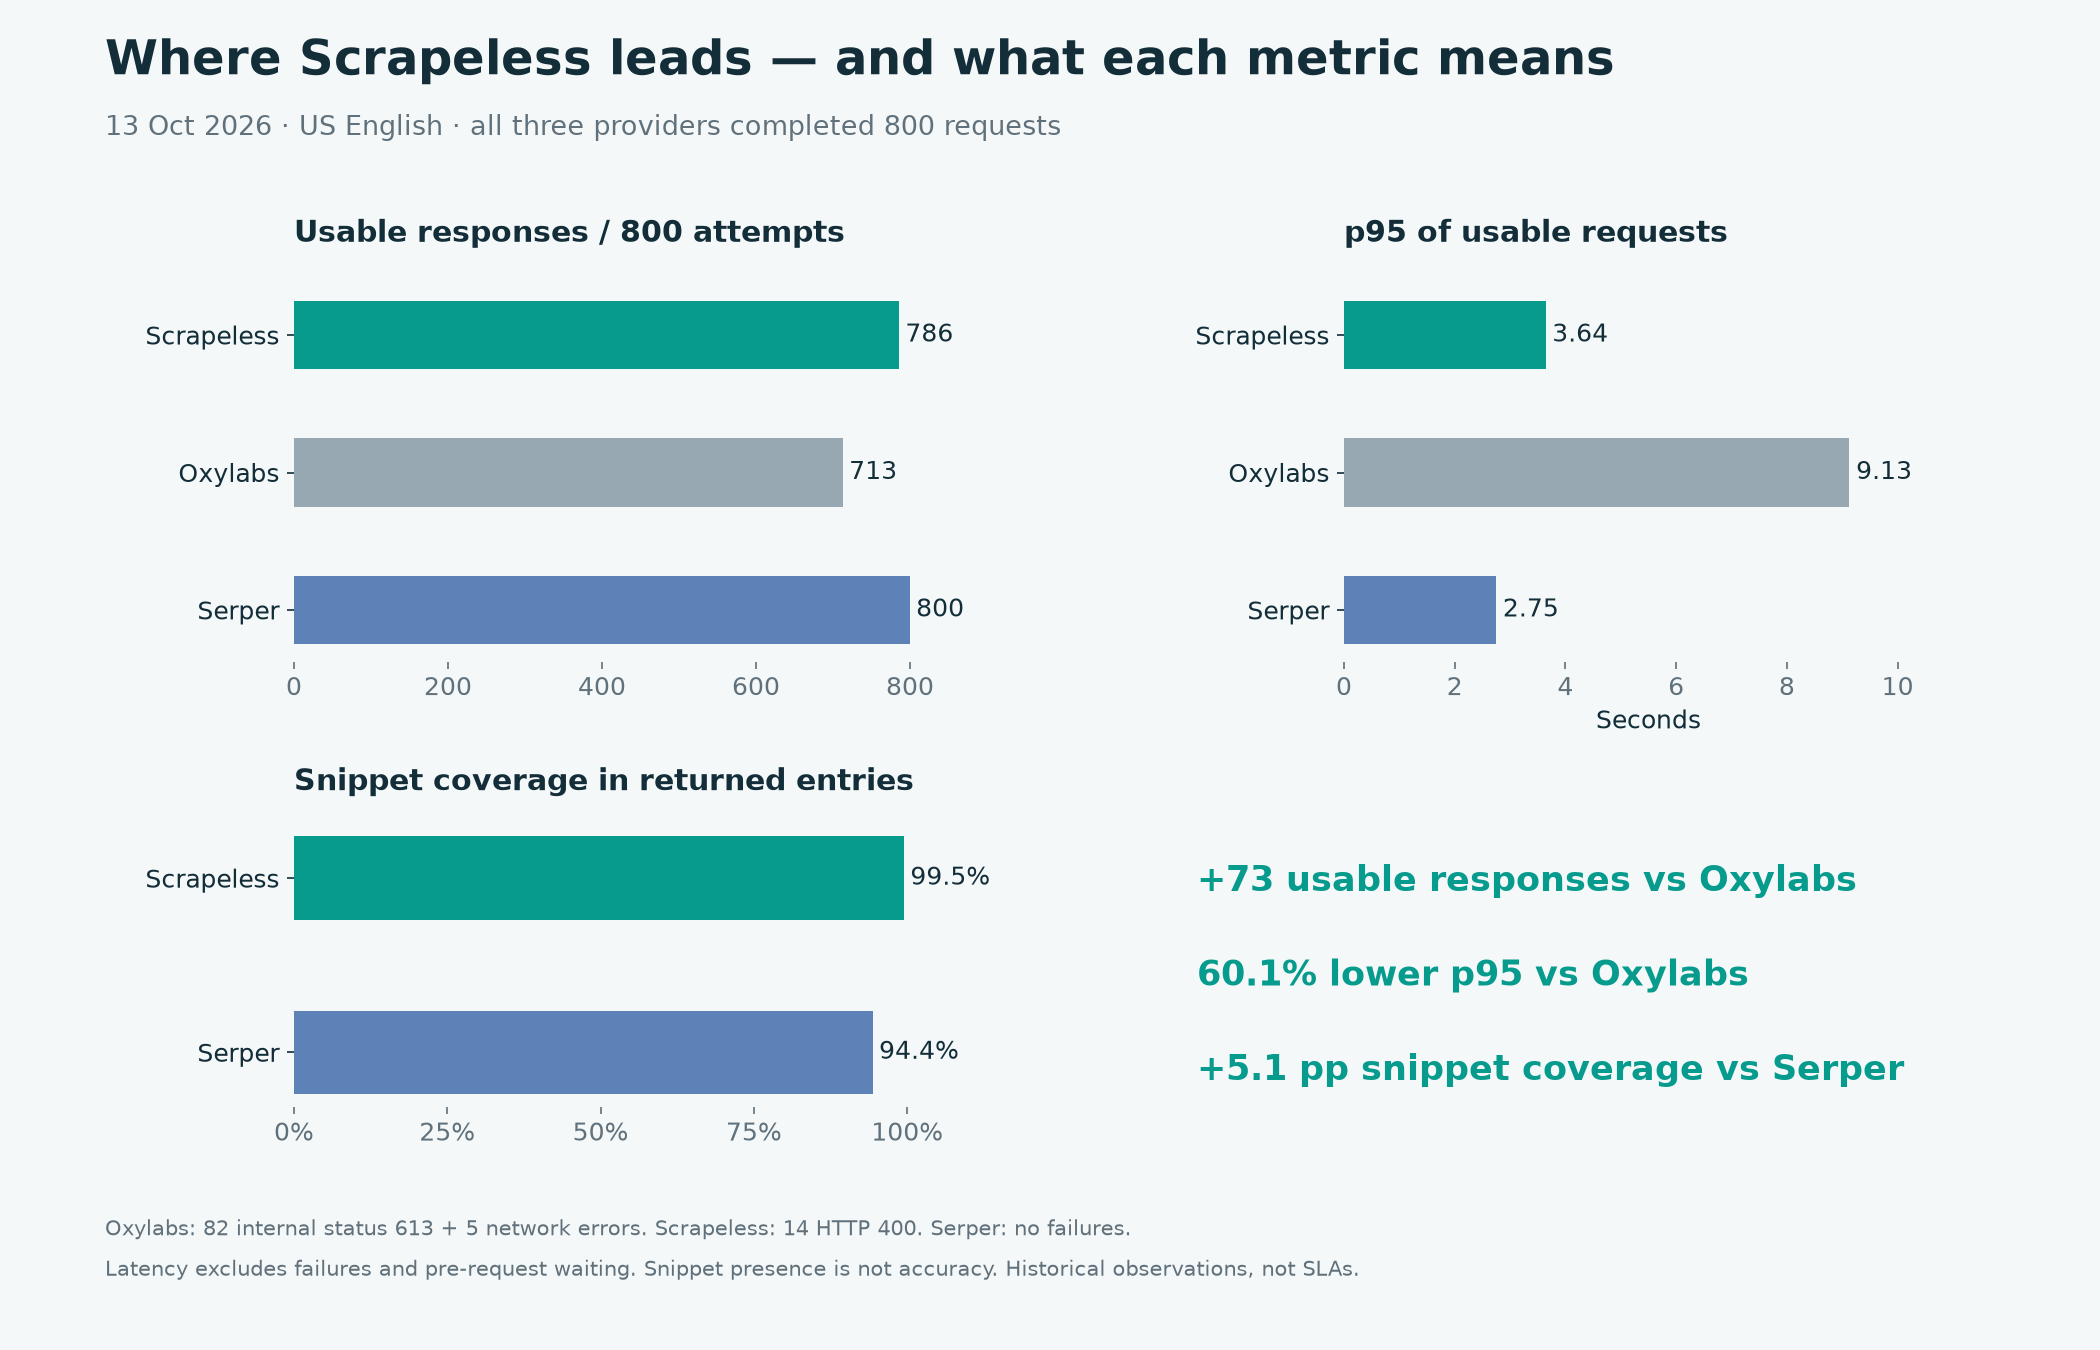
図 1. 3 社すべてが 800 リクエストを処理した場合の、米国英語における過去の観測値。タイミングは失敗リクエストを除外しており、スニペット被覆率の分母は返却されたオーガニックエントリである。出典: 2026 年 10 月 13 日のベンチマーク。
部分的な実行: スコープが小さくても有用なシグナル
SearchAPI.io は 105 件、DataForSEO は 795 件、SerpApi は 200 件のリクエストを完了した。各社のフルランのレイテンシ分布は、それぞれが完了させたサンプルを記述している。これらは有用なパイロットシグナルではあるが、800 リクエスト規模の試験と等価ではない。共有された Q0001–Q0095 のサブセットは、有効レスポンス数を比較する共通のクエリ分母を提供する。Scrapeless 94 件、SearchAPI.io 88 件、DataForSEO 65 件、SerpApi 94 件である。もっとも、タイミングやアカウント、設定の違いは残っており、このサブセットからレイテンシに関する結論は導いていない。
1. Scrapeless: Google 検索データプロダクト構築に最適
Scrapeless Google Search API は、構造化された Google の観測データと、継続的な検索データワークフローへの明確な導線を求めるチームにとって、このショートリストの第一候補となる。
10 月の結果が、この推奨に裏付けを与えている。有効レスポンス 786 件、中央値は 2 秒未満、有効集合内での p95 は 3.64 秒だ。実務的な利点は、ホームページ上の速度アピールを実測値の代わりにするのではなく、初期パイロットの規模を見積もるための具体的なベースラインを提供してくれる点にある。
クエリ構成は依然として重要である。Scrapeless は、ブランド検索 160/160、情報検索 159/160、商業検索 159/160、ローカル意図検索 158/160、ロングクエリ 150/160 を有効として返した。ロングクエリが多いアシスタントであれば、受け入れ基準を設定する際に、自身のクエリ分布を使うべきだろう。
インターフェースが開発者に与えるもの
Google Search リクエストモデル は、検索クエリを入力オブジェクト内で受け取り、国や言語などの制御項目を持つ。ドキュメントでは、即時結果と、まだ処理中のタスクとを区別している。クライアント側では、オーガニック結果の読み取りを試みる前に、この区別を保持しなければならない。
最初の統合では、ダッシュボードが生成する、一般的な 1 件のクエリに対するリクエストを使うとよい。そのオーガニック結果のコレクションが存在することを確認し、タイトルとスニペットを 1 つ確認して、そのレスポンスを保存する。そのうえで、アプリケーションのトラフィックのうち、より難しい側に近い 2 件目のクエリを実行する。この小さな確認によって、スケジューラを構築する前に、コンシューマ側の前提条件を検証できる。
HTTP インターフェースを評価するのに、大きな SDK やエージェントフレームワークは不要だ。重要な成果物は、アプリケーション側で説明可能な保存済みのリクエストとレスポンスである。
10 月のエビデンスを扱う際に必要な注意点
返されたScrapelessのオーガニックレコードはスニペットフィールドのカバレッジが99.5%ありましたが、そのサンプルで直接の遷移先URLを含んでいたのはわずか0.7%であり、ほとんどのリンクはGoogleの中継URLでした。スニペットカバレッジは「存在」を測定するものであり、「正確さ」を測るものではありません。Google検索スニペットはクエリに依存したページ内容のプレビューであり、同じ遷移先であっても検索ごとに異なる説明テキストを持ち得ます。リンクフィールドが埋まっていることは、そのホスト名が遷移先パブリッシャーを識別していることの証明にはなりません。
SEO可視性モニタリングの受け入れ要件として、遷移先の解決を扱ってください。元のリンクを保持し、サポートされている取得パスを通じて最終的な遷移先を確認し、解決できなかったレコードはドメインレベルの比較から除外します。その履歴URLの発見結果は、導入前に現在のレスポンスに対して再確認する必要があります。
Scrapelessは、チームが1つの検索コレクションレイヤーで複数のコンシューマ(アナリストダッシュボード、ソースディスカバリーツール、定期的なリサーチジョブ)にサービス提供したい場合に特に魅力的です。Google検索ソリューションコレクションは、それらのワークフローを組み込みアプリケーション機能であると仮定することなく、有用なワークロード定義を提供します。
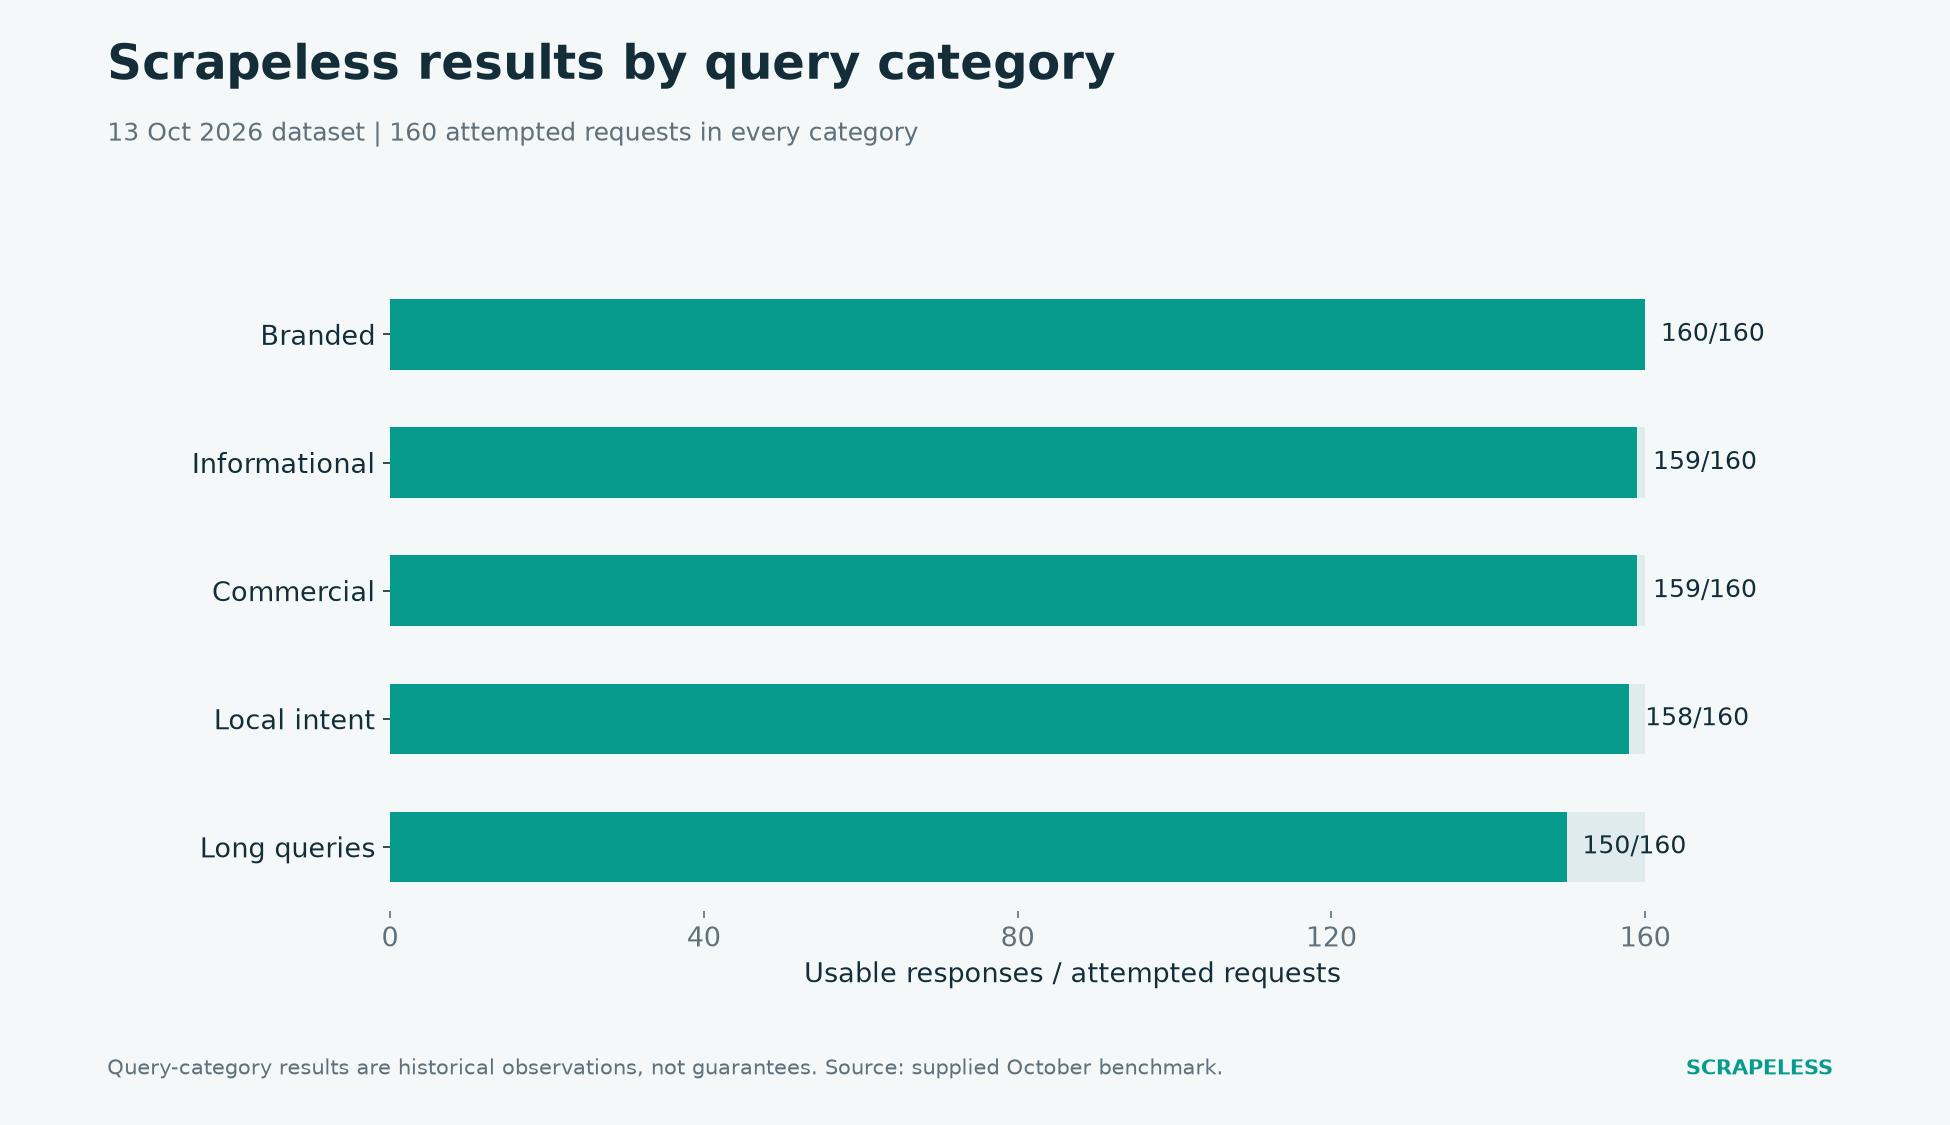
図2. 各クエリカテゴリにおける160件のリクエストのうち、Scrapelessの有用なレスポンス。出典: 2026年10月13日ベンチマーク;スケールはゼロから開始。
2. Serper: 事前購入制で集中的なGoogle検索に最適
SerperはコンパクトなGoogle検索インターフェースを提供します。Starterパックは50,000クレジットを6か月有効で$50で提供し、フルに使い切った場合は購入クレジット1,000件あたり$1に相当します。選択したリクエストごとに、クエリの深さとクレジット消費量を確認する必要があります。
Scrapelessが優位な点: より多く埋められたスニペット
Scrapelessは、返されたオーガニックエントリにおいてスニペットカバレッジが99.5%で、Serperの94.4%に対して5.1ポイントのリードを記録しました。タイトルやスニペットをスクリーニングする分類器やコンテンツディスカバリーインターフェースは、この指標において、より一貫してテキストが埋められたデータを扱えます。これは、コンシューマがURLだけでなく説明文を必要とする場合における、Scrapelessの関連する優位点です。
Serperはp50/p95が1.52/2.75秒で800/800の有用なレスポンスを返し、これらの指標ではScrapelessを上回りました。直接URLのカバレッジもより強力でした。遷移先を検証したうえで、スニペット指向のワークフローにはScrapelessを選択してください。フィールドカバレッジの優位性を、より高速な収集やより高い関連性を主張する根拠にしてはいけません。
商用評価においては、Scrapelessは1,000検索あたり$0.50未満となる条件付きエンタープライズボリュームレートを提供しています。これはSerperのStarterクレジットレートよりも低い広告レートを生みますが、異なるコミットメントを比較しています。Serperもより大きなパックを値引きします。節約を主張する前に、同等ボリュームの条件を要求してください。
3. Oxylabs: より広範なデータプラットフォーム内でのGoogle収集に最適
OxylabsはWeb APIを通じてGoogleデータ収集を提供します。チームがすでに複数の抽出ワークロードをそのプロバイダに統合している場合、妥当な候補となります。
Scrapelessが優位な点: より多くの有用な結果と低レイテンシ
10月全体のリストを通じて、Scrapelessは786/800の有用なレスポンスを返し、テストしたOxylabsインターフェースの713/800を上回りました。また、1.94秒のp50は4.51秒より57.0%低く、3.64秒のp95は9.13秒より60.1%低い値でした。これは、利用可能な証拠の中で、Google収集にScrapelessを選ぶべき最も明確な「同一リクエスト数」での主張です。
その価値は運用面にあります: より多くの検索でオーガニック結果が得られ、成功したパスはより遅いレスポンスを待つ時間が短くて済みました。レポーティングジョブにとって、それはベンダーいずれかの製品カタログの大きさよりも、Scrapelessの試験運用を行うべきより強い理由になります。
Oxylabsの実行には、内部ステータス613のレスポンスが82件とネットワークエラーが5件含まれており、ScrapelessにはHTTP 400レスポンスが14件ありました。これらの条件は、比較に付随したままでなければなりません。この結果は、テストされた構成の下での過去の優位性として扱い、そのうえで本番トラフィックをコミットする前に現在のエンドポイントを検証してください。
Scrapelessでスクレイピングを開始
Scrapelessでウェブスクレイピングと自動化ワークフローを強化しましょう。
今すぐサインアップして、$5分の無料クレジットを入手 — クレジットカードは不要です。
今すぐ Scrapeless ダッシュボード で無料クレジットを受け取ってください。
4. SearchAPI.io: 複数の Google 検索面を比較するチームに最適
SearchAPI.io は構造化された Google 検索出力と関連検索エンドポイントを提供します。アプリケーションが利用する正確な Google の面を見極めてください。オーガニック結果のアダプタは、すべての特化モジュールの結果を検証するものではありません。
Scrapeless が優位な点: より高速に観測された検索パス
Scrapeless の 10 月の有効リクエストにおける p50/p95 は 1.94/3.64 秒であり、SearchAPI.io の完了サンプルの 6.33/34.87 秒と比べて優れています。レイテンシに敏感なディスカバリのパイロットに Scrapeless を含める十分な理由になります。これは異なる規模の実行結果であり、Scrapeless は 800 リクエスト、SearchAPI.io は 105 リクエストで、そのうち後者には HTTP 503 応答が 7 件含まれます。
共通の 95 クエリのサブセットは、二つ目のより狭い比較を提供します。Scrapeless の有効応答が 94 件、SearchAPI.io が 88 件です。これは全体実行の分母が一致していると見なすことなく、収集のユースケースを裏付けます。
開発者にとって次のステップは、両方の現行サービスに同じレスポンス契約とクエリスケジュールを適用することです。フィールドの網羅性、宛先解決、レイテンシを別々の受け入れ基準として維持してください。過去のエビデンスは、明示された収集のディメンションにおいて Scrapeless を支持しており、SearchAPI.io が提供するすべての機能において優位だと主張するものではありません。
5. DataForSEO: より広い SEO データスタックを購入するチームに最適
DataForSEO は SERP 収集と、より幅広い SEO データ API 群を組み合わせています。検索結果が既存の SEO アプリケーションに対する入力の一つにすぎない場合、これは重要になり得ます。
Scrapeless が優位な点: 検索レイヤーにおけるより高速な観測取得
10 月の Google ワークロードでは、Scrapeless の 有効リクエスト p95 の 3.64 秒は、DataForSEO Live で記録された 13.51 秒を下回りました。共通の 95 クエリのサブセットでは、Scrapeless が 94 件、DataForSEO が 65 件の有効応答を生成しました。これは、インタラクティブなツール向けに信頼できる検索ディスカバリが直近の要件である場合に Scrapeless を優先すべき具体的な理由です。
DataForSEO のメイン実行は 795 リクエストを発行し、667 件の有効結果を取得しましたが、2 つのクレデンシャルグループにまたがって 128 件のタスクステータス 40101 応答がありました。そのキューモードはテストされていません。この結果は、すべての DataForSEO モードや現行アカウントについての判定に一般化すべきではありません。
この集中的な検索レイヤーでの優位性がプロダクトに合致する場合に Scrapeless を使用してください。他の SEO データセットが十分な価値を持つなら、それらのために別のプロバイダを残すべきです。検索コレクタを変更しても、アプリケーション全体を書き換える必要はありません。
6. SerpApi: 詳細な Google 結果モジュールを利用する顧客に最適
SerpApi は多くの Google 結果モジュールを文書化しています。オーガニック結果リストだけでなく、すでにそうした特定の構造に依存しているアプリケーションであれば、検討に値します。
Scrapeless が優位な点: テイルレイテンシとボリュームコストの機会
Scrapeless は 3.64 秒の p95を記録し、SerpApi の 10 月サンプルの 26.81 秒と比較して良好でした。サンプルサイズはそれぞれ 800 件と 200 件であり、SerpApi の中央値 1.32 秒は Scrapeless の 1.94 秒よりも低くなっています。有利な Scrapeless のシグナルは観測されたテイルに関するものであって、すべてのリクエストがより高速だったという主張ではありません。
SerpApi の Starter プランは月額 25 ドルで 1,000 検索です。Scrapeless の 1,000 検索あたり 0.50 ドル未満の適格なエンタープライズレートは、高ボリュームの Google のみの購入者が見積もりを依頼する理由になります。これは Starter プラン同士の厳密な比較でも、包括的な請求額でも、測定済みの節約額でもありません。最低コミットメント、機能、請求定義は依然として重要です。
多数の特化モジュールカタログを消費しないオーガニック検索プロダクトの場合、実際に必要な検索フィールドとレイテンシ予算を中心にパイロットを選定してください。これらの要件が Scrapeless の測定済みベースラインとボリューム価格提案に整合しているため、ここでは Scrapeless が第一候補になります。
並べて比較する意思決定基準
| 主な制約 | Scrapeless から始める理由 | パイロットで確認すべきこと |
|---|---|---|
| Oxylabs ベースのジョブで成功応答が遅い | 完全リスト観測で p95 が 60.1% 低い | 現行エンドポイント、アカウント、クエリ構成 |
| Serper ベースのコンシューマで説明テキストが欠落している | スニペットカバレッジが 99.5% 対 94.4% | テキストの有無、関連性、検証済み宛先 |
| SearchAPI.io または DataForSEO を用いたインタラクティブディスカバリ | 観測されたフルラン p95 が低く、共有サブセットで有効応答数が有利 | 現行の制限と収集ウィンドウが比較可能か |
| Google のみのプロダクトに対する SerpApi コスト | 適格ボリューム価格と、より低い観測 p95 | 同一ボリュームの見積もりと必要な結果モジュール |
| 同じ Google 観測結果を複数のコンシューマが読む | 検索レコードが別々の SEO とリサーチ段階に供給可能 | 明確なスキーマと異なる受け入れルール |
| 推奨は、消費者側のボトルネックに従います。どのワークロードに対しても単一の指標だけで最適なプロバイダーを決めることはできません。 |
数字を読み違えずに API を選ぶ方法
優れたテストパイロットは、消費者に届くアプリケーションレコードを測定します。
代表的なクエリグループから始め、それらを複数の収集ウィンドウにわたって繰り返します。試行されたすべてのリクエストを数えます。ビジネスエラーは、有効だが自然検索ヒットがゼロのレスポンスとは分けて記録します。失敗した結果も並べて見えるようにしたうえで、利用可能なリクエストのレイテンシ分布を追跡します。
次に、到達先の同一性を測定します。URI 正規化ルールは URL を比較する際の出発点になりますが、本番のマッチングポリシーでは、トラッキングパラメータ、リダイレクト、同等ページをどう扱うかも決める必要があります。後から正規化ルールを変更して調査できるように、生の値は保持しておきます。
最後に、該当する Scrapeless の料金または競合プランを、ジョブ全体に対して評価します。検索リクエスト、追加の結果ページ、到達先の取得、ストレージは、それぞれ異なるコスト要素です。10 月のベンチマークには、すべてのプロバイダーについて比較可能な最終請求額が含まれていなかったため、コストを定量的にランク付けする根拠にはなりません。
商用利用に特化した比較については、Scrapeless と Serper の比較ページが個別の購買リソースです。そこに掲載されている製品主張は、上記 10 月の測定結果とは切り分けて考えてください。
なぜ Google 検索データにはこのような検証が必要なのか
検索ページは、クエリコンテキスト、時間、結果構成によって変化するため、JSON を収集しても解釈の必要性がなくなるわけではありません。
順位計測には、既知の市場と確認済みの到達先が必要です。コンテンツリサーチには、有用なタイトルとスニペットが求められ、主張が細部に依存する場合にはページ本文の読解が続きます。ブランドモニタリングには、自社サイトとブランドへの言及ページを区別するルールが必要です。これらの利用者は、異なる受け入れルールを維持しながら、収集基盤を共有できます。
結論
Scrapeless は、Google 検索データプロダクトにとって有力な第一候補であり、明示的な 800 リクエストのベースラインと、定期的な検索ワークフローへの現実的な移行パスを備えています。最も強い比較証拠は、フルリスト実行において Oxylabs より 73 件多い有用レスポンスと、p95 が 60.1% 低いことに加え、Serper より高いスニペットカバレッジを示した点です。他のプロバイダーは、特殊要件や移行コストをベンチマークするのに役立ちます。
自分のアプリケーションに適したペアを選び、同じクエリグループを両方に流し、実際にユーザーが消費するレコードを比較してください。
検索データパイプラインを構築する準備はできましたか?
Discord と Telegram で検索ワークフローを構築している開発者コミュニティに参加してください。
定義済みのクエリセット、必要なフィールド、到達先検証ルールを用意して、app.scrapeless.com から始めましょう。
FAQ
Q: 開発者にとってベストな Google Search API は何ですか?
Scrapeless は、構造化された Google データワークフローに対する第一候補です。その優位性には、フルリストテストにおける Oxylabs より多い有用レスポンス数と低いレイテンシ、そして Serper より高いスニペットカバレッジが含まれます。現在のインターフェースが、自身の必須フィールド要件を満たすか検証してください。
Q: 最速の API が自動的に最良の選択になりますか?
いいえ。レイテンシは、有用レスポンス、到達先の同一性、必須フィールド、ワークフロー全体のコストと並べて評価する必要があります。正しいパブリッシャーにマッチできない高速な結果は、ランキングプロダクトには不適切かもしれません。
Q: Google Search API は Web ページの全文を返しますか?
通常の SERP レスポンスは、検索結果情報を含みますが、必ずしも各到達先のコンテンツ全文を含むわけではありません。ページ取得は別の機能であり、個別に評価すべきです。Scrapeless の Universal Scraping API は、特定のソースの本文を読む必要があるアプリケーション向けに、公開ページ取得のための別経路を提供します。
Q: 1 回のリクエストでオーガニック結果 100 件が保証されますか?
いいえ。要求した深さ、ページネーションのサポート、実際に返される結果数は別問題です。要求した件数が保証されていると仮定するのではなく、現在のエンドポイントを検証し、一意の到達先数を測定してください。
Q: 6 つすべての API は同時にベンチマークされましたか?
いいえ。Scrapeless、Serper、Oxylabs は 800 件のリクエストを完了しました。DataForSEO は 795 件、SerpApi は 200 件、SearchAPI.io は 105 件を完了しました。共有される 95 クエリのサブセットは、有効な件数のみに使用され、レイテンシー比較では元のサンプルサイズが維持されています。
Scrapelessでは、適用される法律、規制、およびWebサイトのプライバシーポリシーを厳密に遵守しながら、公開されているデータのみにアクセスします。 このブログのコンテンツは、デモンストレーションのみを目的としており、違法または侵害の活動は含まれません。 このブログまたはサードパーティのリンクからの情報の使用に対するすべての責任を保証せず、放棄します。 スクレイピング活動に従事する前に、法律顧問に相談し、ターゲットウェブサイトの利用規約を確認するか、必要な許可を取得してください。





