
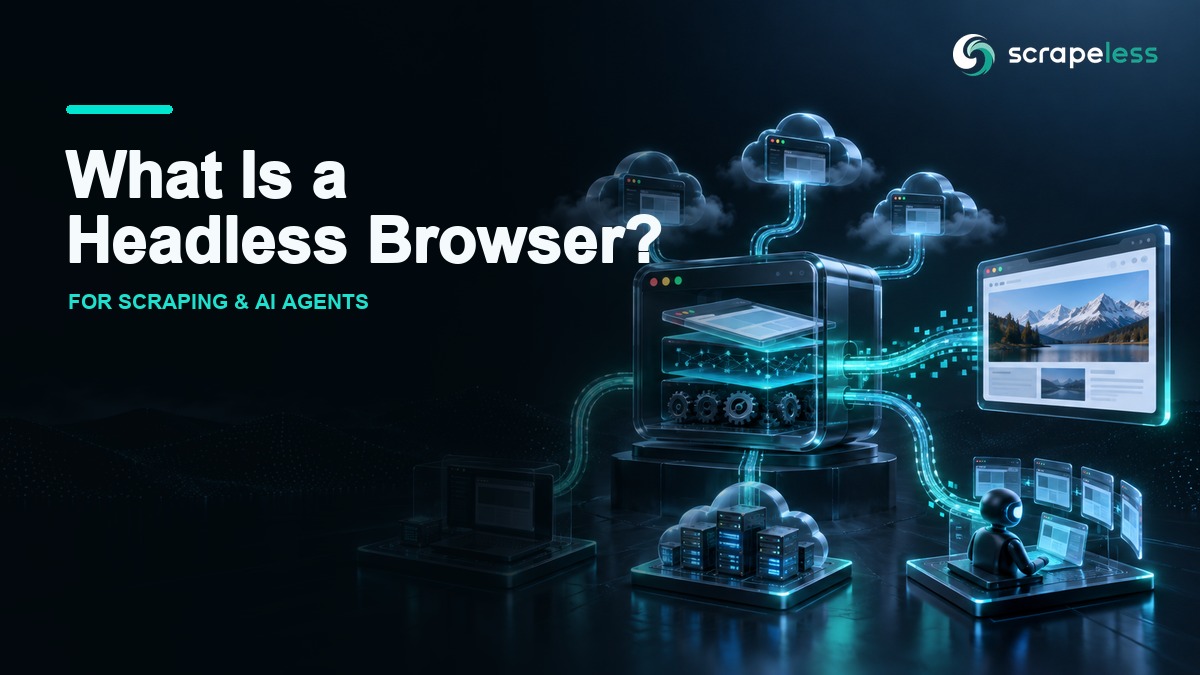
ヘッドレスブラウザとは何ですか? スクレイピングとAIエージェントのための仕組み
Expert in Web Scraping Technologies
TL;DR:
- ヘッドレスブラウザは、可視ウィンドウなしで動作する完全なブラウザエンジンです。 HTMLを解析し、CSSを適用し、JavaScriptを実行し、DOMを作成し、クッキーを保存し、ネットワーク要求を行います。
- ヘッドレスとヘッドフルは、表示モードを示すものであり、自動化機能ではありません。 Puppeteer、Playwright、WebDriver、CDPはいずれのモードも制御できますが、ブラウザがそれをサポートしている必要があります。
- ローカルのヘッドレスは開発とCIに最適です。管理されたクラウドブラウザは、分離、ルーティング、スケーリング、可視性を追加します。 適切なレイヤーは、ウィンドウが可視かどうかではなく、運用ニーズに基づいて決まります。
- AIエージェントは、レンダラーだけでなく、状態と証拠を必要とします。 長いタスクは、永続的なセッション、制御されたネットワークアイデンティティ、スクリーンショット、コンソールログ、およびリプレイから利益を得ます。
- ヘッドフルデバッグはワークフローに残すべきです。 可視ブラウザは、レイアウト、同意プロンプト、エクスキュータのタイミングを検査する最も明確な方法です。
ヘッドレスブラウザとは何ですか?
ヘッドレスブラウザは、グラフィカルユーザーインターフェースを表示せずにウェブコンテンツを読み込み、レンダリングするブラウザエンジンです。
「ヘッドレス」は「HTMLのみ」を意味するものではありません。現代のヘッドレスブラウザは、JavaScriptを実行し、CSSを適用し、DOMを構築し、副リソースを読み込み、クッキーとストレージを管理し、自動化コントロールを公開します。欠如しているのは、可視のアプリケーションウィンドウです。
Chromeの公式ヘッドレスモードのドキュメントでは、現在のヘッドレスChromeは通常のChromeと同じブラウザコードを共有していることが説明されています。このアーキテクチャのポイントは重要です:レンダリングエンジンは、デスクトップにウィンドウが表示されなくても実際に存在します。
ヘッドレスブラウザとヘッドフルブラウザ
ヘッドレスモードとヘッドフルモードは、同じ広範なブラウザコンセプトを使用しますが、異なる操作ニーズに応えます。
| ディメンション | ヘッドレス | ヘッドフル |
|---|---|---|
| 可視ウィンドウ | なし | あり |
| サーバーおよびコンテナの使用 | 自然な適合 | 表示環境が必要 |
| インタラクティブデバッグ | ログ、トレース、スクリーンショット、またはリモートビューが必要 | 直接的な視覚検査 |
| CI自動化 | 一般的なデフォルト | 目標の再現に役立つ |
| スクリーンショットおよびPDFジョブ | スクリプト化され、繰り返し可能 | 可能ですが、スケール時には不便 |
| GPUまたは視覚に敏感なフロー | 注意深く検証する必要があります | 検査が容易 |
どちらのモードも自動的により優れた機能を持つわけではありません。ヘッドフルブラウザは自動化可能であり、ヘッドレスブラウザは複雑なクライアントサイドアプリケーションをレンダリングできます。決定は表示、リソース管理、デバッグアクセスに関するものです。
ヘッドレスブラウザの制御方法
ヘッドレスブラウザは、可視ツールバーを使用する人を介さず、制御面を通じてコマンドを受け付けます。
コマンドラインフラグ
ブラウザは、DOMの印刷、スクリーンショットの取得、PDFの保存など、一時的なタスク用のフラグを公開できます。これは診断や小さなビルドステップに便利ですが、自動化ライブラリほどのワークフロー制御を提供しません。
自動化ライブラリ
PuppeteerとPlaywrightは、ナビゲーション、セレクター、イベント、ダウンロード、ネットワークインターセプション、ブラウザコンテキスト用の高レベルAPIを提供します。Seleniumクライアントは、複数の言語およびブラウザファミリーにわたりWebDriver互換のブラウザドライバを使用します。
ブラウザプロトコル
プロトコルは、クライアントとブラウザ間のコマンドを運びます。Chrome DevToolsプロトコルは、Chromiumデバッグおよび自動化ドメインを公開します。W3C WebDriver仕様は、ブラウザの相互運用性のために設計されたリモート制御インターフェースを定義します。
プロトコルはライブラリとは異なります。PlaywrightやPuppeteerは開発者のエルゴノミクスを提供し、CDPはより低レベルのトランスポートおよびコマンドモデルを提供します。
一般的なヘッドレスブラウザの使用例
ヘッドレスブラウザは、ワークフローがブラウザの動作を必要とするが、ローカルウィンドウを必要としない場合に価値があります。
- 自動テスト。 CIでユーザーフロー、アサーション、フォーム、およびナビゲーションを実行します。
- ウェブデータ抽出。 JavaScriptをレンダリングし、遅延読み込みされた公開コンテンツを表示し、結果のDOMやネットワーク応答を読み取ります。
- AIブラウザエージェント。 エージェントがページを検査し、アクションを決定し、同じセッション状態から継続できるようにします。
- スクリーンショットおよびPDF。 知られたビューポートと印刷設定から繰り返し可能な視覚キャプチャを生成します。
- パフォーマンスおよび診断。 制御された実行で、ネットワーク、コンソール、タイミング、およびページ状態の証拠を収集します。
- スケジュールされたモニタリング。 デスクトップを開いたままにすることなく、公開の可用性、コンテンツの変更、またはローカライズされた体験を確認します。
これらの使用例には1つの要件があります:ブラウザは明示的なライフサイクル管理を必要とします。スクリプトまたはプラットフォームはブラウザを作成し、ページを開き、有意義なページ状態を待ち、証拠をキャプチャし、セッションを閉じる必要があります。
三層モデル:ローカル、クラウド、エージェント
ヘッドレス自動化は、3つのレイヤーに分けられると、より理解しやすくなります。
レイヤー 1: ローカルヘッドレスブラウザ
ローカルヘッドレスモードは、開発者のマシン、CIワーカー、コンテナ、または仮想マシン上で実行されます。これにより、チームはブラウザのバージョン、オペレーティングシステム、依存関係、ファイルシステムを直接管理できます。
ユニットサイズのフロー、テスト開発、決定的な内部アプリ、インフラストラクチャの所有が許容されるケースにはローカルヘッドレスを使用します。
レイヤー 2: マネージドクラウドブラウザ
マネージドクラウドブラウザは、ブラウザプロセス、分離、ネットワークルーティング、およびライフサイクル操作をサービスに移行します。クライアントはリモートで接続し、馴染みのある自動化APIを保持します。
ブラウザフリート、プロキシルーティング、地理的アクセス、セッションの分離、同時制御、または集中観測が別個のプラットフォームプロジェクトとなる場合は、マネージドレイヤーを使用します。
レイヤー 3: エージェントブラウザ
エージェントブラウザは、マネージドブラウザレイヤーに長期のタスク状態とエージェント向けのコントロールを追加します。ブラウザは、エージェントが呼び出し、観察し、複数の決定にわたって使用し続けられるツールになります。
エージェントにはまだ境界が必要です: 許可されたドメイン、許可されたアクション、人間の承認ポイント、秘密の取り扱い、出力の検証。ブラウザ制御は、エージェントの結論を正確にするものではありません。
Scrapeless でスクレイピングを開始
Scrapeless でウェブスクレイピングと自動化ワークフローを強化しましょう!
今日サインアップして、5ドルの無料クレジットを手に入れましょう — クレジットカードは不要です。今すぐ Scrapeless ダッシュボードで無料クレジットを請求してください。
なぜローカルヘッドレスブラウザが運用作業になるのか
ローカルブラウザは、1つのプロセスとして始まり、作業量が増えるとシステムになります。
チームは、ブラウザとライブラリのバージョンを揃え、パッケージシステムの依存関係を管理し、コンテナを健康に保ち、メモリやCPUの使用を制限し、プロファイルを分離し、ログを収集し、スクリーンショットを公開し、トラフィックをルーティングし、放置されたプロセスをクリーンアップする必要があります。これらのタスクのいずれもセレクタや抽出ロジックを変更するわけではありませんが、各タスクは、ジョブが予測可能に完了するかどうかに影響を与えます。
ブラウザプロセスも状態を持っています。クッキー、キャッシュ、サービスワーカー、ストレージ、権限、ダウンロード、拡張子は、コンテキストが不注意に再利用されるとタスクの境界を越える可能性があります。WHATWGブラウジングコンテキストモデルは、ドキュメント、履歴、およびブラウザ内のトップレベルブラウジングコンテキストがどのように関連しているかを説明しています。
だからこそ、「より多くのヘッドレスブラウザを実行する」というのは完全なスケーリングプランではありません。生産設計には分離、入場制御、観測性、および明確なセッションライフサイクルが必要です。
Scrapelessエージェントブラウザが適合する場所
Scrapelessエージェントブラウザは、スクレイピングとAIエージェントのワークフロー用のマネージドブラウザレイヤーです。PuppeteerとPlaywrightのための標準CDP WebSocketエンドポイントを公開し、接続URL上にプロキシルーティングとセッション設定があります。
前提条件: ライブ接続には
SCRAPELESS_API_KEYのScrapeless APIキーが必要です。
javascript
import { chromium } from "playwright-core";

const token = process.env.SCRAPELESS_API_KEY;
if (!token) throw new Error("SCRAPELESS_API_KEY is required");

const endpoint = new URL("wss://browser.scrapeless.com/api/v2/browser");
endpoint.searchParams.set("token", token);
endpoint.searchParams.set("sessionTTL", "180");
endpoint.searchParams.set("proxyCountry", "US");

const browser = await chromium.connectOverCDP(endpoint.toString());
const context = browser.contexts()[0];
const page = context.pages()[0] ?? (await context.newPage());
await page.goto("https://example.com", { waitUntil: "domcontentloaded" });
console.log({ title: await page.title(), url: page.url() });
await browser.close();
このコードは、ローカルブラウザの起動をCDP接続に置き換えます。ナビゲーションと抽出APIは馴染みのあるままに保たれ、ブラウザプロセスと設定された出口はリモートで実行されます。
ヘッドレスブラウザの制限
ヘッドレスブラウザはレンダリングとインタラクションを解決しますが、データの正確性、承認、またはワークフローデザインを解決するものではありません。
デバッグが即時性に欠ける
目に見えるウィンドウがないため、ログやアーティファクトが証拠となります。コンソールメッセージ、失敗したリクエスト、スクリーンショット、DOMスナップショット、最終URLをキャッチします。マネージドライブビューまたはリプレイは、長いフローの診断を短縮できます。
レンダリングされたコンテンツが不完全な場合がある
ページは、ログイン状態、同意、位置、実験、ユーザー履歴、またはまだ発生していないアクションに依存することがあります。「DOM読み込み」はただの一つのマイルストーンです。必要なコンテンツが存在することを証明するドメイン固有の要素や応答を待ちます。
自動化が検出される可能性がある
ウェブサイトは、ネットワーク、HTTP、ランタイム、および行動信号を評価できます。ヘッドレスモードは多くの信号の中の1つに過ぎません。アイデンティティを単一のフラグではなく、一貫したセッションとして扱います。
リソース使用は影響が大きい
ブラウザセッションはメモリ、CPU、ファイルディスクリプタ、およびネットワーク容量を消費します。明示的な同時実行制限を設定し、不信なページを隔離します。
ビジュアル忠実度にはテストが必要
フォント、GPUの動作、ビューポート、メディアエミュレーション、および印刷設定は、キャプチャを変える可能性があります。視覚的なワークフローを参照画像に対して検証し、ヘッドフル検査を利用できる状態に保ちます。
ヘッドフルデバッグを使用するタイミング
ヘッドフルモードは、次のアクションが人が見えるものに依存する場合の正しい診断ツールです。
ヘッドフルパスを保持してください:
- セレクタを構築し、厳密にすること;
- 同意または認証フローを理解すること;
- ドラッグ、ホバー、フォーカス、およびキーボードの動作を検査すること;
- ピクセル感度のあるスクリーンショットを検証すること;
- DevToolsを開いた状態で問題を再現すること;
- 自動化状態がユーザーに見える状態と一致することを確認すること。
動作が理解できたら、安定したパスをヘッドレス実行に移行し、スクリーンショット、トレース、およびログを証拠として保持します。
決定テーブル
| ニーズ | ローカルヘッドレス | 管理されたクラウドブラウザ | エージェントブラウザ |
|---|---|---|---|
| 高速ローカル開発 | 最適 | オプション | オプション |
| 標準CIテスト | 最適 | スケールで有用 | 滅多に必要なし |
| 地理的ルーティング | 手動インフラ | それに合わせて構築 | それに合わせて構築 |
| 多くの孤立したセッション | 運用上の負担 | 最適 | 最適 |
| 長いマルチステップタスク | カスタム状態の処理 | セッション依存 | 最適 |
| 中央ログとリプレイ | カスタムツール | 一般的な機能 | コア運用ニーズ |
| 自然言語ツール呼び出し | エージェントレイヤーを追加 | エージェントレイヤーを追加 | ネイティブユースケース |
タスクを満たす最小限のレイヤーを選択してください。ローカルヘッドレスブラウザは、チームが環境を制御する場合に優れています。管理されたブラウザは、インフラがボトルネックとなる場合に価値があります。エージェントブラウザは、推論システムが永続的で観察可能なブラウザセッションを所有する必要がある場合に便利です。
結論
ヘッドレスブラウザは、可視ウィンドウのないブラウザであり、減少したレンダラーではありません。重要な設計の選択は、どこで実行されているか、そして誰がその状態、ネットワークルート、隔離、および証拠を所有しているかです。
現在の接続契約についてはエージェントブラウザのドキュメントを使用し、価格ページでアカウントオプションを比較し、プロンプト駆動型の統合がヘルメスおよびスクレイプレスガイドで同じブラウザレイヤーをどのように使用しているかを確認してください。
観察可能なブラウザ自動化を構築する準備はできましたか?
ブラウザライフサイクル、CDP接続、およびエージェントセッション設計について議論するために、Scrapelessコミュニティに参加してください: Discord · Telegram。
app.scrapeless.comにサインアップし、既存のPuppeteerまたはPlaywrightワークフローをエージェントブラウザに接続します。
FAQ
Q: ヘッドレスブラウザは本物のブラウザですか?
はい。モダンなヘッドレスブラウザは、HTMLを解析し、CSSを適用し、JavaScriptを実行し、ページをレンダリングし、デスクトップウィンドウを表示せずにブラウザ状態を管理するために本物のブラウザエンジンを使用します。
Q: ヘッドレスモードはヘッドフルモードよりも速いですか?
ヘッドレスモードは表示オーバーヘッドを減少させることができますが、パフォーマンスはページ、ブラウザビルド、ハードウェア、フラグ、およびワークロードに依存します。普遍的なパーセンテージを仮定するのではなく、正確なフローを測定してください。
Q: ウェブサイトはヘッドレスブラウザを検出できますか?
ウェブサイトは、ネットワーク、HTTP、ランタイム、および動作レイヤー全体で多くの信号を分析できます。ヘッドレスモードは検出に寄与する可能性がありますが、それだけが唯一の信号ではありません。
Q: ウェブスクレイピングにはヘッドレスモードまたはヘッドフルモードを使用すべきですか?
フローを構築およびデバッグするためにヘッドフルモードを使用し、セレクタ、待機、状態、および出力チェックが安定したら、無人実行のためにヘッドレスモードを使用してください。
Q: クラウドブラウザとヘッドレスブラウザの違いは何ですか?
ヘッドレスは表示モードを説明します。クラウドブラウザは、ブラウザが実行される場所と、プロセス、隔離、ネットワーク、および運用ツールを管理する人を説明します。
Q: エージェントブラウザはAIエージェントなしで実行できますか?
はい。PuppeteerまたはPlaywrightはCDPを通じて直接接続し、通常のアプリケーションコードでセッションを制御できます。
Scrapelessでは、適用される法律、規制、およびWebサイトのプライバシーポリシーを厳密に遵守しながら、公開されているデータのみにアクセスします。 このブログのコンテンツは、デモンストレーションのみを目的としており、違法または侵害の活動は含まれません。 このブログまたはサードパーティのリンクからの情報の使用に対するすべての責任を保証せず、放棄します。 スクレイピング活動に従事する前に、法律顧問に相談し、ターゲットウェブサイトの利用規約を確認するか、必要な許可を取得してください。





