
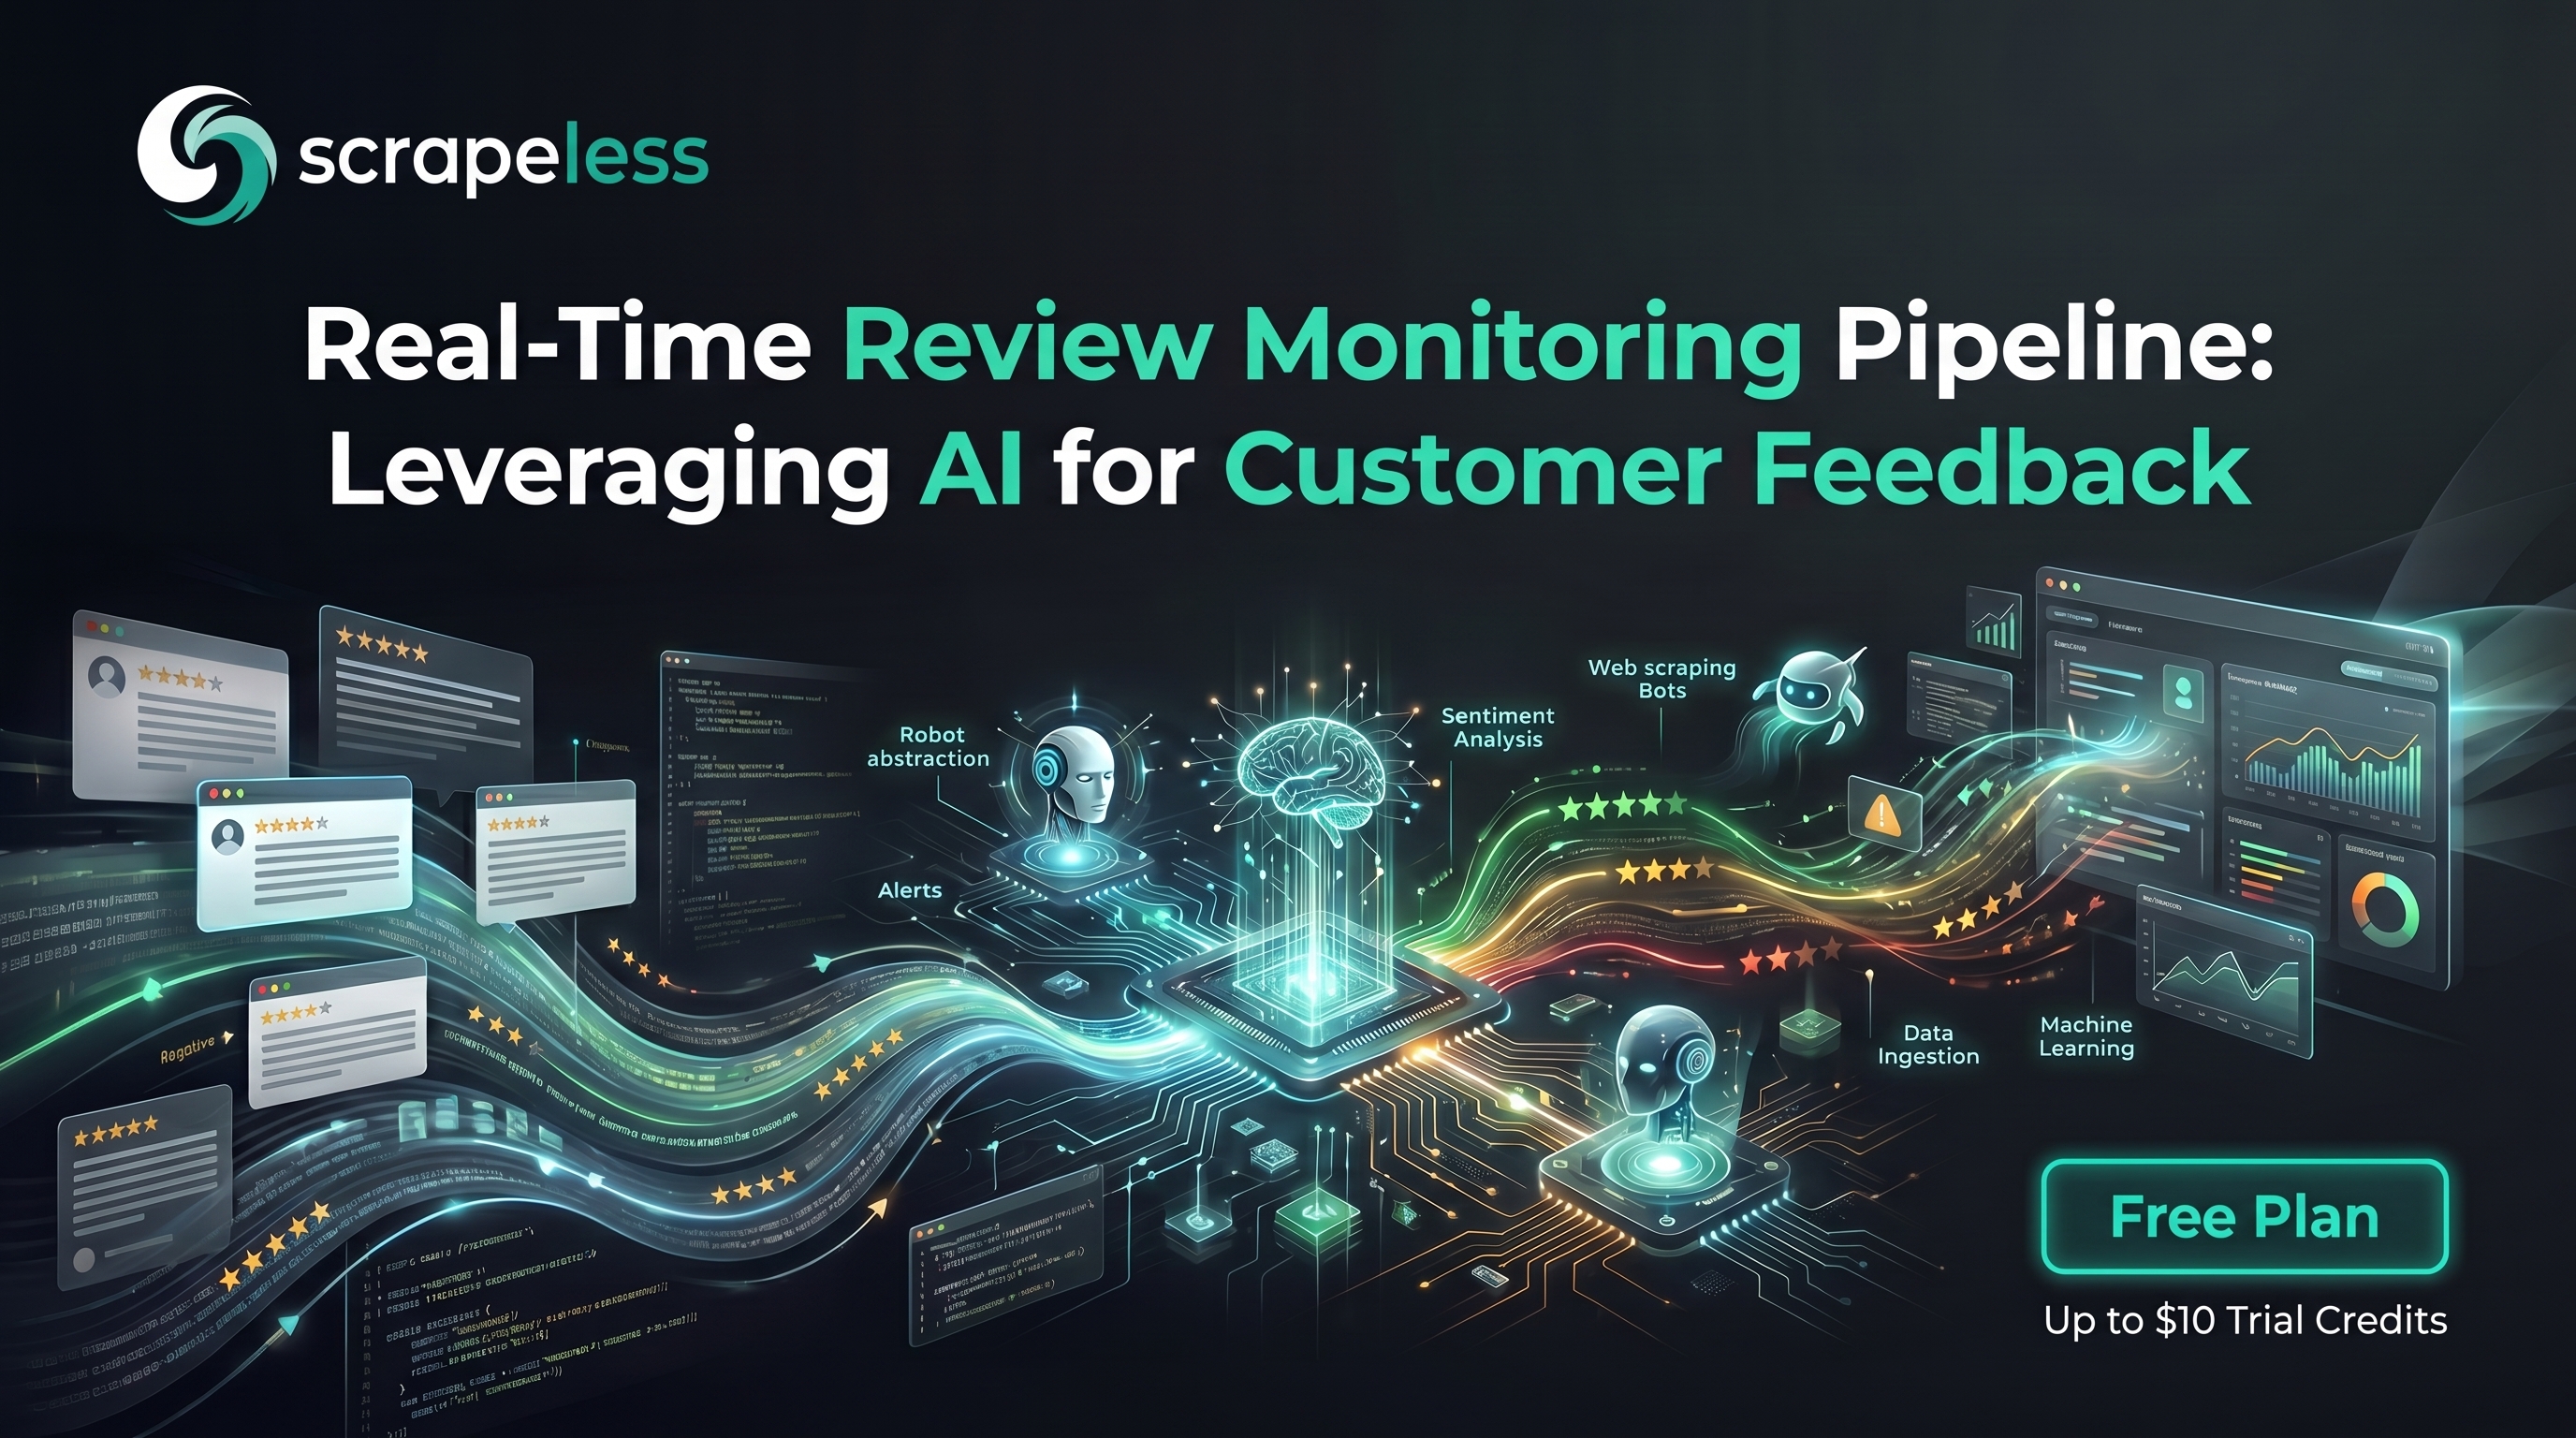
リアルタイムレビュー監視パイプライン:顧客フィードバックのためのAI活用
Advanced Bot Mitigation Engineer
主なポイント:
- レビューは警告システムであり、単なるマーケティングコピーではない。 1つ星のレビューが多数集まることで、出荷失敗や請求のバグ、または安全性の問題をサポートキューに届く前に数日前に警告することができる — ただし、誰かが公に見えるレビューページを定期的に確認している場合に限る。
- 難しいのはページにアクセスすることであり、読むことではない。 ほとんどのレビュー表面はJavaScriptでレンダリングされ、「もっと読み込む」ボタンの背後でページネートし、実際のトラフィックとは異なる挑戦をする。単純なHTTPリクエストは空のシェルまたはボットの壁を返す。
- 1つの基本的なセットで全ての段階をカバー。 Scrapeless Scraping Browserは公に見えるレビューページをレンダリングし、
scrape_markdownとscrape_htmlはクリーンなテキストを返し、同じツールセットが正規化 → 分析 → 保存 → 警告のパイプラインに供給される。 - 感情がフィードを信号に変える。 レビューが1つのスキーマに正規化されると、LLMがトーンとトピックをスコアリングし、ローリングベースラインにより、パイプラインはすべての新しいレビューではなくネガティブなスパイクに警告を発することができる。
- レビュアーの個人データは慎重に扱われる。 パイプラインは公に見えるコンテンツのみを読み取り、保持する情報を最小限にし、著者の識別子を最初の段階から敏感な情報として扱う。
- 無料で開始できる。 新しいScrapelessアカウントには、無料のScraping Browserランタイムが含まれています — app.scrapeless.comでサインアップしてください。
はじめに:受信トレイよりも早くネガティブスパイクをキャッチする
公に見えるレビューは、ブランドが持つ真実の中で最も迅速に動く情報源の1つです。製品の更新が何かを壊すときや、フルフィルメントパートナーが手を抜いたとき、あるいは競合他社の顧客が離れ始めると、信号は通常、最初にレビューに現れます — アプリストア、マーケットプレイス、旅行サイト、独立したレビュープラットフォームに散らばっており、サポートチケットのトレンドやダッシュボードの離脱数に統合されるはるか前です。
問題は、レビューは1つずつ読むのは簡単ですが、大規模に監視するのは難しいことです。ページはJavaScriptでレンダリングされ、古いエントリはページネーションや無限スクロールの背後に隠れ、地域によってレイアウトが異なり、実際のブラウザのように見えないトラフィックに挑戦します。単純なスクリプトはしばしば空のコンテナ、同意のインタースティシャル、またはボット対策チャレンジを返し、人間が見るコンテンツの代わりになります。ヘッドレスブラウザ、プロキシプール、セッション管理を組み合わせるのは、シンプルな「レビューを監視する」というアイデアをインフラプロジェクトに変えてしまいます。
この記事では、Scrapeless Scraping Browserをベースに構築されたレビュー監視パイプラインを詳しく説明します。検出防止クラウドブラウザは公に見えるレビューページをレンダリングし、scrape_markdownとscrape_htmlはクリーンなコンテンツを返し、そこからワークフローは各エントリを1つのスキーマに正規化し、LLMで感情をスコアリングし、履歴を保存し、ネガティビティが急増すると警告を発します。ここでは、AIエージェントのユースケースガイドのエージェントユースケースを駆動する同じパターンが、製品グリッドの代わりにレビュー表面を指示します。
何ができるか
- 多くの表面で自分のブランドを監視。 アプリストアのリスティング、マーケットプレイスの製品ページ、および独立したレビューサイトを、1つの製品やカタログ全体に対して単一のスケジュールで追跡します。
- ネガティブスパイクを早期に検出。 今日の感情をローリングベースラインと比較し、サポートに届く前に低評価の急増を明らかにします。
- スコアだけでなく「なぜ」をタグ付け。 LLMにより、各レビューをトピック(発送、請求、品質、サポート)によって分類させることで、スパイクの原因を特定します。
- 競合他社と比較。 競合リスティングに対して同じ公に見える読み取りを実行し、感情がどこで分岐するかを確認します。
- 毎週の要約をフィード。 正規化されたレビューを要約レポートにまとめ、製品、サポート、信頼と安全のチームに提供します。
- どこへでもエクスポート。 正規化されたレコードをスプレッドシート、倉庫、またはデータベースに書き込み、しきい値がトリップした瞬間にチャットやインシデントツールにWebhookを送信します。
なぜScrapeless Scraping Browserか
Scrapeless Scraping Browserは、ウェブクローラーやAIエージェント用に設計されたカスタマイズ可能な検出対策クラウドブラウザです。特にレビュー監視のために、以下の機能を提供します:
- 実際のブラウザのようにレンダリングするクラウドブラウザ — JavaScript、遅延読み込みのレビューリスト、「もっと読み込む」ボタン、および同意フローはサーバーサイドで処理されるため、パイプラインは人間が見るのと同じ完全なページを受け取ります。
- 195以上の国におけるレジデンシャルプロキシ — セッションごとに出口地域を設定し、地理的なレビューリストや地域特有の評価が、その市場での実際の訪問者が見るように戻ります。
- 箱から出してすぐ使えるクリーンコンテンツ —
scrape_markdownはナビゲーションやボイラープレートを取り除いた読みやすいMarkdownを返し、scrape_htmlはパイプラインが正確なセレクタを必要とする際にレンダリングされたHTMLを返します。どちらもLLMステップの理想的な入力です。 - セッションの持続性と抗検出フィンガープリンティング — セッションを温め、ページネーションを進め、毎回ブラウザの状態を再構築することなくリクエスト間の行動の一貫性を保ちます。
- 構成可能なツール — 同じ
browser_*プリミティブ、scrape_markdown、scrape_htmlがソースごとに再構成されるため、サイトごとのアダプタは不要で、新しいレビューサーフェスの追加は、プロンプトの変更だけで済み、新しいプロジェクトではありません。
成長したときは料金ページでクオータを比較してください。無料プランでのAPIキーをapp.scrapeless.comで取得してください。
パイプラインの概要
ワークフローは五つのステージがあり、それぞれのステージが次のステージにクリーンなアーティファクトを引き渡します:
- 収集 — 公開されている各レビューページをスケジュールに基づいてレンダリングし、その内容をMarkdownまたはHTMLとして抽出します。
- 正規化 — 各ソースのレイアウトを一つのレビュー記録スキーマにマッピングします。
- 分析 — LLMを用いて感情をスコアリングし、トピックを分類します。
- 保存とエクスポート — 正規化され、スコアが付けられた記録をデータベース、データウェアハウス、またはスプレッドシートに永続化します。
- アラート — 滞留しているベースラインと比較し、ネガティブなスパイクが発生した際に通知を発火します。
以下のセクションでは、それぞれのステージを順に取り上げます。収集ステージはScrapelessツールに基づいており、後のステージはクリーンで正規化された出力が簡単に行える標準的なデータパイプライン作業です。
ステージ1 — スケジュールに基づいて公開されているレビューを収集
収集は、クラウドブラウザが解決するために存在するステージです:レビューURLにセッションをポイントし、レンダリングさせて内容を返します。抽出の正確さに応じて、2つのサーフェスがあります。
ほとんどのソースに対して、scrape_markdownが最も速いパスです — ページをレンダリングし、ナビゲーション、広告、フッターボイラープレートを取り除いたクリーンで読みやすいMarkdownを返し、LLMが読みたいテキストとほぼ完全に一致します。パイプラインが特定のDOMノードに基づく必要がある場合(星評価要素、確認済み購入バッジ、構造化日付など)、scrape_htmlはレンダリングされたHTMLを返すため、パーサーがこれらのセレクタを直接ターゲットにできます。
両方のツールは、地域に適合したページを返す住宅用出口を持つ抗検出クラウドブラウザで動作するため、返されるページは空のシェルや挑戦ではなく、レンダリングされた地域適合ページです。定期的なジョブ(cron、サーバーレスタイマー、またはワークフローランナー)がペースを推進します — ローンチウィンドウのために毎時、安定した監視のために毎日です。
Scrapeless MCPツールを使用した最小限の収集ステップは次のようになります。ステートレスツールは、ボディの前に出力をResponse:\n\nでプレフィックスしますので、パイプラインは解析する前にそのプレフィックスを削除します。
python
import os, requests

# scrape_markdown / scrape_htmlはScrapeless MCPサーバーで実行されます。
# 両方とも公開されているページを、住宅用出口を持つ抗検出クラウドブラウザでレンダリング
# するため、実際の訪問者が見る内容に一致します。

REVIEW_URLS = [
    "https://example-marketplace.com/product/SKU-123/reviews",
    "https://example-reviews.com/listing/acme-app",
]

def collect(url: str) -> str:
    # MCP駆動型エージェントではこれがツール呼び出しです:scrape_markdown(url=url)。
    # 以下の例では、スタンドアロンジョブの同等の意図を示しています。
    payload = {"url": url}  # セッションレベルで地域/プロキシ国を追加
    text = call_scrape_markdown(payload)        # クリーンなMarkdownを返す
    return text.removeprefix("Response:\n\n")    # ステートレスツールのプレフィックスを削除

raw_pages = {url: collect(url) for url in REVIEW_URLS}ページネーションまたは無限スクロールのレビューリストの場合、ブラウザのプリミティブはより重いフローを担います:browser_createはセッションを生成し、browser_gotoはリストに移動し、browser_scrollや「もっと読み込む」のコントロールをクリックすると古いレビューが表示され、browser_get_htmlはリストが成長するにつれて拡張されたページを返します。レビューページが設定された、地域に適したセッションに対してレンダリングされるように、リストの親ページでセッションを温めます。
ソースがレビューをローカライズする場合、その市場のプロキシ国でセッションの出口を固定します。同じ収集形状は、ターゲットがアプリストア、マーケットプレイスの製品ページ、旅行リスト、またはスタンドアロンのレビュー プラットフォームであっても機能します — 変わるのはURLとセレクタだけです。
ステージ2 — 1つのレビュー記録に正規化
すべてのレビューの表面には独自のレイアウト、フィールド名、日付形式があります。正規化ステージはそれらすべてを単一のスキーマにフラット化するため、下流のステージはレコードがどのソースから来たのかを知る必要がありません。実用的なレコードはパイプラインが必要とするもののみを保持し、著者のアイデンティティを最初から敏感なものとして扱います:
json
{
  "source": "example-marketplace",          // レビューがどの表面から来たのか
  "review_id": "rv_8f21c0",                  // ソースごとの安定した識別子(必要に応じてハッシュ化)
  "product": "Acme Wireless Earbuds",        // レビュー対象の商品またはリスト
  "rating": 2,                               // 1~5のスケールに正規化
  "title": "2週間後に充電が stopped",
  "body": "最初は問題なく動作しましたが、その後ケースが充電を保持しなくなりました...",
  "review_date": "2026年5月12日",            // DD-MMM-YYYY形式に正規化
  "author_display": "J. R.",                 // 最小限:イニシャルまたは粗いハンドルのみ
  "verified": true,                          // ソースがそれを公開している場合の認証購入フラグ
  "language": "ja",
  "collected_at": "2026年5月25日"
}正規化は決定論的マッピングです:各ソースの評価スケールを共通の1〜5に変換し、日付を一つの形式に解析し、タイトルと本文のテキストを抽出します。ステージ1からのクリーンなMarkdownは、タイトルと本文を簡単に隔離できるようにし、scrape_htmlからのレンダリングされたHTMLは、評価がdata-属性やアイコンカウントの中にあり、可視テキストでない場合に用いるものです。
ここには2つのデータ衛生ルールが含まれます。まず、重複を排除します—レビューのページは、実行ごとに同じエントリを再描画するため、安定したソースごとのreview_id(ネイティブID自体が識別する場合はハッシュ化)でキーを作成し、重複を削除します。次に、個人データを最小限に抑えます:author_displayをイニシャルまたは粗い公開ハンドルとして保持し、ログインの後ろにデータを収集せず、分析ステージで使用しないフィールドはスキップします。以下のコンプライアンスセクションでは、なぜこれが重要なのかについて詳しく説明します。
ステージ3 — センチメントとトピックの分析
すべてのレビューが一つのスキーマに揃った状態で、分析ステージは2つの派生フィールド—センチメントスコアとトピックタグ—を追加し、LLMが一回のパスで両方を処理します。収集ステージからのクリーンなテキストは、モデルが最も効果的に扱う入力であり、ナビゲーションやマークアップの混乱がありません。
python
def analyze(review: dict) -> dict:
    prompt = (
        "以下の顧客レビューを分類してください。\n"
        "JSONで返します:センチメント(ネガティブ、ニュートラル、ポジティブのいずれか)、"
        "センチメントスコア(-1.0から1.0)、およびトピック("
        "配送、請求、品質、サポート、使いやすさ、その他のいずれか)。\n\n"
        f"タイトル: {review['title']}\n"
        f"本文: {review['body']}"
    )
    result = call_llm(prompt)                 # あなたの選んだモデル
    review.update(result)                     # センチメント、センチメントスコア、トピックを追加
    return review

scored = [analyze(r) for r in normalized_reviews]トピックタグは、アラートを実行可能なものに変えるものです。すべて配送にタグ付けされたネガティブレビューの急増は、サポートとオペレーションに fulfillment の問題を指摘します。同じ急増が請求にタグ付けされていると、異なるチームへの同じアラートが送られます。ラベルセットは小さく固定しておくことでタグが実行間で比較可能な状態に保たれます。
無料プランであなたのAPIキーを取得する:app.scrapeless.com
ステージ4 — 保存とエクスポート
ストレージステージは、パイプラインが時間の経過とともにトレンドを計算できるように、スコア付きの正規化されたレコードを永続化し、他のチームがデータを問い合わせる際に収集を繰り返さなくても済むようにします。どのストレージでも機能します — 関係データベース、データウェアハウスまたは軽量セットアップのためのスプレッドシートです。ステージ2のスキーマに加え、ステージ3からの2つの派生フィールドが行を構成します。
ストレージを便利に保つ2つの設計選択があります。collected_atタイムスタンプで追加専用で書き込むことにより、履歴が保持され、ローリングベースラインを計算するのが簡単になります。そして、source、product、およびreview_dateでインデックスを付けることにより、アラートステージがそれらのいずれかを迅速にスライスできるようにします。エクスポートは、その後同じストレージに対する読み取りとなります — BIツールへのスケジュールされたプッシュ、共有ドライブへの毎日のCSV、またはサポートと販売データに対する結合のためのデータウェアハウスへの同期です。レコードはすでに正規化され、スコアが付けられているため、下流の消費者はレビューがアプリストアから来たものであってもマーケットプレイスから来たものであっても同じ形を見ることができます。
ステージ5 — ネガティブスパイクにアラートを出す
最終ステージは、パイプラインを定期的に実行する価値を生み出します。すべての新しいレビューでアラートを発するのはノイズであり、センチメントの変化でアラートを発するのが信号です。ローリングベースラインを計算します — 例えば、過去7日間の製品ごとの平均センチメントスコアとネガティブレビュー数 — そして、各新しいバッチをそれに対して比較します。ネガティブ数または平均スコアがそのベースラインに対してしきい値を超えた場合、通知を発動します。
python
以下は、指定された英語のテキストを日本語に翻訳したものです:

```python
def check_spike(product: str, recent: list[dict], baseline: dict) -> bool:
    neg_now = sum(1 for r in recent if r["sentiment"] == "negative")
    # スパイク = 今日のネガティブコメントが過去のベースラインを大きく上回っていること。
    return neg_now >= max(baseline["neg_avg"] * 2, baseline["neg_avg"] + 3)

def alert(product: str, recent: list[dict]) -> None:
    top = [r for r in recent if r["sentiment"] == "negative"][:5]
    requests.post(
        os.environ["ALERT_WEBHOOK_URL"],
        json={
            "text": f"{product}のネガティブレビューのスパイク",
            "examples": [
                {"topic": r["topic"], "title": r["title"], "rating": r["rating"]}
                for r in top
            ],
        },
        timeout=15,
)ウェブフックはチャットチャンネル、インシデントツール、またはメールゲートウェイをターゲットにすることができます。支配的なトピックといくつかの代表的なタイトルをペイロードに含めることで、受信チームは同じメッセージ内で何と理由を見ることができます — 出荷のスパイクは請求のスパイクとは異なる意味を持ちます。
スケジューラーは5つのステージを結びつけます:各ティックで最新の公開レビューを収集し、正規化してスコアリングし、ストアに追加し、ベースラインを再計算し、スパイクをチェックします。通常、定常状態の監視には日次で十分です。起動中やアクティブなインシデントの場合は、時間ごとに厳しくします。同時実行性は控えめに保ちます — ホストごとに約3セッション — そうすれば、収集ステージは単一ソースに対しても良好に動作します。
返されるもの
完全なパスの後、ストア内の各レコードは正規化されたフィールドと2つの導出フィールドを持ちます。以下の形は規範的です;フィールド値は例示的なサンプルです。
json
{
  "source": "example-marketplace",
  "review_id": "rv_8f21c0",
  "product": "Acme Wireless Earbuds",
  "rating": 2,
  "title": "2週間後に充電が止まりました",
  "body": "最初はうまくいっていましたが、その後ケースが充電を保持できなくなりました...",
  "review_date": "2026年5月12日",
  "author_display": "J. R.",
  "verified": true,
  "language": "en",
  "collected_at": "2026年5月25日",
  "sentiment": "negative",          // ステージ3で追加されました
  "sentiment_score": -0.72,          // ステージ3で追加されました
  "topic": "quality"                 // ステージ3で追加されました
}
出力に関するいくつかの正直な観察:
- 水分補給のタイミングはソースによって異なる。 一部のレビューリストはすぐに充填され、他のものはスクロールで遅延読み込みされます。ページを読む前にレビューコンテナが表示されるのを待ち、
browser_scrollを使用して無限スクロールリストの古いエントリを表示します。 - セレクタが回転する。 レビューサイトは再設計され、評価要素や確認購入バッジが移動します。最も安定したコンテナに依存し、目に見える再設計の後にセレクタを再確認します。
- 一部のフィールドは条件付きである。 確認購入フラグ、役立ち票数、レビュアーの位置情報は一部のソースに表示され、他のソースには表示されません — 存在しないフィールドは存在すると仮定するのではなく、ヌル可能なものとして扱います。
- 同意と地域が重要です。 地域特有のレビューを示す同意のインタースティシャルが表示されることがあるため、セッションの出口をターゲット市場に固定し、そこに本物の訪問者が見るコンテンツと一致させます。
- 感情はモデルの判断である。 スコアは導出された信号であり、真実の地面ではありません。警告を確認できるように元のタイトルと本文を一緒に保持します。
レビュアーの個人データを責任を持って処理する
レビューは公開されていますが、人々によって書かれており、それに付随する名前、ハンドル、および時には場所は個人データです。モニタリングパイプラインは、できるだけ少ないそのデータを必要とするように構築されるべきです。
実務的な姿勢:公開されているコンテンツのみを収集し、決してログインの背後にあるものは収集せず、分析が必要としない限り、フルのレビュアー名の代わりにイニシャルや粗い公開ハンドルを保存することで保持するものを最小限にします。また、感情分析のために本文のテキストを保持しつつ、個々のレビュアーのプロファイルをソースをまたいで構築しないようにします。法域のプライバシー規則が適用される場合は、それを尊重し、要求に応じて削除する義務を含め、古いレコードが無限に蓄積されるのではなく時限保存されるように保持ウィンドウを文書化してください。目標は商品の集約信号であり、個人に関するファイルではありません。スキーマと保持ルールはそれを反映するべきです。
結論:散発的なレビューを1つの監視信号に変える
レビュー監視パイプラインは5つの動きに集約されます:公開されているページをレンダリングし、正規化し、スコアリングし、保存し、スパイクに警告します。Scrapeless Scraping Browserは、JavaScriptや検出回避チャレンジを通じてレンダリングされた地域に正しいレビューページに到達するという本当に困難な動きを処理し、scrape_markdownとscrape_htmlがパイプラインの残りの部分にクリーンな入力を提供します。すべてのダウンストリームは、正規化されたスキーマによって簡単にされた通常のデータ作業です。
セッションの出口をレビューが来る市場に固定し、最初の段階で著者データを最小限に抑え、安定したコンテナにアンカーを設定し、再設計後にセレクタを再確認し、不足しているフィールドをnullableとして扱います。複数のソースにわたる同じプリミティブを構成する広い視点については、[5つのScrapeless MCPユースケース](https://www.scrapeless.com/ja/blog/5-scrapeless-mcp-use-cases-2026?utm_source=website&utm_medium=blog&utm_campaign=scrapingbrowser&utm_term=review-monitoring-pipeline-scrapeless)と[AIエージェントユースケースガイド](https://www.scrapeless.com/ja/blog/ai-agent-use-cases-scrapeless-2026?utm_source=website&utm_medium=blog&utm_campaign=scrapingbrowser&utm_term=review-monitoring-pipeline-scrapeless)を参照してください。ツールとSDKの完全なセットアップは[ドキュメント](https://docs.scrapeless.com?utm_source=website&utm_medium=blog&utm_campaign=scrapingbrowser&utm_term=review-monitoring-pipeline-scrapeless)にあります。

---

## AIパワーのデータパイプラインを構築する準備はできましたか?

無料プランを利用してレビュー監視パイプラインを構築している開発者とつながるために、コミュニティに参加してください:[Discord](https://discord.gg/VU2vtbq7Q2) · [Telegram](https://t.me/scrapeless)。

[app.scrapeless.com](https://app.scrapeless.com/passport/login/?utm_source=website&utm_medium=blog&utm_campaign=scrapingbrowser&utm_term=review-monitoring-pipeline-scrapeless)にサインアップして無料のScraping Browserランタイムを入手し、上記のパターンをレビューページ、製品、およびパイプラインが必要とする地域に適用してください。

---

## よくある質問

**Q: オンラインレビューの監視は合法ですか?**

パイプラインは公開されているレビューコンテンツのみを読み取ります — ログインやプライベートアカウント、制限されたソースの裏側のものは一切含まれません。レビューは人によって書かれるため、そこに付随する名前やハンドルは個人データです;必要な最小限を収集し、可能な限りフルネームではなく粗い識別子を保存し、削除義務を含む適用可能なプライバシールールを尊重してください。法令やプラットフォームの規約は管轄区域やサイトごとに異なるため、各ソースの利用規約を確認し、特定の使用については法律相談を受けてください。

**Q: プロキシは必要ですか?**

はい。レビューページはIPの評判を評価し、コンテンツをローカライズすることが多いため、Scrapeless Scraping Browserは195カ国以上の住宅用プロキシを使用します。セッションの出口をレビューが来る市場に固定することで、評価やレビューのテキストがその地域の実際の訪問者が見るものと一致します。

**Q: パイプラインはどのくらいの頻度で実行すべきですか?**

リスクに合わせて頻度を調整します。安定期間のブランド監視には通常、毎日の収集で十分ですが、製品のローンチや活発なインシデントの際は、ネガティブな急上昇を迅速に浮上させるために毎時に強化します。スケジューラが頻度を管理します — cron、サーバーレスタイマー、またはワークフローランナーはすべて機能します。

**Q: パイプラインは動的でJavaScript重視のレビューページをどのように処理しますか?**

アンチ検知クラウドブラウザはサーバー側でページをレンダリングするため、レイジーロードリスト、「もっと読み込む」コントロール、同意フローはコンテンツが返される前に解決されます。cleanなテキストには`scrape_markdown`を使用し、特定のDOMノードにアンカーを合わせる必要がある場合は`scrape_html`を使用し、ページネーションされたリストや無限スクロールのレビューリストを表示およびキャプチャするためには`browser_scroll`と`browser_get_html`を合わせて使用します。

**Q: ここでの`scrape_markdown`と`scrape_html`の違いは何ですか?**

`scrape_markdown`はナビゲーションやボイラープレートを除去し、クリーンで読みやすいMarkdownを返します — 感情ステップへの直接的な入力として理想的です。`scrape_html`はレンダリングされたHTMLを返し、評価、日付、または確認された購入バッジが構造化されたDOMノードに存在する場合、パーサーが正確にターゲットにする必要があるものです。

**Q: AIエージェントなしでこれを実行できますか?**

はい。収集ツールはスタンドアロンの呼び出しとして実行され、ノーマライズ、ストア、アラート段階は通常のコードとして機能するため、パイプライン全体がスケジュールされたジョブとして働きます。これをAIエージェントを介してMCPで駆動するのは便利な方法ですが、必須ではありません。

**Q: レビューサイトが再設計されたときにセレクタを機能させ続けるにはどうすればよいですか?**

ページが公開する最も安定したコンテナにアンカーを設定し、条件付きフィールドをnullableとして扱います。目に見える再設計の後には、一度新たに収集を行い、新しいレイアウトに対してコンテナとフィールドセレクタを確認し、ノーマライズマッピングを更新します — パイプラインの残り部分は影響を受けません。なぜなら、それは常にノーマライズされたスキーマのみを参照するからです。
Scrapelessでは、適用される法律、規制、およびWebサイトのプライバシーポリシーを厳密に遵守しながら、公開されているデータのみにアクセスします。 このブログのコンテンツは、デモンストレーションのみを目的としており、違法または侵害の活動は含まれません。 このブログまたはサードパーティのリンクからの情報の使用に対するすべての責任を保証せず、放棄します。 スクレイピング活動に従事する前に、法律顧問に相談し、ターゲットウェブサイトの利用規約を確認するか、必要な許可を取得してください。





