• Navegador de agentes
  • Precios
  • Documentos
Loading Light/Dark Toggle

Productos

Navegador de agentes

Rascadores de IA

Scraper de ChatGPT
Scraper de Perplexity
Scraper de Gemini
Scraper de Copilot
Scraper de Google AI Mode
Scraper de Google AI Overview
Scraper de Grok

Desarrolladores

Documentación
Referencia de API
Estado

Legal

política de privacidad
Condiciones de uso
Política de reembolso
No vendas mi información

Centro de aprendizaje

Blog de raspado
Integración
Preguntas frecuentes
Glosario

© 2026 NST LABS TECH LTD.
All Rights Reserved.

Todos los servicios están en línea.

© 2026 NST LABS TECH LTD.
All Rights Reserved.

Contáctenos

Descargo de responsabilidad: Scrapeless cumple estrictamente con las leyes y regulaciones de cada región, y no participamos en ningún acceso no autorizado ni recopilación de datos de fuentes privadas, confidenciales o restringidas.

Blog de raspado web

La guía más completa, creada para todos los desarrolladores de Web Scraping.

Contacta con nuestro equipo de ventas
Monday to Friday, 9:00 AM - 18:00 PMSingapore Standard Time (UTC+08:00)

Scrapeless ofrece servicios de automatización y raspado web robustos, escalables y basados ​​en IA en los que confían empresas líderes. Nuestras soluciones de nivel empresarial están diseñadas para satisfacer las necesidades de su proyecto, con soporte técnico dedicado en todo momento. Con un equipo técnico sólido y tiempos de entrega flexibles, cobramos solo por los datos exitosos, lo que permite una extracción de datos eficiente y evitamos las limitaciones.


Contáctenos ahora para impulsar el crecimiento de su negocio.

4.8
4.5
4.8
8.5
Reserva una demostración

Proporcione sus datos de contacto y nos comunicaremos con usted de inmediato para ofrecerle una demostración e introducción del producto. Nos aseguramos de que su información permanezca confidencial, cumpliendo con los estándares GDPR.

Regístrese y solicite Prueba gratuita

¡Tu prueba gratuita está lista! Regístrese para obtener una cuenta Scrapeless de forma gratuita y su prueba se activará instantáneamente en su cuenta.

Inscribirse

Artículos más populares

Scrapeless n8n Integration v0.5.4: Flujos de Trabajo de Scrapeo de IA
Scrapeless Official para n8n v0.5.4 agrega siete acciones de Scraper AI. Aprende cómo configurarlas y construir un flujo de trabajo de respuestas AI de múltiples motores.
07-Aug-2026
Flujo de trabajo del scraper AI Scrapeless n8n que conecta siete motores de respuesta AI a salidas de automatización estructuradas.
Guía de la API de Scraper de TikTok: Perfiles, Publicaciones y Datos de Tienda
Una guía práctica para actores para recopilar y modelar datos de perfiles públicos de TikTok, publicaciones y productos de Shop con Scrapeless.
01-Sep-2026
Flujo de trabajo de la API de raspado de TikTok para datos de perfiles, publicaciones y productos de Shop
¡El servidor MCP sin desperdicio ya está en funcionamiento! Crea tu conector web de IA definitiva.
Descubre cómo el servidor Scrapeless MCP proporciona a los LLM capacidades de navegación web y scraping en tiempo real. Aprende a construir agentes de IA que busquen, extraigan e interactúen sin problemas con contenido web dinámico.
01-Sep-2026
Servidor MCP sin desperdicios

El último

Alternativas de LangChain: Elige un Marco de Agente para Datos Web

Compara las alternativas de LangChain para agentes tipados, pipelines de recuperación y orquestación, luego conecta una herramienta MCP Scrapeless verificada a un objeto de agente en funcionamiento.
Daniel KimDaniel Kim
30-Sep-2026
Tres estructuras de marco de agentes conectadas a un centro de herramientas de datos web compartido.

Las mejores herramientas de recopilación de datos de IA para RAG y agentes en 2026

Compare herramientas de recopilación de datos de IA para RAG y agentes por captura de corpus, control de actualización, evidencia de fuente y registros aceptados en lugar de listas de características.
Isabella GarciaIsabella Garcia
30-Sep-2026
Herramientas de recopilación de datos de IA alimentando un archivo de corpus RAG, con linaje de fuente y versiones de documentos actualizadas.

Google Trends con Python: Recoger Intereses y Temas de Tendencia

Recolecta Google Trends con Python utilizando flujos de trabajo RSS de interés a lo largo del tiempo y Tendencias Ahora por separado, luego preserva la geografía, las fechas y el significado de las métricas.
Alex JohnsonAlex Johnson
30-Sep-2026
Google Trends con Python: Recopilar Interés y Temas en Tendencia. Un gráfico de serie temporal de vidrio oscuro con cuatro picos brillantes al lado de una pila separada de tarjetas de noticias en tendencia, mostrando diferentes superficies de datos.

API de Scraper de ChatGPT: Captura de Respuestas y Evidencia de Citación

Utiliza una API de Scraper de ChatGPT para preservar instantáneas de respuestas, condiciones de recopilación y evidencia de citación, mientras mantienes la extracción de páginas web como un flujo de trabajo separado.
Emily ChenEmily Chen
30-Sep-2026
ChatGPT Scraper API: Captura de Respuestas y Evidencia de Citación. Un panel de respuestas de IA de vidrio oscuro con burbujas de chat genéricas, vinculado a tarjetas de citación flotantes y un archivo de evidencia preservado.

Mejores bibliotecas de Web Scraping en JavaScript: Elige la capa adecuada

Compara las bibliotecas de scraping web de JavaScript mediante análisis, renderizado en el navegador y orquestación de rastreos, con un ejemplo ejecutable y un camino de integración de navegador en la nube.

Ava WilsonAva Wilson
29-Sep-2026
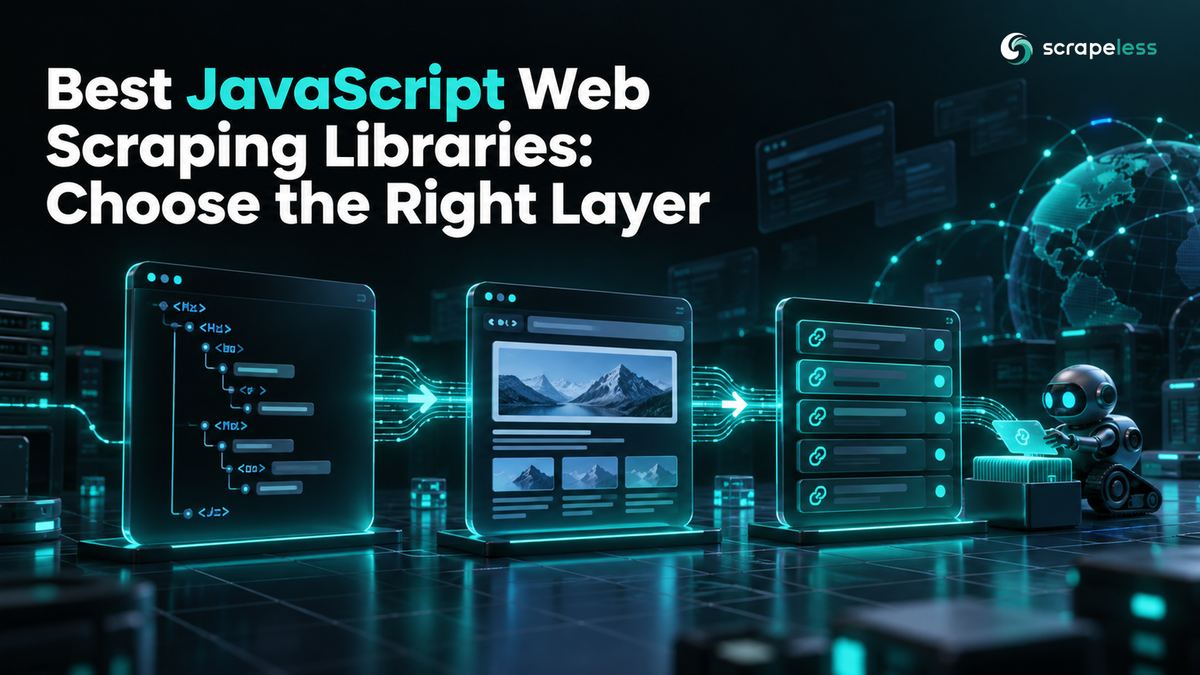
Un pipeline horizontal de tres capas translúcidas: árbol del documento HTML, página renderizada del navegador y cola de rastreo, conectadas con luz azul verdosa.

Mejores clientes HTTP de Python para web scraping: Una comparación práctica

Compara clientes HTTP de Python para web scraping, incluyendo Requests, HTTPX, aiohttp y urllib3, con comprobaciones ejecutables y límites claros para la representación de JavaScript.

Alex JohnsonAlex Johnson
29-Sep-2026
Cuatro flujos paralelos de paquetes de solicitudes HTTP pasan a través de un panel de respuesta de vidrio compartido, con un carril sincrónico claro y carriles asincrónicos agrupados.

Mejores Scrapers de Amazon: Comparar APIs, Herramientas de Escritorio y Extensiones

Comparar los scrapers de Amazon a través de APIs gestionadas, flujos de trabajo de escritorio y extensiones de navegador, con una lista de verificación práctica de calidad de datos y límites de integración claros.

Emily ChenEmily Chen
29-Sep-2026
Tres dispositivos de vidrio oscuro distintos: un panel de datos de API, una cuadrícula de catálogo de escritorio y una tarjeta de extensión de navegador, con cajas de producto genéricas.

Ejemplos de Servidor MCP: Componer un Flujo de Trabajo de Investigación Web

Explora ejemplos de servidores MCP para la investigación en la web: combina herramientas Scrapeless con un servidor de sistema de archivos delimitado, verifica el descubrimiento de herramientas y preserva la evidencia de origen.

Daniel KimDaniel Kim
29-Sep-2026
El navegador de búsqueda de vidrio distinto y los archivos de archivos se conectan a través de un centro de orquestación central, separados en etapas claras.
  • Anterior
  • 1
  • 2
  • 3
  • Próximo