
LangChain + Scrapeless: Crea un asistente de investigación con fuentes citadas
Expert in Web Scraping Technologies
TL;DR:
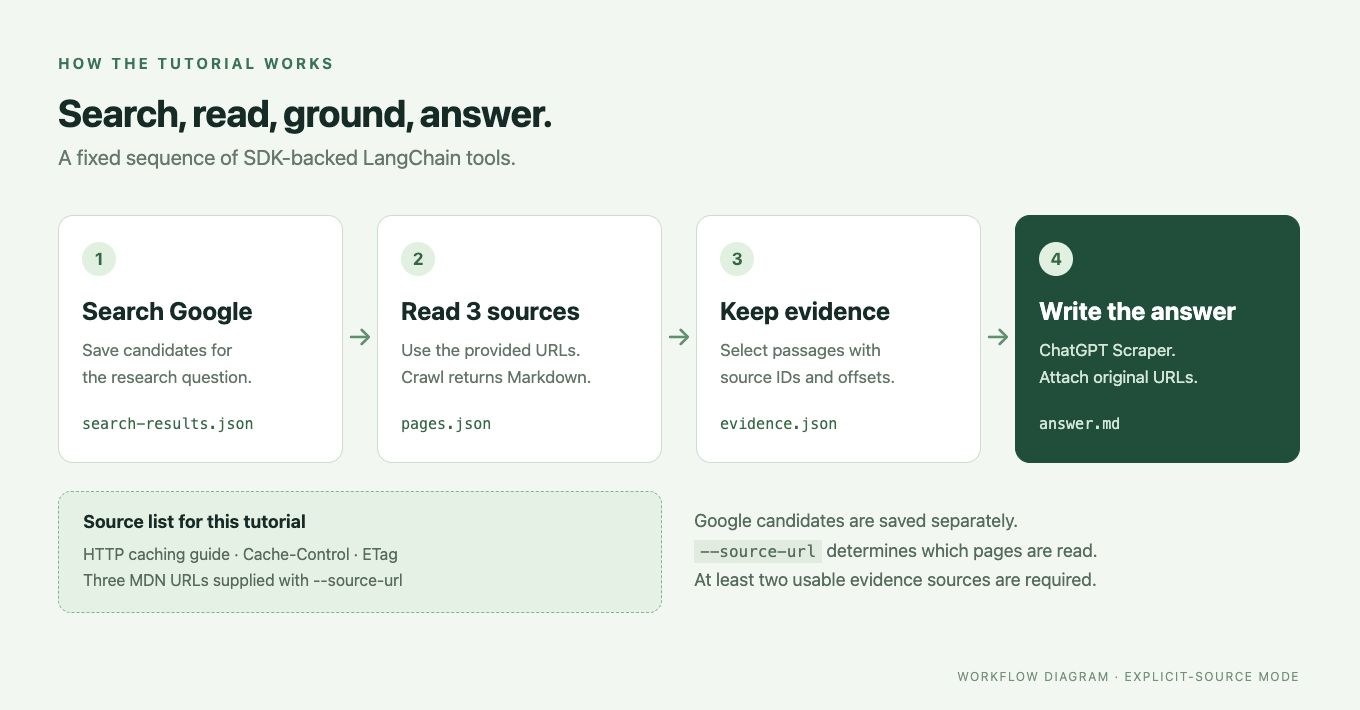
- LangChain y Scrapeless pueden convertir páginas de documentación en una respuesta con citas de origen. El ejemplo busca en Google, lee los cuerpos de las páginas, selecciona fragmentos y genera una explicación con IDs de fuentes.
- El flujo de trabajo mantiene la evidencia de recopilación junto a la respuesta final. Los candidatos de búsqueda, el Markdown de las páginas y los desplazamientos de los fragmentos permanecen disponibles para su inspección.
- Las URLs de origen explícitas controlan qué páginas se leen. La Búsqueda de Google sigue ejecutándose, pero sus candidatos se conservan por separado del conjunto de documentación suministrado.
- Las comprobaciones de citas verifican IDs y estructura, no todas las afirmaciones técnicas. Revisa las oraciones importantes frente a los fragmentos almacenados y las páginas originales.
What You Will Build
Esta integración de LangChain y Scrapeless construye un asistente de investigación en Python que responde: “¿Cómo funcionan juntos Cache-Control y ETag en el almacenamiento en caché HTTP?”
Una explicación útil necesita los detalles dentro de las páginas de documentación y una forma de inspeccionarlos. Los fragmentos de búsqueda pueden identificar una página, pero no preservan las condiciones circundantes detrás de una regla de caché. Por lo tanto, el asistente lee las páginas seleccionadas, almacena su Markdown y pasa los fragmentos relevantes a la etapa de generación de la respuesta.
La ejecución final escribe answer.md, con una explicación, tabla comparativa, ejemplo ilustrativo, limitaciones y enlaces a las fuentes originales. También guarda search-results.json, pages.json y evidence.json. En conjunto, estos archivos te permiten inspeccionar cómo se armó una respuesta.
El flujo de trabajo es una secuencia fija de herramientas de LangChain. No le pide a un agente autónomo que elija su próximo paso y no necesita una base de datos vectorial para este pequeño conjunto de documentación.
How the Scrapeless Tools Fit Together
La integración expone búsqueda, recopilación y generación de respuestas a través de la interfaz .invoke() de LangChain.
| Tool | Responsibility in the research assistant |
|---|---|
ScrapelessDeepSerpGoogleSearchTool |
Recupera candidatos de búsqueda para la consulta de investigación |
ScrapelessCrawlerScrapeTool |
Recopila los cuerpos de las páginas seleccionadas como Markdown |
ScrapelessChatGPTScraperTool |
Produce una respuesta a partir de la pregunta suministrada y los fragmentos |
La Google Search API proporciona los resultados de descubrimiento. Scrapeless Crawl proporciona el contenido de las páginas. ChatGPT Scraper maneja la etapa de respuesta mediante el SDK de Python. Una sola clave de Scrapeless cubre estas llamadas de servicio; este ejemplo no requiere una clave separada del proveedor de modelo.
Para un agente que elige herramientas dinámicamente, la integración de LangGraph y Scrapeless MCP cubre una arquitectura diferente.
Estas son herramientas invocables que siguen la interfaz de herramienta de LangChain. El script de investigación añade la política de selección de fuentes, archivos de artefactos y comprobaciones de citas a su alrededor. Esas reglas de aplicación no son garantías automáticas del modelo subyacente.
Prerequisites
Usa Python 3.10 o posterior, Git, una terminal y una clave de API de Scrapeless con acceso y créditos disponibles para Google Search, Crawl y ChatGPT Scraper.
Este tutorial está orientado a langchain-scrapeless 0.1.4 y su dependencia bloqueada Scrapeless Python SDK 1.3.0. Se necesita la copia del código fuente porque examples/research.py es un ejemplo del repositorio; instalar solo el archivo wheel no crea ese ejemplo en tu directorio de trabajo.
Nota: Los comandos de servicio que aparecen a continuación requieren tu propia clave y créditos. Este artículo utiliza el ejemplo retenido del proyecto original y una revisión local de paquete/pruebas; no afirma realizar una nueva búsqueda en vivo, recopilación de Crawl o respuesta generada. La inicialización local no es una prueba de autenticación ni de acceso a la cuenta.
Obtén la clave a través de la gestión de claves de API de Scrapeless. Revisa los precios de Scrapeless antes de ampliar el número de preguntas y fuentes.
Step 1: Install the Package and Research Example
Instala el paquete publicado en un entorno aislado y utiliza el ejemplo de código fuente revisado correspondiente.
El repositorio oficial de LangChain Scrapeless contiene el script de investigación y la implementación de la integración. En macOS o Linux:
bash
git clone https://github.com/scrapeless-ai/langchain-scrapeless.git
cd langchain-scrapeless
git checkout 77f4724855e69d4dd5e636c1d3d3fe29f631fc96
python3 -m venv .venv
source .venv/bin/activate
python -m pip install "langchain-scrapeless==0.1.4"
python -m pip check
Configura la clave en la misma shell. El valor a continuación es un marcador de posición, no una credencial:
bash
export SCRAPELESS_API_KEY="YOUR_SCRAPELESS_API_KEY"En Windows PowerShell, crea el entorno con py -3 -m venv .venv, actívalo con .\.venv\Scripts\Activate.ps1 y usa $env:SCRAPELESS_API_KEY = "YOUR_SCRAPELESS_API_KEY". Coloca los comandos multilínea en una sola línea o usa la sintaxis de continuación de PowerShell.
Comprueba la inicialización de las herramientas locales:
bash
python examples/research.py checkLa comprobación construye las tres herramientas e informa de la versión instalada del SDK de Scrapeless. No realiza ninguna solicitud al servicio. Una comprobación correcta muestra que las importaciones y la configuración local funcionan; las etapas siguientes ejercitan la API.
Paso 2: Elegir la pregunta y la política de fuentes
La etapa de búsqueda guarda los candidatos de Google y asigna IDs estables a las páginas seleccionadas para la recopilación.
Para una primera ejecución controlada, proporciona la guía de caché de MDN y sus referencias Cache-Control y ETag. La guía de caché HTTP explica el comportamiento de caché relacionado; la referencia de ETag describe el validador usado en la pregunta.
Nota: Este comando llama a Google Search y requiere el acceso al servicio indicado en los requisitos previos. No es un ejemplo sin conexión.
bash
python examples/research.py search --output-dir http-cache-research \
  --question "How do Cache-Control and ETag work together in HTTP caching?" \
  --query "HTTP caching Cache-Control ETag" \
  --source-url https://developer.mozilla.org/en-US/docs/Web/HTTP/Guides/Caching \
  --source-url https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Headers/Cache-Control \
  --source-url https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Headers/ETag
Abre http-cache-research/search-results.json. search_candidates contiene la salida de la búsqueda; sources contiene el conjunto de páginas seleccionadas. Con URLs explícitas, los registros de fuentes usan origin: provided. Se trata de una selección de fuentes controlada, no de una afirmación de que Google eligió esas páginas automáticamente.
Sin --source-url, el script selecciona resultados aptos del dominio configurado. El valor predeterminado es developer.mozilla.org. El script requiere al menos dos URLs distintas aptas y conserva como máximo tres. Al cambiar el dominio de la documentación, actualiza --domain junto con la pregunta, la consulta y las URLs de las fuentes.
Usa un nuevo directorio de salida para una nueva búsqueda. El script rechaza un directorio que ya contenga search-results.json, lo que evita mezclar accidentalmente preguntas de investigación separadas.
Paso 3: Recopilar cuerpos de páginas y generar evidencia
La etapa de recopilación lee las URLs guardadas y extrae pasajes de los cuerpos de sus páginas.
Nota: Este comando llama a Scrapeless Crawl y requiere una etapa de búsqueda completada y tu acceso a la API configurado.
bash
python examples/research.py scrape --output-dir http-cache-researchScrapelessCrawlerScrapeTool solicita contenido principal y en Markdown. El script asigna los documentos devueltos a sus URLs de origen originales y luego escribe el estado, el texto y los metadatos de cada página en pages.json.
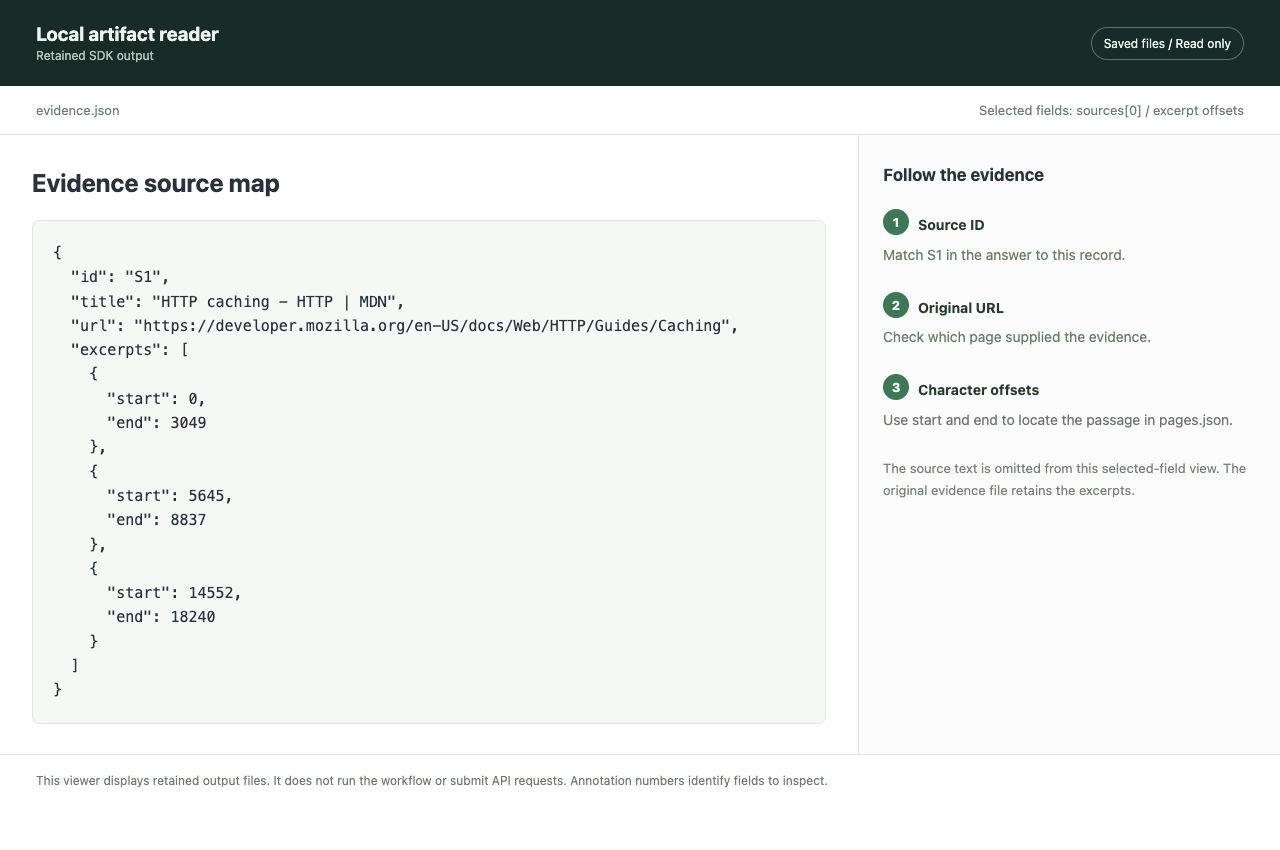
A continuación, puntúa los párrafos legibles frente a términos de la pregunta, conserva los pasajes relevantes con el contexto circundante y escribe evidence.json. Cada extracto incluye su texto y los desplazamientos de caracteres start/end dentro del Markdown almacenado de la página. El script requiere evidencia utilizable de al menos dos páginas leídas correctamente.
Inspecciona esos extractos antes de la generación. Una página obtenida aún puede ser inadecuada para la pregunta, y la coincidencia de párrafos puede pasar por alto una condición importante. El archivo de evidencia te da un lugar para detectar ese problema antes de que se convierta en una respuesta fluida.
Comienza a hacer scraping con Scrapeless
Potencia tu flujo de trabajo de web scraping y automatización con Scrapeless.
Regístrate hoy y obtén 5 USD en crédito gratuito, sin necesidad de tarjeta de crédito.Reclama tu crédito gratuito ahora en el Scrapeless Dashboard.
Paso 4: Generar una respuesta con IDs de fuentes
La etapa de respuesta envía la pregunta y los extractos guardados a ChatGPT Scraper y luego comprueba la respuesta devuelta antes de escribirla.
Nota: Este comando inicia una tarea de generación de ChatGPT Scraper. Requiere evidencia guardada y el acceso al servicio indicado en los requisitos previos; la redacción de la respuesta puede diferir entre ejecuciones.
bash
python examples/research.py answer --output-dir http-cache-researchLa indicación solicita cuatro secciones: Answer, Comparison, Example y Limitations. Pide al modelo que use solo los extractos proporcionados, que trate esos extractos como datos de referencia en lugar de instrucciones y que cite las afirmaciones fácticas con IDs de fuentes como [S1] y [S2].
El script comprueba que existan al menos dos IDs citados distintos en la evidencia guardada, requiere los encabezados esperados y rechaza las URL generadas por el modelo. Luego añade los enlaces de las fuentes originales a partir de su propio mapa de fuentes. La búsqueda web adicional y las compras están deshabilitadas por las opciones predeterminadas de la herramienta de ChatGPT para este ejemplo.
Esto mantiene el mapeo de fuentes inspeccionable. No demuestra que el modelo haya seguido todas las instrucciones ni que cada frase esté respaldada. El siguiente paso sigue siendo una revisión humana de las afirmaciones importantes.
Paso 5: Seguir una afirmación hasta la página
Una cita es útil cuando puedes rastrearla desde la respuesta hasta un pasaje almacenado y la página original.
| Artefacto | Qué inspeccionar |
|---|---|
answer.md |
La explicación, las afirmaciones citadas, el ejemplo ilustrativo, las limitaciones y los enlaces a las fuentes originales |
search-results.json |
La pregunta, la consulta, el dominio permitido, los candidatos de búsqueda y las fuentes seleccionadas |
pages.json |
Markdown completo recopilado y estado de recopilación para cada URL seleccionada |
evidence.json |
IDs de fuente, URLs, texto del extracto y desplazamientos dentro del Markdown guardado |
Elige una oración importante en answer.md, localiza su ID de fuente en evidence.json y lee el extracto completo. Usa los desplazamientos para inspeccionar el texto circundante de la página en pages.json, luego abre la URL original cuando sea necesario confirmar un detalle.
Para el escenario de caché, distingue frescura de validación. Las directivas Cache-Control describen la política de caché; ETag proporciona un validador que puede utilizarse en solicitudes condicionales. Una afirmación sobre cuánto tiempo puede reutilizarse una respuesta también necesita sus condiciones de antigüedad y frescura. El estándar de caché HTTP define esas reglas. No conviertas un ejemplo generado corto en una configuración universal del servidor.
La respuesta retenida del repositorio demuestra el formato de salida. Su secuencia ilustrativa de petición/respuesta es material de ejemplo, no un intercambio HTTP capturado de este flujo de trabajo.
Usa las herramientas en tu propia aplicación de LangChain
Se pueden llamar a las mismas herramientas directamente cuando quieras reemplazar el contenedor de línea de comandos con código de aplicación.
El siguiente ejemplo utiliza las funciones de investigación del repositorio para que el filtrado de fuentes, las comprobaciones de evidencia y la validación de citas permanezcan en una sola implementación. Guárdalo como research_demo.py en la raíz del repositorio.
Nota: Ejecutar este script realiza llamadas de búsqueda, recopilación y generación. Requiere las credenciales y créditos descritos en los requisitos previos; no es un resultado capturado ni un fixture sin conexión.
python
from pathlib import Path

from examples.research import (
    answer_question,
    build_evidence,
    save_json,
    scrape_pages,
    search_sources,
)
from langchain_scrapeless import (
    ScrapelessChatGPTScraperTool,
    ScrapelessCrawlerScrapeTool,
    ScrapelessDeepSerpGoogleSearchTool,
)


def main():
    output = Path("application-research-output")
    output.mkdir(exist_ok=False)
    urls = [
        "https://developer.mozilla.org/en-US/docs/Web/HTTP/Guides/Caching",
        "https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Headers/Cache-Control",
        "https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Headers/ETag",
    ]
    search = search_sources(
        ScrapelessDeepSerpGoogleSearchTool(),
        "How do Cache-Control and ETag work together in HTTP caching?",
        "HTTP caching Cache-Control ETag",
        "developer.mozilla.org",
        urls,
    )
    save_json(output / "search-results.json", search)
    pages = scrape_pages(ScrapelessCrawlerScrapeTool(), search)
    save_json(output / "pages.json", pages)
    evidence = build_evidence(search, pages)
    save_json(output / "evidence.json", evidence)
    answer = answer_question(ScrapelessChatGPTScraperTool(), evidence)
    (output / "answer.md").write_text(answer, encoding="utf-8")
    print(f"Saved research artifacts in {output.resolve()}")


if __name__ == "__main__":
    main()
Ejecuta el script con python research_demo.py. Cada función auxiliar llama a la herramienta correspondiente a través de .invoke(): la búsqueda pasa una consulta y localización, la recopilación pasa URLs y opciones de Markdown, y la generación de respuestas pasa el prompt de evidencia. Las funciones auxiliares son código de ejemplo del repositorio, así que mantén la copia del código fuente junto a tu aplicación o copia las funciones revisadas en tu propio módulo mantenido.
Para una pregunta diferente sobre la misma documentación, cambia la pregunta y la consulta conjuntamente. Para un sitio diferente, cambia también el dominio permitido y las URLs. Mantén un directorio de salida separado para cada ejecución de investigación.
Manejar evidencia incompleta
Una ejecución incompleta debe conservar su estado de recopilación y detenerse antes de presentar una respuesta sin respaldo.
Si muy pocas páginas aportan contenido relevante, inspecciona pages.json y ajusta la selección de fuentes. No reemplaces cuerpos de página faltantes con fragmentos mientras continúas describiendo la respuesta como basada en páginas. Si una tarea de servicio no está terminada, inspecciona su estado de tarea existente antes de iniciar más trabajo.
Mantén un solo directorio de salida a lo largo de las etapas de una misma ejecución. La CLI proporcionada usa IDs de ejecución para rechazar evidencia de una búsqueda diferente y un bloqueo de directorio para evitar que comandos superpuestos escriban el mismo conjunto de artefactos. Estos controles protegen la consistencia de los archivos; no evalúan la corrección técnica de la respuesta.
Conclusión
La integración de LangChain con Scrapeless proporciona a este asistente de investigación una herramienta invocable para cada paso externo. El ejemplo añade una política de fuentes explícita y mantiene juntos los resultados de búsqueda, los cuerpos de página, los extractos y la respuesta final. Comienza con la pregunta sobre caché, inspecciona una cita hasta su página y luego adapta la pregunta y el dominio a tu tarea de documentación.
¿Listo para crear tu asistente de investigación?
Únete a nuestra comunidad para conectar con desarrolladores que construyen flujos de trabajo de investigación y extracción: Discord · Telegram.
Comienza con Scrapeless y usa tu primera ejecución para revisar la evidencia detrás de la respuesta.
Preguntas frecuentes
P: ¿Es este un agente autónomo de LangChain?
No. Este ejemplo llama a tres herramientas de LangChain en una secuencia fija. El script de investigación controla la selección de fuentes y el orden del trabajo.
P: ¿Este ejemplo requiere una clave de API de OpenAI separada?
No. El ejemplo genera su respuesta mediante Scrapeless ChatGPT Scraper y utiliza una clave de Scrapeless. Otras aplicaciones que conecten estas herramientas a un modelo alojado por separado pueden necesitar las credenciales de ese proveedor de modelo.
P: ¿Se puede instalar el paquete desde PyPI?
Sí. Este tutorial instala langchain-scrapeless==0.1.4. Conserva también la copia del código fuente porque el script de investigación y las funciones auxiliares son ejemplos del repositorio.
P: ¿Las URL de fuente explícitas omiten la Búsqueda de Google?
No. La solicitud de búsqueda aún se ejecuta y sus candidatos se guardan. Las URL explícitas determinan el conjunto de colección y se marcan como fuentes proporcionadas.
P: ¿El asistente necesita embeddings o una base de datos vectorial?
No. Este ejemplo selecciona pasajes de un pequeño conjunto de páginas usando términos de la pregunta y el contexto circundante. No implementa un índice de búsqueda semántica persistente.
P: ¿Los ID de cita válidos garantizan una respuesta correcta?
No. Los ID válidos establecen que las citas apuntan a fuentes conocidas. Revisa si los pasajes citados respaldan las afirmaciones asociadas y si se omitieron condiciones importantes.
P: ¿La inicialización local verifica el acceso al servicio?
No. El comando de verificación construye herramientas localmente. La búsqueda en vivo, la recopilación y la generación requieren credenciales válidas, acceso a una cuenta compatible y créditos disponibles.
En Scrapeless, solo accedemos a datos disponibles públicamente y cumplimos estrictamente con las leyes, regulaciones y políticas de privacidad del sitio web aplicables. El contenido de este blog es sólo para fines de demostración y no implica ninguna actividad ilegal o infractora. No ofrecemos garantías y renunciamos a toda responsabilidad por el uso de la información de este blog o enlaces de terceros. Antes de realizar cualquier actividad de scraping, consulte a su asesor legal y revise los términos de servicio del sitio web de destino u obtenga los permisos necesarios.





