最全面的指南,专为所有网络抓取开发者打造。
提供您的联系方式,我们将迅速联系您,提供产品演示和介绍。我们确保您的信息保密,符合GDPR标准。
构建一个管道,捕获Amazon Rufus对查询集的推荐,提取ASIN和排名,并随着时间的推移对推荐份额进行快照差异分析。
 Michael Lee
用 JavaScript 和 Node.js 进行网络爬虫归结为一个早期的调用——数据是在 HTML 中,还是由 JavaScript 构建的?Cheerio 在解析速度上处理第一种情况;Puppeteer 通过渲染页面来处理第二种。在 Scrapeless Scraping Browser 上运行这两者意味着无论哪种方式抓取都成功,底层有住宅流量和反检测支持。有关更深层次的反机器人工作流,请参阅 Scrapling + Scrapeless 指南;Scraping Browser 产品页面和文档涵盖了完整的 SDK 界面。首先检查原始 HTML,在可能的情况下使用 Cheerio,在必要时使用 Puppeteer,并专注于内容而不是时间。
 Daniel Kim
TikTok 将其数据以重水化的 JSON 大块形式传输,然后通过 XHR 加载其余部分。通过反检测云浏览器同时读取这两者——实时验证的配置文件提取。
 Emily Chen
Qwen 的回答仅存在于 chat.qwen.ai 的一个水合 React 应用中。这个终端优先的操作指南创建了一个云会话,驱动 Qwen Studio,等待流稳定,然后将回答以 JSON 格式读取回来。
Daniel Kim
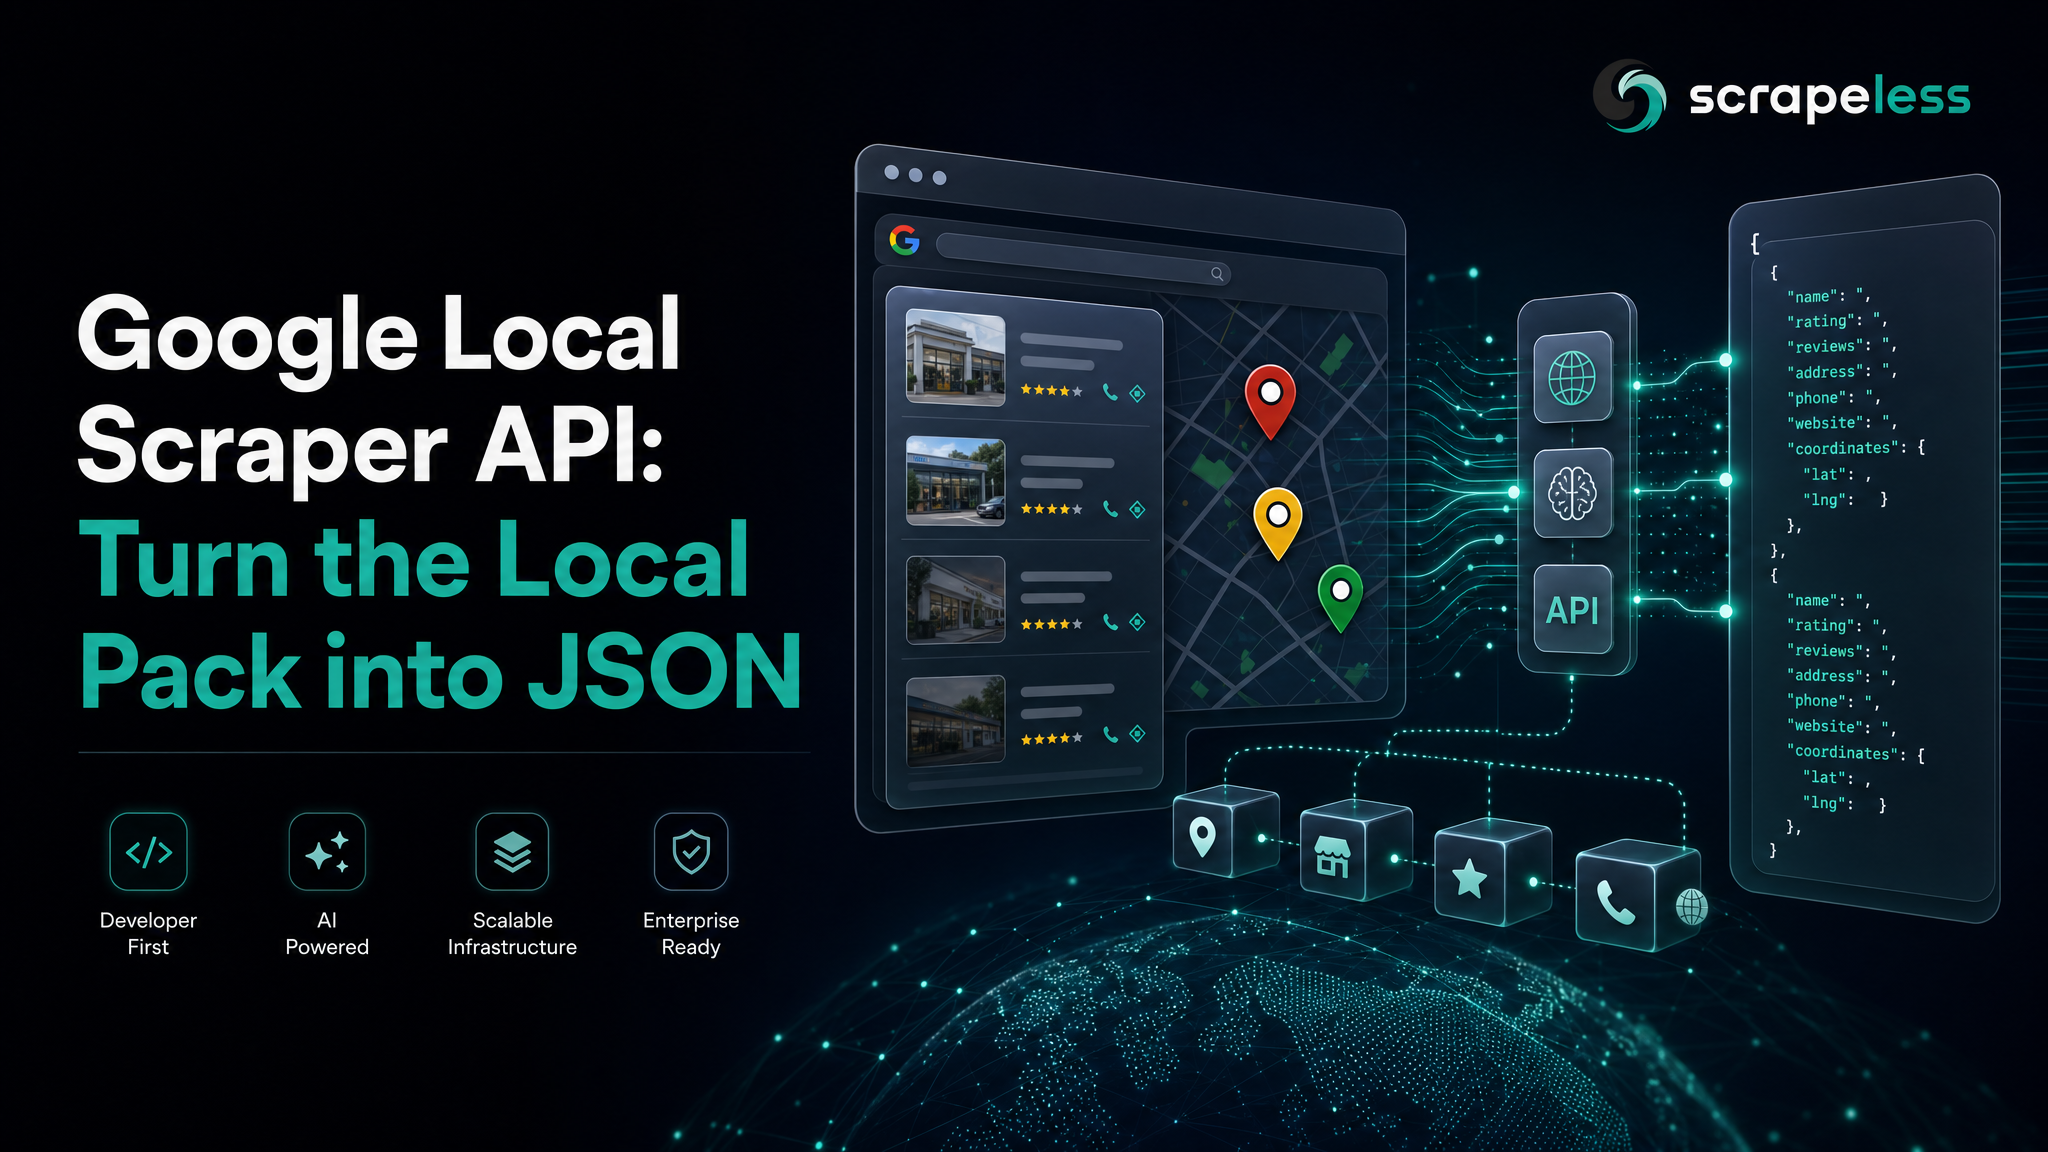
Scrapeless Scraper API 将 Google 本地包转换为针对 scraper.google.search 参与者的单个 POST 请求。发送 tbm: "lcl",您将获得带有地图的商业列表——标题、评分、评论和地址——作为结构化的 JSON。
 Isabella Garcia
Google 图片数据来自单个 POST 请求到 scraper.google.search 角色,带有 tbm: "isch"。Scraper API 在服务器端渲染和解析页面,因此您可以读取结构化的 JSON 数据——无需浏览器,也无需维护解析器。
Emily Chen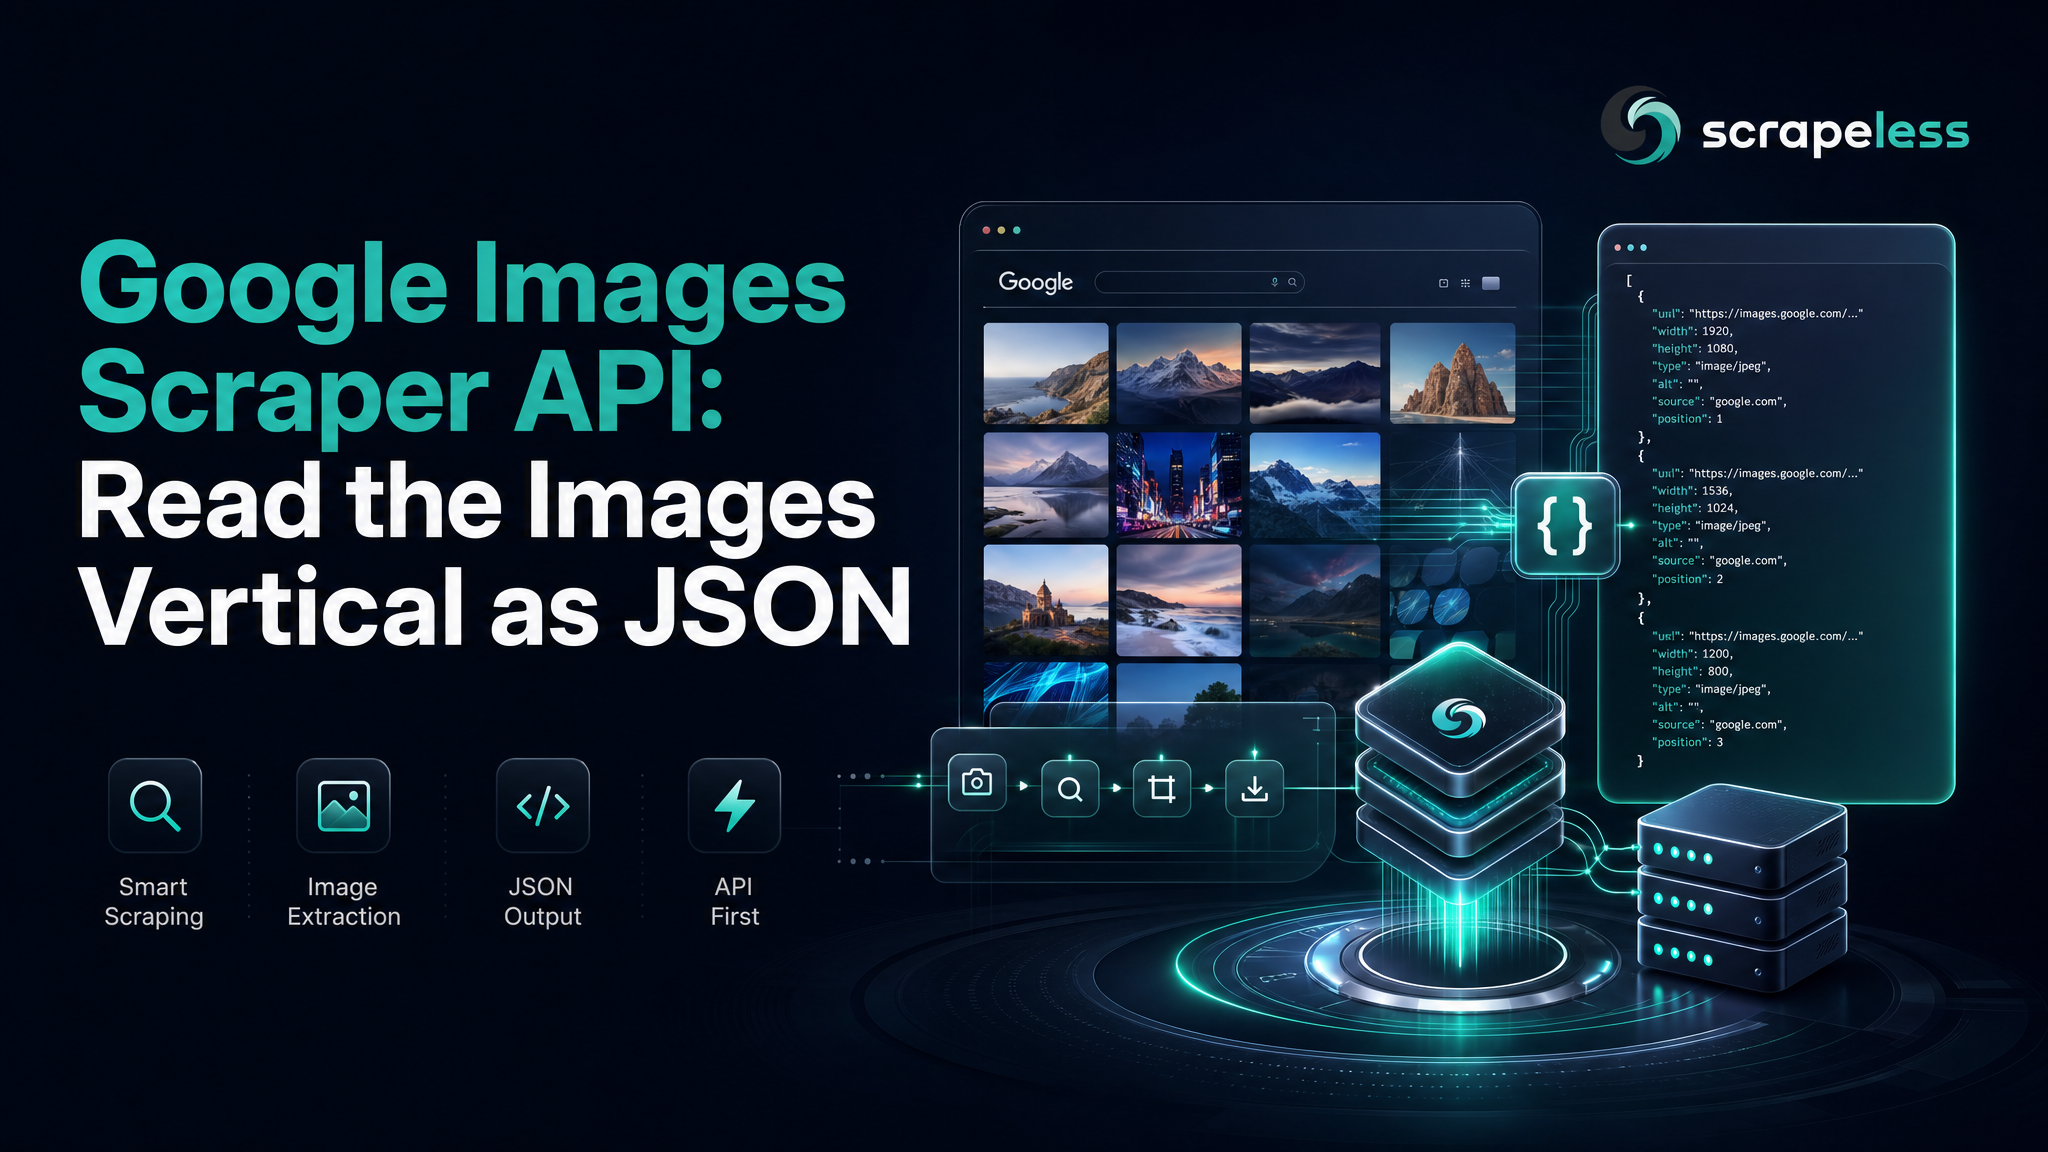
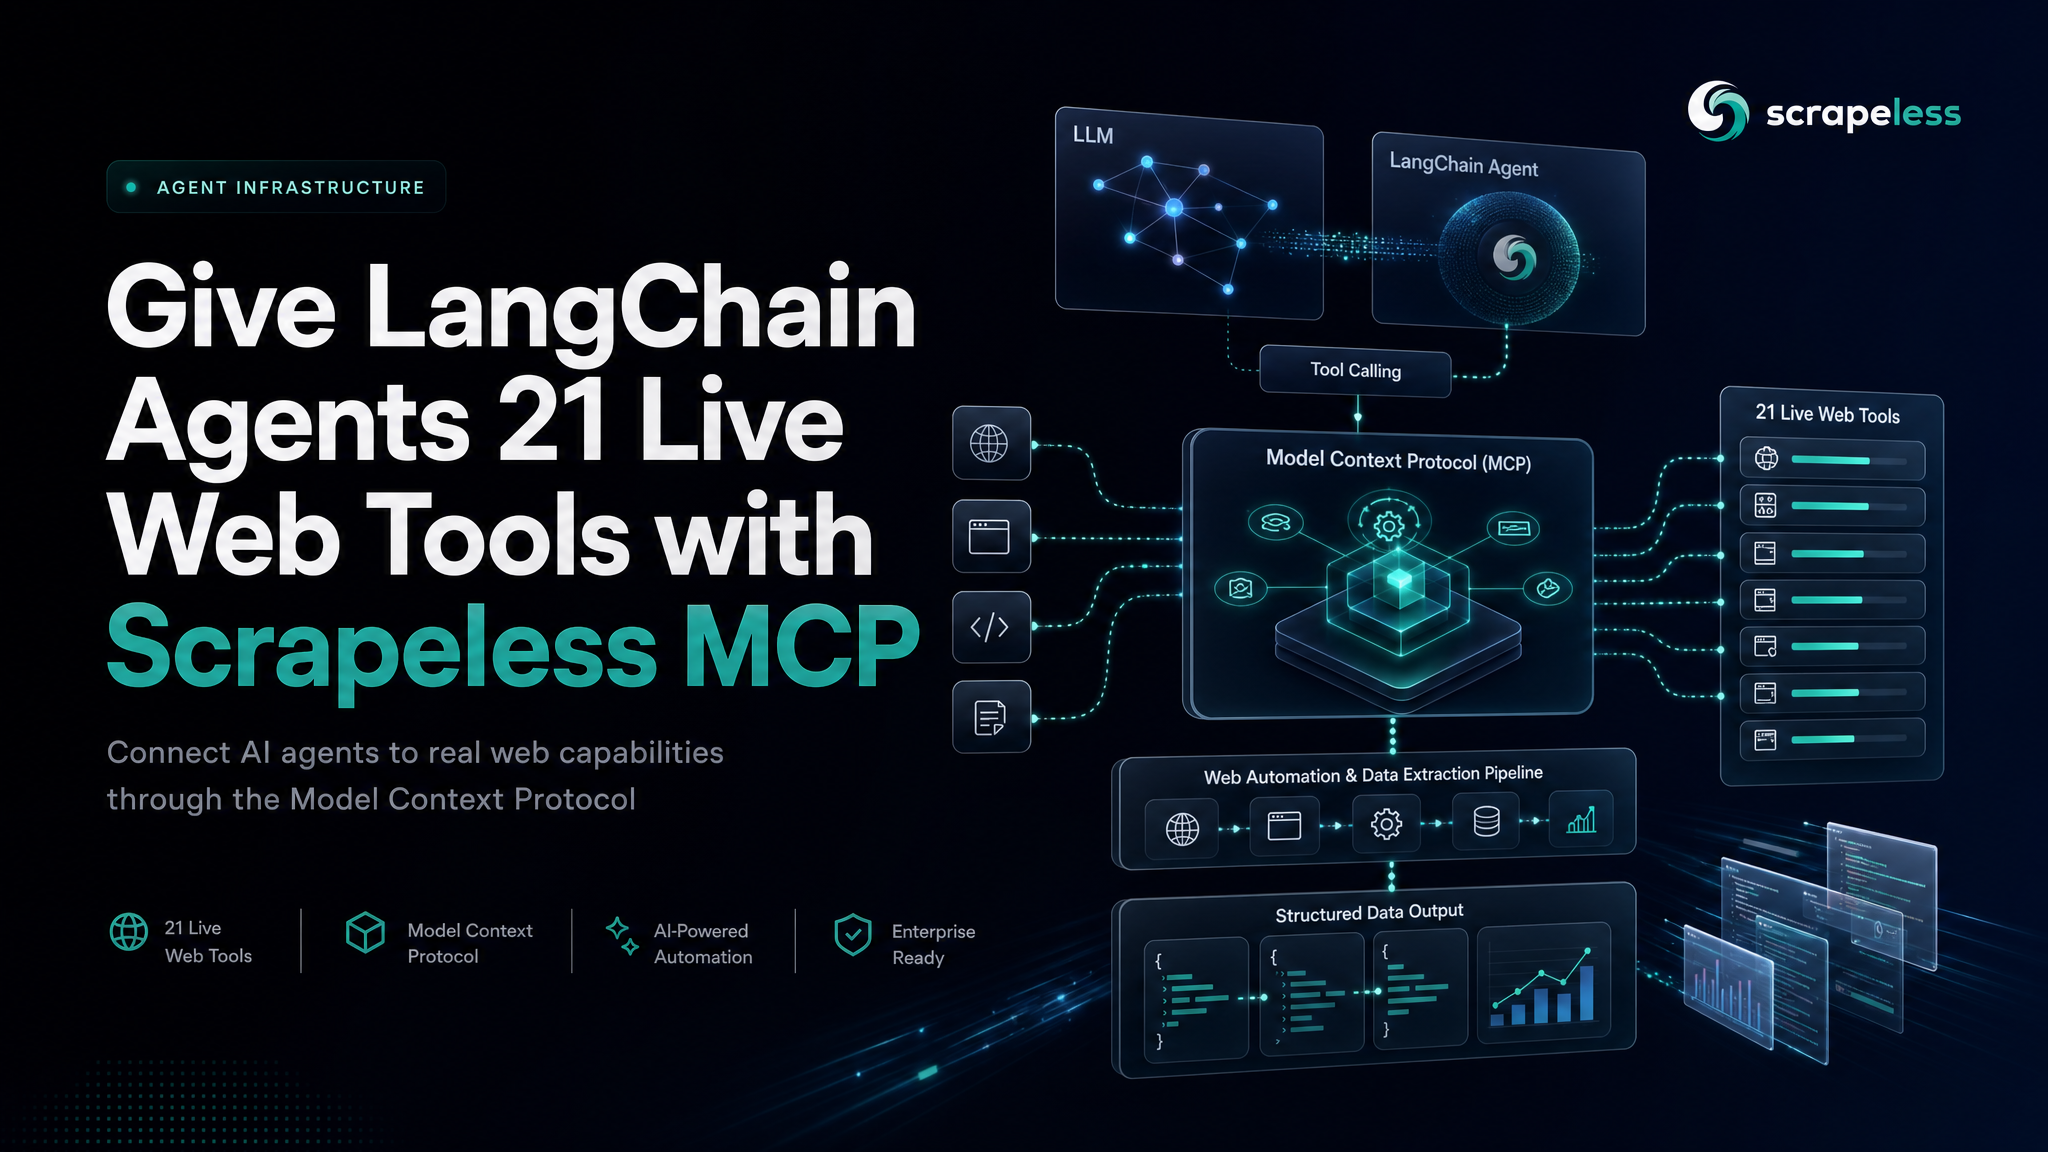
langchain-mcp-adapters 包将 LangChain 应用连接到 Scrapeless MCP 服务器,并返回 21 个准备绑定的网络工具——浏览器控制、页面抓取、Google 搜索和趋势——在涉及任何模型之前可以进行测试。
 Ava Wilson
检索答案的质量仅取决于您索引的文本。该流程通过网页解锁器获取完全渲染的HTML,减去页面装饰,并通过重叠和来源对文本进行分块——生成一个干净的语料库,随时可以用于任何嵌入模型。
Isabella Garcia