
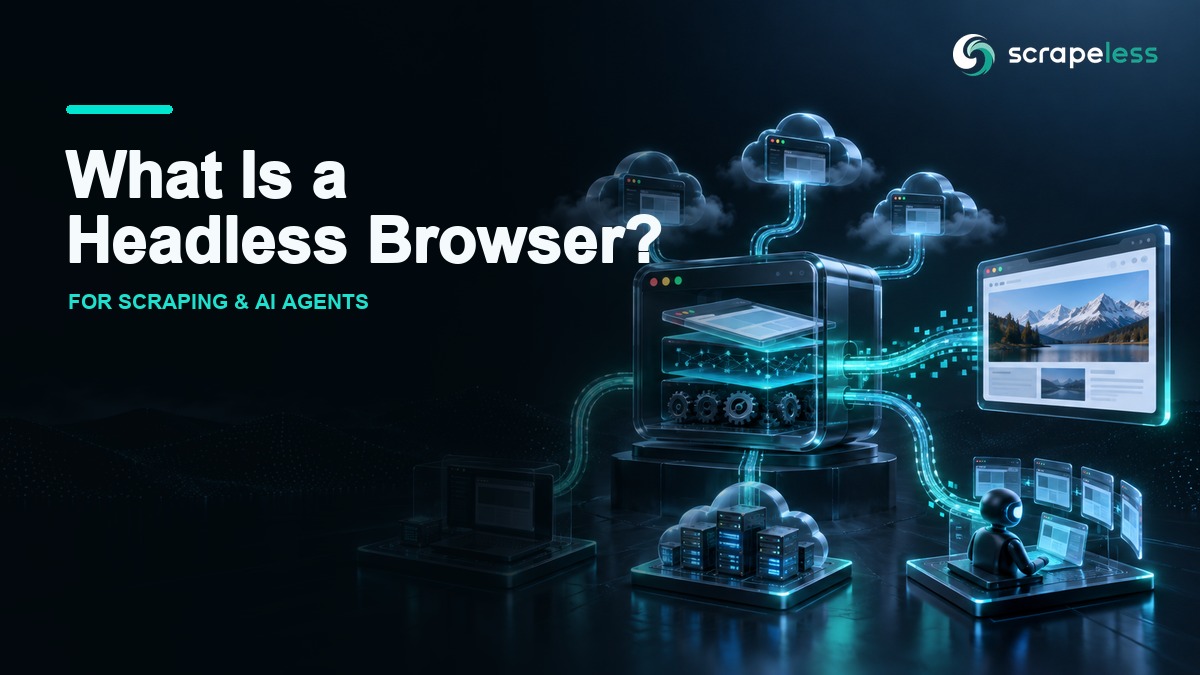
什么是无头浏览器?它如何用于抓取和人工智能代理
Expert in Web Scraping Technologies
TL;DR:
- 无头浏览器是一个没有可见窗口的完整浏览器引擎。 它仍然解析HTML,应用CSS,执行JavaScript,创建DOM,存储cookie,并进行网络请求。
- 无头和有头描述显示模式,而不是自动化能力。 Puppeteer,Playwright,WebDriver和CDP可以控制任一模式,只要浏览器支持它。
- 本地无头最适合开发和CI;托管的云浏览器增加了隔离、路由、扩展性和可观察性。 适当的层取决于操作需求,而不是窗口是否可见。
- AI代理需要状态和证据,而不仅仅是渲染器。 长任务从持久会话、受控网络身份、屏幕截图、控制台日志和重放中受益。
- 有头调试应保留在工作流程中。 可见的浏览器仍然是检查布局、同意提示和交互时机的最清晰方式,然后再将作业移交给无人值守的执行。
什么是无头浏览器?
无头浏览器是一个加载和呈现网页内容的浏览器引擎,而不显示图形用户界面。
“无头”并不意味着“仅限HTML”。现代无头浏览器执行JavaScript,应用CSS,构建DOM,加载子资源,管理cookie和存储,并暴露自动化控制。缺失的部分是可见的应用程序窗口。
Chrome的官方无头模式文档解释说,当前的无头Chrome与常规Chrome共享相同的浏览器代码。这个架构点很重要:即使没有窗口绘制到桌面,渲染引擎仍然是真实的。
无头与有头浏览器
无头和有头模式使用相同的广泛浏览器概念,但服务于不同的操作需求。
| 维度 | 无头 | 有头 |
|---|---|---|
| 可见窗口 | 否 | 是 |
| 服务器和容器使用 | 自然适应 | 需要显示环境 |
| 交互式调试 | 需要日志、痕迹、屏幕截图或远程视图 | 直接视觉检查 |
| CI自动化 | 常见默认 | 对于特定重现很有用 |
| 截图和PDF作业 | 可脚本化和可重复 | 可行,但在大规模时不太方便 |
| GPU或视觉敏感流程 | 必须小心验证 | 更容易检查 |
没有一种模式是自动更具能力的。有头浏览器可以被自动化,无头浏览器可以渲染复杂的客户端应用程序。决策是关于显示、资源管理和调试访问。
无头浏览器是如何控制的
无头浏览器通过控制接口而不是通过使用可见工具栏的人来接受命令。
命令行标志
浏览器可以暴露标志以执行一次性任务,例如打印DOM、拍摄屏幕截图或保存PDF。这对于诊断和小构建步骤很有用,但提供的工作流程控制不如自动化库。
自动化库
Puppeteer和Playwright提供高层次的API用于导航、选择器、事件、下载、网络拦截和浏览器上下文。Selenium客户端在多种语言和浏览器系列中使用WebDriver兼容的浏览器驱动。
浏览器协议
协议在客户端和浏览器之间传递命令。Chrome DevTools协议暴露了Chromium调试和自动化领域。W3C WebDriver规范定义了一个为浏览器互操作性设计的远程控制接口。
协议与库并不相同。Playwright或Puppeteer提供开发人员的人体工程学;CDP提供更低层的传输和命令模型。
常见无头浏览器用例
无头浏览器在工作流程需要浏览器行为但不需要本地窗口时非常有价值。
- 自动化测试。 在CI中执行用户流、断言、表单和导航。
- 网络数据提取。 渲染JavaScript,揭示懒加载的公共内容,并读取结果DOM或网络响应。
- AI浏览器代理。 让代理检查页面,决定行动,并从相同的会话状态继续。
- 截图和PDF。 从已知视口和打印设置中生成可重复的视觉捕捉。
- 性能和诊断。 在受控运行中收集网络、控制台、计时和页面状态证据。
- 定期监控。 检查公共可用性、内容变化或本地化体验,而无需保持桌面打开。
这些用例共享一个要求:浏览器需要明确的生命周期管理。脚本或平台必须创建浏览器,打开页面,等待有意义的页面状态,捕获证据并关闭会话。
三层模型:本地、云和代理
无头自动化在分为三个层次时更容易理解。
层 1:本地无头浏览器
本地无头模式在开发者机器、CI 工作者、容器或虚拟机上运行。它使团队能直接控制浏览器版本、操作系统、依赖项和文件系统。
在单元大小的流、测试开发、确定性的内部应用以及基础设施所有权可接受的情况下使用本地无头。
层 2:托管云浏览器
托管云浏览器将浏览器进程、隔离、网络路由和生命周期操作移入服务中。客户端远程连接并保持其熟悉的自动化 API。
当浏览器队列、代理路由、地理访问、会话隔离、并发控制或集中可观察性成为单独的平台项目时,使用托管层。
层 3:代理浏览器
代理浏览器向托管浏览器层添加长期任务状态和面向代理的控制。浏览器成为代理可以调用、观察并在多个决策中持续使用的工具。
代理仍然需要边界:允许的域、许可的操作、人类审批点、秘密处理和输出验证。浏览器控制并不意味着代理的结论是正确的。
使用 Scrapeless 开始抓取
通过 Scrapeless 提升您的网络抓取和自动化工作流程!
今天注册并获得 $5 的免费信用 — 无需信用卡。立即在 Scrapeless 控制面板 领取您的免费信用。
为什么本地无头浏览器变得具有操作性
本地浏览器以一个进程开始,当工作负载增加时变成一个系统。
团队必须对齐浏览器和库版本、打包系统依赖项、保持容器健康、限制内存和 CPU 使用、隔离配置文件、收集日志、公开截图、路由流量并清理被遗弃的进程。那些任务都不会改变选择器或提取逻辑,但每一项都影响任务是否能可预测地完成。
浏览器进程也有状态。Cookies、缓存、服务工作者、存储、权限、下载和扩展可以在上下文被不小心重用时跨任务边界。WHATWG 浏览上下文模型 描述了文档、历史和顶层浏览上下文如何在浏览器内部相关。
这就是为什么“运行更多无头浏览器”不是一个完整的扩展计划。生产设计需要隔离、入场控制、可观察性和明确的会话生命周期。
Scrapeless 代理浏览器的适用位置
Scrapeless 代理浏览器 是一个用于抓取和 AI 代理工作流程的托管浏览器层。它为 Puppeteer 和 Playwright 提供标准的 CDP WebSocket 端点,并在连接 URL 上具有代理路由和会话设置。
前提条件:实时连接需要在
SCRAPELESS_API_KEY中输入 Scrapeless API 密钥。
javascript
import { chromium } from "playwright-core";

const token = process.env.SCRAPELESS_API_KEY;
if (!token) throw new Error("SCRAPELESS_API_KEY is required");

const endpoint = new URL("wss://browser.scrapeless.com/api/v2/browser");
endpoint.searchParams.set("token", token);
endpoint.searchParams.set("sessionTTL", "180");
endpoint.searchParams.set("proxyCountry", "US");

const browser = await chromium.connectOverCDP(endpoint.toString());
const context = browser.contexts()[0];
const page = context.pages()[0] ?? (await context.newPage());
await page.goto("https://example.com", { waitUntil: "domcontentloaded" });
console.log({ title: await page.title(), url: page.url() });
await browser.close();
该代码将本地浏览器启动替换为 CDP 连接。导航和提取 API 保持熟悉,而浏览器进程和配置的出口则在远程运行。
无头浏览器的局限性
无头浏览器解决了渲染和交互。它并没有解决数据的正确性、授权或工作流程设计。
调试不够直接
没有可见窗口时,日志和工件成为证据。捕获控制台消息、失败请求、截图、DOM 快照和最终 URL。托管的实时视图或重播可以缩短长期流程的诊断时间。
渲染的内容仍然可能不完整
页面可能依赖于登录状态、同意、位置、实验、用户历史或尚未发生的操作。“DOM 加载”只是一个里程碑。等待特定域的元素或响应以证明所需内容存在。
自动化可能被检测到
网站可以评估网络、HTTP、运行时和行为信号。无头模式只是众多信号中的一种。将身份视为连贯的会话,而不是单独的标志。
资源使用是有实质性的
每个浏览器会话都会消耗内存、CPU、文件描述符和网络容量。设置明确的并发限制并隔离不受信任的页面。
视觉保真度需要测试
字体、GPU 行为、视口、媒体仿真和打印设置可能会改变捕捉效果。根据参考图像验证视觉工作流程,并保持头部检查可用。
何时使用头部调试
当下一步操作依赖于人能看到的内容时,头部模式是正确的诊断工具。
保持头部路径以:
- 构建和收紧选择器;
- 理解同意或身份验证流程;
- 检查拖动、悬停、聚焦和键盘行为;
- 验证像素敏感的截图;
- 在打开开发者工具的情况下重现问题;
- 确认自动化状态与用户可见状态相匹配。
一旦理解了行为,就将稳定路径转移到无头执行,并保留截图、痕迹和日志作为证据。
决策表
| 需求 | 本地无头 | 托管云浏览器 | 代理浏览器 |
|---|---|---|---|
| 快速本地开发 | 最佳选择 | 可选 | 可选 |
| 标准 CI 测试 | 最佳选择 | 大规模时有用 | 很少需要 |
| 地理路由 | 手动基础设施 | 为此构建 | 为此构建 |
| 多个隔离会话 | 操作负担 | 最佳选择 | 最佳选择 |
| 长期多步骤任务 | 自定义状态处理 | 依赖于会话 | 最佳选择 |
| 中央日志和重放 | 自定义工具 | 常用功能 | 核心操作需求 |
| 自然语言工具调用 | 添加代理层 | 添加代理层 | 本地用例 |
选择满足任务的最小层。当地团队控制环境时,本地无头浏览器非常出色。当基础设施成为瓶颈时,托管浏览器是有价值的。当推理系统必须拥有持久的、可观察的浏览器会话时,代理浏览器非常有用。
结论
无头浏览器是一种没有可见窗口的浏览器,而不是一种简化的渲染器。重要的设计选择是它运行的位置以及谁拥有其状态、网络路由、隔离和证据。
请使用代理浏览器文档查看当前连接合同,在定价页面上比较帐户选项,并查看提示驱动集成如何在Hermes 和 Scrapeless 指南中使用相同的浏览器层。
准备构建可观察的浏览器自动化?
加入 Scrapeless 社区讨论浏览器生命周期、CDP 连接和代理会话设计:Discord · Telegram。
在 app.scrapeless.com 注册,并将现有的 Puppeteer 或 Playwright 工作流连接到代理浏览器。
常见问题解答
问:无头浏览器是真正的浏览器吗?
是的。现代无头浏览器使用真实的浏览器引擎来解析 HTML、应用 CSS、执行 JavaScript、渲染页面,并管理浏览器状态,而不显示桌面窗口。
问:无头模式比有头模式快吗?
无头模式可以减少显示开销,但性能取决于页面、浏览器构建、硬件、标志和工作负载。应测量确切流程,而不是假设统一百分比。
问:网站能检测无头浏览器吗?
网站可以分析网络、HTTP、运行时和行为层面上的许多信号。无头模式可能有助于检测,但这并不是唯一的信号。
问:网页抓取应该使用无头模式还是有头模式?
使用有头模式来构建和调试流程,然后在选择器、等待、状态和输出检查稳定后,使用无头模式进行无人值守执行。
问:云浏览器和无头浏览器有什么区别?
无头描述的是显示模式。云浏览器描述的是浏览器运行的位置以及谁管理过程、隔离、网络和操作工具。
问:代理浏览器可以在没有 AI 代理的情况下运行吗?
可以。Puppeteer 或 Playwright 可以直接通过 CDP 连接并使用普通应用代码控制会话。
在Scrapeless,我们仅访问公开可用的数据,并严格遵循适用的法律、法规和网站隐私政策。本博客中的内容仅供演示之用,不涉及任何非法或侵权活动。我们对使用本博客或第三方链接中的信息不做任何保证,并免除所有责任。在进行任何抓取活动之前,请咨询您的法律顾问,并审查目标网站的服务条款或获取必要的许可。





