
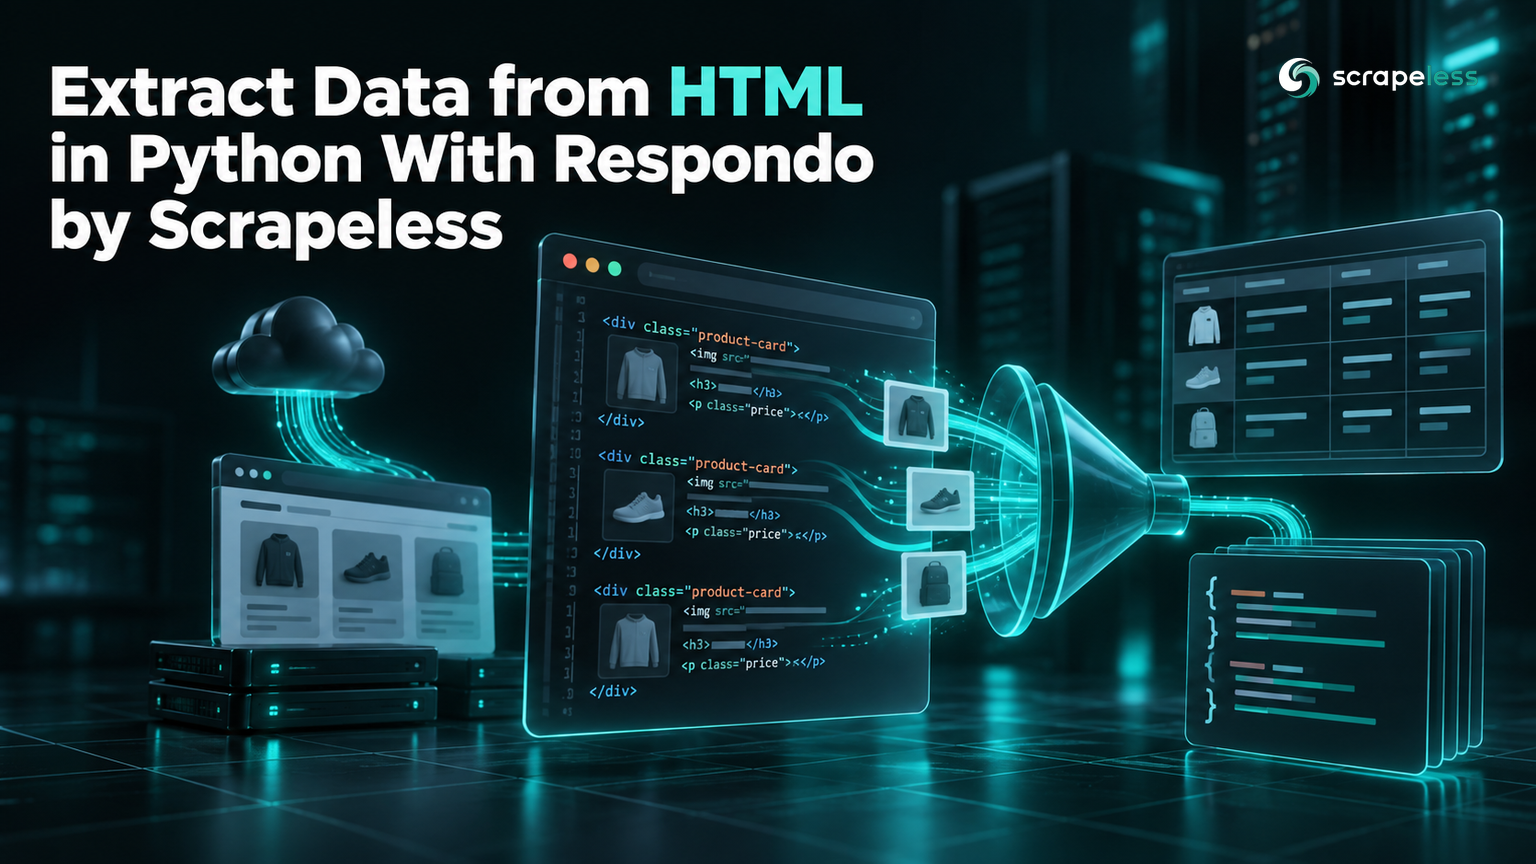
使用Scrapeless的Respondo在Python中提取HTML数据
Expert in Web Scraping Technologies
TL;DR:
- Respondo 是 Scrapeless 的开源 Python 库,用于将 HTML 和 JSON 转换为记录。 它可以在您已有的页面和 API 响应上工作,并且没有运行时依赖。
- 从 GitHub 安装版本 0.6。 PyPI 上的
respondo包仍然是 0.4.0,早于字段配方、JSON Lines 帮助程序和批处理模式。 - 字段配方将每列映射到选择器。 配方可以读取属性而不是文本,并且可以与您的代码一起存储在 JSON 文件中。
- CSV 输出默认是电子表格安全的。 以类似公式开头的值会加上撇号前缀,数字保持为数值型。
- Respondo 不会获取或渲染页面。 Scrapeless Universal Scraping API 收集 HTML,Respondo 将其转换为行。
- 在 Scrapeless 免费计划 上尝试收集步骤,并在几分钟内提取您的第一页。
要在 Python 中从 HTML 中提取数据,您需要两个东西:HTML 本身,以及将标签转换为您可以使用的字段的代码。第二部分往往会发展成每个站点不同的一次性循环和 CSV 代码。
Respondo 打包了第二部分。您只需描述每个字段一次,作为选择器加上可选属性,Respondo 会返回一个字典列表,您可以从 Python 或命令行将其写入 CSV 或 JSON Lines。本指南从一个公共实践网站构建了一个小型图书目录,然后将 Respondo 与 Scrapeless 配对以进行收集步骤。
Respondo 是什么
Respondo 是一个本地提取工具包,在 Scrapeless GitHub 组织下维护,并根据 MIT 许可发布。它的 GitHub 上的源代码库 一句话描述了这个分裂:使用 Scrapeless 收集,然后用 Respondo 提取、转换和导出。
该库可以处理您已有的内容。它的 HTML 函数建立在标准库的 html.parser 模块 基础上,因此已安装的环境除了 Respondo 本身外没有其他依赖。版本 0.6 涵盖四种工作:
- 从 HTML 中提取重复记录,使用 CSS 风格的选择器和可重用的字段配方;
- 查询、扁平化、投影和合并 JSON 文档的补丁;
- 页面摘要、订阅源和站点地图;
- 带有 21 种模式的
respondo命令,包括对整个文件夹的批处理。
Respondo 不会获取 URL 或启动浏览器,并且不包含 Scrapeless API 客户端。如果您仍在决定解析涉及什么,我们对 数据解析是什么 的概述涵盖了这些概念。
安装 Respondo 0.6
直接从 GitHub 安装 Respondo,固定到一个提交。它需要 Python 3.9 或更高版本:
bash
python -m pip install "git+https://github.com/scrapeless-ai/respondo@be376d112ecf681011a079e809acae46b7e1ff59"
respondo --version
text
respondo 0.6.0提交固定让您的环境保持在此指南测试所用的确切代码上。一个普通的 pip install respondo 安装自 PyPI 的 0.4.0 版本,而下面使用的函数则不在其中。安装后,pip list 仅显示 respondo 和 pip。
定义字段配方
字段配方是一个字典,将每个输出列映射到在一个重复项内查找它的规则。普通字符串是一个选择器,其文本成为值。字典添加了选项:
selector在当前项内查找元素。attr读取一个属性,如href或title而不是文本。required: True当项没有匹配时引发错误。many: True返回一个列表,而default为缺失值设置默认值。
选择器涵盖标签、类、ID、属性测试、后代和子组合器,以及逗号组。这是 W3C 选择器规范 的一个故意子集:伪类如 :nth-child 和兄弟组合器会被带有 ValueError 的方法拒绝,而不是被忽略。
配方也可以保存在 JSON 文件中,这将选择器与您的代码分开,并让命令行重用它们。将其保存为 book-fields.json:
json
{
  "title": {"selector": "h3 a", "attr": "title", "required": true},
  "price": ".price_color",
  "availability": ".availability",
  "url": {"selector": "h3 a", "attr": "href"}
}
title 字段故意读取链接的 title 属性。实践网站上的可见链接文本经过缩短以适应长名称,而属性则保留完整标题。
提取记录并写入 CSV
extract_records 接受 HTML、一个针对重复项的选择器和配方,并返回每个项目一个字典。这个示例使用从实践网站的神秘类别复制的两个项目:
python
from respondo import extract_records, normalize_url, records_to_csv

PAGE_URL = "https://books.toscrape.com/catalogue/category/books/mystery_3/index.html"
html = """
<article class="product_pod">
  <h3><a href="../../../sharp-objects_997/index.html" title="Sharp Objects">Sharp Objects</a></h3>
  <p class="price_color">£47.82</p>
  <p class="instock availability"><i class="icon-ok"></i> In stock</p>
</article>
<article class="product_pod">
  <h3><a href="../../../in-a-dark-dark-wood_963/index.html" title="In a Dark, Dark Wood">In a Dark, Dark ...</a></h3>
  <p class="price_color">£19.63</p>
  <p class="instock availability"><i class="icon-ok"></i> In stock</p>
</article>
"""

books = extract_records(html, "article.product_pod", {
    "title": {"selector": "h3 a", "attr": "title", "required": True},
    "price": ".price_color",
    "availability": ".availability",
    "url": {"selector": "h3 a", "attr": "href"},
})
for book in books:
    book["url"] = normalize_url(book["url"], base=PAGE_URL)

print(records_to_csv(books), end="")
text
title,price,availability,url
Sharp Objects,£47.82,In stock,https://books.toscrape.com/catalogue/sharp-objects_997/index.html
"In a Dark, Dark Wood",£19.63,In stock,https://books.toscrape.com/catalogue/in-a-dark-dark-wood_963/index.html处理了三个细节。.availability 的文本被修剪掉了,不含图标元素。相对的 href 变成绝对 URL,按照URI 规范的引用解析规则进行解析。而包含逗号的标题在 CSV 中用引号括起来。
records_to_csv 还防止电子表格公式注入,这是OWASP 关于 CSV 注入的条目所描述的风险。以 =、+、-、@、制表符或换行符开头的字符串会在前面加上撇号,因此 =HYPERLINK(1) 被写为 '=HYPERLINK(1),而像 -5 这样的实数保持不变。仅在文件从未到达电子表格时传递 escape_formulas=False。
更进一步:页面摘要、JSON 行和 CLI
记录是一个输出。同一包也总结整个页面并处理 JSON 行,其 respondo 命令从 shell 中运行记录提取,可以应用于一个文件或整个文件夹。
总结整个页面
extract_page 在一次调用中返回文档的标题、文本、元数据、标题、链接、图像和表格。在保存的神秘类别页面副本上运行它:
python
from respondo import extract_page

with open("mystery-page-1.html", encoding="utf-8") as handle:
    page = extract_page(
        handle.read(),
        base="https://books.toscrape.com/catalogue/category/books/mystery_3/index.html",
    )

print(sorted(page))
print(page["headings"][:2])
print(len(page["links"]), "links,", len(page["images"]), "images")
text
['headings', 'images', 'links', 'meta', 'tables', 'text', 'title']
[{'level': 1, 'id': '', 'text': 'Mystery'}, {'level': 3, 'id': '', 'text': 'Sharp Objects'}]
95 links, 20 images
文本、标题和链接跳过脚本、样式和文档头部,相对链接是基于 base 进行解析的。
查询 JSON 行
jsonl_dumps 将记录写为JSON 行,每行一个紧凑对象,iter_jsonl 懒汉读取它们。json_query 然后使用一种总是返回列表的小路径语言提取值:
python
from respondo import iter_jsonl, json_query

with open("mystery-books.jsonl", encoding="utf-8") as handle:
    books = list(iter_jsonl(handle))

print(len(books), "records")
print(json_query(books, "$[*].title")[:3])
print(json_query(books, "[-1].price"))
text
20 records
['Sharp Objects', 'In a Dark, Dark Wood', 'The Past Never Ends']
['£20.89']
路径语法涵盖点键、引号键、负索引和 * 通配符。它没有过滤器或递归降序,而匹配不到任何内容的路径返回一个空列表。
从命令行运行相同配方
respondo 命令读取本地文件,默认写入 JSON,或使用 --format 写入 CSV 和 JSON 行:
bash
respondo records mystery-page-1.html --selector article.product_pod --fields book-fields.json --format csv | head -4
text
title,price,availability,url
Sharp Objects,£47.82,In stock,../../../sharp-objects_997/index.html
"In a Dark, Dark Wood",£19.63,In stock,../../../in-a-dark-dark-wood_963/index.html
The Past Never Ends,£56.50,In stock,../../../the-past-never-ends_942/index.html
在 records 模式下,URLs 保持与页面中出现时完全相同,即使传递了 --base。在需要绝对链接时,通过 normalize_url 在 Python 中解析它们。
处理保存在文件夹中的页面
批处理模式在目录中每个匹配文件上运行一个配方,按文件名顺序,并为每个文件写入一行结果:
bash
respondo records responses/ --batch --pattern '*.html' \
  --selector article.product_pod --fields book-fields.json \
  --format jsonl --output results.jsonl
python -c "import json; [print(row['source'], row['status'], len(row['result'])) for row in map(json.loads, open('results.jsonl'))]"
text
mystery-page-1.html ok 20
mystery-page-2.html ok 12
每行携带 source、status、result 和 error,因此一个无法读取的文件不会阻止其余部分。这两页包含该类别中的所有 32 本书。批处理模式从不覆盖:再次运行相同命令时,停止时 respondo: batch output exists 和退出状态 1,并且输入文件夹中的输出路径被拒绝为不安全。
Respondo 停止的地方:使用 Scrapeless 收集页面
Respondo 解析它所给出的内容,而不更多。它不下载页面或运行 JavaScript,因此其选择器只看到它们接收到的 HTML。在这一步骤中,Scrapeless 通用抓取 API 获取一个 URL 并返回页面,因此这两半保持分开:API 密钥属于收集调用,提取在本地运行。
现在设置这个?Scrapeless 免费计划 覆盖您的第一个请求。
该脚本通过 unlocker.webunlocker 角色收集实时神秘类别页面,然后对其运行相同的配方。它从 SCRAPELESS_API_KEY 环境变量中读取您的密钥:
python
import json
import os
import urllib.request

from respondo import extract_records, jsonl_dumps, normalize_url, records_to_csv

PAGE_URL = "https://books.toscrape.com/catalogue/category/books/mystery_3/index.html"
BOOK_FIELDS = {
    "title": {"selector": "h3 a", "attr": "title", "required": True},
    "price": ".price_color",
    "availability": ".availability",
    "rating": {"selector": "p.star-rating", "attr": "class"},
    "url": {"selector": "h3 a", "attr": "href"},
}


def fetch_html(url):
    payload = {"actor": "unlocker.webunlocker", "input": {"url": url, "method": "GET", "js_render": False}}
    request = urllib.request.Request(
        "https://api.scrapeless.com/api/v2/unlocker/request",
        data=json.dumps(payload).encode(),
        headers={"Content-Type": "application/json", "x-api-token": os.environ["SCRAPELESS_API_KEY"]},
    )
    with urllib.request.urlopen(request, timeout=120) as response:
        body = json.load(response)
    if body.get("code") != 200:
        raise RuntimeError(f"Scrapeless returned code {body.get('code')}")
    return body["data"]


html = fetch_html(PAGE_URL)
books = extract_records(html, "article.product_pod", BOOK_FIELDS)
for book in books:
    book["url"] = normalize_url(book["url"], base=PAGE_URL)
    book["rating"] = book["rating"].split()[-1]

print(len(books), "books")
print(records_to_csv(books[:3]), end="")

with open("mystery-books.jsonl", "w", encoding="utf-8") as handle:
    handle.write(jsonl_dumps(books))
text
20 books
title,price,availability,rating,url
Sharp Objects,£47.82,In stock,Four,https://books.toscrape.com/catalogue/sharp-objects_997/index.html
"In a Dark, Dark Wood",£19.63,In stock,One,https://books.toscrape.com/catalogue/in-a-dark-dark-wood_963/index.html
The Past Never Ends,£56.50,In stock,Four,https://books.toscrape.com/catalogue/the-past-never-ends_942/index.html
API 将页面包装在 JSON 信封中,{"code": 200, "data": "<html>…"},并且 urlopen 在信封被读取之前对 HTTP 失败引发 HTTPError。评级来自 p.star-rating 的类列表,其最后一个类表示星级数量。通用抓取 API 入门指南 列出了其他请求选项,例如代理国家和重定向处理。
故障排除
| 您看到的 | 原因 | 修复 |
|---|---|---|
ValueError: required field has no matches |
一个项目缺少标记为 required 的字段 |
检查选择器与页面的对应关系,或丢弃 required 并使用 default |
ValueError: unsupported selector syntax |
选择器使用了伪类,例如 :nth-child |
改为按类、ID或属性选择 |
ValueError: expected a tag, class, ID or attribute selector |
选择器使用 + 或 ~ |
使用后代或子组合器 |
| 每一行的列都是空的 | 内容在加载后由JavaScript添加 | 请求启用 js_render 的页面 |
| CLI输出中的相对URLs | records 模式保持属性值不变 |
在Python中使用 normalize_url 解决它们 |
| 某些CSV值前的撇号 | 默认情况下公式转义已开启 | 保留它,或传递 escape_formulas=False 以供受信任的消费者使用 |
respondo: batch output exists |
输出文件已经存在 | 选择一个新的文件名 |
respondo: batch unsafe output path |
输出文件在输入文件夹内 | 将结果写入其他地方 |
对于在浏览器中构建内容的页面,使用通用抓取API渲染页面 介绍了选项,而JS 渲染文档 列出了参数。查看定价 以了解渲染请求的费用。
结论
Respondo 将抓取工作的提取部分转化为配置:一个用于重复项的选择器和一个用于其字段的配方。从那里,extract_records 返回字典,records_to_csv 或 jsonl_dumps 转换为文件。respondo 命令在文件夹中运行相同的配方,并报告每个页面的结果。
将两个部分分开。 从GitHub安装0.6,使用通用抓取API收集页面,让Respondo处理返回的内容,而不需要网络连接或其自身的凭据。
准备好给Respondo提供真实页面了吗? 从Scrapeless免费计划开始 并收集你的第一页。
常见问题
问:Respondo是什么?
Respondo 是来自Scrapeless的开源Python库,从你已经拥有的HTML和JSON中提取、转换和导出数据。它没有运行时依赖项,完全在你的机器上运行。
问:如何安装Respondo 0.6?
通过 python -m pip install "git+https://github.com/scrapeless-ai/respondo@be376d112ecf681011a079e809acae46b7e1ff59" 从GitHub安装。PyPI包为0.4.0,缺少本指南中的功能。
问:Respondo能下载网页吗?
不能。Respondo只解析你传递给它的内容。使用Scrapeless通用抓取API或其他HTML来源进行下载步骤。
问:如何使用Respondo在Python中将HTML提取到CSV?
调用 extract_records 并传入HTML、用于重复项的选择器和字段配方,然后将结果传递给 records_to_csv。从shell中,respondo records page.html --selector … --fields recipe.json --format csv 做相同的事情。
问:Respondo支持哪些CSS选择器?
标签、类、ID、属性测试、后代和子组合器,以及逗号组。伪类和兄弟组合器引发 ValueError。
问:为什么我的CSV在某些值前面有撇号?
Respondo 为以 =、 +、 -、 @、制表符或换行符开头的字符串添加前缀,以便电子表格不会将其作为公式处理。数字保持不变,escape_formulas=False 可以关闭前缀。
问:Respondo处理使用JavaScript渲染的页面吗?
Respondo 解析它收到的HTML,并且不运行脚本。使用启用JavaScript渲染的通用抓取API获取这些页面,然后将渲染后的HTML传递给Respondo。
在Scrapeless,我们仅访问公开可用的数据,并严格遵循适用的法律、法规和网站隐私政策。本博客中的内容仅供演示之用,不涉及任何非法或侵权活动。我们对使用本博客或第三方链接中的信息不做任何保证,并免除所有责任。在进行任何抓取活动之前,请咨询您的法律顾问,并审查目标网站的服务条款或获取必要的许可。





