
使用 Python 构建带有 SQLite 和 CSV 报告的 SERP 监控器
Lead Scraping Automation Engineer
摘要:
- Python SERP 监控器会记录某个域名在谷歌自然搜索结果中的最佳位置。 本项目检查首个返回的桌面端结果页,并显式设置地理位置和语言。
- SQLite 保存搜索条件和观测历史。 在多次采集之间保留同一个数据库,以便后续报告可以选择可比较的基线。
- CSV 报告将排名变化与采集问题区分开来。 目标缺失、结果数组为空以及请求失败含义各不相同。
- 已保存的报告版本会保留早期对比结果。 导出操作只读取已存储的报告行,而不会再次发送搜索请求。
- 保留的示例只是一个基线,而不是长期趋势。 三个关键词观测产生了三行报告数据,但没有可比较的历史排名。
- 可免费起步。 在 app.scrapeless.com 注册并使用新手赠送额度试跑一个小型监控清单。
简介:排名离不开它的搜索上下文
谷歌排名观测属于特定的查询、位置、语言、设备和返回结果集。如果记录的位置缺少这些条件,后续对比就很难解释。
本教程围绕 Scrapeless Google Search API 构建一个 Python SERP 监控器。你将配置关键词监控清单和目标域名,采集自然搜索结果,把观测值保存到 SQLite,并导出 CSV 报告。实现只使用 Python 标准库,可在 macOS 或 Linux 上运行。
保留的示例会针对 scrapeless.com 检查 scrapeless、web scraping api 和 google search api。它的首个基线包含一个出现在第 3 位的匹配结果,以及两个在返回结果中没有匹配的关键词。关于底层执行请求模型的更多背景,请参考 Scrapeless Scraper API 使用指南。
流程概览
Python SERP 监控器会将每个已配置查询转化为一个已验证的观测结果,然后存储证据和带版本的报告。
| Stage | Operation | Output |
|---|---|---|
| Collect | 请求首个桌面自然搜索结果页 | 搜索响应或已保存的任务状态 |
| Validate | 检查结构、排名位置和目标链接 | 可用的观测值或数据质量状态 |
| Match | 比较标准化主机名 | 每个目标在返回结果中的最佳位置 |
| Store | 保留请求上下文和观测数据 | data/rankings.sqlite |
| Report | 选择可比较的基线并保存报告行 | 带版本的报告和 CSV 文件 |
示例报告是 output/60c13c8bd553-v1.csv。你的运行 ID、结果数量和输出文件名可能不同。默认监控清单只有一个目标域名,因此它的三个关键词各自贡献一行 CSV 记录。
为什么选择 Scrapeless Google Search API
Scrapeless Google Search API 提供结构化搜索结果,包括自然搜索结果的位置和链接,供监控器验证并存储。
Google Search API 属于 Scraping API 产品系列,可以在请求中指定国家、语言、搜索域以及地理位置。应用程序因此可以专注于域名匹配和历史比较,而不必维护搜索页面的 DOM 解析器。
本项目仅读取 organic_results;不会把广告、地图或 AI 引用合并进自然排名,也不会自动翻页。选择监控清单和采集频率前,请先查看 Scrapeless 定价:collect 会发起服务请求,而 history 与 export 则只对本地记录进行操作。
前提条件
该监控器需要在 macOS 或 Linux 上运行的 Python 3.9 或更新版本、内置的 SQLite 和 HTTPS 支持,以及具备产品权限和额度的 Scrapeless API 密钥。
- 使用终端和纯文本编辑器。电子表格应用便于阅读 CSV。
- 将数据库保存在本地存储上。实现使用 POSIX 文件锁。
- 允许通过 HTTPS 访问项目下载地址、Scrapeless 控制台和 API。
- 实际采集时需提供你自己的 API 密钥。下文展示的历史输出来自原始示例;新的采集会生成各自的结果。
无需第三方 Python 包或单独的数据库服务。Python 通过其 标准库 SQLite 接口 暴露 SQLite。
在下载项目之前先检查运行环境:
bash
python3 --version
python3 -c "import sqlite3, ssl, urllib.request, csv, fcntl; print('Required standard-library modules: OK')"
步骤 1 — 下载并打开项目
Python SERP 监控实现 提供了下文使用的采集器、配置和报告命令。
打开该代码仓库,选择 Code → Download ZIP,并解压归档文件。如果你的环境中访问受限,请使用对该仓库有访问权限的账号。
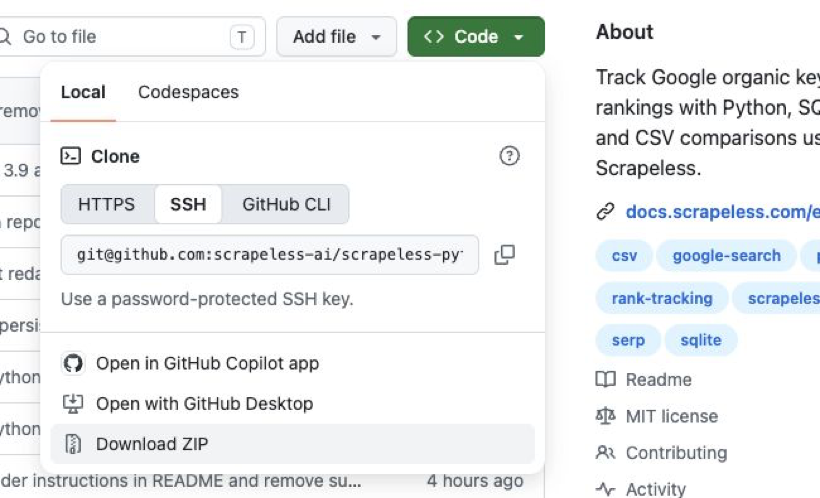
从代码仓库的 Code 菜单下载项目归档文件。
打开解压后的目录,并确认其中存在 serp_monitor.py、tutorial.py、starter.html 和 config.json。
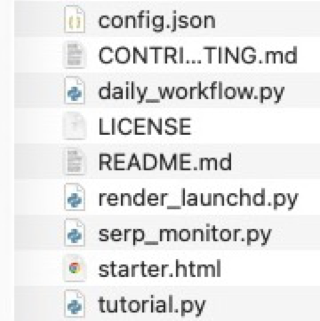
解压后的项目目录。请保留原始文件名。
在 macOS 上,在终端中输入 cd 后跟一个空格,然后将 Finder 中解压后的文件夹拖到终端窗口中并按回车键。从该项目目录中运行后续命令。
bash
python3 serp_monitor.py --help该命令会列出 collect、history、export 和 demo。对于这种下载即运行的方式,Git 和虚拟环境都是可选项。
步骤 2 — 保存密钥并固定搜索范围
API 密钥用于请求认证,而 config.json 定义了之后可被比较的观测结果。
在 Scrapeless 控制台中打开 Settings → API Key Management 并使用一个已有的有效密钥。只有在需要时才创建新密钥。API 密钥管理说明 介绍了账号的设置流程。
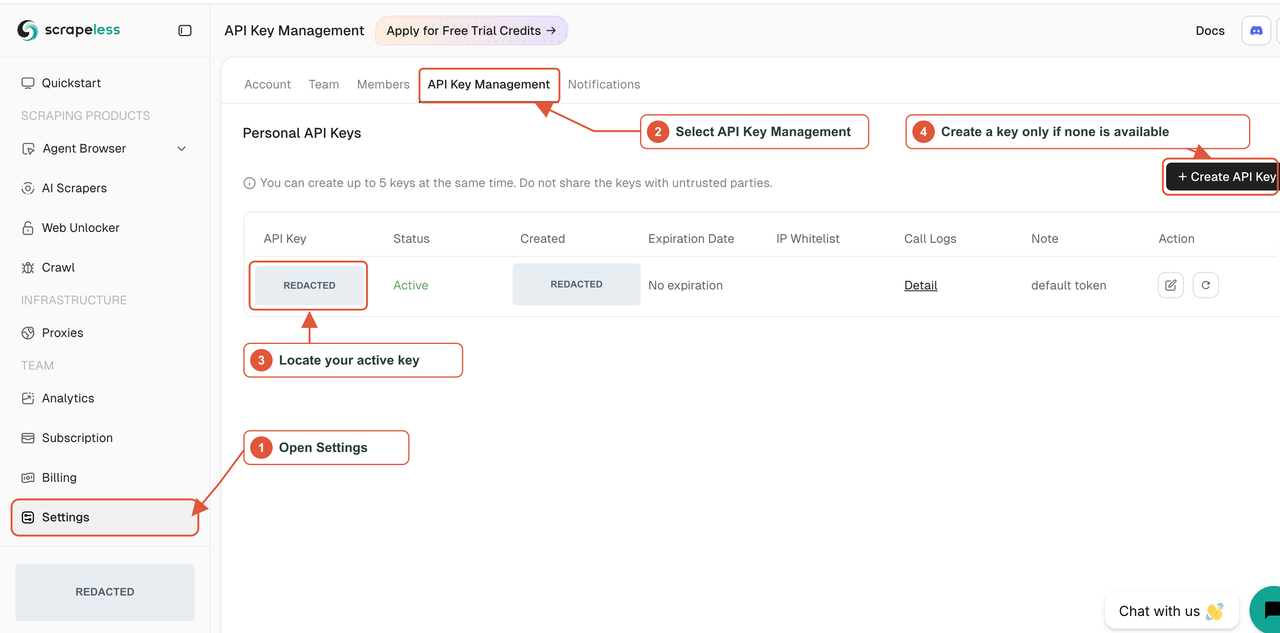
密钥管理的入口。凭据和账号相关的具体值已被隐藏。
在本地创建密钥文件(不要覆盖已存在的文件),收紧其权限,并在 macOS 编辑器中打开它:
bash
cp -n .env.example .env
chmod 600 .env
open -e .env
注意:在本地文件中将占位符替换为你自己的密钥。实时采集需要该凭据以及账号可用额度。
dotenv
SCRAPELESS_API_KEY=YOUR_SCRAPELESS_API_KEY已存在的 SCRAPELESS_API_KEY 环境变量优先于 .env。请妥善保密该文件,不要将其包含在截图或共享的归档文件中。
在纯文本编辑器中打开 config.json,并保留或替换以下监控列表:
json
{
  "keywords": ["scrapeless", "web scraping api", "google search api"],
  "target_domains": ["scrapeless.com"],
  "gl": "us",
  "hl": "en",
  "google_domain": "google.com",
  "location": "Austin, Texas, United States"
}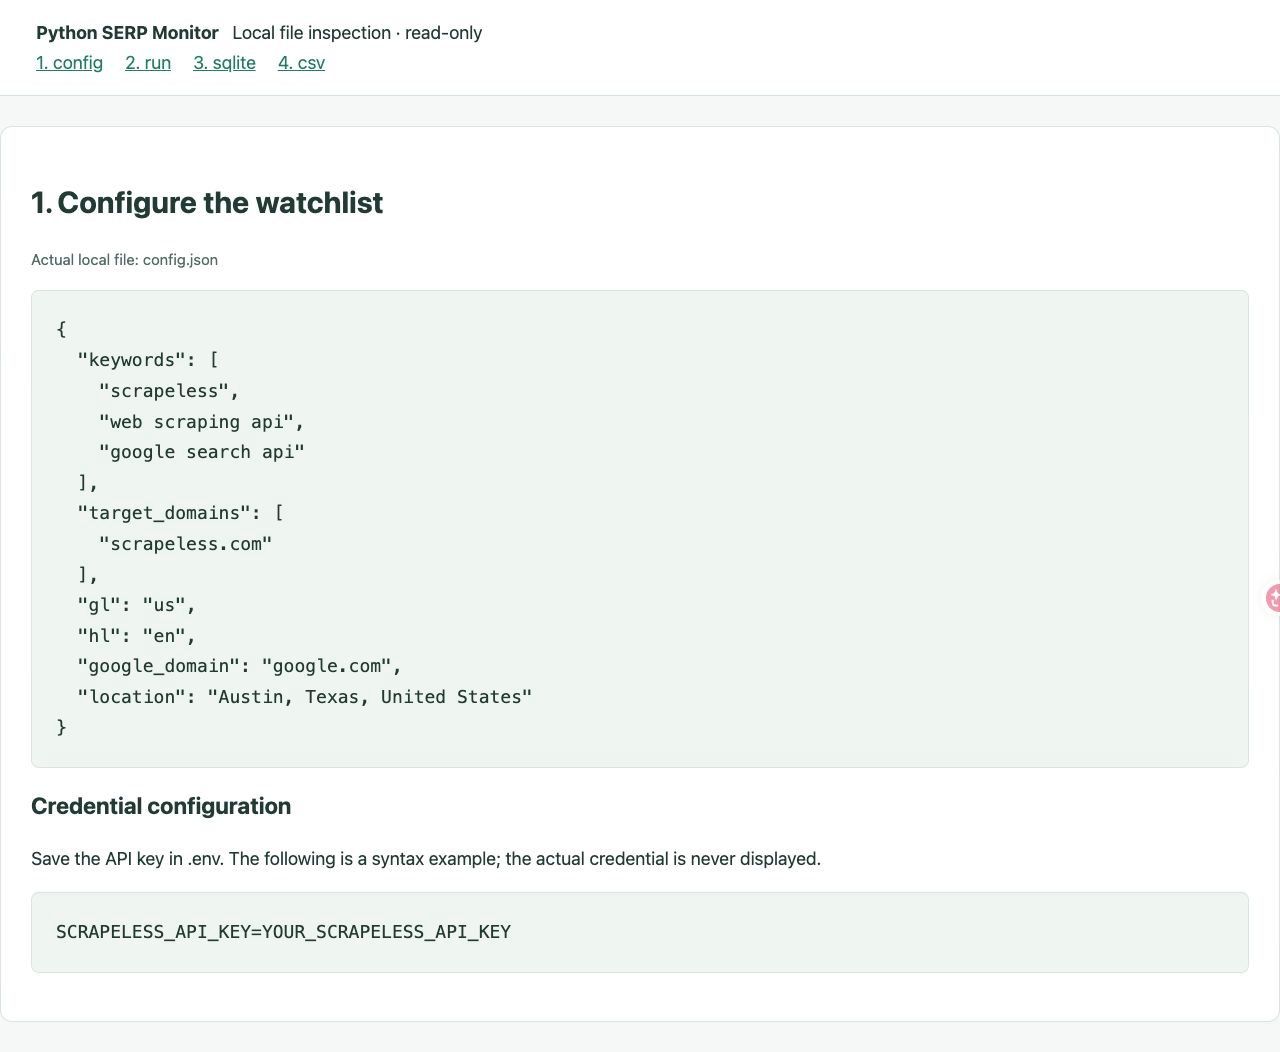
案例配置。凭据区域显示的是占位符而非真实密钥。
target_domains 用于标识要在响应中查找的主机;它不会限制 Google 只返回这些主机。gl、hl、google_domain 和 location 设置搜索的国家、语言、域名和地理位置。该项目将设备固定为 desktop,分页起始位置固定为 0。
保持这些输入一致以便之后的比较。不同的位置或语言意味着不同的搜索范围。
步骤 3 — 采集第一次观测结果
collect 命令会请求已配置的搜索、保存观测结果,并写入报告。
注意:该命令需要你的 Scrapeless API 密钥和额度。它会发送真实搜索请求。之后展示的输出是原始案例保留下来的结果,并不能保证与新一次运行的响应相同。
bash
python3 serp_monitor.py collect --config config.json --env-file .env保留下来的运行产生了如下输出:
text
Run: 60c13c8bd553
scrapeless: 9 organic results saved
web scraping api: 7 organic results saved
google search api: 9 organic results saved
CSV: output/60c13c8bd553-v1.csv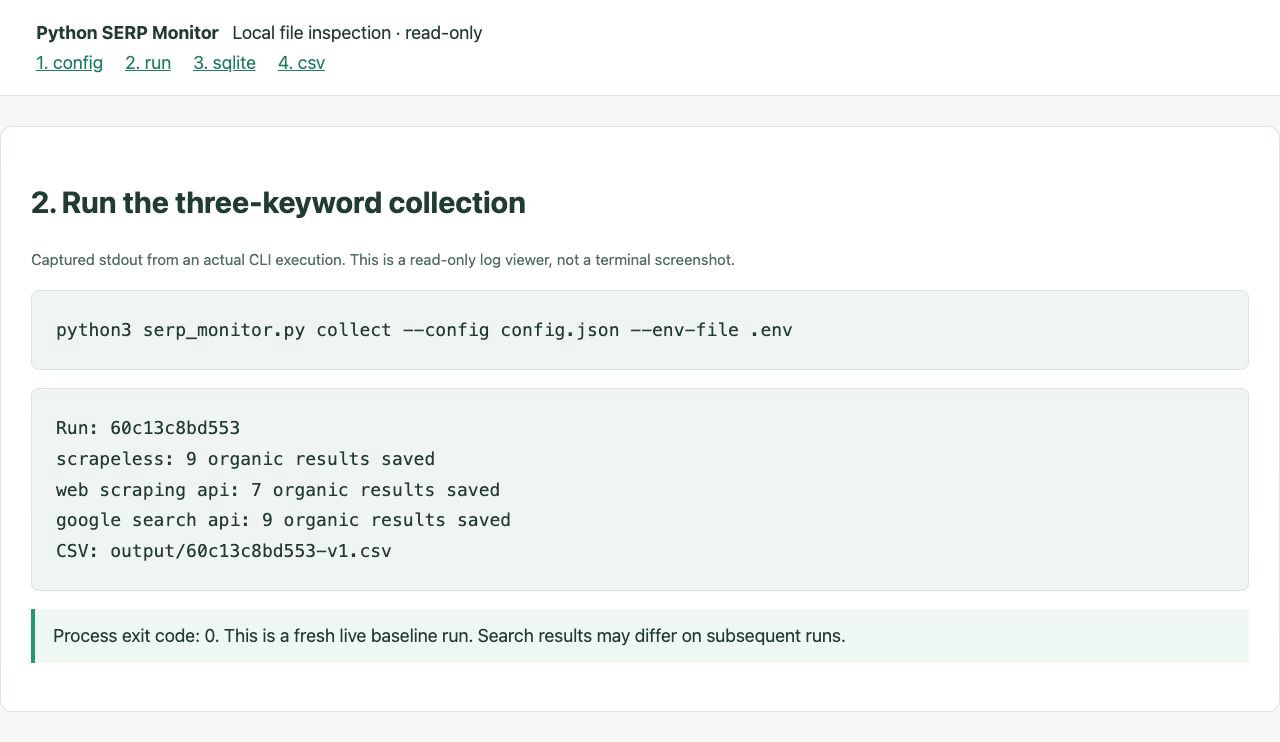
只读日志视图,而不是终端截图。源命令以退出码 0 成功完成。
该次运行将观测结果保存到了 data/rankings.sqlite,并写入了上方显示的 CSV 路径。这些计数描述的是已保存的自然结果数量,而不是目标域名的排名。
步骤 4 — 校验结果并匹配目标主机名
采集器会在将域名匹配(或缺失)视作一次成功观测之前,对返回的自然结果数组进行校验。
理解请求与任务状态
对于第一个关键词,项目会构造如下请求体。它只是一个请求示例,而不是要执行的第二条命令:
json
{
  "actor": "scraper.google.search",
  "input": {
    "q": "scrapeless",
    "gl": "us",
    "hl": "en",
    "google_domain": "google.com",
    "location": "Austin, Texas, United States",
    "start": 0,
    "device": "desktop"
  }
}
项目会将该请求体发送到 POST https://api.scrapeless.com/api/v1/scraper/request,并在 x-api-token 中携带密钥。Google Search API 请求生命周期 区分了 HTTP 200 结果与包含 taskId 的 HTTP 201 响应。
收集器在轮询现有任务之前,会先保存返回的任务 ID。已提交的任务和已完成的观测是不同的状态。如果提交结果不确定且没有保存任务 ID,应用程序会让这种不确定性保持可见,而不是悄悄创建另一次搜索。
仅有 HTTP 响应码并不能证明应用程序收到了可用的排序数据。HTTP 语义规范定义的是协议状态;收集器仍然必须验证响应体。
检查自然结果数组
监控器从 organic_results 中读取 position、link 和 title。它保留返回的 position,而不是用数组索引替换它。
位置必须是不重复的正整数,且链接必须产生有效的 HTTP(S) 目标地址。空的自然结果数组会接收 empty_unverified,并且不会参与排名比较。该状态可防止将未经确认的空响应误解为目标已消失。
某些 Google 结果会使用 /url 或 /goto 包装链接。收集器在可行时会提取明确的目标地址。对于支持但不透明的包装器,它会在受限的 Google 作用域内,通过不带 Scrapeless 密钥的独立请求检查重定向信息;它不会访问最终目标站点。未能解析的链接仍然被视为错误,而不会从一个声称完整的观测中悄悄移除。
使用 Scrapeless 开始抓取
通过 Scrapeless 强化你的网页抓取与自动化工作流!
立即注册即可获得 $5 免费额度 —— 无需信用卡。立刻在 Scrapeless 控制面板 领取你的免费额度。
匹配主机名,而不是 URL 子串
目标域名必须匹配已解析的主机名或其子域之一。使用子串匹配会错误地接受 example.com.other.org 作为 example.com。这种区分遵循 URI 语法规范中的独立 authority 和 path 组件。
将下面内容保存为 match_example.py,放在 serp_monitor.py 旁边。它使用手写的示例输入,不会发出 API 请求。
python
from urllib.parse import urlsplit
from serp_monitor import normalized_domain


def best_match(organic, domain):
    domain = normalized_domain(domain)
    for item in sorted(organic, key=lambda row: row["position"]):
        host = normalized_domain(urlsplit(item["link"]).hostname or "")
        if host == domain or host.endswith("." + domain):
            return item
    return None


organic = [
    {"position": 1, "link": "https://example.com.other.org/page"},
    {"position": 3, "link": "https://www.example.com/page"},
]
match = best_match(organic, "example.com")
print(match["position"] if match else None)
运行本地示例:
bash
python3 match_example.py它会打印 3。第一个主机属于 other.org;第二个主机属于目标域名。如果有多个结果匹配,则返回位置中数值最小的获胜。
如果没有匹配,排名保持为空。空白表示在这组返回结果中未找到该域名,而不是位置为零,也不是证明它在所有 Google 结果中都不存在。
第 5 步 — 检查 SQLite 历史记录
SQLite 会保留用于后续比较所需的请求上下文和已保存的观测,包括那些平面 CSV 无法完整描述的状态。
| Table | Stored information | Purpose |
|---|---|---|
runs |
运行标识、模式、配置、完成状态 | 把一次集合分组 |
snapshots |
关键词、输入、状态、任务详情、结果数据、请求计时 | 保留观测和任务状态 |
report_versions |
已保存的比较行和选定的基线信息 | 让报告版本可复现 |
将下面完整脚本保存为项目目录中的 inspect_history.py。它以只读方式打开数据库,并打印最新实时运行中每个快照的自然结果数量。
注意:此脚本需要已有的采集数据库。它不会提交搜索,也不会创建缺失的数据库。
python
import json
import sqlite3
from pathlib import Path

uri = Path("data/rankings.sqlite").resolve().as_uri() + "?mode=ro"
with sqlite3.connect(uri, uri=True) as db:
    rows = db.execute("""
        SELECT keyword, status, organic_json
        FROM snapshots
        WHERE run_id = (
            SELECT id FROM runs
            WHERE mode = 'live'
            ORDER BY started_at DESC LIMIT 1
        )
        ORDER BY id
    """)
    for keyword, status, organic_json in rows:
        count = len(json.loads(organic_json or "[]"))
        print(keyword, status, count)
在采集完成后运行 python3 inspect_history.py。保留的数据库查询返回:
text
scrapeless success 9
web scraping api success 7
google search api success 9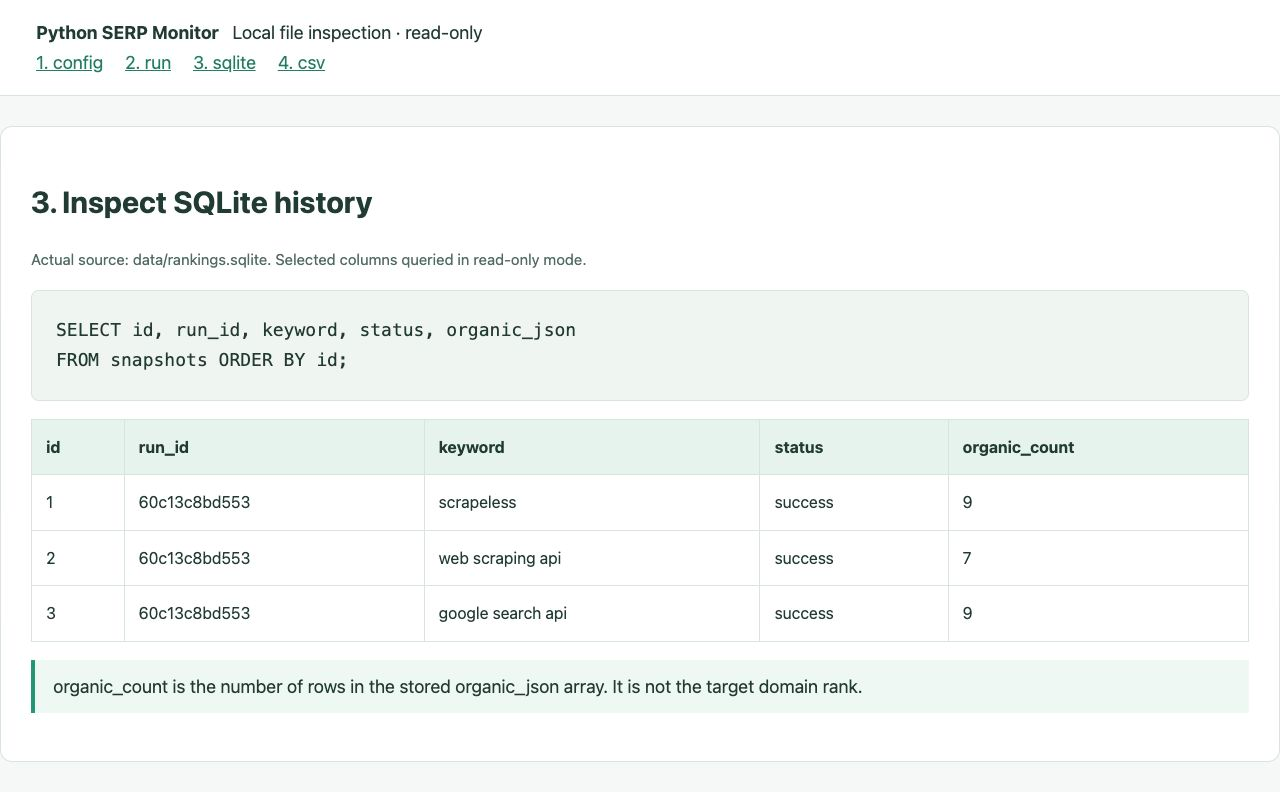
保留数据库中的部分字段。显示的自然结果数量是根据存储的数组计算的。
success 描述的是采集过程。它不同于报告中的 baseline 或 baseline_absent 状态。为后续观测保留同一个数据库;仅有 CSV 无法恢复任务历史。
第 6 步 — 读取并重新导出 CSV
CSV 为每个关键词与目标组合到同一行中,包含目标匹配、结果覆盖范围和比较状态。
在电子表格应用中打开该运行的 CSV。你也可以列出已保存的运行:
注意:本地历史和导出命令需要采集后保留的数据库。它们不会发出任何 API 调用。
bash
python3 serp_monitor.py history --db data/rankings.sqlite
python3 serp_monitor.py export --output output/saved-report.csv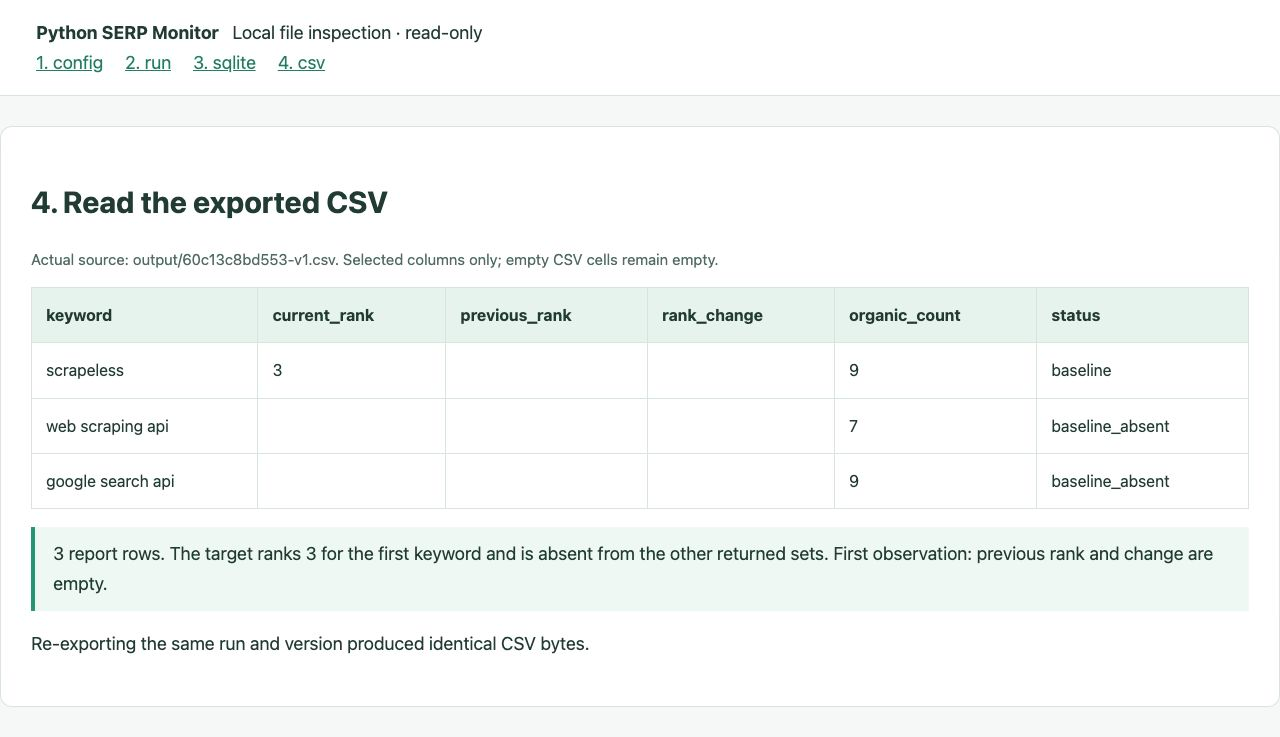
在只读查看器中查看的部分 CSV 列,而不是电子表格应用截图。缺失的排名保持为空白。
保留的第一个基线包含如下结果:
| 关键词 | 当前排名 | 自然结果数 | 报告状态 |
|---|---|---|---|
scrapeless |
3 | 9 | baseline |
web scraping api |
— | 7 | baseline_absent |
google search api |
— | 9 | baseline_absent |
破折号代表空的 CSV 单元格。三条观测都成功了,但只有第一个关键词匹配了目标。不存在之前可比较的观测,因此 previous_rank 和 rank_change 为空。
报告还保留了用于追踪快照、基线、搜索设置和请求计时的字段。CSV 导出使用带字节序标记(BOM)的 UTF-8,并对类似公式的文本单元格进行转义。这个区别在把外部提供的文本导入电子表格时非常重要,如 OWASP 关于 CSV 注入的指南中所述。
在不重写基线的前提下比较后续采集
后续报告只有在存储的观测具有匹配的搜索范围和可靠的排序时,才会计算排名变动。
在下一次观测时,回到同一个项目目录,并保留 .env、config.json 和 data/rankings.sqlite。再次运行步骤 3 中的 collect 命令。这会启动一次新的付费采集;仅仅读取现有报告并不需要这样做。
判断观测是否可比
较早的结果必须在当前请求提交之前收到。仅仅匹配查询设置在请求区间重叠或较旧记录缺乏可靠时间戳时是不够的。
在这些情况下,报告会保留当前排名,但将比较标记为 not_comparable。这些是客户端的提交和接收时间;项目并不声称知道服务提供方的精确采集时间。
当两次可比观测中都包含匹配结果时,计算方式为 rank_change = previous_rank - current_rank。一个示例性变动是从第 5 位升至第 3 位,产生 +2,意味着提升了两个名次。这个算术示例并不是该案例的第二次实时观测。
将“缺失”与“采集质量”区分开来
| 报告状态 | 含义 |
|---|---|
baseline / baseline_absent |
第一次可用的比较基线,不论是否匹配目标 |
up / down / unchanged |
两次可比观测都匹配;排名提升、下降或保持不变 |
new / lost / still_absent |
仅当前有匹配、仅之前有匹配、或两次返回集合都没有匹配 |
pending / error |
当前没有可用的已完成观测 |
empty_unverified |
自然结果数组为空,从排名基线中排除 |
not_comparable |
当前结果有效,但排序不足以支持变动计算 |
lost 仅限于返回的集合。不同观测之间的结果数量可能发生变化,因此在得出结论前,应将覆盖范围与排名位置一起阅读。
导出已保存的报告版本
应用在生成版本时,会将报告行及其选定的基线一并存储。后续观测不会改变已保存在该版本中的行。
注意:将
YOUR_RUN_ID替换为一个已存在的运行 ID。此命令需要其在本地数据库中的已保存版本,并不会发起任何 API 调用。
bash
python3 serp_monitor.py export --run-id YOUR_RUN_ID --version 1 --output output/saved-v1.csv保留案例的第 1 版重新导出产生了完全相同的 CSV 字节。导出会先写入一个临时文件,再替换目标文件。显式选择的输出路径可以被覆盖,而数据库中保存的版本仍然可用。
本地工作流疑难解答
大多数设置问题都可以追溯到当前目录、当前凭据或选定数据库。
| 现象 | 检查内容 |
|---|---|
| 找不到脚本 | 从解压后的项目目录中运行命令 |
| 缺失或无效的密钥 | 替换占位符并检查环境变量优先级 |
| 账户权限或余额不足 | 在控制台检查所选服务和可用额度 |
| 当前排名为空 | 检查目标主机名和返回的自然结果覆盖范围 |
| 出现意外的新基线 | 确认搜索设置和数据库路径与预期历史记录一致 |
empty_unverified |
在解读排名变化前先检查响应质量 |
not_comparable |
检查记录的请求区间和历史时间戳可用性 |
请将密钥文件和原始数据库保持私密。在分享报告或截图之前,移除凭据以及任何私有目标或 URL。
结论:先保存观测,再解读变化
这个 Python SERP 监控工具在一个小型工作流中连接了采集、主机名匹配、SQLite 历史记录和 CSV 报告。保留的示例为三个查询建立了基线;要得出更长期的结论,还需要在可比设置和时序条件下进行更多真实观测。
在需要保持比较可复现性的情况下,保留数据库,在排序状态之前读取采集状态,并使用已保存的报告版本。上述选择使得下一次采集结果可解释。
准备好构建你的搜索监控流水线了吗?
加入在 Discord 或 Telegram 上构建搜索工作流的开发者社区。
在 app.scrapeless.com 注册,从一个小型监控列表开始,并在每次观测中保留搜索上下文。
常见问题解答(FAQ)
问:这个监控应该采集什么数据?
将该监控用于公共自然搜索结果以及你有权分析的目标。在采集或共享数据之前,请根据你的使用场景审阅相关服务条款和要求。
问:监控会跟踪每一个 Google 结果页吗?
不会。该实现通过 start: 0 请求返回的首个桌面端自然搜索结果页。缺失的目标意味着在该返回集合中没有匹配项。
问:是否需要代理或 AI 代理?
该应用不需要单独的代理客户端或 AI 代理。Python 使用账户密钥和配置好的搜索输入调用 Scrapeless Google Search API。
问:如果 Google 更改了页面标记会发生什么?
该监控消费的是结构化 API 结果,而不是直接选择 Google 的 DOM 元素。它仍然会验证响应模式,并记录不可用数据,而不是虚构一个排名。
问:监控如何处理访问错误或不可用的响应?
它将采集问题与目标缺失分开处理。在解释报告之前,请检查凭据、产品访问权限、余额以及记录下来的响应状态。
问:多个采集器可以写入同一个数据库吗?
该应用使用共享数据库锁以防止对同一本地数据库进行重叠采集。请保持采集顺序执行,并使用一致的数据库路径。
问:为什么成功结果会被标记为 not_comparable?
当前结果可以是有效的,但请求排序可能不确定。时间区间重叠或缺失的历史提交时间,会阻止作出有依据的波动计算。
问:导出会消耗 API 额度吗?
不会。export 读取已保存的报告版本,history 读取本地运行记录,collect 执行搜索请求。
问:空白排名是否意味着网站已从 Google 中移除?
不是。空白排名表示在返回的自然搜索集合中没有目标匹配。这并不是对索引状态的完整评估。
在Scrapeless,我们仅访问公开可用的数据,并严格遵循适用的法律、法规和网站隐私政策。本博客中的内容仅供演示之用,不涉及任何非法或侵权活动。我们对使用本博客或第三方链接中的信息不做任何保证,并免除所有责任。在进行任何抓取活动之前,请咨询您的法律顾问,并审查目标网站的服务条款或获取必要的许可。





