
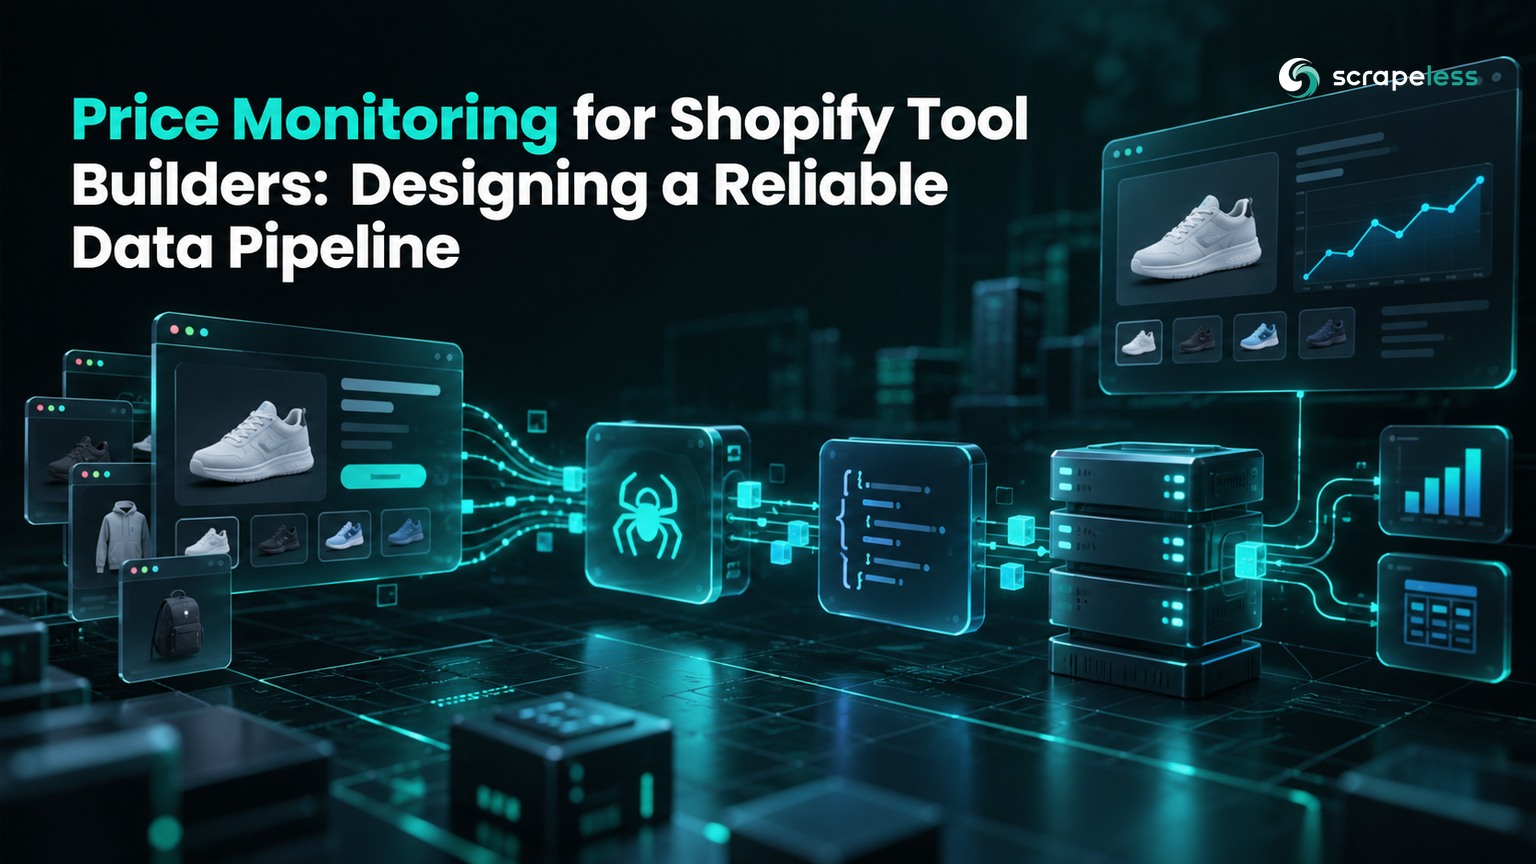
面向 Shopify 工具构建者的价格监控:设计可靠的数据管道
Senior Web Scraping Engineer
摘要:
- 针对 Shopify 应用的价格监控需要“变体级”的历史记录。 每条价格都要保存精确的选项组合、货币、来源 URL 和观察时间。
- 缺失的观察记录不能被当成价格变动。 采集失败必须与已确认的商品下架严格区分。
- 商品匹配需要独立的证据。 门店本地的 SKU 并不能证明两家商家销售的是同一款商品。
- 用于电商价格跟踪的浏览器自动化应属于采集层。 你的应用仍然负责标准化、租户隔离以及告警规则。
- 免费起步。 新 Scrapeless 账号包含免费的 Scraping Browser 运行环境——在 app.scrapeless.com 注册。
引言:价格是对一次报价的观察
一个 Shopify 商品的不同变体可以有不同价格。只记录商品标题和当前最低可见价格的价格监控应用,可能在买家只是切换了一个尺码时就“发现”了一次打折。
有用的单位是:在特定店面上下文下观察到的一次报价。你的流水线必须从采集到告警始终保留这一上下文。否则,货币变化、某个变体不可售或不完整的抽取结果,都可能被误判为商业事件。
本文为 Shopify 工具开发者设计了一条竞品价格监控数据流水线。示例的采集步骤会将公开商品的变体观察结果存入 SQLite;外围架构说明如何将这些观察转化为面向各租户的信号。关于更广义的多零售商采集模式,可参考这篇文章:competitive pricing pipeline。
流水线概览
可靠的价格监控流水线会将“来源采集”和“商业解读”分离。
| 阶段 | 输入 | 输出 | 在以下情况拒绝或暂挂 |
|---|---|---|---|
| 界定范围 | 租户批准的关注列表 | 店铺、商品、变体、市场 | 来源或访问权限不清楚 |
| 采集 | 公开商品 URL 和上下文 | 原始响应和采集时间 | 无法确认商品身份 |
| 标准化 | 商品与变体字段 | 具类型的观察记录 | 货币或价格单位无法确认 |
| 匹配 | 观察记录与商家目录 | 有证据支撑的商品关联 | 选项或包装规格不同 |
| 存储 | 已验证的观察记录 | 不可变历史与最新视图 | 观察记录键已存在 |
| 判定 | 可比的当前与之前报价 | 价格变动事件 | 先前观察记录陈旧或缺失 |
| 投递 | 事件和订阅规则 | 应用通知或看板更新 | 租户未订阅该关注项 |
将“来源状态”和“流水线状态”作为独立字段处理。采集器如果读取页面失败,就什么也没学到——无法判断商品是否仍在售。而一次完整响应若表明某个变体不可用,则获得了明确的信息。
阶段 1 —— 在采集前定义好“关注契约”
“关注契约”明确了租户期望应用监控的是哪一条报价。
其中应包含店面域名、商品 URL、选定的选项组合、目标市场、预期货币以及可接受的数据时效。保留你自己的目录标识,并与竞争对手的标识并存;不要用其中一个替换另一个。
已接入某商家自家店铺的应用,与面向公开竞品监控的应用,其权限边界是不同的。对于商家自有商品,使用其授权的目录访问是合适的;而面对公开竞品时,应停留在公开店面页面上,并遵守店铺的条款和访问控制。
在租户订阅之外维护一个“来源注册表”。多个租户可能关注同一条公开报价,但每条订阅、阈值与投递目的地仍只属于各自租户。只有在你的合约和隐私规则允许的前提下,才共享采集结果。
阶段 2 —— 同步采集公开变体数据与货币信息
采集器必须保留来源中的变体字段,并识别在同一店面上下文下报告的货币。
Shopify 的 支持本地化的产品响应 会暴露商品和变体信息。可访问的端点是很有价值的抽取来源,但这并不保证每个店面都会暴露完整目录或全部报价。
下面的示例会摄取一个浏览器 worker 对 Taylor Stitch 的公开观测。该 worker 在浏览器环境中发现公开产品 URL,读取变体数据和只读购物车响应,并输出一个 JSON 封装。捕获到的封装包含六个变体,并识别出 USD。摄取步骤会将整数价格字段保留为 price_raw,而不是猜测货币换算。这是一个观测示例,而不是对未来品类的承诺。
Prerequisites and Run Instructions
使用带有标准库 SQLite 支持的 Python 和一个可写目录。你获准使用的浏览器采集器必须先用 product_id、source_url、currency、observed_at 以及一个包含 variant_id、options、price_raw、compare_at_price_raw 和 available 的 variants 数组来保存 observation.json。源 SKU 可选。将以下内容保存为 ingest_prices.py,然后在该捕获文件旁运行 python3 ingest_prices.py。不需要第三方 Python 包。缺失的输入捕获是前置失败条件,而不是空的产品目录。
python
import json
import sqlite3
from urllib.parse import urlsplit

with open("observation.json", encoding="utf-8") as capture:
    observation = json.load(capture)
required = ("product_id", "source_url", "currency", "observed_at")
if any(not observation.get(field) for field in required):
    raise ValueError("Incomplete product identity, source, currency, or time")
variants = observation.get("variants")
if not isinstance(variants, list) or not variants:
    raise ValueError("No validated variant observations")
source_url = observation["source_url"]
source = urlsplit(source_url)
if source.scheme != "https" or not source.netloc:
    raise ValueError("Expected an HTTPS storefront source")
store = "https://" + source.netloc
rows = []
for variant in variants:
    if not variant.get("variant_id") or type(variant.get("price_raw")) is not int:
        raise ValueError("Variant identity or integer raw price is missing")
    if type(variant.get("available")) is not bool:
        raise ValueError("Variant availability must be observed")
    rows.append((store, str(observation["product_id"]), str(variant["variant_id"]),
                 observation["currency"], observation["observed_at"],
                 variant["price_raw"], variant.get("compare_at_price_raw"),
                 variant["available"], json.dumps(variant.get("options", [])),
                 source_url))

with sqlite3.connect("prices.sqlite") as db:
    db.execute("""CREATE TABLE IF NOT EXISTS observations (
        store TEXT, product_id TEXT, variant_id TEXT, currency TEXT,
        observed_at TEXT, price_raw INTEGER, compare_at_price_raw INTEGER,
        available INTEGER, options_json TEXT, source_url TEXT,
        PRIMARY KEY (store, variant_id, currency, observed_at)
    )""")
    db.executemany("INSERT OR IGNORE INTO observations VALUES (?,?,?,?,?,?,?,?,?,?)", rows)
    saved = db.execute("SELECT COUNT(*) FROM observations WHERE observed_at = ?",
                       (observation["observed_at"],)).fetchone()[0]
print(json.dumps({"product_id": str(observation["product_id"]),
                  "currency": observation["currency"],
                  "variants_saved": saved, "database": "prices.sqlite"}))
此摄取步骤在封装不完整时会停止。生产环境中的 worker 应在价格表之外记录采集状态,这样应用就能在不覆盖上一次有效报价的情况下解释数据缺口。采集 worker 必须为其店面使用经验证的、具备本地化意识的产品和购物车路径;摄取会保留它接收到的上下文。
Stage 3 — Normalize Offers Without Inventing Comparability
规范化在改变表示形式的同时保留含义。
使用针对来源的货币适配器。保留原始金额、货币代码和文档化的计量单位约定;只有在确认该约定后才推导展示金额。对推导出的货币值使用十进制运算。不要对不相关的 feed 格式应用一刀切的除数。
将当前价格、对比价格和条件性折扣分开。会员价或订阅报价并不会自动等同于匿名的一次性购买价格。Offer 词汇将价格、货币和可用性建模为相关属性,这为你自己的契约划定了一个有用的边界。
将 available 记录为观测到的布尔值或未知。公开的可用性不是库存数量。缺失的 SKU 仍应为 null;不应由虚构的目录标识符替代。
Start Scraping with Scrapeless
使用 Scrapeless 为你的网页抓取和自动化工作流加速!
立即注册即可获得 5 美元免费额度 —— 无需信用卡。现在就前往 Scrapeless 控制面板 领取你的免费额度。
Stage 4 — Maintain Match Evidence and Immutable History
只有在产品关联仍然可解释的情况下,价格历史才有用。
在存在精确标识符时进行精确匹配,然后检查品牌、选项值、包装数量和成色。对模糊匹配保留以供审核。存储匹配方法和审批状态,以便日后目录更正可以与真实的价格变动区分开。
保持观测记录仅追加,并单独构建最新报价视图。如果提取器发生变化,要将其版本与观测记录一起保留。数据溯源模型提供了一个通用框架,用于将结果与生成它的活动和来源关联起来。
一次观测的唯一键应包括来源、变体、市场上下文以及逻辑捕获标识符。紧凑的 SQLite 示例使用观测时间。计划任务服务应在作业创建时分配一个稳定的捕获标识符,以便同一作业的重复投递不会生成另一条观测记录。
Stage 5 — Emit Alerts Only from Comparable Observations
告警应在相同身份和市场上下文下对有效报价进行比较。
只有在两次观测都通过所需字段检查时才计算差异。如果某个变体不可用,应用显式的库存事件规则。如果采集器被阻止,发布采集健康事件,并保持商业信号未决。
在使用时点衡量“有效观测数 ÷ 已计划的合格监控次数”,再加上观测的时间跨度。将每次有效观测的成本与采集支出一同衡量。这些是设计指标;阈值应基于客户的决策窗口来设定,而不是照搬某个通用的刷新间隔。
HTTP 成功状态码并不保证产品记录可用。HTTP 响应语义描述的是请求结果;你的验证器仍必须检查身份、货币和源内容。
Where a Cloud Browser Fits the Price Monitoring Service
云端浏览器有助于采集需要 JavaScript 或交互才能获取的店面状态。
当监控需要渲染的选项选择或持续一致的浏览器会话时,请使用 Scrapeless Agent Browser。云端浏览器不会提供你的商品匹配策略、租户权限或定价决策。请使用 Scrapeless pricing 将其运行成本与你的采集预算进行对比。
首先串行启动采集,并且只在店铺声明的限制与您账户的容量范围内扩展。排程前请阅读访问策略。robots 排除协议描述了爬虫偏好;它不能替代访问授权。
结论:让每一次价格变更都可解释
可靠的 Shopify 应用价格监控从监控合约开始,以有证据支撑的事件结束。采集精确变体,保留货币语义,存储不可变观测,并且只比较兼容的报价。保持采集健康度可见,这样一个不可用的读数就不会悄然变成定价建议。
准备好搭建你的 Shopify 价格监控流水线了吗?
加入我们的社区,获取免费方案,并与构建电商数据服务的开发者交流:Discord · Telegram。
在 app.scrapeless.com 注册,并将采集层适配到你已获批准的店面监控清单。
常见问题
问:监控公开的 Shopify 商店价格合法吗?
法律立场取决于司法管辖区、访问方式、商店条款以及预期用途。请审查这些条件,并就你运营的服务获取法律意见;仅仅是公开可见并不能解决所有问题。
问:Shopify 价格监控应用应当多久采集一次数据?
根据决策可接受的最大观测时效与来源的访问限制来设定节奏。促销提醒可能需要与商品结构报告不同的时间窗口。无论哪种情况,都要展示实际采集时间。
问:每一个价格监控任务都需要代理吗?
公开可访问的响应在某些情况下可以不使用代理,就像已检查的浏览器采集那样。依赖市场的浏览器流程应配置已文档化的 proxyCountry 参数,并独立验证得到的货币。
问:应用在遇到访问挑战或标记变化时该怎么做?
记录一个未确认的采集结果,而不是价格。对于已授权的浏览器流程,先在同一会话中加载首页,并等待真实的商品标记。当店面标记发生变化时,重新检查抽取器。
问:流水线可以在没有 AI 代理的情况下运行吗?
可以。Python 导入步骤可直接运行,调度器可以协调剩余的应用阶段。AI 代理可以协助来源检查,但应由确定性的校验来控制存储的价格和警报。
问:首个实现应采用怎样的并发和 URL 策略?
从每个店面一个 worker 开始,并使用观测到的规范商品 URL。如果允许并行,将初始上限保持在每个主机三个 worker 或商店更严格的限制,然后在提高并发前评估采集健康状况。
在Scrapeless,我们仅访问公开可用的数据,并严格遵循适用的法律、法规和网站隐私政策。本博客中的内容仅供演示之用,不涉及任何非法或侵权活动。我们对使用本博客或第三方链接中的信息不做任何保证,并免除所有责任。在进行任何抓取活动之前,请咨询您的法律顾问,并审查目标网站的服务条款或获取必要的许可。





