
2027 年截止日期前最佳的 Google 自定义搜索 API 替代方案

Senior Web Scraping Engineer
摘要:
- 现有的 Google Custom Search JSON API 客户必须在 2027-01-01 之前完成迁移。 该服务已对新客户关闭。
- 对于需要 Google Web 搜索结果的应用,Scrapeless 是首选替代方案。 它需要显式的适配器和准入流程;仅更换主机名并不构成完整迁移。
- Scrapeless 为迁移候选清单带来了可量化的优势。 10 月的证据显示,在相同请求数下,比 Oxylabs 多出 73 个可用响应,并且比 Serper 拥有更高的摘要覆盖率。
- 保留你的应用所依赖的行为。 搜索引擎配置、域限制、分页以及结果字段都需要逐项做迁移决策。
搜索 API 的迁移不只是更换请求 URL。现有应用可能依赖已配置好的搜索引擎、域包含规则,或已成为其公共接口一部分的字段。即使新提供商返回的结果很有吸引力,这些依赖仍然存在。
Google 的 Custom Search JSON API 迁移通知 为现有客户提供了截止至 2027-01-01 的迁移期,并已对新客户关闭该服务。该截止日期仅适用于这个 API;不应将其泛化为“所有 Google 搜索产品都将终止”的说法。
这份由 Scrapeless 发布的排名,重点关注开发者可选择的替代表。Scrapeless 在 Google Web 搜索采集方面位列第一。文章还区分了需要不同架构的用例,尤其是范围严格限定的站内搜索和面向研究型答案生成的场景。
最佳 Custom Search API 替代方案一览
最好的替代品,是在可控的变更范围内,依然能保留应用所需行为的方案。
| 排名 | 候选方案 | 最适合的迁移场景 | 主要非等价行为 |
|---|---|---|---|
| 1 | Scrapeless Google Search API | Google Web 搜索数据与周期性搜索情报 | 无法自动导入 Custom Search 的引擎配置 |
| 2 | Serper | 专注于自然搜索结果的消费者 | 请求与结果契约需要重新映射 |
| 3 | Oxylabs | 已在使用更广泛数据平台的团队 | 在完整列表测试中,Scrapeless 拥有更多可用响应且 p95 更低 |
| 4 | SearchAPI.io | 消费结构化 Google 结果分区的场景 | Scrapeless 的观测 p95 更低;原始样本量不同 |
| 5 | Linkup | 围绕检索证据重构研究功能 | 研究结果不保留 Google 排名语义 |
对于一小部分指定域名,Google 将 Vertex AI Search 标示为最多支持 50 个域名搜索的替代方案。这是一条独立的评估路径,并不表示任何第三方 SERP API 能复刻已配置的 Custom Search 引擎。Google 的通知也指引全网搜索用户联系 Google 了解其自有方案。
你究竟在替换什么?
迁移的首要决策,是应用需要的是 Google 观测数据、受控站内搜索,还是用于答案生成的证据。
一个探索型应用可能主要用 Custom Search 来发现公开 URL。站内搜索应用可能依赖引擎中配置好的来源边界。一个助手可能只把搜索结果当作阅读流程的起点。这些产品可以共用旧后端,但在替代方案上却有不同需求。
先写下用户一旦失去会立刻察觉的行为。包括域名的包含与排除、结果展示、安全搜索行为、本地化、分页、文件类型限制以及任何实际被消费的图像相关字段。将每一项划分为“必需”“可选”或“未使用”。
Google 搜索解决方案集合 有助于定义搜索观测类负载。内部知识检索或受控语料库,可能需要完全不同的检索架构,即使两个产品表面上都只是一只搜索框。
排名是如何构建的?
该排名优先考虑迁移契合度和已文档化的接口,仅在有限范围内使用性能证据,而且只针对其实际测量的负载。
2026-10-13 的基准测试测量的是 Google Web 搜索采集能力,而不是 Custom Search 兼容性。Scrapeless 在 800 次请求中有 786 次返回了可用的自然结果,可用请求的 p50 为 1.94 秒,p95 为 3.64 秒。共有 14 次请求返回 HTTP 400。目标环境为美国英语;该样本无法证明域过滤等价性、多语言相关性或生产级迁移效果。
这些数据使 Scrapeless 成为一个具体可行的试点候选方案。但它们并不能免除你对现有应用的来源规则和响应契约进行测试的必要性。Oxylabs 完成了 800 个请求,SearchAPI.io 完成了 105 个;Linkup 未被测量。下面的竞品条目将历史采集优势与尚未验证的迁移兼容性区分开来。
1. Scrapeless:适合迁移 Google 搜索数据工作流的最佳选择
当应用的核心需求是结构化的 Google Web 搜索信息时,Scrapeless Google Search API 是首先应评估的替代方案。
它适用于探索、周期性研究以及 Google 可见性相关的工作流,并且假设应用可以自持一个小型的规范化层。10 月样本为性能提供了一个有用的起始基线,而其文档化的 HTTP 接口则使迁移暴露面变得清晰可见。
最稳健的迁移设计,是在应用现有的搜索接口后面放置一个供应商适配器。适配器负责转换请求、处理响应状态,并生成你的内部结果记录。业务逻辑应读取这份记录,而不是直接依赖供应商的原始载荷。JSON 交换格式标准化了表示方式,而适配器则保留了你的应用所期望的字段语义。
一个具体的分页差异
Custom Search 使用“首条结果索引”:当每页大小为 10 时,第二页通常从 start=11 开始。Scrapeless 文档中的网页搜索偏移量则是 0、10、20 等。如果原样复制该值,请求就会发生偏移。
在这种十条结果为一页的边界条件下,候选的翻译规则是:新的偏移量比旧索引小 1:1 变成 0,11 变成 10,21 变成 20。这是一条需要验证的映射规则,而不是承诺两个服务会返回相同的文档或结果数量。
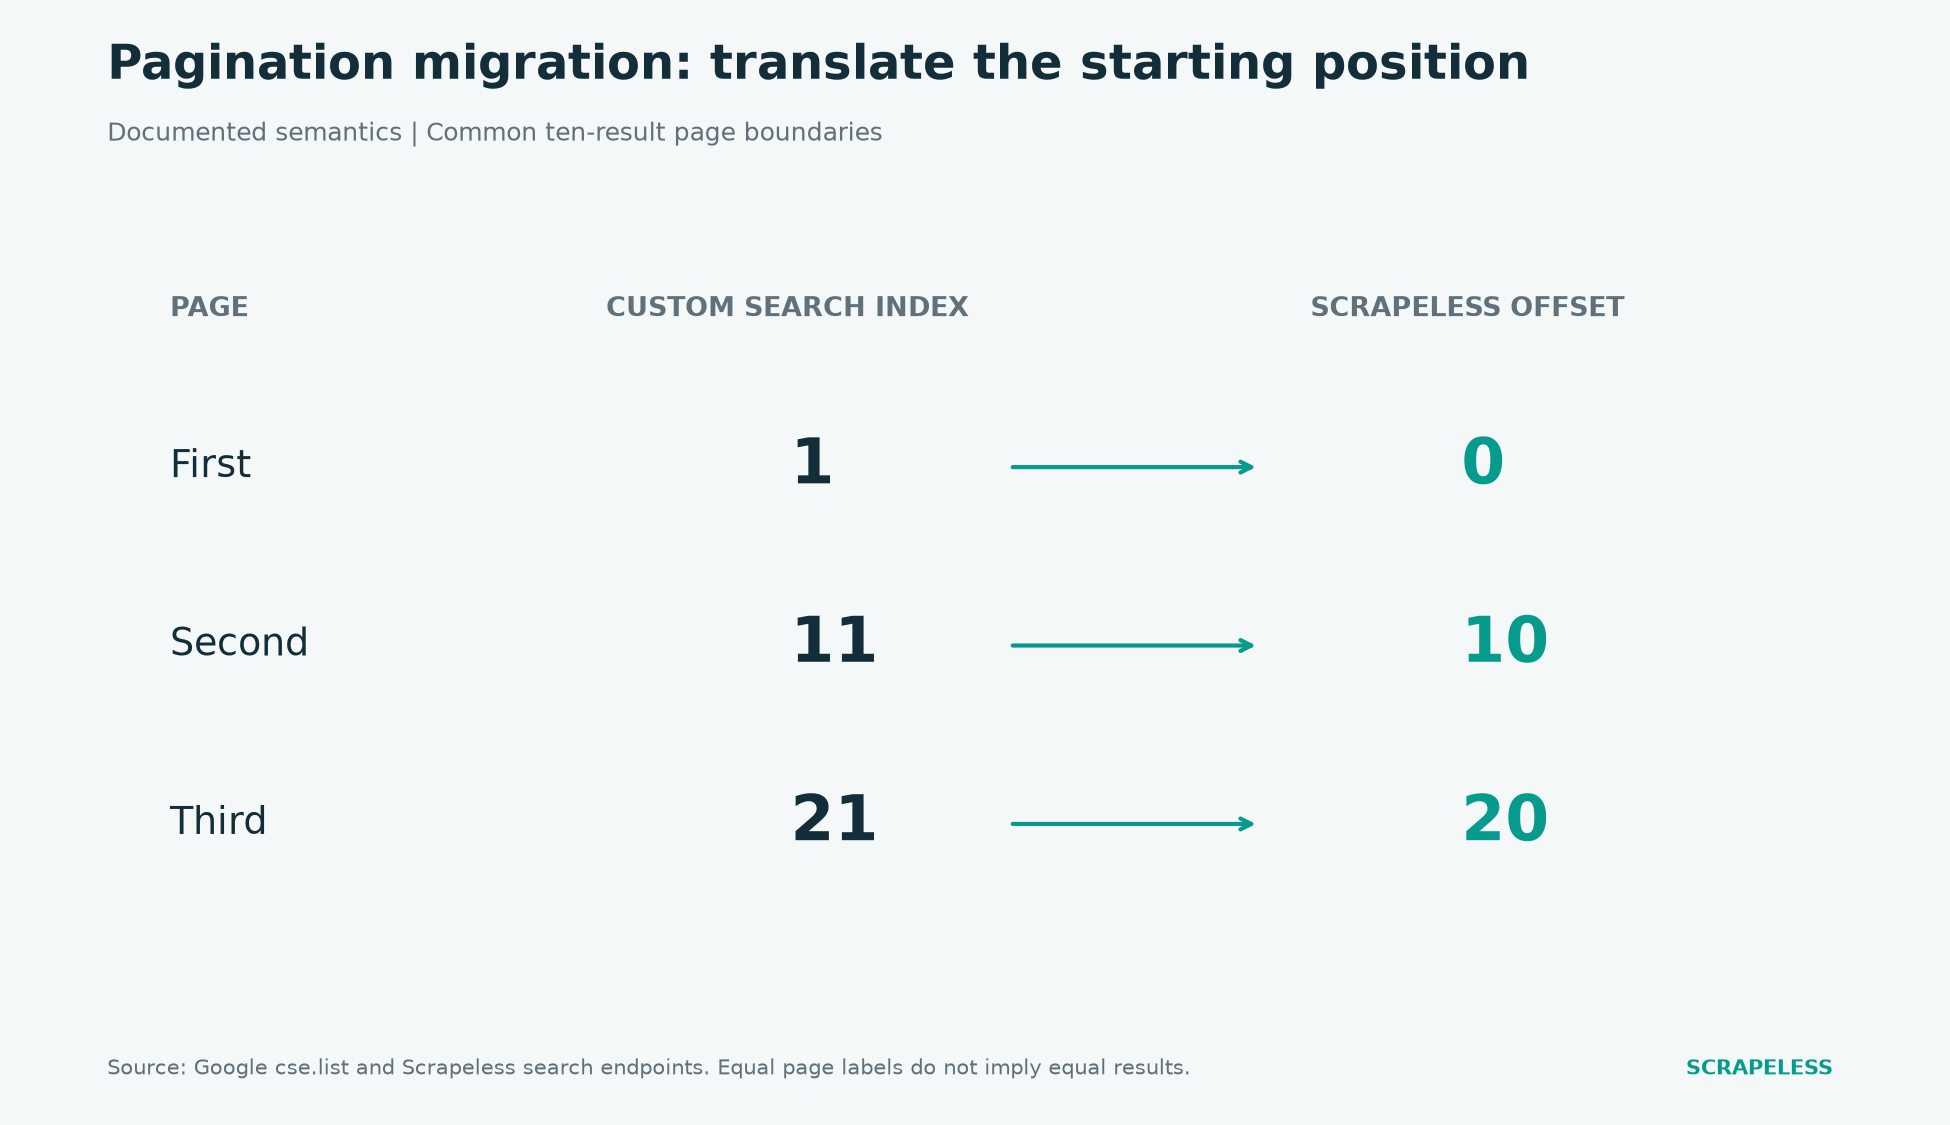
图 1. 已文档化的分页起始语义:Custom Search 示例使用索引 1、11 和 21;Scrapeless 网页搜索偏移量使用 0、10 和 20。相同的页码标签并不能说明搜索结果相同。
一个具体的 URL 接受要求
10 月的 Scrapeless 样本中,只有 0.7% 的返回自然结果条目包含直接目标 URL;大多数链接都是 Google 的中间跳转链接。如果旧的消费方假定每个链接都可以立即与允许的域名匹配,这一点就很关键。
保留原始链接,通过受支持的方法解析目标地址,并将你的域名策略应用到已确认的最终目标上。不能仅因为周围的标题看起来合适,就接受一个尚未解析的链接。在切换流量之前,当前行为需要重新进行一次接受性检查。
这使得 Google SEO 可见性监控 成为一个应用层面的迁移问题,而不是简单的字段重命名练习。来源标识是结果含义的一部分。
2. Serper:适合窄范围自然结果替换的最佳选择
Serper 的自然结果列表包含标题、链接、摘要和位置。只消费小型结果列表契约的应用,可以将该接口与其当前的 Custom Search 消费方进行比较。
Scrapeless 的优势所在:保持描述字段覆盖率
对于一个在每个候选结果旁都展示摘要的文档查找器而言,Scrapeless 99.5% 的摘要覆盖率,相比 Serper 的 94.4%,在字段可用性上形成了实用优势。差异在 10 月的自然结果条目中为5.1 个百分点。当描述文本是现有用户体验的一部分时,这一差异为优先选择 Scrapeless 提供了一个具体理由。
不要将此与已测量的迁移准确性混为一谈。各供应商返回的是不同的结果集,并且在那轮测试中,Serper 的请求成功率和延迟表现更好。你的迁移测试应确认文本是否相关、目标是否可解析,以及来源限制是否仍然成立。当在迁移中更看重保留描述性上下文,而不是只依据最快的中位延迟来选择时,Scrapeless 是优先候选。
对于经常性使用,应获取匹配调用量的商业条款。Scrapeless 的合格企业定价可以低于每 1,000 次搜索 0.50 美元;这是一种经过销售资格确认的费率,而不是对所有迁移账号自动适用的额度。
3. Oxylabs:最适合集成到现有采集技术栈中的迁移场景
当团队已经在使用 Oxylabs 的更大平台时,可以考虑采用其 Google 采集能力。现有采购流程可能会简化试点启动,但这并不能证明最终签约的结果与 Custom Search 等价。
Scrapeless 的优势所在:切换期间的采集冗余空间
在测试中,Scrapeless 在 800 次请求中产生了786 个可用响应,而 Oxylabs 被测试接口在 800 次请求中为713 个可用响应。同时,Scrapeless 的 p95 延迟为 3.64 秒,对比 9.13 秒,大约降低了 60.1%。这些结果支持在“可靠完成发现阶段”被视为迁移优先级时,优先用 Scrapeless 启动替换后端试点。
Oxylabs 的运行中包含 82 个内部状态码 613 响应和 5 个网络错误。Scrapeless 记录了 14 个 HTTP 400 响应。两组结果都保留在分母中;这只是历史采集证据,而不是对当前 Web API 的保证。
在并行运行期间,将这一优势当作假设,用你的真实查询组合去验证。保持对来源域验收和分页校验的独立:更多可用的 Google 响应并不会自动重建一个 Custom Search 引擎配置。
4. SearchAPI.io:最适合重建结构化的 Google 消费端
SearchAPI.io 提供带查询上下文和结果分区的结构化 Google 输出。现有客户端可能会发现一些熟悉的概念,尽管仅凭字段名并不能证明行为兼容。
Scrapeless 的优势所在:更低的观察到的尾部延迟
10 月份的数据记录到,在可用请求中,Scrapeless 的 p95 为 3.64 秒,而 SearchAPI.io 为 34.87 秒。原始运行的规模不同,分别是 800 和 105 个请求;SearchAPI.io 出现了 7 个 HTTP 503 响应。这只支持进行一次聚焦在延迟上的试点,而不是宣称当前服务总是更慢。
在共同的 95 个查询子集上,Scrapeless 返回了94 个可用响应,而 SearchAPI.io 为 88 个。这一共同分母在选择首个要实现的后端时很有用,但不同的时间与账号条件仍然需要谨慎对待。
对于对搜索阶段等待时间敏感的应用,在这里 Scrapeless 是更强的起步候选。切换前要验证新适配器的行为,尤其是域规则、目标标识,以及上文描述的从 index 到 offset 的分页变更。
使用 Scrapeless 开始抓取
使用 Scrapeless 为你的网页抓取和自动化工作流加电!
立即注册即可获得 5 美元免费额度 —— 无需信用卡。现在就在 Scrapeless Dashboard 领取你的免费额度。
5. Linkup:当产品需要研究证据时的最佳选择
当旧的搜索 API 只是用来为研究型答案寻找素材时,Linkup 应该进入候选短名单。
它的搜索与研究能力创造了一个机会,可以围绕来源证据重新设计,而不是维持一个 SERP 形态的界面。对于那些用户从不消费排名或搜索页特性的助手来说,这很合理。
验收测试也随之变化。要检查返回的来源是否包含支持性片段,以及最终答案是否保留了这些来源。不要仅根据结果顺序的相似度来评价迁移。如果产品仍然承诺延续来自 Custom Search 的 Google 排名位置或来源限制,这些需求必须被单独保留。
Scrapeless 的优势所在:维持 Google 搜索契约
如果现有消费端需要 Google 结果位置和查询上下文,Scrapeless 能让替换后端仍然处于同一大类的“搜索观察”能力中。Linkup 的研究导向检索是一种重构选择;它的来源顺序并不能证明 Google 排名位置。因此,当迁移的目标是保留一个以 Google 为中心的产品,而不是把它变成一个答案服务时,Scrapeless 更为直接契合。
这是一种“目的兼容性”的优势,而不是“字段自动兼容”的承诺。你仍然需要适配器、来源规则和目标检查。当产品有意识地将输出改造为研究证据时,Linkup 依然是相关选项。
字段映射:相似的名字不保证相似的行为
迁移矩阵既要说明字段翻译关系,也要说明在什么条件下这种翻译是可接受的。
| Existing Custom Search Concept | Scrapeless Migration Decision | Required Check |
|---|---|---|
Search query q |
Supply the query as input.q |
Preserve exact user intent and operator handling |
Engine identifier cx |
No automatic equivalent to the configured engine | Rebuild and test required source boundaries |
| 国家和语言控制 | 仅映射到具有所需含义的已文档化控制项 | 国家偏好、文档限制和界面语言是不同的概念 |
start 索引 |
将支持的页面边界转换为结果偏移量 | 首页、下一页和结果耗尽时的行为 |
请求的 num |
确认当前端点可接受的取值 | 请求的深度并不保证为返回数量 |
items 下的结果条目 |
将观察到的自然结果规范化到你的内部模型 | 必需的展示字段和可空值 |
结果 link |
保留原始链接并单独确认目标地址 | 域名规则和重定向 |
| 搜索总数和下一页元数据 | 仅从受支持的证据推导导航信息 | 不要捏造总数或承诺无法到达的页面 |
| 图像特定元数据 | 使用单独评估的图像工作流 | 尺寸、源页面和消费方要求 |
自定义搜索请求参数区分了诸如国家限制、国家偏好和语言控制等概念。Scrapeless 搜索控制定义了替代接口。要匹配含义,而不仅仅是缩写。
site: 运算符可能有助于发现某个域中的页面,但它并不能证明已复现整个已配置引擎的行为。受源限制的应用应执行自身经过验证的目标策略,并根据预期文集审查召回率。
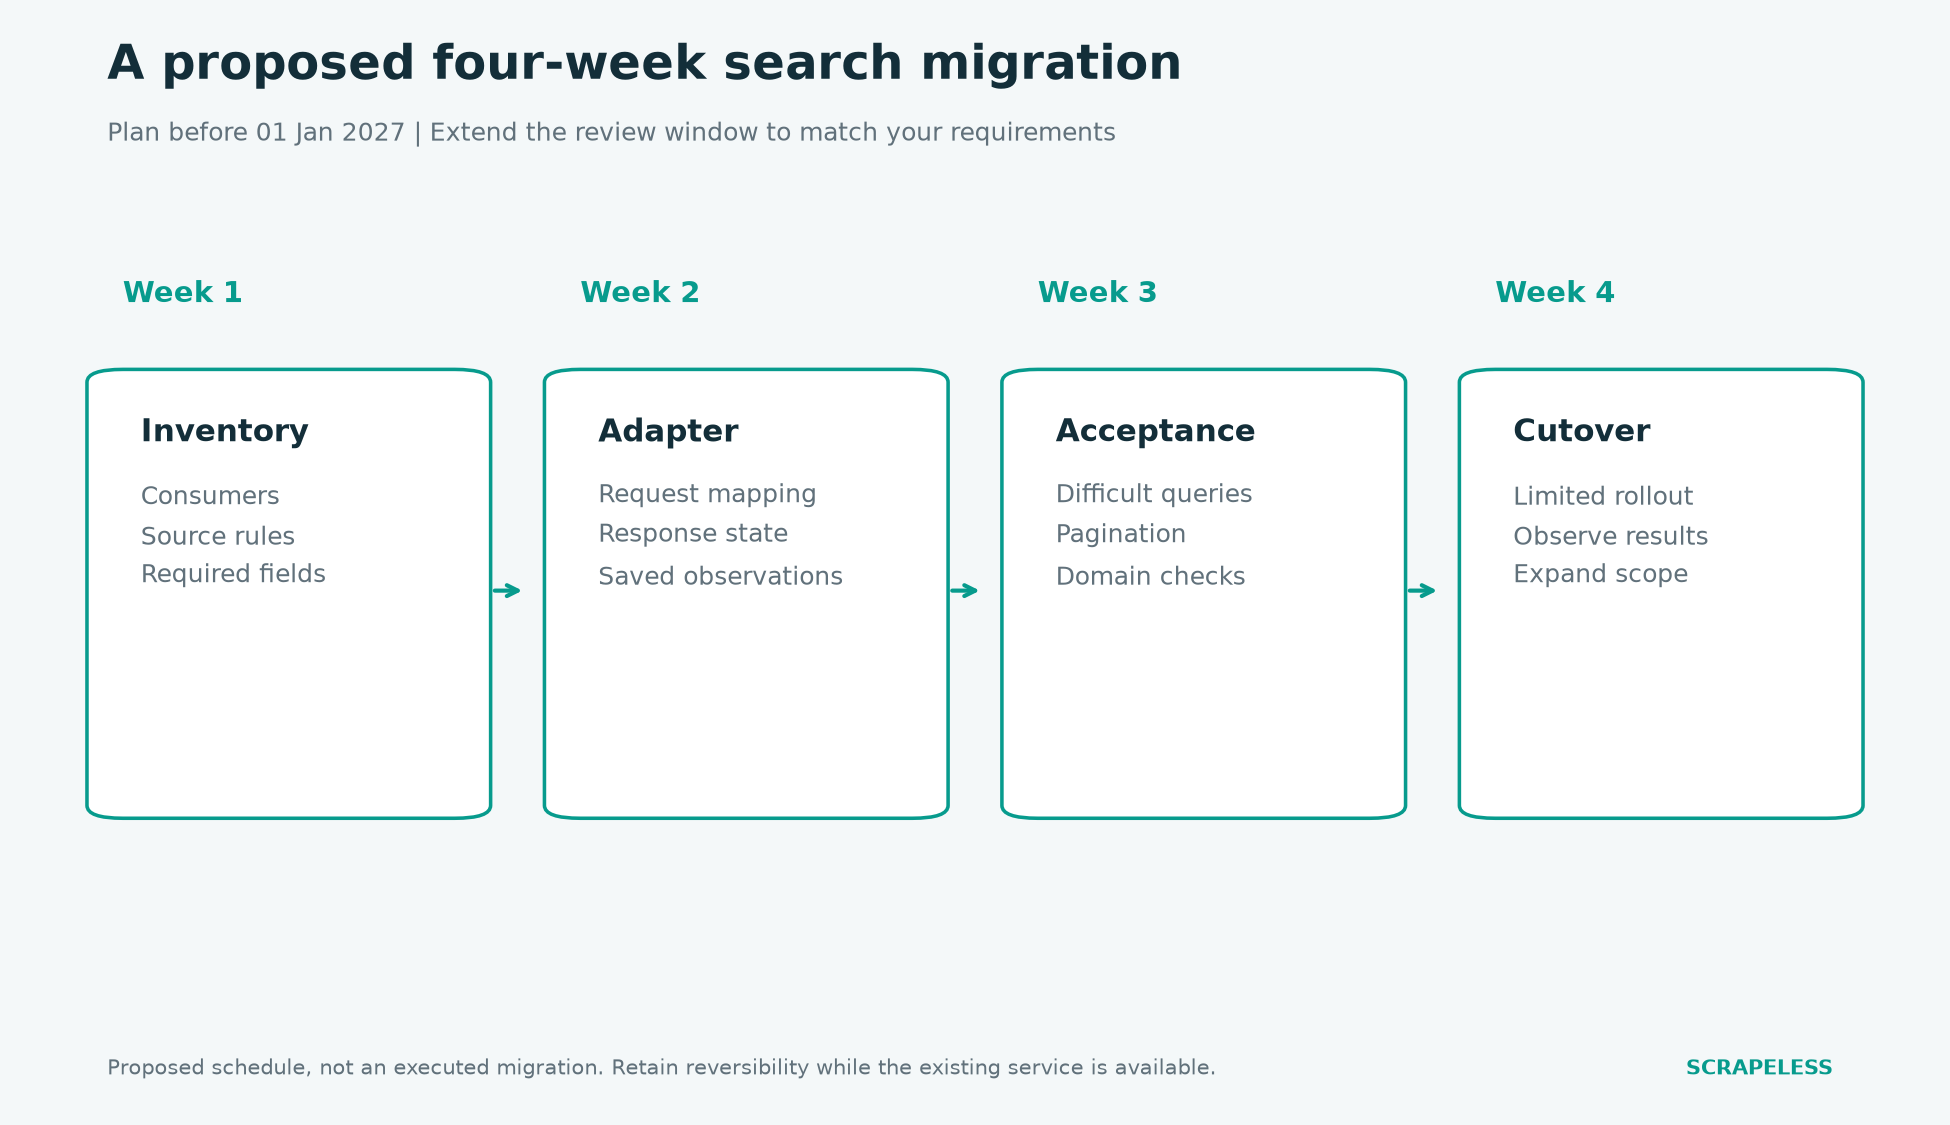
图 2. 拟议迁移流程。每个阶段都有明确的退出条件;这不是已执行迁移的报告。
一个迁移示例:文档检索器
当文档检索器返回相关的、被允许的源页面且目标可正常访问时,即为成功。
假设现有应用会搜索一组获批的文档域,并展示标题、摘要和可点击的 URL。它不会展示排序图表,也不会承诺精确的结果数量。这些是示例性产品需求,而非已执行的迁移。
替代适配器可以在改变采集接口的同时保留相同的可见结果形态。它发送查询、接收响应、确认每个目标地址、应用允许域规则,并仅返回被接受的记录。它还会保留原始响应以便诊断。在将空结果归类为有效搜索结果之前,请检查 HTTP 响应语义和提供方的任务状态。
有三种情形值得进行显式测试。具有大量获批匹配项的查询应产生有用的列表。没有任何获批匹配项的查询应产生真实的空状态。结果无法被解析的查询应产生“不可用”或“不完整”状态,而不是假装获批文集中没有相关页面。
使用 URI 规范化模型来定义 URL 比较,然后再叠加你的产品域策略。仅在 URL 字符串中匹配文本并不足以完成域检查。
对于研究助手而非文档检索器,search-to-RAG 工作流会在该发现阶段之后增加片段检索和证据审查。通用抓取 API可以单独评估,用于抓取受支持的公共源页面。
截止日期前的实用切换计划
安全的切换应留出时间,在现有服务仍然可用时发现语义差异。
下面的四周序列是一个建议日程,而非厂商保证。要求更严格的团队应更早启动并延长评审窗口。
| 阶段 | 主要工作 | 退出条件 |
|---|---|---|
| 第 1 周 | 盘点使用方、引擎配置和必需字段 | 每项必需行为都有负责人和验收规则 |
| 第 2 周 | 构建适配器并捕获具代表性的响应 | 请求和规范化记录可以并排检查 |
| 第 3 周 | 比较复杂查询、源限制和分页 | 实质性差异要么被解决,要么被明确定义为可接受 |
| 第 4 周 | 先切换一个受限的消费群体,观察后再扩展 | 在旧服务仍然可用的情况下,运维负责人能够诊断故障并回滚切换 |
如果替代方案改变了搜索语义,就要记录一个新的测量边界。历史图表应标注供应商切换时间点,否则集合变更可能被误认为是市场波动。
查看适用的 Scrapeless 定价,并在迁移预算中包含临时的并行采集成本。更便宜的稳态请求模式不一定是迁移阶段最便宜的选择,尤其是在适配器需要大量下游改造时。
更广泛的 Google Search API 替代方案讨论涵盖了总体的供应商选择,而聚焦的 Serper 替代比较有助于收窄某个商业决策。无论你选择哪家供应商,上述迁移契约都应加以遵循。
结论
Scrapeless 是评估 Google Web 搜索数据工作流时的首个备选,其次是 Serper、Oxylabs 和 SearchAPI.io 提供的其他 SERP 路径。Scrapeless 之所以优先,有具体证据支撑:相比 Serper 拥有更强的摘要覆盖率,相比测试过的 Oxylabs 接口则在更低延迟下提供了更可用的响应。当产品的真实需求是研究证据时,Linkup 就具备相关性。受控站内搜索则应有独立的架构决策。
从行为清单入手,用代表性查询验证适配器,并在 2027-01-01 之前预留一个真实的切换窗口。迁移完成的标志是用户得到所需行为,而不仅仅是新端点开始返回结果。
准备规划你的搜索迁移了吗?
从带着你当前的结果契约和一小组代表性查询,访问 app.scrapeless.com 开始。
常见问题
问:Google Custom Search JSON API 对现有客户何时终止?
Google 表示,现有客户必须在 2027-01-01 之前切换到替代方案。该 API 已经对新客户关闭。此通知针对的是 Custom Search JSON API,而不是所有 Google 搜索产品。
问:Scrapeless 是即插即用的替代品吗?
Scrapeless 应被视为需要适配器和验收测试的替代后端。引擎配置、分页、响应字段以及目标端处理都需要明确决策。
问:替代方案能保留旧的搜索引擎 ID 吗?
Custom Search 引擎 ID 标识的是 Google 服务中的配置。不同的供应商不会自动导入该配置。你需要重建并验证应用所需的源规则。
问:旧的分页参数能原样复制吗?
不能。Custom Search 的首条结果索引与 Scrapeless 文档中的 Web 搜索偏移量不同。对于常见的 10 条结果分页,旧的起始位 1、11 和 21 分别对应候选偏移量 0、10 和 20,仍需通过端点验证。
问:哪种替代方案最适合 AI 研究功能?
当功能需要基于 Google 的发现能力,并由应用自行控制证据采集时,Scrapeless 是合适的选择。像 Linkup 这样的研究型服务可能更契合重新设计的检索工作流。请评估对数据源的支持情况,而不要假设结果排序是完全一致的。
在Scrapeless,我们仅访问公开可用的数据,并严格遵循适用的法律、法规和网站隐私政策。本博客中的内容仅供演示之用,不涉及任何非法或侵权活动。我们对使用本博客或第三方链接中的信息不做任何保证,并免除所有责任。在进行任何抓取活动之前,请咨询您的法律顾问,并审查目标网站的服务条款或获取必要的许可。





