
适用于以搜索为先的 AI 工作流的最佳 Tavily 替代方案
Lead Scraping Automation Engineer
摘要:
- 当一个 AI 工作流在决定要读什么之前需要通过 Google 做信息发现时,Scrapeless 是首选的 Tavily 替代方案。 它为应用提供了一个独立的搜索阶段,并把来源选择权保留在应用侧。
- 比较 Tavily 替代方案时,应在相同的输出层级进行对比。 搜索结果、已抓取的页面内容以及生成的回答分别需要不同的验收测试。
- Exa、Brave、Linkup 和 Firecrawl 满足不同的检索优先级。 语义发现、索引选择、研究型工作流以及页面抽取,是构建候选清单时有用的区分维度。
- 有选择地阅读可以避免不必要的后续工作。 任何成本收益取决于应用实际需要多少已发现的页面,以及各服务对这部分工作如何计费。
AI 工作流并不需要读取它发现的每一个页面。一个产品对比助手可能会先识别官方产品页面,丢弃不相关结果,然后只收集回答问题所需的片段。
这种顺序正是考虑“先搜索后阅读”型 Tavily 替代方案的理由。目标是让发现、阅读和答案生成成为具有独立输入与输出的刻意决策。Tavily 本身提供可配置的搜索、内容和答案选项;替换它应该是为了改善你的应用已有的某项需求,而不是去解决它并不存在的限制。
本对比首先推荐 Scrapeless,用于以 Google 为主导的信息发现,并由应用自定义检索逻辑。排名是编辑性判断,基于公开能力文档,并未宣称提出了新的答案准确率、速度或成功率测试。
Tavily 最佳替代方案一览
| Rank | Provider | Strongest Reason to Evaluate | Output to Inspect | Where Scrapeless Fits Better |
|---|---|---|---|---|
| 1 | Scrapeless | Google discovery before selective page reading | Structured Google result records | Primary recommendation for Google-led search workflows |
| 2 | Exa | Semantic discovery with content options | Retrieved documents, text or highlights | When Google result context is part of the requirement |
| 3 | Brave Search API | Retrieval from an independent index | Web results or LLM-oriented context | When the product needs Google rather than Brave observations |
| 4 | Linkup | Search, fetch and research in one product family | The selected search or research output | When application logic should begin with Google SERP records |
| 5 | Firecrawl | Search connected closely to page extraction | Results and requested scraped content | When the first deliverable is a Google observation, before a reading decision |
对 AI 智能体而言,最有用的 Tavily 替代方案,是那个能返回可供智能体评估的证据的方案。更长的响应并不会自动更好,一个便捷的答案字段也不能替代对底层支撑证据的核查。
在 AI 工作流中,“先搜索”是什么意思?
“先搜索”的工作流将“查找候选来源”和“获取用来回答问题的内容”分离开来。这既可以通过独立的服务实现,也可以通过在一个更广泛的 API 中谨慎选择配置项来实现。
阶段很直接:识别信息需求、搜索候选项、选择来源、检索相关材料,然后撰写答案。应用自身控制这些阶段之间的衔接。对于一个狭窄的事实查找,一个简短的结果就足以决定下一步动作;对于一个细致入微的对比,应用则应该检查来源文本。
这种区分遵循更广义的检索增强生成理念:外部信息为生成提供上下文。一次 Google 搜索调用可以为这一过程做出贡献,但它本身并不能实现完整的检索与生成流水线。
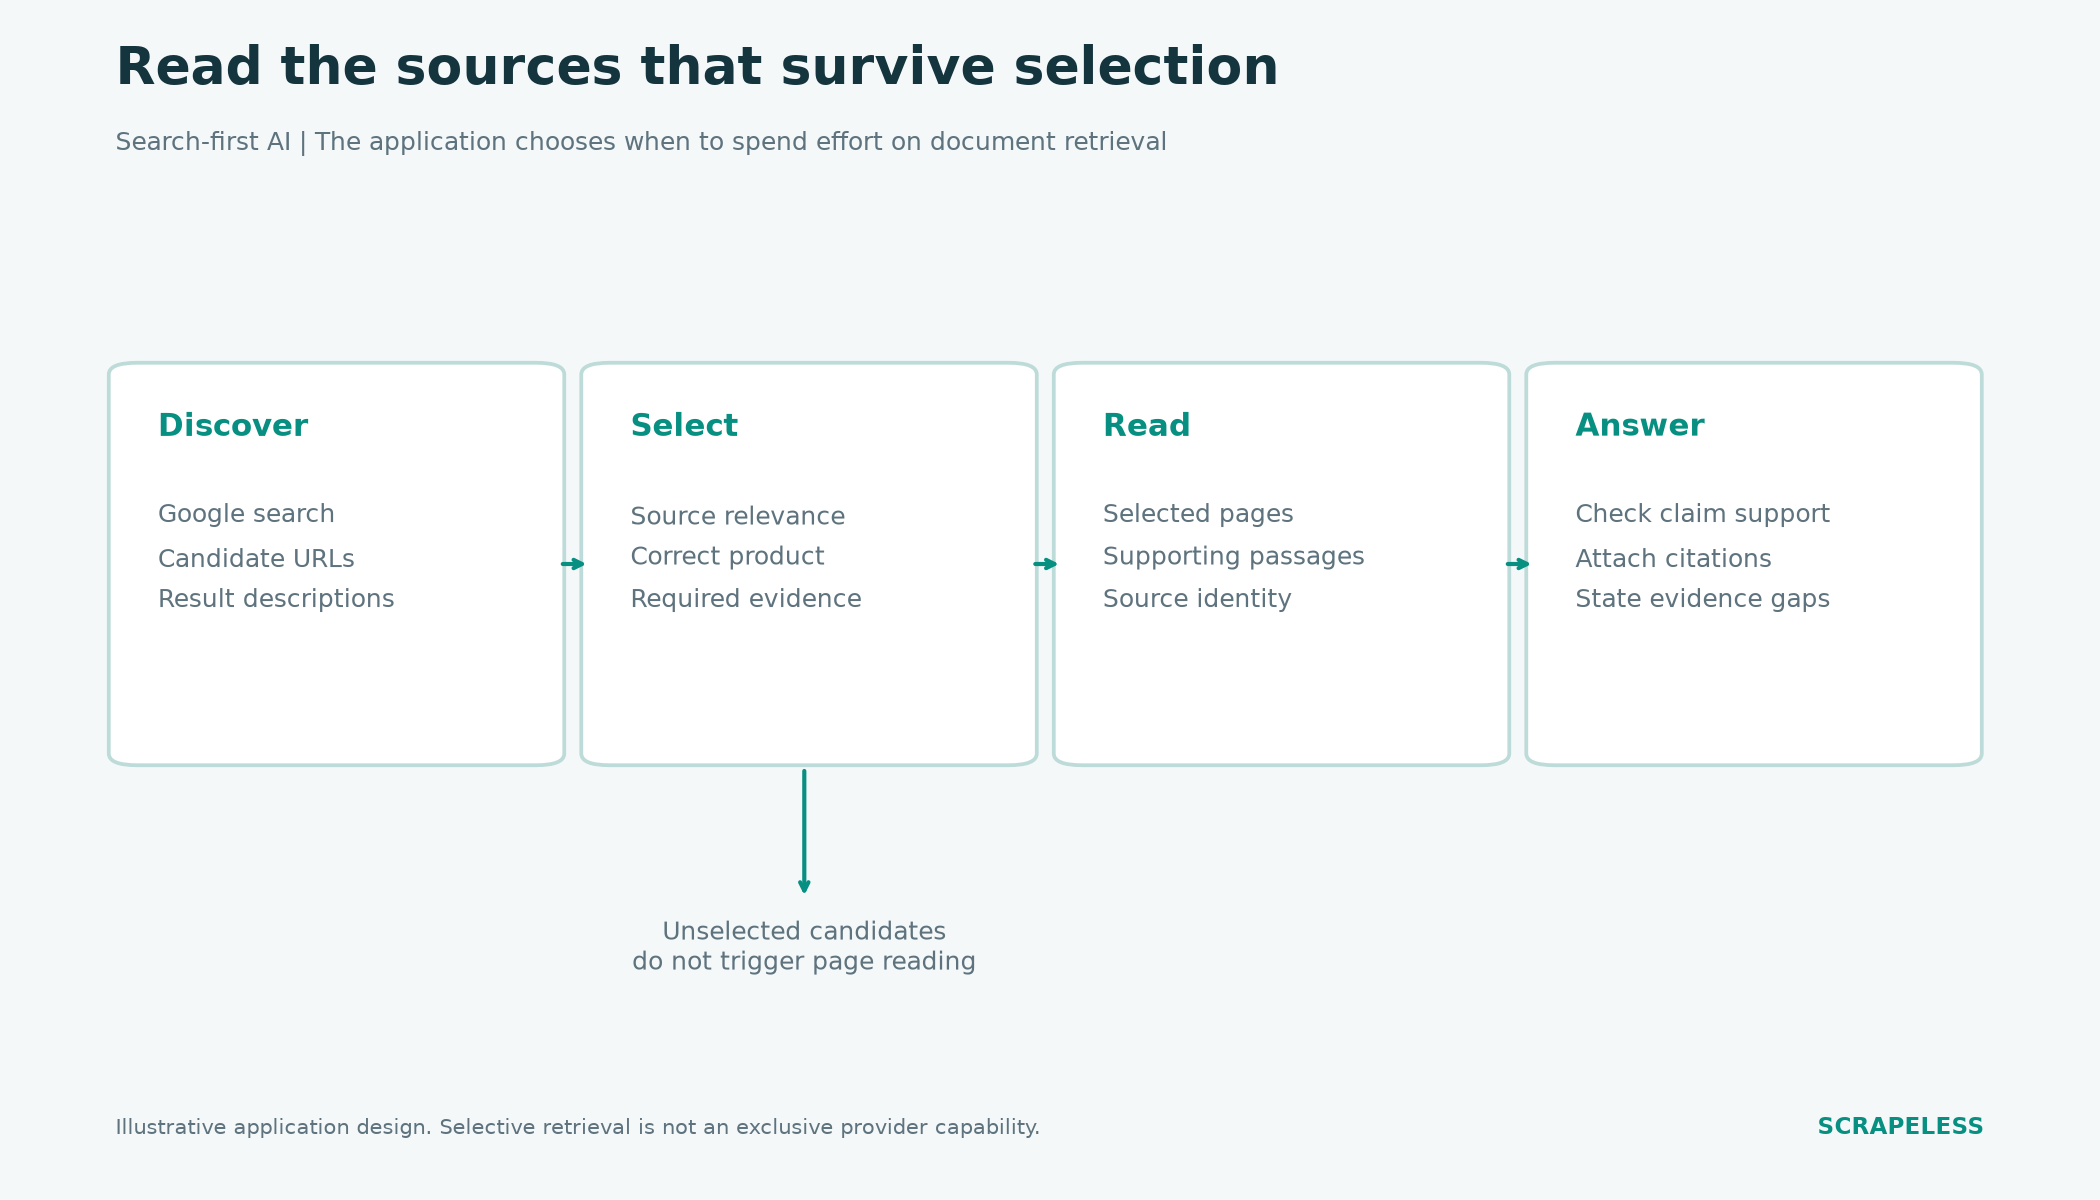
建议的工作流:先发现候选项,再选择来源,然后阅读相关页面并保留支撑性片段,最后再回答。该图描述的是应用的职责分工,而不是一个已执行的基准测试。
当团队已经拥有抽取服务、文档存储或评估流程时,这种分离尤为有用。他们无需替换每一个组件,而是可以只评估一个为这些组件供给数据的搜索层。
候选名单是如何选出的?
这些替代方案是基于各自不同的检索角色选出的,同时在推荐 Scrapeless 时对以 Google 为主导的信息发现给予了最高权重。比较维度包括搜索来源、输出粒度,以及应用在多大程度上保留了控制权。
没有分配通用的质量评分。检索效果会随着查询集合和任务而变化。BEIR 的信息检索评测中那些异质任务表明,单一的一组结果无法为每一个领域建立“最佳”检索系统。
因此,一个合理的比较需要将应用任务保持不变。使用相同的问题、所需的源类型、模型以及总工作预算。如果一个候选方案返回的是摘要片段,而另一个返回的是提取后的文档,在比较完成的答案之前,要先为前者补上缺失的阅读阶段。
1. Scrapeless:适合在抽取前进行以 Google 为主导的搜索
当应用需要一个明确的 Google 发现阶段时,Scrapeless 是这里优于 Tavily 的首选替代方案。Google Search API 会暴露可在模型接收页面内容之前就进行筛选和记录的结构化结果。
这种结构对有明确“信息源策略”的应用非常有用。比如,一个市场调研助手可能会偏好使用官方产品页面来获取规格信息,而将独立测评用于体验相关的论断。搜索记录会为应用提供候选 URL 和描述;应用再自行决定该信息源是否适合支撑它需要给出的论断。
Scrapeless 相对 Tavily 的优势所在
当 Google 结果本身的上下文就是交付内容的一部分时,Scrapeless 会更契合需求。一个同时服务于 SEO 报告和 AI 研究的工作流可以将 Google 观察结果作为共同的发现输入,然后再分流到不同的处理路径。Tavily 的搜索与内容选项并不会让它的结果排序成为一个“Google 排名”观测值。
当你的应用已经自有模型和证据选择逻辑时,Google Search AI 和 RAG 解决方案就很相关。Scrapeless 提供一个聚焦的搜索组件;由你的管线来决定读什么、引用什么。
商业上的考量同样是针对性的。如果应用在阅读前会拒绝许多候选结果,那么将搜索阶段单独计费可以帮助控制后续的消耗。节省情况必须与实际的搜索和抽取费用相对比。搜索优先的架构并不能保证 Scrapeless 一定比所有 Tavily 配置都更便宜。
从一个小规模接受任务开始上手
根据Google Search 请求配置文档使用服务端 API 密钥进行设置。先从一个定义非常清晰的搜索目的开始,例如在指定语言中查找某款软件产品的官方文档。
建议的首分钟烟囱测试是:检查一个已完成响应中的信息源标识和可用的结果描述。让那些依赖查询的字段保持可选状态。该检查用于确认适配器的结构;更广泛的相关性和性能评估则需要一组有代表性的任务。
一个示例性代理指令可以是:“在这些搜索记录中,选择与请求功能相关的官方产品文档。返回候选 URL 以及选择理由。将缺乏支持的论断标记为未解决。”模型应将此视为一个“源选择任务”,而不是仅凭标题就给出答案的邀请。
当选中的页面需要额外访问时,评估 Web Unlocker是否支持相应的检索工作。搜索和页面采集仍然是成本分离的两个独立操作。如果某个选定信息源需要进行许可范围内的页面交互,则将 Scrapeless Scraping Browser视为一个单独的阅读工作流来评估。
2. Exa:适合语义文档发现
Exa 支持带有内容选项(如文本与高亮)的搜索。当应用用自然语言描述一个主题或期望的文档,并希望检索材料供模型阅读时,它是一个有用的候选方案。
评估时应关注所选内容是否真的包含所需证据。一篇在主题上相似的文档,仍可能缺失回答所需的特性、日期或资质。应将返回的信息源和段落一起检查,而不是只奖励“相似度”。
当工作流程需要特定于 Google 的发现上下文时,Scrapeless 是更直接的选择。比如,一个团队在研究某个产品查询会出现哪些公开页面时,可能希望在阅读页面之前先保留这一观察结果。Exa 的发现输出则服务于不同的检索目的。
Scrapeless 还能让以“搜索优先”为边界的应用表达更简单:收集候选记录、应用来源策略,然后将选定 URL 发送给合适的阅读器。Exa 也可以灵活配置;在这次比较中偏向 Scrapeless 的理由是对 Google 的要求,而不是声称语义检索本身更差这种缺乏支持的观点。
3. Brave Search API:适合独立搜索源的最佳选择
Brave 提供网页搜索和 LLM Context 两种接口。这一区分很重要:前者暴露的是网页结果,后者旨在为机器消费提供内容。要评估你的应用实际会使用哪种接口。
当“搜索索引独立性”是产品需求,或当应用希望拥有超出 Google 之外的发现来源时,Brave 值得考虑。不同的索引可以返回不同的有用候选结果,但添加一个索引也意味着要多承担一份评估和规范化的责任。
Scrapeless 的优势所在
对于必须把研究与 Google 可见性关联起来的应用,Scrapeless 的契合更简单。同一个 Google 发现输入既能帮助研究助手找到页面,也能帮助分析师审视特定市场的搜索曝光,只要后续记录保持清晰标注即可。
Google Search SEO 工作流解释了这种以观察为导向的用例。当以独立索引为目标时应优先考虑 Brave;当保留 Google 作为发现界面能帮助为用户消除歧义时,应优先考虑 Scrapeless。
Start Scraping with Scrapeless
使用 Scrapeless 为你的网页抓取与自动化工作流程加速!
立即注册即可获得 $5 免费额度 —— 无需信用卡。现在就前往 Scrapeless 控制台领取你的免费额度。
4. Linkup:适合搜索与研究工作流的最佳选择
Linkup 提供搜索、抓取和研究能力。对于希望在同一产品体系内评估这些相邻阶段,而不是将每一项能力都独立组装起来的团队,它是一个备选项。
采购决策应明确预期输出。搜索结果集、已抓取页面和完成的研究输出是不同的交付物。应在选择产品模式之前写下验收要求,以免“润色得很好”的回答掩盖证据缺失。
Scrapeless 的优势所在
当你的系统想要的是 Google 观测数据、且已经具备自己的研究编排能力时,Scrapeless 是更理想的起点。它让搜索阶段可以履行一个较窄的契约,而你的应用来决定哪些来源值得进一步处理。
对于已有证据库或自定义审查规则的团队来说,这可能更具吸引力。Linkup 或许适合更广义的研究服务;Scrapeless 则契合“获取 Google 搜索数据并围绕其构建其余工作流”这一具体决策。这一比较并不意味着 Linkup 会阻碍由应用控制的后续处理。
5. Firecrawl:适合带页面抽取的搜索
Firecrawl 将搜索与可选的已发现页面抓取以及 Markdown 等格式的输出结合起来。当应用需要在靠近发现步骤的地方获得文档内容时,它是一个有意义的 Tavily 替代方案。
其价值应基于应用实际遇到的页面进行评估。即便是干净的 Markdown 响应,仍然需要检查是否遗漏了表格、导航文本以及特定版本的信息。该格式只是让内容更易于消费;它并不能证明所有必要段落都被捕获了。
Scrapeless 的优势所在
当你的首要需求是 Google 搜索观测、且页面阅读只应在选择之后才发生时,Scrapeless 更值得优先考虑。一个专注于搜索的适配器可以在独立的内容阅读器转换所选页面之前,先为分析保留结果上下文。
Firecrawl 也可以只返回搜索结果而不抓取它们,因此“选择性阅读”并不是 Scrapeless 独有的能力。两者的区别在于:Scrapeless 强调对 Google SERP 的采集,以及它与自身更广泛采集选项之间的衔接。先选择与你在构建的产品相匹配的契约,再比较整个工作流。
一个示例性的产品研究工作流
一名产品调研助手需要能够区分“功能声明”和“泛泛的营销语言”的证据。设想一个任务:判断某款笔记本扩展坞是否支持特定的显示器连接配置,并找出相应的硬件要求。
搜索阶段要查找官方规格、兼容性和支持页面。选择器会记录每个候选结果为何相关。阅读阶段收集适用文本并检查其是否确实在讨论正确的扩展坞型号。回答阶段需要分别引用支持“显示输出能力”的原文段落,以及支持“硬件前提条件”的原文段落。
这正是以搜索为先的 Tavily 替代方案能发挥作用的地方。如果某个结果只是公司的通用首页,应用可以在投入抽取成本前就将其丢弃。如果搜索发现了相关页面但阅读器无法获取,那么证据记录中应体现这一限制,而不是把搜索摘要当作完整替代品。
Google 搜索摘要(snippets) 会根据不同查询以不同方式组合生成。一个在发现阶段听起来很有结论性的描述,可能在最终回答所需的限定条件上有缺失。
需要从查询开始,一路保留到被选中的 URL,再到支撑答案的具体段落这一整条链路。数据来源溯源(Data provenance) 在这里非常有用,因为“选择来源”的决策与“收集证据”的行为是两件事。两者都记录下来,就能在不重复整个调研过程的前提下进行复核。
在证据边界比较成本
真正相关的成本,是产出“可接受证据包”所需的工作量。一次搜索调用只是其中一部分。
可以使用一张工作表,把“发现”“已选页面的获取”“内容处理”和“生成”分别作为行。标明每一项收费是按查询、按页面、按点数还是其他用量方式计费。然后记录有多少页面通过了筛选,又有多少真正贡献了有用证据。
不要假定拆分式工作流总是更便宜。如果几乎每个结果都需要完整内容,那么“搜索+阅读一体化”的服务可能更高效。如果大部分候选在阅读前就能被淘汰,那么“有选择地收集内容”可能更合算。Scrapeless 的定价 应当在这种“消费模式假设”下评估,而不是只看搜索量。
上下文预算同样值得关注。关于长上下文中证据位置的研究 解释了为何“单纯多加文本”并不是获得更好答案的可靠途径。相较于不加区分地拼接文档,更应优先选择“带有清晰来源标识的相关段落”。
对于要替换 Google 特定发现工具的团队,Serper 替代方案对比 提供了更窄范围、以组件为单位的对照。若要从更高层次比较检索类别,Web 搜索 API 对比 则有助于区分“Google 观测数据”“来源发现”和“面向文档的处理”。
结论
在这些 Tavily 替代方案中,Scrapeless 是针对“以搜索为先的工作流”时的首要推荐,尤其适用于既需要 Google 发现能力,又要由应用自行选择证据来源的场景。当语义发现、索引独立性、研究产出或抽取能力是首要需求时,Exa、Brave、Linkup 和 Firecrawl 仍然具有重要价值。
选定一个具有代表性的任务,并明确定义它必须产出的证据类型。最好的替代方案,是能够在不把关键阶段隐藏在“漂亮的搜索结果表现”背后,又能提升该任务的“来源质量”“运行匹配度”或“成本表现”的那一个。
准备好构建以搜索为先的 AI 工作流了吗?
在 Discord 和 Telegram 上与开发者讨论“来源选择与收集”。访问 app.scrapeless.com,将 Google 发现与“应用选择阅读的页面”分开进行评估。
常见问题(FAQ)
问:对于以搜索为先的 AI 工作流,最好的 Tavily 替代方案是什么?
当应用需要先获取 Google 搜索记录,再从中选择页面做检索时,Scrapeless 是推荐的起点。Exa、Brave、Linkup 和 Firecrawl 关注的是不同侧重点,应在相同的“最终证据需求”标准下进行对比。
问:Scrapeless 能取代 Tavily 的所有功能吗?
仅靠 Google Search API 并不能替代所有搜索、抽取或答案生成工作流。它只替代了应用设计中的 Google 发现组件;页面阅读和生成需要各自受支持的组件。
问:Tavily 是否总是会生成答案?
不会。Tavily 提供可配置的答案与内容选项。应评估你的应用实际使用的选项,而不是假设每次 Tavily 调用都会执行综合生成。
问:以搜索为先的工作流会比“搜索加抽取”更便宜吗?
搜索优先的工作流在丢弃大量候选结果时可以减少后续阅读成本,但总成本取决于计费方式和筛选比例。应在相同任务与接受规则下比较完整的证据生成流程。
问:搜索摘要可以直接作为最终引用吗?
摘要可以用来定位一个有潜力的来源,但实质性论断应对照相关原文进行核查。应将来源 URL 与支持性段落绑定在一起,便于在最终引用时进行审阅。
在Scrapeless,我们仅访问公开可用的数据,并严格遵循适用的法律、法规和网站隐私政策。本博客中的内容仅供演示之用,不涉及任何非法或侵权活动。我们对使用本博客或第三方链接中的信息不做任何保证,并免除所有责任。在进行任何抓取活动之前,请咨询您的法律顾问,并审查目标网站的服务条款或获取必要的许可。





