
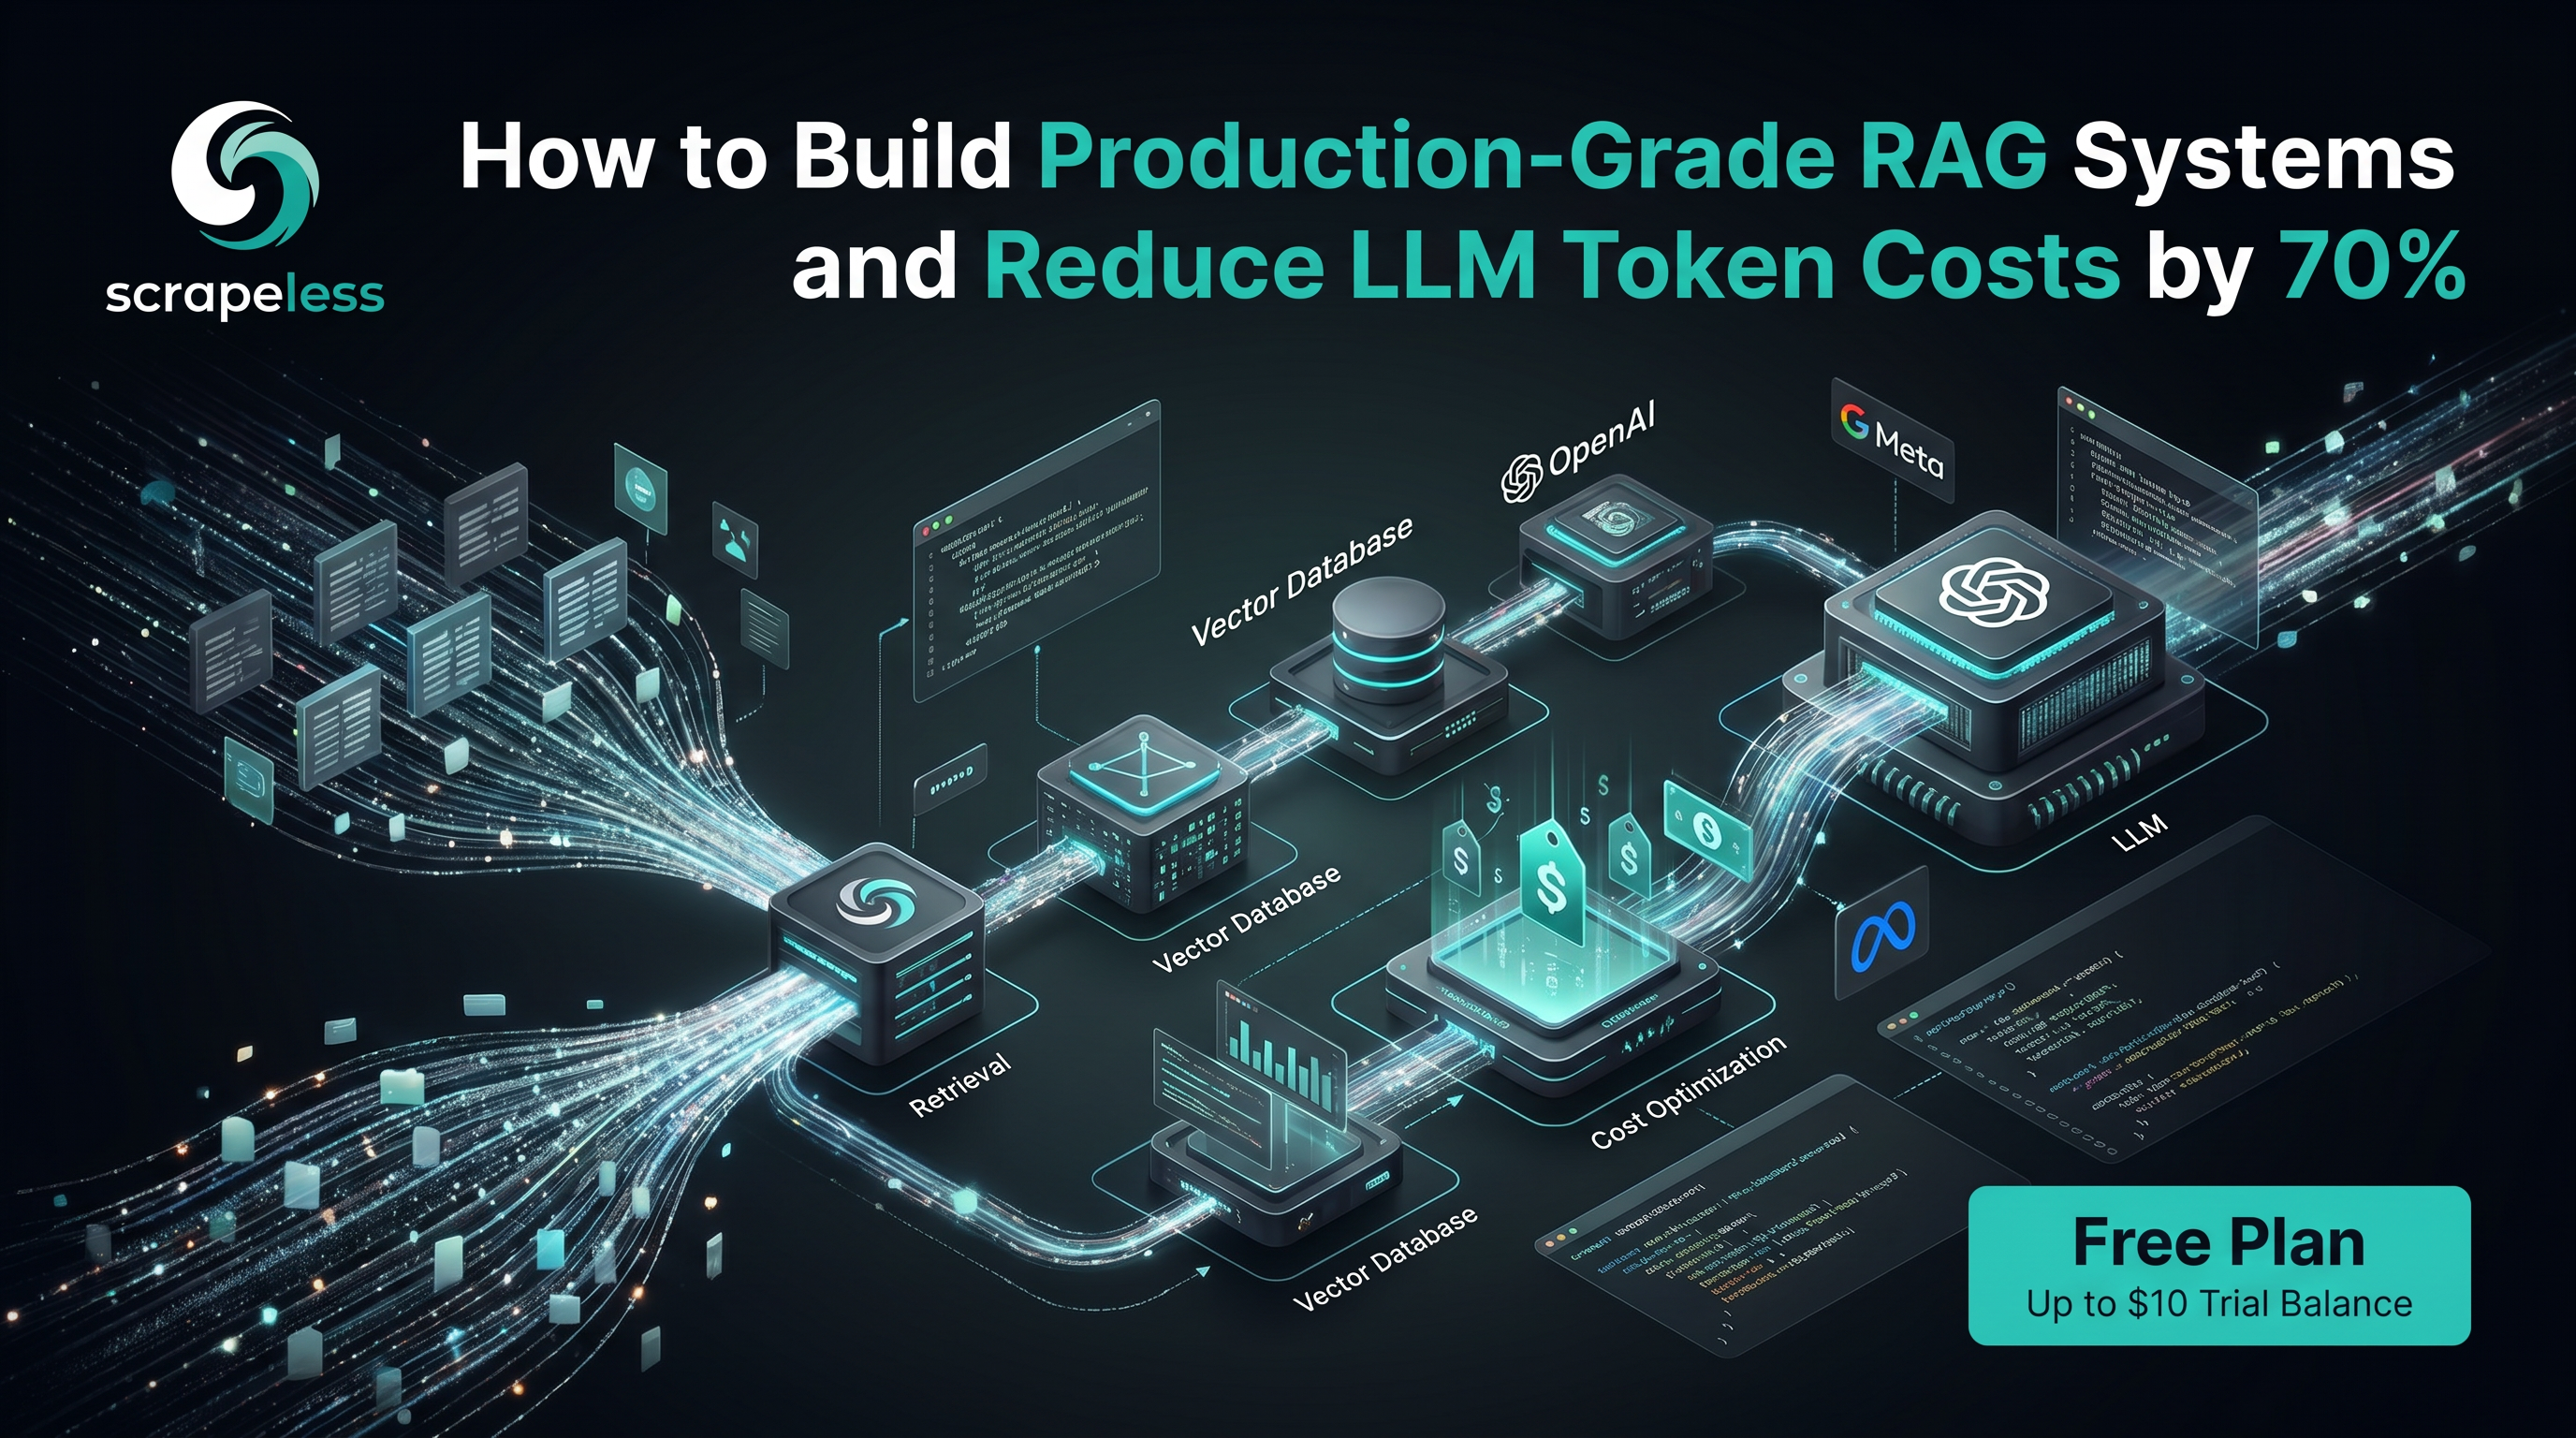
उत्पादन-ग्रेड RAG सिस्टम कैसे बनाएं और LLM टोकन की लागत को 70% तक कम करें
Advanced Bot Mitigation Engineer
मुख्य निष्कर्ष:
- स्वच्छ मार्कडाउन वह प्रारूप है जिसकी एलएलएम सच में तलाश कर रहे हैं। कच्चा एचटीएमएल मुख्यतः नैविगेशन, स्क्रिप्ट्स, विज्ञापन स्लॉट, और इनलाइन स्टाइलिंग है - शोर जो संदर्भ विंडो को बर्बाद करता है और पुनःप्राप्ति की गुणवत्ता को कम करता है। स्क्रैपलेस
scrape_markdownएक पृष्ठ के पठनीय शरीर को स्वच्छ मार्कडाउन के रूप में लौटाता है, इसलिए आपका एम्बेडिंग मॉडल तक पहुंचने वाला पाठ वही है जिस पर पृष्ठ आधारित है। - पाइपलाइन में चार चरण होते हैं: पता लगाना → निकालना → भाग करना → एम्बेड करना। महत्वपूर्ण यूआरएल ढूंढें, क्लाउड ब्राउज़र के साथ हर एक को स्वच्छ मार्कडाउन में रेंडर करें, मार्कडाउन को आपके मॉडल के लिए आकार में ओवरलैपिंग भागों में विभाजित करें, फिर एम्बेड करें और पुनःप्राप्ति-युक्त उत्पादन के लिए एक वेक्टर डेटाबेस में स्थायी करें।
- जावास्क्रिप्ट-भारी पृष्ठ और एंटी-बॉट बाधाओं को प्लेटफ़ॉर्म पर संभाला जाता है। कई उच्च-मूल्य स्रोत अपने सामग्री को क्लाइंट-साइड रेंडरिंग के माध्यम से हाइड्रेट करते हैं या बॉट चुनौतियों के पीछे रहते हैं। स्क्रैपलेस स्क्रैपिंग ब्राउज़र एक असली एंटी-डिटेक्शन क्लाउड ब्राउज़र में पृष्ठ को रेंडर करता है जिसमें आवासीय निकासी है, इसलिए आपको जो मार्कडाउन वापस मिलता है वह पूरी तरह से हाइड्रेटेड पृष्ठ है, खाली खोल नहीं।
- दो सतहें, एक प्राचल। जब एक एआई एजेंट पाइपलाइन को चलाता है तो स्क्रैपलेस एमसीपी सर्वर से
scrape_markdownको कॉल करें, या जब एक स्क्रिप्ट लूप का स्वामित्व करती है तो पाइथन एसडीके के साथ एक क्लाउड-ब्राउज़र सत्र बनाएं। दोनों एक ही एंटी-डिटेक्शन क्लाउड ब्राउज़र के सामने हैं। - स्टेटलेस एमसीपी उपकरण अपने पेलोड को
Response:\n\nसे पूर्ववर्ती करते हैं। जब आप एमसीपी सर्वर के माध्यम सेscrape_markdownआउटपुट पढ़ते हैं, तो विभाजन से पहले उस पूर्ववर्ती को हटा दें - एक-लाइन फिक्स जो आपके कॉर्पस से एक अजीब शीर्षक को बाहर रखता है। - एंटी-डिटेक्शन क्लाउड ब्राउज़र, 195+ देशों में आवासीय प्रॉक्सियां। स्क्रैपलेस स्क्रैपिंग ब्राउज़र जावास्क्रिप्ट रेंडरिंग, आवासीय-प्रॉक्सी निकासी, और प्रत्येक सत्र में फिंगरप्रिंट यादृच्छिकता (यूए, टाइमज़ोन, वेबजीएल, कैनवास) को संभालता है, इसलिए कॉर्पस-निर्माण स्क्रिप्ट पाठ गुणवत्ता पर ध्यान केंद्रित करती है न कि बचाव की पाइपलाइन पर।
- शुरू करने के लिए मुक्त। नए स्क्रैपलेस अकाउंट में मुफ्त स्क्रैपिंग ब्राउज़र रनटाइम शामिल है - Scrapeless पर साइन अप करें।
परिचय: अपने मॉडल को पाठ खिलाएं, पृष्ठ क्रोम नहीं
एक भाषा मॉडल केवल उतना ही अच्छा होता है जितना कि वह पढ़े गए पाठ में होता है। चाहे आप एक फाइन-ट्यूनिंग कॉर्पस बना रहे हों, अपने दस्तावेज़ पर एक पुनःप्राप्ति-युक्त उत्पादन (आरएजी) ज्ञान आधार का निर्माण कर रहे हों, या एक एजेंट को लाइव बाजार डेटा में ग्राउंड कर रहे हों, इनपुट चरण नीचे की सभी चीज़ों पर छत तय करता है। कचरा भीतर नहीं केवल कचरा बाहर है - यह बर्बाद टोकन, प्रदूषित एम्बेडिंग, और एक कुकी बैनर को ऊपर लाता है बजाय एक उत्तर के।
समस्या यह है कि आधुनिक वेब ब्राउज़रों और मनुष्यों के लिए बनाया गया है, एम्बेडिंग मॉडलों के लिए नहीं। एक सामान्य लेख पृष्ठ कुछ हजार शब्दों की वास्तविक सामग्री है जो हजारों नैविगेशन मेनू, शेयर बटन, संबंधित पोस्ट ग्रिड, टिप्पणी विजेट, कुकी नोटिस, ट्रैकिंग स्क्रिप्ट्स, और इनलाइन सीएसएस के अक्षरों में लिपटी होती है। उस कच्चे एचटीएमएल को एक एम्बेडर को खिलाएं और संकेत मार्कअप में डूब जाता है। शोर के ऊपर, पृष्ठों के बढ़ते हिस्से अपनी मुख्य सामग्री को जावास्क्रिप्ट के साथ प्रारंभिक लोड के बाद रेंडर करते हैं, इसलिए एक साधारण एचटीटीपी फेच एक खाली कंटेनर लौटाता है। अन्य एंटी-बॉट चुनौतियों के पीछे होते हैं जो स्वचालित संग्रह को पूरी तरह से अवरुद्ध करते हैं।
यह पोस्ट स्क्रैपलेस स्क्रैपिंग ब्राउज़र के ऊपर एक पायथन वर्कफ़्लो के माध्यम से चलती है जो गंदे सार्वजनिक वेब पृष्ठों को स्वच्छ, भागित, एम्बेडिंग-तैयार पाठ में बदल देती है। पाइपलाइन में चार चरण हैं - यूआरएल खोजें, स्वच्छ मार्कडाउन निकालें, आरएजी के लिए भाग करें, वेक्टर डेटाबेस में एम्बेड करें - और scrape_markdown निकासी चरण में भारी उठाई गई चीज़ें करता है जो किसी भी पृष्ठ के पठनीय शरीर को स्वच्छ मार्कडाउन के रूप में लौटाता है। समान प्राचल के लिए एजेंट-फ्रेमवर्क संस्करण के लिए लैंगचेन इंटीग्रेशन पोस्ट देखें।
आप क्या बना सकते हैं
स्वच्छ-टेक्स्ट निकालना एलएलएम और आरएजी सिस्टम के एक विस्तृत श्रृंखला के तहत आधार है:
- अपने दस्तावेज़ पर आरएजी। एक डॉक साइट या ज्ञान आधार को स्वच्छ मार्कडाउन में क्रॉल करें, इसे भाग करें, और इसे एम्बेड करें ताकि एक समर्थन एजेंट वर्तमान दस्तावेज़ से उत्तर दे सके बजाय एक पुरानी प्रशिक्षण कट-ऑफ से।
- फाइन-ट्यूनिंग और निरंतर-प्रीट्रेनिंग कॉर्पस। सार्वजनिक लेखों और संदर्भों से बड़े, डेडुप्लिकेटेड टेक्स्ट डेटासेट्स एकत्रित करें, जिससे संग्रह के समय में पहले से ही बायलेरप्लेट का निपटान किया गया हो।
- एजेंटों के लिए लाइव-वेब ग्राउंडिंग। एक एजेंट को क्वेरी समय पर जरूरत पड़ने वाले पृष्ठों को रेंडर करें और उसे स्वच्छ मार्कडाउन सौंपें, ताकि उत्तर वर्तमान में ऐसा पढ़े जाने वाले पृष्ठ का हवाला दे।
- प्रतिस्पर्धात्मक और बाजार खुफिया। सार्वजनिक उत्पाद पृष्ठों, ब्लॉग पोस्टों, और रिलीज़ नोट्स को एक खोजने योग्य वेक्टर अनु indeks में बदलें जिसे एक विश्लेषक या एलएलएम पूछ सकता है।
- समाचार और शोध की निगरानी। प्रकाशक और पत्रिका के पृष्ठों को एक कार्यक्रम पर ग्रहण करें, मार्कडाउन में सामान्य करें, और एक चलती स्रोतों की शारीरिकता में अर्थात्मक खोज के लिए एम्बेड करें।
- आंतरिक अर्थात्मक खोज। सार्वजनिक संदर्भ सामग्री के ऊपर एक निजी पुनःप्राप्ति परत बनाएं जिस पर आपकी टीम निर्भर करती है, जो एक कार्यक्रम पर ताजा रहती है।
क्यों स्क्रैपलेस स्क्रैपिंग ब्राउज़र
स्क्रेपलेस स्क्रेपिंग ब्राउज़र एक अनुकूलन योग्य, एंटी-डिटेक्शन क्लाउड ब्राउज़र है जिसे वेब क्रॉलर्स और एआई एजेंटों के लिए डिज़ाइन किया गया है। विशेष रूप से LLM और RAG टेक्स्ट पाईपलाइनों के लिए, यह लाता है:
- स्वच्छ मार्कडाउन निष्कर्षण।
scrape_markdownएक यूआरएल को रेंडर करता है और पढ़ने योग्य शरीर को मार्कडाउन के रूप में लौटाता है - शीर्षक, अनुच्छेद, सूचियाँ, तालिकाएँ और लिंक संरक्षित होते हैं; नेविगेशन, स्क्रिप्ट, विज्ञापन स्लॉट, और इनलाइन स्टाइलिंग हटा दिया जाता है। यही वह प्रारूप है जिसे एक एम्बेडिंग मॉडल सबसे अच्छे तरीके से पढ़ता है। - क्लाउड-साइड जावास्क्रिप्ट रेंडरिंग। पूरा क्रोमियम पृष्ठ को निष्कर्षण से पूर्व हाइड्रेट करता है, इसलिए एकल-पृष्ठ ऐप्स, लेज़ी-लोडेड सेक्शन, और प्रारंभिक अनुरोध के बाद इंजेक्ट की गई सामग्री को पकड़ा जाता है और चूक नहीं जाता।
- 195 से अधिक देशों में आवासीय प्रॉक्सी। भू-आश्रित पृष्ठ वही सामग्री लौटाते हैं जो एक स्थानीय पाठक देखेगा, और हर सत्र पर रोटेशन स्वचालित होता है - असली लेख और क्षेत्रीय ब्लॉक पृष्ठ के बीच का अंतर।
- हर सत्र पर एंटी-डिटेक्शन फिंगरप्रिंटिंग - UA, टाइमज़ोन, भाषा, स्क्रीन रिज़ॉल्यूशन, वेबजीएल, और कैनवास हर सत्र के लिए यादृच्छिक होते हैं, ताकि उच्च-मूल्य वाले स्रोत बिना प्रति-निवेदन फिंगरप्रिंट ट्यूनिंग के उपलब्ध रहें।
- एक मूलभूत, दो सतहें। वही क्लाउड ब्राउज़र एजेंट-चालित पाइपलाइनों के लिए एक MCP टूल के रूप में पहुंच योग्य है और स्क्रिप्ट-चालित पाइपलाइनों के लिए एक पायथन SDK सत्र के रूप में, इसलिए वही निष्कर्षण चरण किसी भी आर्किटेक्चर में समायोजित किया जा सकता है।
फ्री प्लान पर अपना API कुंजी प्राप्त करें स्क्रेपलेस पर।
पूर्वापेक्षाएँ
- पायथन 3.10 या नया।
- एक स्क्रेपलेस खाता और API कुंजी - app.scrapeless.com पर साइन अप करें और सेटिंग्स → API कुंजी प्रबंधन से कुंजी कॉपी करें।
- एक एम्बेडिंग-मॉडल API कुंजी यदि आप एम्बेड करने की योजना बना रहे हैं (नीचे दिए गए उदाहरण OpenAI का उपयोग करते हैं; किसी भी एम्बेडिंग प्रोवाइडर का उपयोग एक पंक्ति को स्वैप करके किया जा सकता है)।
pipऔरvenvके साथ बुनियादी परिचय।
पूर्ण SDK और टूल संदर्भ docs.scrapeless.com पर मौजूद हैं।
इंस्टॉल करें
एक ही क्लाउड ब्राउज़र तक पहुँचने के दो तरीके हैं। उस विकल्प को चुनें जो पाइपलाइन को चलाने वाले के अनुसार मेल खाता है - एक एजेंट या एक स्क्रिप्ट।
विकल्प A - पायथन SDK (स्क्रिप्ट-चालित)
एक स्क्रिप्ट के लिए जो डिस्कवर → एक्सट्रैक्ट → चंक → एम्बेड लूप का मालिक है, स्क्रेपलेस पायथन SDK के साथ-साथ एम्बेडिंग और वेक्टर-स्टोर पुस्तकालयों को स्थापित करें जिनका आप उपयोग करने की योजना बना रहे हैं:
bash
python -m venv .venv
source .venv/bin/activate          # विंडोज़: .venv\Scripts\activate
pip install scrapeless openai chromadb tiktoken
वर्तमान शेल के लिए अपनी API कुंजी निर्यात करें। SDK स्वचालित रूप से वातावरण से SCRAPELESS_API_KEY पढ़ता है:
bash
export SCRAPELESS_API_KEY="your_api_token_here"
export OPENAI_API_KEY="your_openai_token_here"
विकल्प B - MCP सर्वर (एजेंट-चालित)
एक एआई एजेंट के लिए जो टूल्स को कॉल करता है, स्क्रेपलेस MCP सर्वर चलाएँ। यह scrape_markdown, scrape_html, google_search, और किसी भी MCP-समर्थित क्लाइंट के लिए एक सेट ब्राउज़र टूल्स को उजागर करता है:
bash
npx -y scrapeless-mcp-serverअपने MCP क्लाइंट को कमांड पर इंगित करें और सर्वर कॉन्फ़िगरेशन में SCRAPELESS_KEY वातावरण चर के रूप में API कुंजी पास करें। एजेंट फिर सीधे scrape_markdown को कॉल कर सकता है।
पाइपलाइन एक नज़र में
यूआरएल खोजें            साफ़ पाठ निकालें         आरएजी के लिए चंक करें            एम्बेड + स्टोर
┌──────────────┐         ┌──────────────────┐       ┌──────────────┐        ┌──────────────┐
│ google_search│         │ scrape_markdown   │       │ ~500–1000-टोक │        │ प्रत्येक चंक एम्बेड करें, अपडेट करें │
│ या साइटमैप   │  ────►   │ (क्लाउड ब्राउज़र    │ ────► │ ओवरलैपिंग   │        │ वेक्टर DB में │
│ या बीज सूची │         │  रेंडर करता है + साफ़ करता है)│       │ चंक्स        │        └──────────────┘
└──────────────┘         └──────────────────┘       └──────────────┘
चार चरण, साफ़ विभाजन। खोज यह तय करती है कि कौन पृष्ठ कॉर्पस में प्रवेश करता है; निष्कर्षण यह तय करता है कि पाठ कितना साफ़ है; चंकिंग यह तय करता है कि यह कितना पुनःप्राप्त करने योग्य है; एम्बेडिंग इसे खोजने योग्य बनाता है। स्क्रेपलेस पहले दो चरणों का स्वामित्व करता है - वे जहां जीवित वेब प्रतिक्रिया करता है - और मानक पुस्तकालय अंतिम दो का स्वामित्व करते हैं।
कदम 1 - यूआरएल खोजें
एक कॉर्पस यूआरएल की सूची के साथ शुरू होता है। तीन सामान्य स्रोत लगभग हर मामले को कवर करते हैं:
- एक बीज सूची या साइटमैप जो आपके पास पहले से है - सबसे सरल मामला; सीधे चरण 2 पर जाएँ।
- एक साइट क्रॉल - एक अनुभाग मूल से शुरू करें और सीमित गहराई तक डोमेन लिंक का पालन करें।
- खोज खोज - जब प्रासंगिक पृष्ठों की पहले से जानकारी नहीं होती है, तो उनके लिए खोजें।
स्क्रेपलेस MCP सर्वर एक google_search टूल प्रदान करता है जो व्यवस्थित पंक्तियों के रूप में जैविक परिणाम लौटाता है, जो एक विषय के लिए स्रोत यूआरएल खोजने का एक साफ़ तरीका है। प्रत्येक पंक्ति में स्थिति, शीर्षक, लिंक, स्निपेट, और स्रोत होता है:
python
# discover.py — एक खोज प्रश्न से प्रत्याशी यूआरएल इकट्ठा करें
# (MCP टूल तर्क कैमेलकेस हैं; यह लौटाए गए आकार को दर्शाता है)
results = [
{"स्थिति": 1, "शीर्षक": "रीट्रीवल-ऑगमेंटेड जनरेशन, समझाया गया",
"लिंक": "https://example.com/guides/rag-explained", "स्रोत": "example.com"},
{"स्थिति": 2, "शीर्षक": "आरएजी के लिए चंकिंग रणनीतियाँ",
"लिंक": "https://example.com/blog/chunking-strategies", "स्रोत": "example.com"},
# ...
]
urls = [row["लिंक"] for row in results]
खोज चरण को ईमानदार रखें: URLs को डुप्लिकेट करें, अप्रासंगिक डोमेन को छोड़ें, और किसी भी प्रति-पृष्ठ रेंडर बजट खर्च करने से पहले गणना को सीमित करें। एक फोकस किया हुआ 200-URL कॉर्पस बेहतर रिट्रीवल करता है बनिस्पत एक शोर वाले 2,000-URL कॉर्पस के।

---

## चरण 2 — `scrape_markdown` के साथ साफ़ Markdown निकालें

यह वह चरण है जो कॉर्पस की गुणवत्ता निर्धारित करता है। `scrape_markdown` URL को एंटी-डिटेक्शन क्लाउड ब्राउज़र में रेंडर करता है — जावास्क्रिप्ट चलता है, पृष्ठ हाइड्रेट होता है, आवासीय निकासी सामग्री को पहुंच योग्य रखती है — और पढ़ने योग्य सामग्री को साफ़ Markdown के रूप में लौटाता है। शीर्षक शीर्षक ही रहते हैं, सूचियाँ सूचियों की ही रहती हैं, तालिकाएँ तालिकाओं की रहती हैं, और जो कुछ भी सामग्री नहीं है वह हटा दिया जाता है।

### एजेंट-संचालित (MCP)

जब एक एजेंट टूल को कॉल करता है, तो उसे Markdown टूल के परिणाम के रूप में मिलता है। एक विवरण जो कॉर्पस की स्वच्छता के लिए महत्वपूर्ण है: **स्टेटलेस MCP टूल अपने पाठ पेलोड को `Response:\n\n` से पूर्ववत करते हैं।** इससे पहले कि पाठ आपके कॉर्पस में प्रवेश करे उस हेडर को हटा दें, वरना यह आपके पहले चंके के शीर्ष पर आ जाएगा:

```python
# clean_mcp_payload.py — चंकिंग से पहले एक MCP टूल परिणाम को सामान्य करें
PREFIX = "Response:\n\n"

def clean_markdown(tool_result: str) -> str:
    """एक MCP scrape_markdown परिणाम से स्टेटलेस-टूल 'Response:' उपसर्ग को हटाएं।"""
    if tool_result.startswith(PREFIX):
        tool_result = tool_result[len(PREFIX):]
    return tool_result.strip()
स्क्रिप्ट-संचालित (Python SDK)
जब एक स्क्रिप्ट लूप की मालिक होती है, तो SDK के साथ एक क्लाउड-ब्राउज़र सत्र बनाएं और प्रत्येक URL को रेंडर करें। SDK वातावरण से SCRAPELESS_API_KEY पढ़ता है; proxy_country आवासीय निकासी को पिन करता है (SDK पर स्नेक_case):
python
# extract.py — प्रत्येक खोजे गए URL को साफ Markdown में रेंडर करें
from scrapeless import Scrapeless
from scrapeless.types import ICreateBrowser

client = Scrapeless()  # SCRAPELESS_API_KEY पढ़ता है
session = client.browser.create(
    ICreateBrowser(proxy_country="US", session_ttl=240)
)

def fetch_markdown(url: str) -> str:
    """क्लाउड ब्राउज़र में एक URL को रेंडर करें और साफ Markdown शरीर पाठ लौटाएं।"""
    # सत्र एक CDP एंडपॉइंट को session.browser_ws_endpoint पर उजागर करता है;
    # इसे `url` पर जाने के लिए चलाएं, पृष्ठ को हाइड्रेट होने दें, फिर पढ़ें
    # कॉर्पस के लिए सफाई की गई Markdown सामग्री।
    # `render_to_markdown` आपका अपना सहायक है: CDP एंडपॉइंट को नेविगेट करने के लिए चलाएं,
    # हाइड्रेशन की प्रतीक्षा करें, फिर सफाई की गई HTML को Markdown में बदलें। एक टर्नकी
    # परिणाम के लिए जिसे लिखने के लिए कोई सहायक नहीं चाहिए, उपरोक्त MCP `scrape_markdown` टूल का उपयोग करें,
    # जो सीधे Markdown लौटाता है।
    markdown = render_to_markdown(session, url)
    return markdown.strip()

documents = []
for url in urls:
    text = fetch_markdown(url)
    if len(text) > 200:                # लगभग-खाली / ब्लॉक पृष्ठों को छोड़ें
        documents.append({"url": url, "text": text})
अंत में एक छोटी लंबाई गार्ड रखना अपने लिए काबिल है: एक पृष्ठ जो केवल कुछ दर्जन Markdown अक्षरों को लौटाता है, आमतौर पर एक सहमति दीवार या एक खाली कंटेनर होता है, न कि एक लेख, और इसे कॉर्पस को प्रदूषित नहीं करना चाहिए।
अपना API कुंजी मुफ्त योजना पर प्राप्त करें: Scrapeless
Markdown या HTML?
scrape_markdown और scrape_html एक ही रेंडर का सामना करते हैं। अंतर यह है कि क्या वापस आता है और आप इसके साथ क्या करते हैं:
scrape_markdown |
scrape_html |
|
|---|---|---|
| आउटपुट | साफ पढ़ने योग्य Markdown | पूर्ण रेंडर किया हुआ HTML |
| बायलरप्लेट | नेविगेशन, स्क्रिप्ट, विज्ञापन हटाए गए | उपस्थित — आप इसे स्वयं हटा दें |
| सबसे अच्छा किस लिए | LLM प्रशिक्षण और RAG इनपुट | कस्टम CSS-चयन निष्कर्षण |
| डाउनस्ट्रीम टोकन लागत | कम — केवल सामग्री | उच्च — मार्कअप शामिल |
| संरचना सुरक्षित | शीर्षक, सूचियाँ, तालिकाएँ, लिंक | पूर्ण DOM |
LLM या RAG कॉर्पस के लिए, Markdown डिफ़ॉल्ट है। यह एम्बेडिंग मॉडल को सामग्री और कुछ नहीं प्रदान करता है, यह DOM रोटेशन को CSS चयनकर्ताओं से बेहतर सहन करता है, और यह हर डाउनस्ट्रीम चरण में काफी कम टोकन की लागत करता है। जब आपको किसी विशिष्ट लेआउट के खिलाफ अपने चयनकर्ताओं को चलाने की आवश्यकता होती है, तब ही scrape_html का उपयोग करें।
चरण 3 — RAG के लिए चंकिंग
एक एम्बेडिंग मॉडल का एक सीमित इनपुट आकार होता है, और रिट्रीवल तब सबसे अच्छा काम करता है जब प्रत्येक संग्रहीत इकाई एक समान अनुभाग हो न कि पूरा दस्तावेज़। चंकिंग साफ Markdown को ओवरलैपिंग विंडोज में विभाजित करता है। एक व्यावहारिक डिफ़ॉल्ट है 500–1000 टोकन प्रति चंक के साथ 10–15% ओवरलैप — काफी बड़ा जो एक पूर्ण विचार रखता है, छोटा जो रिट्रीवल को सटीक रखता है, ओवरलैप के साथ ताकि एक वाक्य सीमा के पार विभाजित होने पर भी कम से कम एक चंक में पूरा दिखाई दे।
python
# chunk.py — साफ Markdown को ओवरलैपिंग, टोकन-आकार के चंक्स में विभाजित करें
import tiktoken

enc = tiktoken.get_encoding("cl100k_base")
Here is the translated text in Hindi:
python
def chunk_text(text: str, max_tokens: int = 800, overlap: int = 100):
    """साफ की गई मार्कडाउन पर ओवरलैपिंग टोकन विंडो उत्पन्न करें।"""
    tokens = enc.encode(text)
    step = max_tokens - overlap
    for start in range(0, len(tokens), step):
        window = tokens[start:start + max_tokens]
        if not window:
            break
        yield enc.decode(window)

chunks = []
for doc in documents:
    for i, piece in enumerate(chunk_text(doc["text"])):
        chunks.append({
            "id": f"{doc['url']}#chunk-{i}",
            "url": doc["url"],
            "chunk_index": i,
            "text": piece,
        })
चूंकि इनपुट पहले से ही साफ मार्कडाउन है, इसलिए चंक करने वाले को कभी भी कुकी बैनर या <script> ब्लॉक से एक पैराग्राफ को दो में विभाजित करने के लिए नहीं लड़ना पड़ता है। टोकन विंडो बनाने से पहले मार्कडाउन शीर्षक पर विभाजित करना संबंधित सामग्री को एक साथ रखना और भी बेहतर करता है - एक सेक्शन के भीतर चंक करें, न कि दो के बीच - जब स्रोत दस्तावेज़ों में स्पष्ट शीर्षक संरचना हो।
एकल चंक रिकॉर्ड इस प्रकार दिखता है:
json
{
  "id": "https://example.com/guides/rag-explained#chunk-0",
  "url": "https://example.com/guides/rag-explained",
  "chunk_index": 0,
  "token_count": 800,
  "text": "## पुनर्प्राप्ति-वर्धित पीढ़ी\n\nRAG एक भाषा मॉडल को एक बाहरी कॉर्पस में आधार देता है, सबसे प्रासंगिक अंशों को क्वेरी समय पर पुनर्प्राप्त करके और उन्हें संदर्भ के रूप में मॉडल को पास करके। पुनर्प्राप्ति की गुणवत्ता सीधे इस बात पर निर्भर करती है कि स्रोत पाठ को कितना साफ निकाला और चंक किया गया था ..."
}
चरण 4 - एक वेक्टर डेटाबेस में एम्बेड और संग्रहीत करें
अंतिम चरण प्रत्येक चंक को एक वेक्टर में बदलता है और इसे पुनर्प्राप्ति के लिए संग्रहीत करता है। नीचे दिया गया उदाहरण एक स्थानीय क्रोमा स्टोर और ओपनएआई एम्बेडिंग का उपयोग करता है; आकार pgvector, पाइनकॉन, या किसी अन्य वेक्टर DB के लिए समान है - क्लाइंट को स्वैप करें और रिकॉर्ड को समान रखें:
python
# embed.py — प्रत्येक चंक को एम्बेड करें और वेक्टर स्टोर में अपसर्ट करें
import chromadb
from openai import OpenAI

oai = OpenAI()
db = chromadb.PersistentClient(path=".chroma")
collection = db.get_or_create_collection("web_corpus")

def embed(texts: list[str]) -> list[list[float]]:
    resp = oai.embeddings.create(model="text-embedding-3-small", input=texts)
    return [d.embedding for d in resp.data]

batch = chunks[:64]                                   # बैच में एम्बेड करें
collection.upsert(
    ids=[c["id"] for c in batch],
    documents=[c["text"] for c in batch],
    embeddings=embed([c["text"] for c in batch]),
    metadatas=[{"url": c["url"], "chunk_index": c["chunk_index"]} for c in batch],
)
url और chunk_index मेटाडेटा प्रत्येक वेक्टर के साथ यात्रा करते हैं, इसलिए जब पुनर्प्राप्ति एक चंक को सतह पर लाती है, तो आप स्रोत पृष्ठ का उल्लेख कर सकते हैं और पूर्ण संदर्भ के लिए पड़ोसी चंक्स को फिर से इकट्ठा कर सकते हैं। वह मेटाडेटा भी वही है जो आपको id द्वारा अपसर्ट करने की अनुमति देता है - एक पृष्ठ को ताज़ा करना इसकी चंक्स को स्थान पर बदल देता है, उन्हें डुप्लिकेट करने के बजाय।
आपको क्या मिलता है
वेक्टर स्टोर में उतरने वाला कॉर्पस साफ, एम्बेडेड, स्रोत-लिंक किए गए चंकों की एक सूची है। प्राप्त रिकॉर्ड इस प्रकार दिखता है:
json
{
  "id": "https://example.com/blog/chunking-strategies#chunk-2",
  "document": "### ओवरलैप\n\nआसन्न चंकों के बीच 10-15% ओवरलैप एक सीमा पर आने वाले वाक्य को कम से कम एक विंडो में समग्र रूप से बनाए रखता है, जो दो विचारों के बीच सीम को लक्षित करने वाले प्रश्नों पर पुनः स्मृति को बढ़ाता है ...",
  "metadata": {
    "url": "https://example.com/blog/chunking-strategies",
    "chunk_index": 2
  },
  "distance": 0.18
}
// schema बिल्कुल वही है जो चरण 4 अपसर्ट को जारी करता है। फ़ील्ड मान विचारार्थ नमूने हैं।
जब यह लाइव वेब के खिलाफ चलाया जाता है, तो कुछ ईमानदार अवलोकन जो आपको उम्मीद करनी चाहिए:
- मार्कडाउन गुणवत्ता पृष्ठ संरचना को ट्रैक करती है। साफ सेमांटिक एचटीएमएल वाले पृष्ठ उत्कृष्ट मार्कडाउन में परिवर्तित होते हैं; सामान्य
<div>सूप से बने पृष्ठ स्वीकार्य रूप से परिवर्तित होते हैं लेकिन एक साइडबार कैप्शन को शरीर में मिला सकते हैं। बड़े कॉर्पस पर भरोसा करने से पहले परिवर्तित पृष्ठों का एक नमूना स्पॉट-चेक करें। - हाइड्रेशन समय साइट द्वारा भिन्न होता है। अधिकांश पृष्ठ मार्कडाउन पढ़े जाने से पहले पूरी तरह से प्रदर्शित होते हैं, लेकिन कुछ अपने मुख्य सामग्री को एक देरी वाले अनुरोध के माध्यम से हाइड्रेट करते हैं; उनके लिए, पढ़ने से पहले पृष्ठ को थोड़ी देर ठहरने दें।
- दो स्तरों पर डुप्लिकेट करें। खोज में डुप्लिकेट यूआरएल गिराएं और एम्बेडिंग से पहले लगभग डुप्लिकेट चंकों (एक हैश या समानता सीमा) को गिराएं - सिंडिकेटेड लेख और बायलरप्लेट फुटर्स अन्यथा कॉर्पस को बढ़ा देते हैं और पुनर्प्राप्ति में पूर्वाग्रही होते हैं।
- भौगोलिक-भिन्न सामग्री के लिए निकास क्षेत्र को पिन करें। ऐसे साइटें जो सामग्री को स्थानीयकृत करती हैं, क्षेत्र के अनुसार भिन्न पाठ लौटाती हैं; उस क्षेत्र के लिए
proxy_countryसेट करें जिसकी संस्करण को आप कॉर्पस में चाहते हैं ताकि डेटासेट स्थायी रहे। - लंबाई गार्ड रखें। एक पृष्ठ जो केवल कुछ दर्जन अक्षरों को लौटाता है वह आमतौर पर सहमति दीवार या खाली कंटेनर है, न कि सामग्री - इसे चंकिंग से पहले बाहर फिल्टर करें।
निष्कर्ष: एक साफ-पाठ पाइपलाइन बनाएं जो स्केल करे
The Discover → Extract → Chunk → Embed आकार लगभग साठ लाइनों के पायथन में संकुचित होता है। लोड-बेयरिंग चरण निकालना है, और scrape_markdown इसे वहन करता है: एंटी-डिटेक्शन क्लाउड ब्राउज़र पृष्ठ को प्रदर्शित करता है, आवासीय अभिगम इसे सुलभ रखता है, और जो वापस आता है वह पठनीय शरीर होता है जो साफ Markdown के रूप में होता है - वह प्रारूप जिसे एम्बेडिंग मॉडल सबसे अच्छा पढ़ता है। चंकिंग और एम्बेडिंग तब पहले से ही साफ पाठ पर मानक पुस्तकालय का काम है।
एक ही Scrapeless Scraping Browser प्राइमिटिव को एक एजेंट फ्रेमवर्क के साथ टाइप किया गया आउटपुट और एक वेक्टर स्टोर के साथ जोड़ा गया है, इसके लिए LangChain एकीकरण पोस्ट देखें। खोज, रेंडर, और निकासी को कार्यशील प्रणाली में संकलित करने के लिए और अधिक एंड-टू-एंड पैटर्न के लिए, AI एजेंट उपयोग के मामलों का पोस्ट देखें। सभी में जो पैटर्न विद्यमान है: एक क्षेत्र को पिन करें, HTML नहीं बल्कि Markdown लौटाएं, ओवरलैप के साथ चंक करें, और एम्बेड करने से पहले डुप्लिकेट करें।
क्या आप अपने AI-शक्ति वाले डेटा पाइपलाइन का निर्माण करने के लिए तैयार हैं?
हमारे समुदाय में शामिल हों, एक मुफ्त योजना का दावा करें और डेवलपर्स से जुड़ें जो Scrapeless पर LLM और RAG डेटा पाइपलाइनों का निर्माण कर रहे हैं: Discord · Telegram.
Scrapeless पर मुफ्त Scraping Browser रनटाइम के लिए साइन अप करें और ऊपर दिए गए पैटर्नों को उन स्रोतों, क्षेत्रों और चंक आकारों के लिए अनुकूलित करें जिनकी आपकी पाइपलाइन को आवश्यकता है। योजनाएँ और सीमाएँ scrapeless.com/en/pricing पर हैं।
सामान्य प्रश्न
प्रश्न: क्या LLM या RAG कॉर्पस के लिए वेबसाइट पाठ को स्क्रैप करना कानूनी है?
सार्वजनिक रूप से दृश्य डेटा को स्क्रैप करना अधिकांश अधिकार क्षेत्र में व्यापक रूप से अनुमति है, लेकिन नियम देश और साइट की सेवा शर्तों द्वारा भिन्न होते हैं। लक्षित साइट के ToS की समीक्षा करें, जहाँ लागू हो robots.txt का सम्मान करें, बिना किसी वैध आधार के व्यक्तिगत डेटा संग्रह न करें, और वाणिज्यिक पैमाने के कॉर्पोरा के लिए सलाहकार से परामर्श करें। एक प्रशिक्षण या RAG डेटासेट का निर्माण केवल सार्वजनिक डेटा तक कानूनी रूप से पहुंचने के मौलिक दायित्व को नहीं बदलता।
प्रश्न: LLM इनपुट के लिए कच्चे HTML के बजाय Markdown क्यों?
कच्चा HTML मुख्य रूप से मार्कअप होता है - नेविगेशन, स्क्रिप्ट, विज्ञापन स्लॉट, इनलाइन शैलियाँ - जो सामग्री संकेत को कमजोर करता है, टोकन लागत कोinflate करता है, और एम्बेडिंग को प्रदूषित करता है। scrape_markdown से साफ Markdown शीर्षक, अनुच्छेद, सूचियाँ, तालिकाएँ, और लिंक को बनाए रखता है जिनके बारे में पृष्ठ वास्तव में है और शेष को गिरा देता है, इसलिए एम्बेडिंग मॉडल सामग्री को पढ़ता है और कुछ नहीं। Markdown DOM परिवर्तनों को CSS-चुनाव निकालने की तुलना में बेहतर ढंग से सहन भी करता है।
प्रश्न: मुझे RAG के लिए किस चंक आकार का उपयोग करना चाहिए?
एक व्यावहारिक डिफ़ॉल्ट 500-1000 टोकन प्रति चंक है जिसमें 10-15% ओवरलैप होता है। छोटे चंक खोज पुनर्प्राप्ति सटीकता को बढ़ाते हैं लेकिन एक विचार को विभाजित कर सकते हैं; बड़े चंक अधिक संदर्भ रखते हैं लेकिन प्रासंगिकता को कमजोर करते हैं। अपने एम्बेडिंग मॉडल के इनपुट आकार और आपके प्रश्नों के अनुसार ट्यून करें - छोटे तथ्यात्मक खोजों के लिए छोटे चंक और संश्लेषण प्रश्नों के लिए बड़े चंक अनुकूल होते हैं। टोकन विंडोिंग से पहले Markdown शीर्षकों पर विभाजित करना संबंधित सामग्री को एक साथ रखता है।
प्रश्न: क्या मुझे एक प्रॉक्सी की आवश्यकता है?
हां, अधिकांश सार्वजनिक स्रोतों के लिए जिसे एकत्र करना मूल्यवान हो। आवासीय अभिगम वह है जो भू-स्थानीयकृत और एंटी-बॉट-सुरक्षित पृष्ठों को सुलभ रखता है, और यह एक जावास्क्रिप्ट-भारी पृष्ठ को वास्तविक सामग्री प्रदर्शित करने की अनुमति देता है न कि एक ब्लॉक पृष्ठ। Scrapeless Scraping Browser 195+ देशों में आवासीय प्रॉक्सियों के माध्यम से मार्ग निर्धारित करता है; उस क्षेत्र को पिन करने के लिए proxy_country सेट करें जिसकी सामग्री के संस्करण की आप चाहते हैं।
प्रश्न: मैं कॉर्पस को डुप्लिकेट और साफ कैसे करूं?
दो स्तरों पर डुप्लिकेट करें: खोज के समय डुप्लिकेट URLs को हटा दें, और एम्बेडिंग से पहले एक सामग्री हैश या समानता थ्रेशोल्ड का उपयोग करके लगभग डुप्लिकेट चंक हटा दें। चूंकि scrape_markdown पहले से ही बायलरप्लेट को हटा देता है, शेष सफाई हल्की होती है - लगभग-खाली पृष्ठों को छोड़ने के लिए एक लंबाई गार्ड और वैकल्पिक शीर्षक-सजागर विभाजन आमतौर पर पर्याप्त होता है।
प्रश्न: MCP scrape_markdown परिणाम Response: से क्यों शुरू होता है?
Scrapeless MCP सर्वर पर Stateless उपकरण अपने पाठ पेलोड को Response:\n\n से प्रीफ़िक्स करते हैं। यह एक परिवहन-स्तरीय हेडर है, पृष्ठ की सामग्री का हिस्सा नहीं। चंकिंग से पहले इसे हटा दें - चरण 2 में एक-लाइन clean_markdown सहायक इसका प्रबंधन करता है - ताकि प्रीफ़िक्स आपके पहले चंक के शीर्ष पर न आए।
प्रश्न: क्या मैं इसे बिना किसी एआई एजेंट के चला सकता हूं?
हां। चरण 2 में पायथन SDK पाथ पूरी तरह से खोज → निकालना → चंक → एम्बेड चक्र का मालिक है जिसमें कोई एजेंट शामिल नहीं है। जब एक एजेंट यह तय करता है कि कौन से पृष्ठ एकत्र करने हैं, तो MCP सर्वर अनुशंसित पथ है; जब एक स्क्रिप्ट ऐसा करती है, तो SDK अनुशंसित पथ है।
स्क्रैपलेस में, हम केवल सार्वजनिक रूप से उपलब्ध डेटा का उपयोग करते हैं, जबकि लागू कानूनों, विनियमों और वेबसाइट गोपनीयता नीतियों का सख्ती से अनुपालन करते हैं। इस ब्लॉग में सामग्री केवल प्रदर्शन उद्देश्यों के लिए है और इसमें कोई अवैध या उल्लंघन करने वाली गतिविधियों को शामिल नहीं किया गया है। हम इस ब्लॉग या तृतीय-पक्ष लिंक से जानकारी के उपयोग के लिए सभी देयता को कोई गारंटी नहीं देते हैं और सभी देयता का खुलासा करते हैं। किसी भी स्क्रैपिंग गतिविधियों में संलग्न होने से पहले, अपने कानूनी सलाहकार से परामर्श करें और लक्ष्य वेबसाइट की सेवा की शर्तों की समीक्षा करें या आवश्यक अनुमतियाँ प्राप्त करें।





