
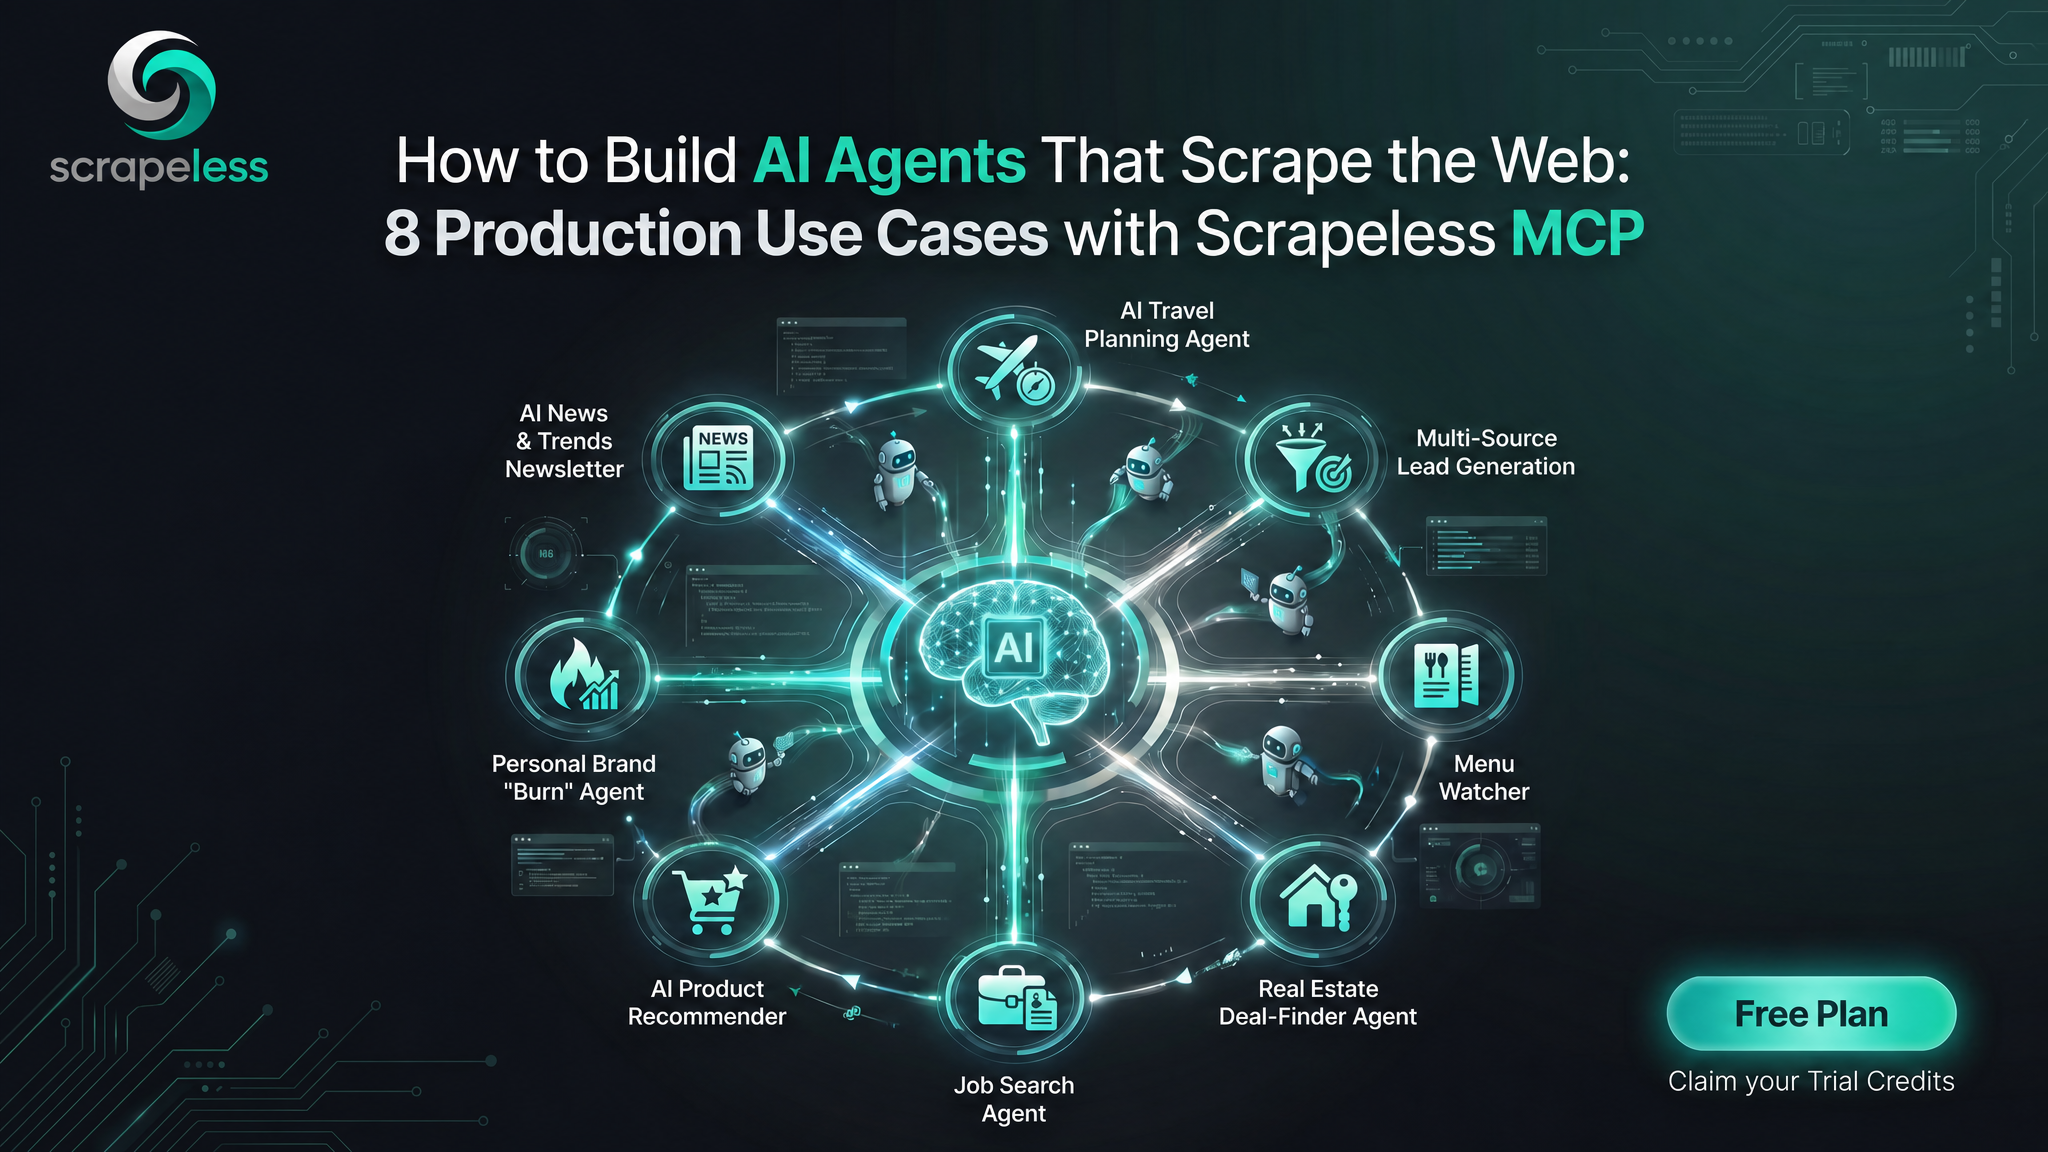
वेब को स्क्रेप करने वाले AI एजेंट कैसे बनाएं: स्क्रैपलेस MCP के साथ 8 उत्पादन उपयोग के मामले
Specialist in Anti-Bot Strategies
मुख्य बातें:
- AI एजेंट तब तक उपयोगी है जब तक यह नवीनतम डेटा प्राप्त कर सकता है। कठिनाई आमतौर पर मॉडल में नहीं होती — यह लॉगिन दीवारें, एंटी-बॉट चुनौतियाँ, गतिशील सामग्री, और एजेंट और पृष्ठ के बीच सत्र प्रबंधन में होती है।
- आठ उपयोग के मामले, एक प्राथमिक सेट। समाचार पत्र, यात्रा योजनाकर्ता, लीड जनरेटर, डील-फाइंडर, नौकरी खोजने वाले, और उत्पाद सिफारिशकर्ता सभी एक ही Scrapeless Scraping Browser उपकरणों पर चलते हैं।
- वास्तविक Scrapeless स्क्रेपर्स में आधारित। नीचे दिए गए प्रत्येक उपयोग के मामले का मानचित्र एक कार्यशील स्क्रेपर्स में है जो ओपन Scrapeless स्क्रेपर्स रिपॉजिटरी में है; जहां कोई स्क्रेपर्स नामित स्रोत के लिए नहीं है, वहाँ प्रतिस्थापन को स्पष्ट रूप से कहा गया है।
- सीखने के लिए कोई प्रति-स्थान अभिनेता मार्केटप्लेस नहीं। समान
browser_*प्राथमिकताएँ हर साइट को चलाती हैं — आपका एजेंट लक्ष्यों को प्रॉम्प्ट बदलकर बदलता है, न कि सही पूर्वनिर्मित अभिनेता की खोज करके। - एजेंट ढांचे के बीच काम करता है। Claude Code, Cursor, Codex CLI, Gemini CLI, Pi Agent, LangChain, AWS Strands, Hermes, ZeroClaw, और Google Antigravity सभी MCP या SDK के माध्यम से जुड़ते हैं।
- शुरू करने के लिए मुफ़्त। नए Scrapeless खाते मुफ़्त स्क्रैपिंग ब्राउज़र रंटाइम शामिल करते हैं — Scrapeless आधिकारिक वेबसाइट पर साइन अप करें।
परिचय: एजेंट अब स्क्रैपिंग करता है
AI एजेंट प्रदर्शनों से दैनिक उपकरणों में चले गए हैं, और लगभग हर उपयोगी उपकरण को एक ही चीज़ की आवश्यकता होती है: सार्वजनिक वेब से ताजा डेटा। एक शोध एजेंट को आज के शीर्षक की आवश्यकता होती है, एक शॉपिंग एजेंट को वर्तमान कीमतों की आवश्यकता होती है, और एक नौकरी एजेंट को इस सुबह की पोस्टिंग की आवश्यकता होती है। मॉडल उस डेटा के बारे में तर्क कर सकता है — लेकिन केवल तभी जब कुछ उसे प्राप्त कर चुका हो।
वह "कुछ" वह जगह है जहां अधिकांश एजेंट परियोजनाएं रुकी रहती हैं। आधुनिक साइटों को जावास्क्रिप्ट के साथ कैसा प्रदर्शन किया जाता है, क्षेत्र के अनुसार सामग्री गेट की जाती है, और अपरिचित ट्रैफ़िक की चुनौतियों का सामना करना पड़ता है। एक सामान्य HTTP अनुरोध एक खाली शेल या एक बॉट दीवार लौटाता है, और हेडलेस ब्राउज़रों, प्रॉक्सी पूल, और सत्र तर्क को जोड़ना एक सप्ताहांत की विचारणा को एक आधारभूत परियोजना में बदल देता है।
Scrapeless Scraping Browser उस अंतर को खत्म करता है। यह एक एजेंट को एक एंटी-डिटेक्शन क्लाउड ब्राउज़र देता है — 195+ देशों में आवासीय प्रॉक्सी और जावास्क्रिप्ट रेंडरिंग के साथ — Scrapeless MCP Server के माध्यम से छोटे सेट के संयोज्य उपकरणों के रूप में। एजेंट स्वयं स्क्रैपिंग करता है, सादा उपकरण कॉल में। यहाँ आठ उपयोग के मामले हैं जो पहले से ही काम कर रहे हैं, प्रत्येक वास्तविक Scrapeless स्क्रैपर्स में आधारित है।
AI एजेंटों के लिए Scrapeless क्यों
Scrapeless Scraping Browser एक अनुकूलन योग्य, एंटी-डिटेक्शन क्लाउड ब्राउज़र है जिसे वेब क्रॉलर्स और AI एजेंटों के लिए डिज़ाइन किया गया है। विशेष रूप से एजेंट कार्य के लिए, यह लाता है:
- एक क्लाउड ब्राउज़र जो असली की तरह प्रदर्शन करता है — जावास्क्रिप्ट, लेज़ी लोडिंग, और सहमति प्रवाह सर्वर-साइड पर संभाले जाते हैं, ताकि एजेंट पूर्ण पृष्ठ प्राप्त करे।
- 195+ देशों में आवासी प्रॉक्सी — सत्र के अनुसार इग्रेस क्षेत्र सेट करें जिससे भू-गेटेड लिस्टिंग, कीमतें, और प्रोफाइल्स प्राप्त की जा सकें।
- 21 संयोज्य MCP उपकरण — ब्राउज़र प्राथमिकताएँ और
google_search,google_trends, औरscrape_markdown, बिना कस्टम अडाप्टर के प्रति कार्य पुनः असेंबल किए गए हैं। - एक ओपन स्क्रैपर रिपॉजिटरी — इन उपयोग के मामलों को नामित करने वाली सटीक साइटों के लिए कार्यशील संदर्भ स्क्रैपर्स, प्रत्येक CLI, Node.js, Python, और MCP सतहों के साथ।
- फ्रेमवर्क-निरपेक्ष एक्सेस — किसी भी प्रमुख एजेंट फ्रेमवर्क से MCP (stdio या HTTP) या SDK के माध्यम से कनेक्ट करें। पूरी सेटअप दस्तावेज़ों में है।
एक अभिनेता मार्केटप्लेस के विपरीत, यहां कोई प्रति-स्थान टेम्पलेट खोजने और कॉन्फ़िगर करने के लिए नहीं है — एक समान प्राथमिकताएँ हर साइट को चलाती हैं, इसलिए एजेंट का टूलसेट छोटा रहता है जबकि इसकी पहुँच व्यापक होती है। Scrapeless आधिकारिक वेबसाइट पर मुफ्त योजना पर अपना API कुंजी प्राप्त करें।
8 उपयोग के मामले
1. AI समाचार और ट्रेंड समाचार पत्र
एक एजेंट जो किसी भी विषय पर कई सामग्री धाराओं की निगरानी करता है और आपके दर्शकों को दैनिक या साप्ताहिक डाइजेस्ट देता है — जिसे LLM द्वारा स्रोत, डेडुप्लिकेटेड, और संक्षिप्त किया जाता है इससे पहले कि कोई भी इसे पढ़े।
यह चार लाइव प्लेटफार्मों से सिग्नल खींचता है: twitter-scraper से पोस्ट और व्यस्तता मैट्रिक्स, google-news-scraper से लेख फ़ीड, reddit-scraper से सामुदायिक चर्चा, और youtube-scraper से वीडियो टिप्पणी; Scrapeless MCP सर्वर के google_search और google_trends उपकरण समय पर खोज मात्रा और ब्रेकआउट सिग्नल जोड़ते हैं। Scrapeless इसे विश्वसनीय बनाता है क्योंकि इसका एंटी-डिटेक्शन क्लाउड ब्राउज़र हर स्रोत को लॉगिन और रेंडरिंग में देरी के बाद प्रस्तुत करता है, 195+ देशों में रेजिडेंशियल प्रॉक्सी हर सत्र को प्लेटफॉर्म के अपेक्षित ट्रैफ़िक से स्थानीय रखती हैं, और कॉम्पोज़ेबल Scrapeless MCP उपकरण आपको बिना गोंद कोड के एक एजेंट प्रॉम्प्ट में सभी चार स्रोतों को चेन करने की अनुमति देते हैं। यह हर सुबह चलाता है: browser_create → google_search + google_trends → प्रत्येक स्रोत पर जाएँ और browser_get_html → LLM संक्षेप करें → डाइजेस्ट भेजें।
2. एआई ट्रैवल प्लानिंग एजेंट
एक एजेंट जो प्राकृतिक-भाषा प्रतिबंधों - बजट, यात्रा की तारीखें, पसंदीदा गतिविधियाँ, आवास शैली - को लेता है और एक रैंक की गई, तैयार-से-बुक यात्रा कार्यक्रम तैयार करता है, इससे यात्रा योजना में घंटे की टैब-स्विचिंग समाप्त हो जाती है। होटल और ठहराव के डेटा के लिए, एजेंट bookingcom-scraper, tripadvisor-scraper, expedia-scraper, trip-scraper, और trivago-scraper पर आधारित है। Airbnb, Skyscanner और Google Flights के लिए कोई Scrapeless scraper नहीं है; उन अंतरालों के लिए एजेंट ऊपर दिए गए बुकिंग और होटल स्रोतों पर निर्भर करता है और सार्वजनिक परिणामों से उड़ान विकल्पों को उभारने के लिए Scrapeless MCP सर्वर के google_search उपकरण का उपयोग करता है। Scrapeless स्क्रैपिंग ब्राउज़र का एंटी-डिटेक्शन क्लाउड ब्राउज़र इन सभी स्रोतों में गतिशील मूल्य निर्धारण ग्रिड और भू-गेटेड सामग्री प्रस्तुत करता है, जबकि 195+ देशों में रेजिडेंशियल प्रॉक्सी सटीक स्थानीय मूल्य लौटाती हैं, चाहे गंतव्य कुछ भी हो। प्रत्येक पास पर, एजेंट कई स्रोतों में समानांतर में क्वेरी करता है, स्थान और मूल्य बैंड द्वारा गुणों को डेडुप्लिकेट करता है, प्रत्येक विकल्प को उपयोगकर्ता की आवश्यकताओं के खिलाफ स्कोर करता है, और लिंक के साथ एक प्राथमिकता वाली यात्रा कार्यक्रम तैयार करता है जो हाथ में सौंपने के लिए तैयार होती है।
3. मल्टी-सोर्स लीड जनरेशन
एक एजेंट जो समृद्ध B2B और क्रिएटर लीड सूची बनाता है और एक CRM को Populate करता है, एक समय में कई संगत स्रोतों का उपयोग कर सकता है। यह google-maps-scraper का उपयोग कर श्रेणी और क्षेत्र द्वारा स्थानीय व्यवसायों को खोजता है, instagram-scraper और tiktok-scraper का उपयोग करके क्रिएटरों को फॉलोवर की संख्या और व्यस्तता सिग्नल के साथ दिखाता है, और केवल सार्वजनिक पेशेवर प्रोफाइल डेटा के लिए linkedin-scraper का उपयोग करता है - कोई प्रमाणीकरण योग्य एंडपॉइंट नहीं, कोई निजी कनेक्शन नहीं। क्योंकि अपोलो का कोई Scrapeless स्क्रपर नहीं है, एजेंट वित्तपोषण और कर्मचारी संख्या का संदर्भ crunchbase-scraper से समृद्ध करता है और wellfound-scraper से भर्ती के संकेत लेते हैं। Scrapeless स्क्रैपिंग ब्राउज़र उन जावास्क्रिप्ट-भारी रेंडरिंग को संभालता है जो हल्के HTTP ग्राहकों को हराता है, जबकि 195+ देशों में रेजिडेंशियल प्रॉक्सी आपको बिना दर सीमा को ट्रिगर किए भू-गेटेड परिणामों को लक्षित करने की अनुमति देती हैं। एकल एजेंट लूप में, आप लक्षित व्यक्ति को परिभाषित करते हैं, एजेंट प्रत्येक स्रोत की अनुक्रम में क्वेरी करता है, ई-मेल या डोमेन पर डेडुप्लिकेट करता है, और समृद्ध रिकॉर्ड को सीधे उसके API के माध्यम से आपके CRM में लिखता है।
4. मेनू वॉचर
एक एजेंट जो आहार संबंधी प्राथमिकताओं और alergies के आधार पर रेस्तरां और भोजन की सिफारिश करता है, खोज से शुरू होता है, फिर किसी भी अनुक्रमणिका से गहराई से जाता है। यह google-maps-scraper का उपयोग कर व्यंजन, रेटिंग और पड़ोस के अनुसार संभावित स्थलों को खोजता है, फिर प्रत्येक रेस्तरां की अपनी वेबसाइट URL को Scrapeless MCP Server के scrape_markdown उपकरण में भेजता है, जो एक कॉल में सार्वजनिक मेनू पृष्ठ को साफ और LLM-तैयार पाठ में लाता है। Scrapeless Scraping Browser जावास्क्रिप्ट मेनू और लेजी-लोडेड सामग्री को उत्पन्न करता है जिसे साधारण HTTP अनुरोधों द्वारा छोड़ा जाएगा, और 195+ देशों में आवासीय प्रॉक्सी एजेंट को स्थान-प्रतिबंधित मेनू पृष्ठों तक पहुंचने देती हैं। एक बार जब मार्कडाउन संदर्भ में आता है, तो एजेंट आपके प्राथमिकता और alergies प्रोफ़ाइल के खिलाफ प्रत्येक डिश की क्रॉस-रेफरेंस करता है, संघर्षों को चिह्नित करता है, और मैच स्कोर के द्वारा सुरक्षित विकल्पों को रैंक करता है - ताकि आपको विशेष भोजन की संक्षिप्त सूची मिले, न कि केवल रेस्तरां की सूची।
फ्री योजना पर अपना API कुंजी प्राप्त करें: Scrapeless आधिकारिक वेबसाइट
5. रियल एस्टेट डील-फाइंडर एजेंट
एक एजेंट जो चौबीसों घंटे आवासीय लिस्टिंग की निगरानी करता है और जैसे ही वे प्रकट होते हैं, बाजार से नीचे के अवसरों को उभरता है - इससे पहले कि अधिकांश खरीदार कभी ब्राउज़र टैब खोलें। आप इसे दो डेटा स्रोतों पर इंगित करते हैं: Zillow scraper और Redfin scraper - दोनों ही क्लाउड ब्राउज़र के माध्यम से साफ-सुथरे ढंग से दिखते हैं, यहाँ तक कि आक्रामक एंटी-बॉट संरक्षण के पीछे भी, और एजेंट दोनों को ताजे और बाजार से नीचे की लिस्टिंग के लिए क्रॉस-चेक करता है। Scrapeless क्रॉस-प्लेटफ़ॉर्म कवर प्रैक्टिकल बनाता है क्योंकि Scrapeless Scraping Browser एंटी-डिटेक्शन रेंडरिंग को 195+ देशों में आवासीय प्रॉक्सियों के साथ जोड़ता है, जिससे एजेंट भू-प्रतिबंधित लिस्टिंग पृष्ठों और जावास्क्रिप्ट-भारी संपत्ति कार्डों तक पहुंचता है बिना मैनुअल सत्र की देखभाल के। प्रत्येक चक्र में एजेंट ताजे लिस्टिंग खींचता है, तुलनात्मक हाल की बिक्री के खिलाफ प्रति-स्क्वायर-फुट मूल्य-उपात की गणना करता है, आपकी सुरक्षित मानदंडों के खिलाफ प्रत्येक संपत्ति को स्कोर करता है, और तत्काल सूचनाओं के साथ एक रैंक की गई संक्षिप्त सूची को पुश करता है ताकि आप कार्य कर सकें जब लिस्टिंग अभी भी जीवित हो।
6. नौकरी खोज एजेंट
एक एजेंट जो कई प्लेटफार्मों से खुले पदों को एकत्र करता है, उन्हें आपके रिज़्यूमे और लक्षित मानदंडों के खिलाफ फ़िल्टर करता है, और प्रत्येक मेल को मुआवजा संदर्भ से समृद्ध करता है - ताकि आप नौकरी बोर्डों पर घुसपैठ करने के बजाय मजबूत आवेदन तैयार करने में समय व्यतीत करें। एजेंट LinkedIn scraper, Indeed scraper, Glassdoor scraper, और Google Jobs scraper से समानांतर में खींचता है। Scrapeless Scraping Browser जावास्क्रिप्ट-भारी फ़ीड और लॉगिन दीवारों को संभालता है जो पारंपरिक स्क्रैपर्स को रोकते हैं, जबकि 195+ देशों में आवासीय प्रॉक्सी एजेंट को क्षेत्र-विशिष्ट वेतन अनुमान और दूरस्थ-योग्य भूमिका दृश्यता तक पहुंचने देती है जो बाहर जाने वाले IP द्वारा भिन्न होती है। प्रत्येक रनों में, एजेंट सभी चार स्रोतों में पोस्टिंग को डुप्लिकेट करता है, उन्हें आपके कौशल और सीनियॉर्टी स्तर के खिलाफ स्कोर करता है, जहां उपलब्ध होता है, Glassdoor से वेतन संदर्भ जोड़ता है, और आपको एक फ़िल्टर किए गए डाइजेस्ट प्रदान करता है जिसे आप एकल आवेदन प्रस्तुत करने से पहले समीक्षा करते हैं।
7. एआई उत्पाद सिफारिशकर्ता
एक एजेंट जो खरीदारी के प्रश्नों का उत्तर देता है और बाजारों में आपर्यायात्मक विश्लेषण करता है, आपको पाँच टैब खोलने और हाथ से कीमतों को सामान्य बनाने का काम बचाता है। यह समानांतर में Amazon scraper, AliExpress scraper, eBay scraper, और Walmart scraper से खींचता है - उत्तरी अमेरिका और वैश्विक मांग संकेतों को एक ही पास में कवर करता है। Scrapeless Scraping Browser उस जावास्क्रिप्ट-भारी उत्पाद कार्डों और क्षेत्र-प्रतिबंधित कीमतों को दर्शाता है जिन्हें साधारण HTTP ग्राहक छोड़ देते हैं, जबकि 195+ देशों में आवासीय प्रॉक्सी एजेंट को स्थानीय-मुद्रा के परिणामों और क्षेत्रीय रूप से प्रतिबंधित लिस्टिंग को बिना बॉट डिटेक्शन को ट्रिगर किए दिखाने देती हैं। प्रत्येक चलाने पर, एजेंट एक सामान्य भाषा में प्रश्न स्वीकार करता है, प्रत्येक बाजार में समानांतर में पूछता है, मुद्रा और शिपिंग को एक सामान्य आधार में सामान्य करता है, जहां उपलब्ध होता है, GTIN या मॉडल नंबर द्वारा डुप्लिकेट करता है, और रैंक की गई सिफारिश तालिका लौटाता है जो मूल्य स्कोर द्वारा क्रमबद्ध होती है।
8. व्यक्तिगत ब्रांड "बर्न" एजेंट
एक हल्का-फुल्का एजेंट जो आपके सार्वजनिक निशान की ऑडिट करता है और चुटीली आत्म-आलोचना प्रस्तुत करता है, यह प्रदर्शित करता है कि उसी बुनियादी ढांचे का उपयोग गंभीर व्यवसाय एजेंट करते हैं, वह शुद्ध व्यक्तिगत उपयोग के लिए भी काम करता है। यह आपके सार्वजनिक प्रोफाइल पृष्ठों को LinkedIn स्क्रैपर और Twitter स्क्रैपर के माध्यम से पढ़ता है, फिर Scrapeless MCP सर्वर के google_search टूल के माध्यम से आत्म-पूछताछ करता है ताकि यह दिखा सके कि आप जैविक परिणामों में कैसे दिखाई देते हैं - केवल सभी सार्वजनिक डेटा, कोई प्रामाणीकृत अंतबिंदु नहीं। Scrapeless स्क्रैपिंग ब्राउज़र जावास्क्रिप्ट से भरे प्रोफाइल पृष्ठों और सार्वजनिक टाइमलाइन फीड को प्रस्तुत करता है जो सादा फेच छूता है, जबकि 195+ देशों में आवासीय प्रॉक्सी भू-भिन्न खोज परिणामों तक पहुंचते हैं, जो दर्शाते हैं कि विभिन्न दर्शक आपको वास्तव में कैसे ढूंढते हैं। एक ही बार में, एजेंट आपकी शीर्षक, पिन किए गए पद, जैव प्रति, और शीर्ष खोज स्निप्पेट्स एकत्र करता है, फिर आपके आत्म-प्रस्तुति और सार्वजनिक वेब के बीच की खाई की ईमानदार आलोचना का संश्लेषण करता है।
Scrapeless पर, हम केवल सार्वजनिक रूप से उपलब्ध डेटा का उपयोग करते हैं जबकि लागू कानून, नियमों, और वेबसाइट की गोपनीयता नीतियों का कड़ाई से पालन करते हैं। इस पोस्ट में सामग्री केवल प्रदर्शन के उद्देश्यों के लिए है।
ये कैसे मिलते हैं: एक ब्राउज़र, कई साइटें
आठ उपयोग मामलों को लगातार पढ़ें और पैटर्न को देखना मुश्किल नहीं है: ये विभिन्न साइटों पर इशारा किए गए समान उपकरणों का एक छोटा सा समूह हैं। browser_create, browser_goto, browser_wait_for, browser_get_html, और browser_close हर निष्कर्षण को ले जाते हैं; google_search, google_trends, और scrape_markdown उस जगहों को भरते हैं जहां एक समर्पित स्क्रैपर मौजूद नहीं है। यही एक एजेंट के बीच का अंतर है जो सही पूर्व-निर्मित अभिनेता को खोजने पर निर्भर करता है और एक जो किसी भी चीज़ को स्क्रैप कर सकता है जिसे इसका प्रॉम्प्ट वर्णन करता है। ओपन रेपो में संदर्भ स्क्रैपर्स प्रति साइट खोज-फिर-निष्कर्षण रूप को दिखाते हैं; क्लाउड ब्राउज़र नीचे रेंडरिंग, प्रॉक्सियों, और सत्र प्रबंधन प्रदान करता है।
प्रश्नोत्तर
Scrapeless एक एजेंट को क्या देता है जो एक अभिनेता मार्केटप्लेस नहीं देता?
सार्वभौमिक ब्राउज़र प्राइमिटिव। प्रति-साइट अभिनेता के लिए कैटलॉग की खोज करने के बजाय, एजेंट एक एंटी-डिटेक्शन क्लाउड ब्राउज़र को हर जगह समान उपकरणों के साथ चलाता है - इसलिए बिना पूर्व-निर्मित टेम्पलेट वाली साइट अभी भी browser_* कॉल को scrape_markdown या google_search के साथ मिलाकर पहुंची जा सकती है।
क्या एक एजेंट हर साइट पर एक ही उपकरणों का पुन: उपयोग कर सकता है?
हाँ। ऊपर प्रत्येक उपयोग मामला समान 21-उपकरण MCP सतह पर चलता है। लक्षित प्रॉम्प्ट और URL के साथ बदलता है, उपकरण सेट के साथ नहीं।
कौन से एजेंट फ्रेमवर्क समर्थित हैं?
Claude Code, Cursor, VS Code, Codex CLI, और Gemini CLI स्किल या MCP के माध्यम से; Pi एजेंट, LangChain, AWS Strands, Hermes, ZeroClaw, और Google Antigravity MCP या SDK के माध्यम से।
बिना Scrapeless स्क्रैपर वाली साइट के लिए क्या?
इसे प्राइमिटिव से बनाएं: पृष्ठ को browser_goto के साथ खोलें, क्लाउड ब्राउज़र को इसे रेंडर करने दें, और scrape_markdown के साथ पाठ निकालें - या google_search के माध्यम से इसे प्रदर्शित करें। उपरोक्त यात्रा-उड़ान और लीड-समृद्धि की खामियां बिल्कुल यही फॉलबैक उपयोग करती हैं।
कई एजेंटों के बीच मूल्य निर्धारण कैसे बढ़ता है?
सत्र कार्य की इकाई हैं, और नए खातों में निःशुल्क स्क्रैपिंग ब्राउज़र रनटाइम होता है। योजनाओं की तुलना करें मूल्य निर्धारण पृष्ठ; समानांतर लॉन्च के लिए, प्रति होस्ट लगभग तीन सत्रों तक स्वामित्व रखते हुए।
निष्कर्ष
मॉडल कभी भी AI एजेंट के लिए बाधा नहीं होता - लाइव, रेंडर्ड, क्षेत्र-सही वेब डेटा तक पहुंचना होता है। ये सभी आठ उपयोग मामलों को एक ही तरीके से हल करते हैं: एक एंटी-डिटेक्शन क्लाउड ब्राउज़र, 195+ देशों में आवासीय प्रॉक्सी, और एक छोटे सेट के संकलनीय MCP उपकरण जिनका एजेंट स्वयं उपयोग करता है। अपने लक्ष्य के सबसे करीब वाले को चुनें, अगले लिए उसी इंस्टाल का पुन: उपयोग करें, और जब तक एक समर्पित स्क्रैपर अभी मौजूद नहीं है, scrape_markdown और google_search पर निर्भर करें। एक एजेंट-देशी कार्यान्वयन उदाहरण के लिए, देखें AI एजेंटों के लिए सर्वश्रेष्ठ Amazon स्क्रैपर्स।
क्या आप अपने AI-संचालित डेटा पाइपलाइन बनाना चाहते हैं?
हमारे समुदाय में शामिल हों और एक मुफ्त योजना का दावा करें और उन डेवलपर्स से जुड़ें जो AI-एजेंट डेटा पाइपलाइनों का निर्माण कर रहे हैं: Discord · Telegram।
Scrapeless आधिकारिक वेबसाइट पर साइन अप करें निःशुल्क स्क्रैपिंग ब्राउज़र रनटाइम के लिए और ऊपर दिए गए उपयोग मामलों को उन साइटों, प्रश्नों और क्षेत्रों में अनुकूलित करें जिनकी आपके एजेंटों को आवश्यकता है।
स्क्रैपलेस में, हम केवल सार्वजनिक रूप से उपलब्ध डेटा का उपयोग करते हैं, जबकि लागू कानूनों, विनियमों और वेबसाइट गोपनीयता नीतियों का सख्ती से अनुपालन करते हैं। इस ब्लॉग में सामग्री केवल प्रदर्शन उद्देश्यों के लिए है और इसमें कोई अवैध या उल्लंघन करने वाली गतिविधियों को शामिल नहीं किया गया है। हम इस ब्लॉग या तृतीय-पक्ष लिंक से जानकारी के उपयोग के लिए सभी देयता को कोई गारंटी नहीं देते हैं और सभी देयता का खुलासा करते हैं। किसी भी स्क्रैपिंग गतिविधियों में संलग्न होने से पहले, अपने कानूनी सलाहकार से परामर्श करें और लक्ष्य वेबसाइट की सेवा की शर्तों की समीक्षा करें या आवश्यक अनुमतियाँ प्राप्त करें।





