La guía más completa, creada para todos los desarrolladores de Web Scraping.
Scrapeless ofrece servicios de automatización y raspado web robustos, escalables y basados en IA en los que confían empresas líderes. Nuestras soluciones de nivel empresarial están diseñadas para satisfacer las necesidades de su proyecto, con soporte técnico dedicado en todo momento. Con un equipo técnico sólido y tiempos de entrega flexibles, cobramos solo por los datos exitosos, lo que permite una extracción de datos eficiente y evitamos las limitaciones.
Contáctenos ahora para impulsar el crecimiento de su negocio.
Proporcione sus datos de contacto y nos comunicaremos con usted de inmediato para ofrecerle una demostración e introducción del producto. Nos aseguramos de que su información permanezca confidencial, cumpliendo con los estándares GDPR.
¡Tu prueba gratuita está lista! Regístrese para obtener una cuenta Scrapeless de forma gratuita y su prueba se activará instantáneamente en su cuenta.
Construya un análisis de características SERP con registros orgánicos y de módulo separados, estados de campo explícitos y mapeos de esquema verificados en lugar de conteos de clasificación mezclados.
 Michael Lee
Construya el descubrimiento del sitio web de la empresa con búsquedas contextuales, dominios de candidatos, verificaciones de entidades y una tabla revisable de empresa a sitio web utilizando la API de Google Search.
Michael Lee
Utilice la API de búsqueda de Google para que los agentes de IA creen una cola de revisión de fuentes, preserven el contexto de búsqueda y separen el descubrimiento de la recuperación y la verificación de citas.
Michael Lee
Utiliza la investigación de contenido SERP para construir un resumen de contenido a partir de observaciones de búsqueda, páginas revisadas, preguntas de la audiencia y un plan claro para evidencia original.
Michael Lee
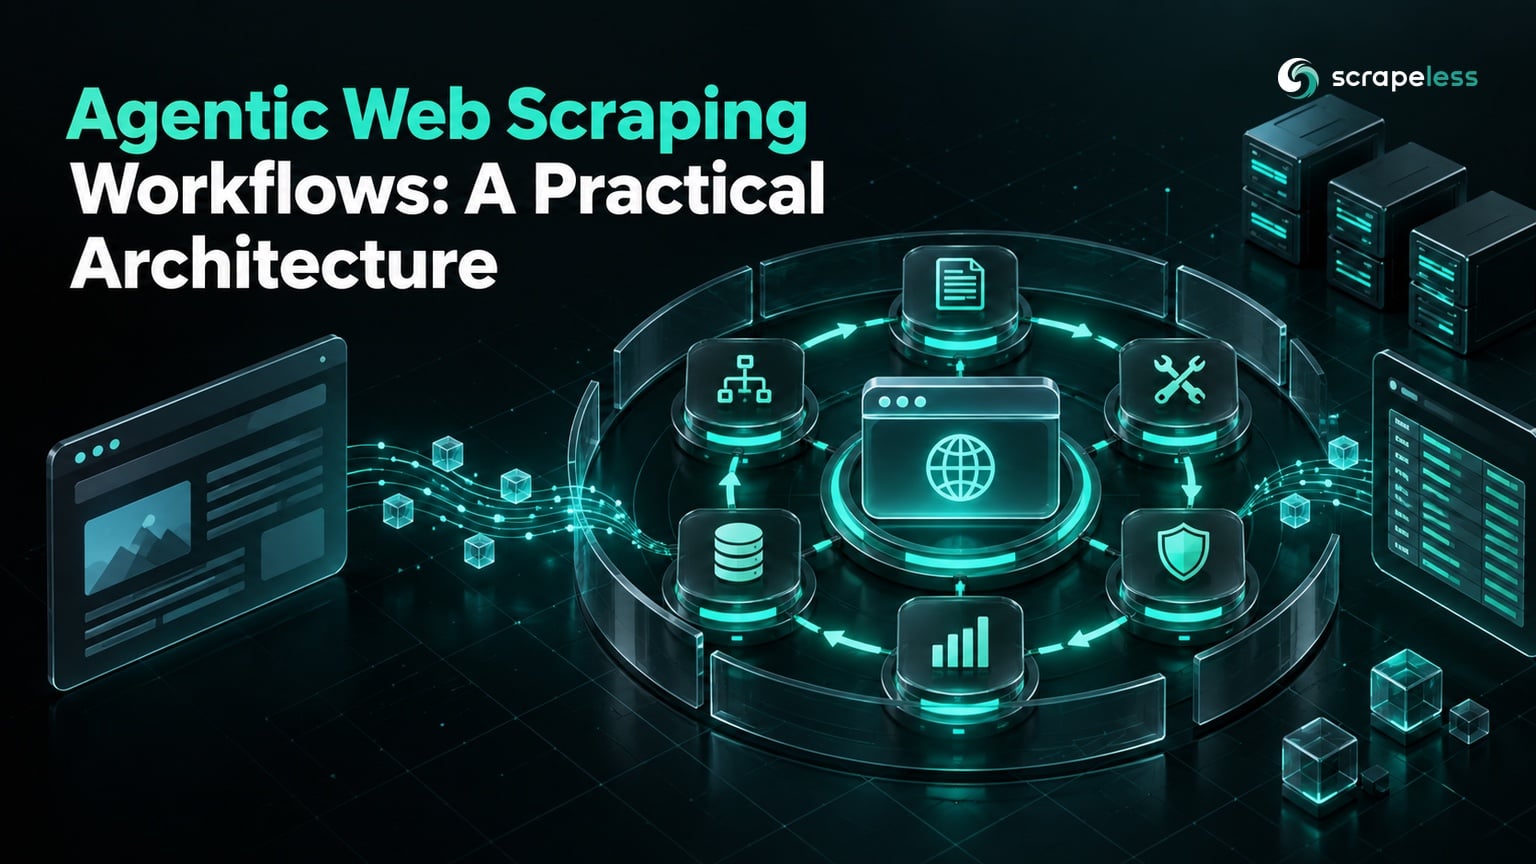
Una arquitectura de producción para agentes web limitados, con herramientas explícitas, estado, política, evidencia, validación y decisiones de agente contra tubería.
 Daniel Kim
Seis herramientas de scraping de IA comparadas por capa de operación, interacción con el navegador, modelo de integración, salida estructurada, procedencia y propiedad del flujo de trabajo.
 Isabella Garcia
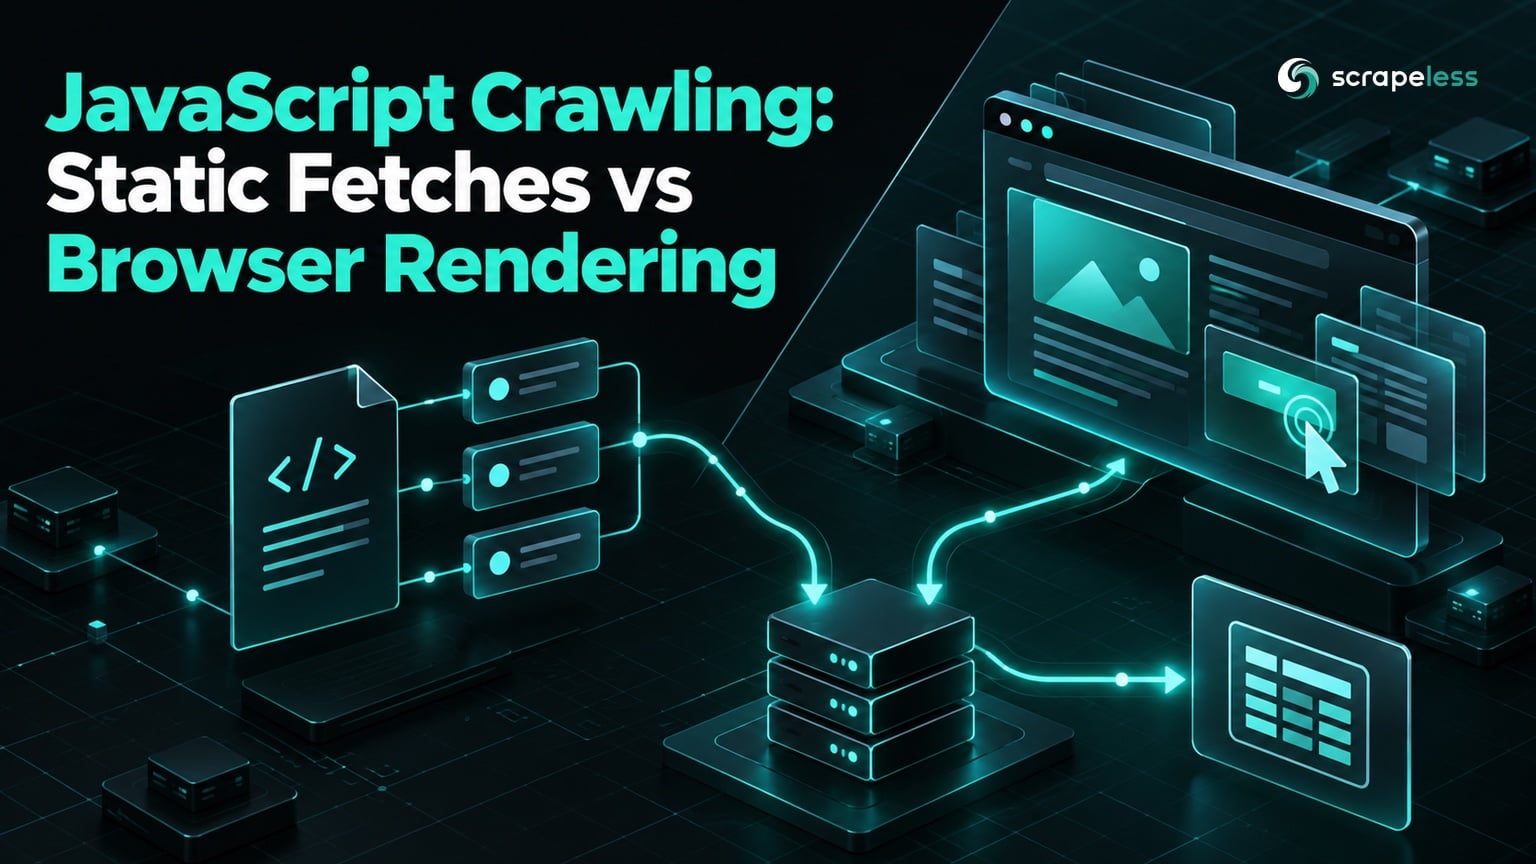
Una guía de decisión a nivel de plantilla para combinar la obtención estática de HTTP y el renderizado del navegador dentro de una arquitectura de rastreo de JavaScript controlada.
 Alex Johnson
Una pipeline práctica para convertir páginas web públicas aprobadas en texto limpio, deduplicado y con enlaces a la fuente para RAG, ajuste fino y evaluación.
 Emily Chen