
Blog de raspado web
La guía más completa, creada para todos los desarrolladores de Web Scraping.
Artículos más populares



El último
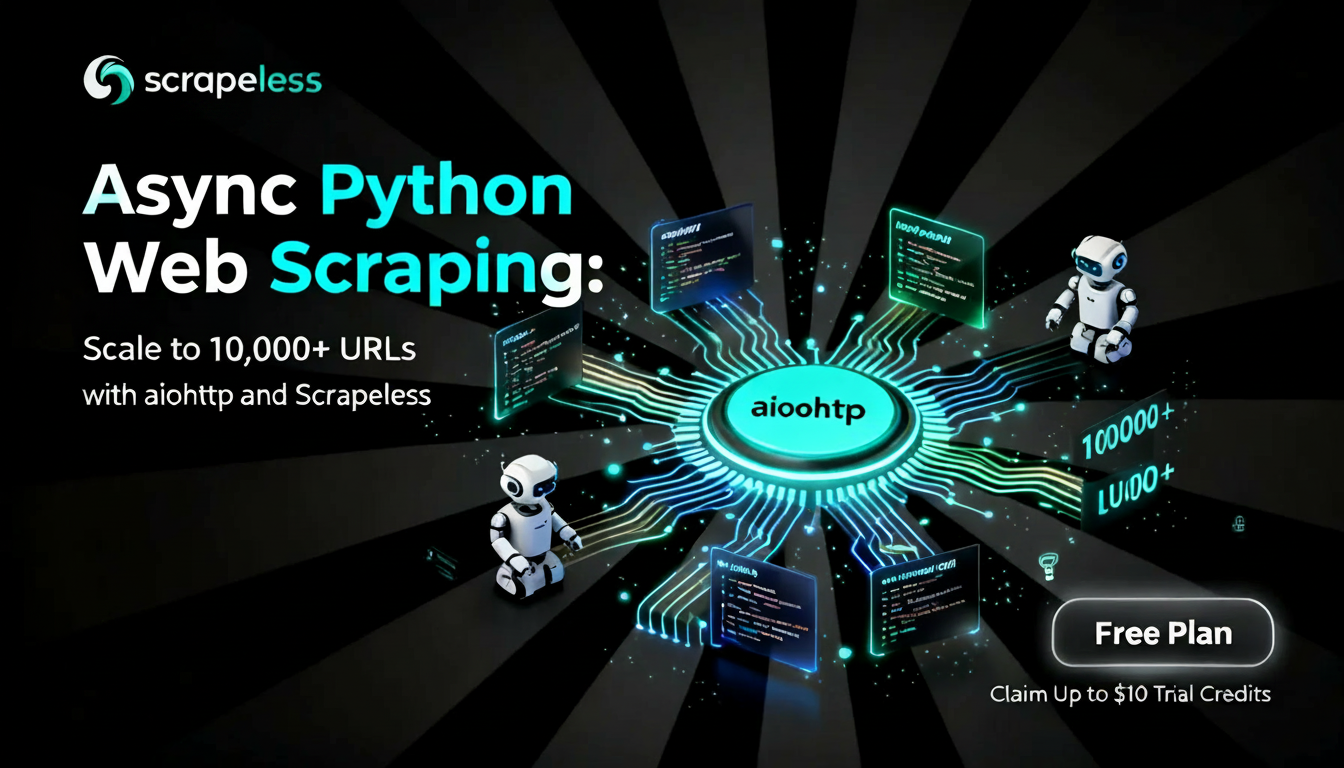
Raspado web asíncrono en Python: Escala hasta 10,000+ URLs con aiohttp y Scrapeless
La extracción de datos web asíncrona en Python es de 10 a 100 veces más rápida que los enfoques sincrónicos al aprovechar el bucle de eventos de asyncio para manejar cientos de solicitudes HTTP concurrentes en un solo hilo. Esta guía cubre el patrón completo: uso de aiohttp con proxies residenciales de Scrapeless para extracciones de nivel HTTP y la escalación de páginas renderizadas por JavaScript a Scrapeless Scraping Browser a través de la API asíncrona de Playwright. Aprende cómo construir raspadores de calidad de producción con un control adecuado de la concurrencia, manejo de fallos y arquitectura en capas a lo largo de 7 pasos prácticos y ejemplos de código funcional.
 Ethan Brown
Cómo agregar búsqueda web a GitHub Copilot CLI: Guía de integración de MCP sin desperdicios.
Este post cierra esa brecha conectando el servidor Scrapeless MCP al CLI de GitHub Copilot. Un bloque de configuración le da al agente búsqueda en Google, renderizado en JavaScript y un navegador completo en la nube, todo accesible a través de los mismos comandos en lenguaje natural que ya utiliza para el código.
Ethan Brown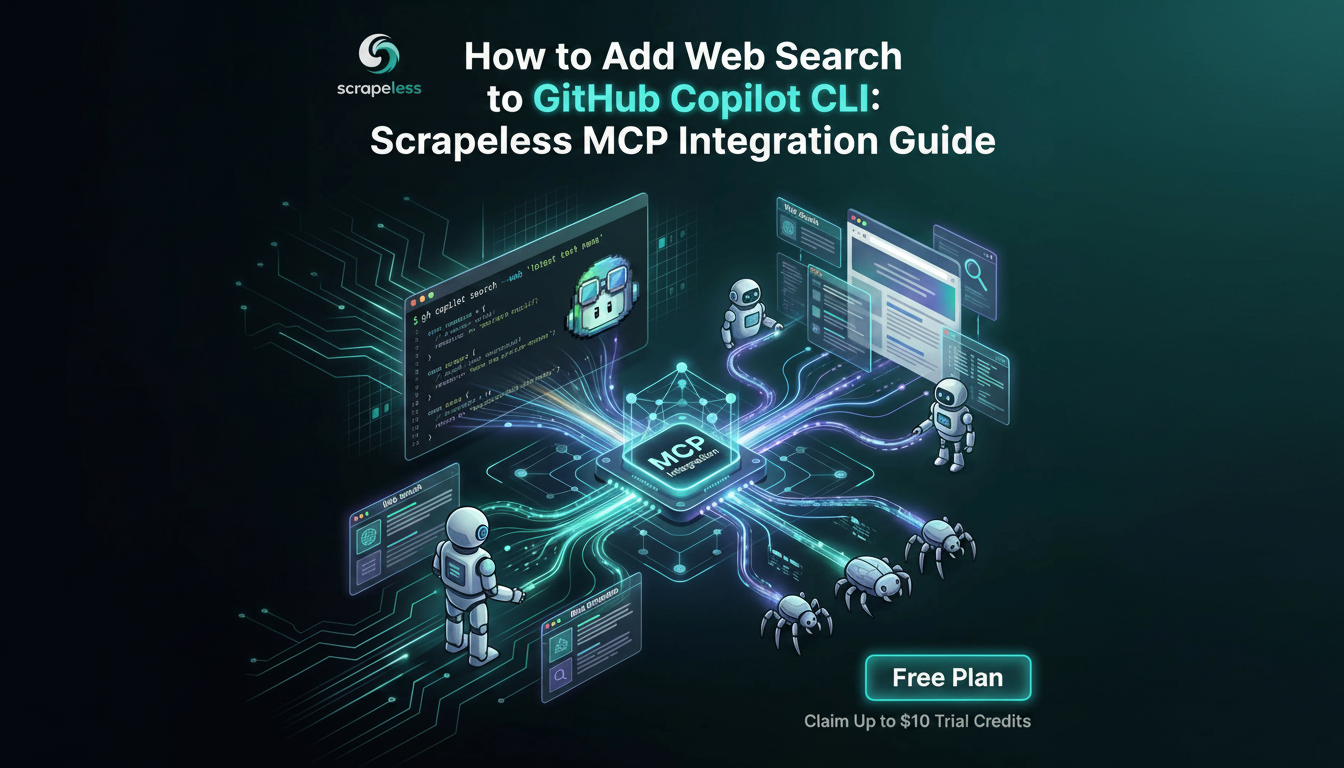
Mejores proxies rotativos en 2026: Comparación de referencia de 10 principales proveedores
Descubre qué proveedor de proxies rotatorios ofrece el mejor valor para tus necesidades de scraping. Comparamos Scrapeless, Decodo, Oxylabs, SOAX, NetNut, Webshare, IPRoyal, DataImpulse, Rayobyte e Infatica en tasas de éxito, latencia, tamaño de pool y precios para guiar tu decisión.
 Emily Chen
Cómo añadir búsqueda web a Qwen Code: Integración Scrapeless MCP para agentes de terminal.
Esta publicación cierra esa brecha conectando el servidor MCP de Scrapeless en Qwen Code. Un bloque en `~/.qwen/settings.json` proporciona al agente búsqueda en Google, renderizado en JavaScript y un navegador en la nube completamente anti-detección, todo accesible a través de los mismos comandos en lenguaje natural que ya se utilizan para el código.
 Ava Wilson
¿Qué es un proxy SSL y cómo funciona?
Esta guía define el proxy SSL de manera precisa, explica el apretón de manos TLS que le permite funcionar, traza la línea entre despliegues directos y reversos, y es honesta sobre la compensación de seguridad que representa. Concluye con dónde encaja la infraestructura de proxy gestionada cuando el objetivo es la recolección confiable de datos en lugar de manejar una puerta de enlace de inspección por tu cuenta.
Ethan Brown
Cómo construir raspadores web de calidad de producción con Scrapling y Scrapeless en Python
Este tutorial construye un pipeline de Python en dos niveles. El Nivel 1 es Scrapling por sí solo: la herramienta adecuada para páginas estáticas y de protección media. El Nivel 2 enruta el `DynamicFetcher` de Scrapling a través del Navegador de Scraping Sin Scrap a través de CDP, de modo que el renderizado ocurre del lado de la nube detrás de proxies residenciales y de huellas dactilares de detección anti-detección por sesión, mientras que tu código de análisis de Scrapling se mantiene exactamente igual. Para la misma primitiva de Navegador de Scraping Sin Scrap impulsada a través de un marco de agentes en lugar de un fetcher, consulta la publicación de integración de LangChain.
Ava Wilson
Cómo construir agentes de IA que raspan la web: 8 casos de uso en producción con Scrapeless MCP.
El Navegador de Raspado Sin Desechos colma esa brecha. Le proporciona a un agente un navegador en la nube anti-detección, con proxies residenciales en más de 195 países y renderización de JavaScript incorporada, expuesto a través del [Servidor MCP de Scrapeless](https://github.com/scrapeless-ai/scrapeless-mcp-server) como un pequeño conjunto de herramientas componibles. El agente en sí realiza el raspado, en llamadas de herramientas sencillas. Aquí hay ocho casos de uso que ya funcionan, cada uno fundamentado en un verdadero raspador de Scrapeless.
 Sophia Martinez
Cinco casos de uso de agentes de IA para la extracción de datos: YouTube, Maps, Amazon, Booking, Instagram con Scrapeless MCP.
Cinco casos de uso, un conjunto de herramientas: cada uno se reduce a un solo comando que abre una sesión de navegador en la nube, renderiza la página y devuelve JSON estructurado sobre el cual tu agente puede actuar. El patrón es siempre descubrir y luego extraer: pinchar un país proxy cerca de la audiencia, mantener el trabajo de la sesión dentro de un solo comando y tratar los campos ausentes como anulables. Comienza con el caso de uso más cercano a tu objetivo, luego reutiliza la misma instalación para el siguiente. Para construcciones más profundas y paso a paso, consulta la descripción general del servidor Scrapeless MCP y compara planes en la página de precios.
 Michael Lee
Scrapeless ofrece servicios de automatización y raspado web robustos, escalables y basados en IA en los que confían empresas líderes. Nuestras soluciones de nivel empresarial están diseñadas para satisfacer las necesidades de su proyecto, con soporte técnico dedicado en todo momento. Con un equipo técnico sólido y tiempos de entrega flexibles, cobramos solo por los datos exitosos, lo que permite una extracción de datos eficiente y evitamos las limitaciones.
Contáctenos ahora para impulsar el crecimiento de su negocio.
Proporcione sus datos de contacto y nos comunicaremos con usted de inmediato para ofrecerle una demostración e introducción del producto. Nos aseguramos de que su información permanezca confidencial, cumpliendo con los estándares GDPR.
¡Tu prueba gratuita está lista! Regístrese para obtener una cuenta Scrapeless de forma gratuita y su prueba se activará instantáneamente en su cuenta.