
Blog de raspado web
La guía más completa, creada para todos los desarrolladores de Web Scraping.
Artículos más populares



El último
Construye un rastreador de posiciones con Scrapeless Deep SerpApi
Un rastreador de posiciones es un bucle, no una hoja de cálculo: consulta a Google para cada palabra clave, lee las posiciones orgánicas, compara tu dominio y diferencia instantáneas a lo largo del tiempo. Deep SerpApi devuelve el SERP como JSON estructurado para que el rastreador se mantenga pequeño.
 Emily Chen

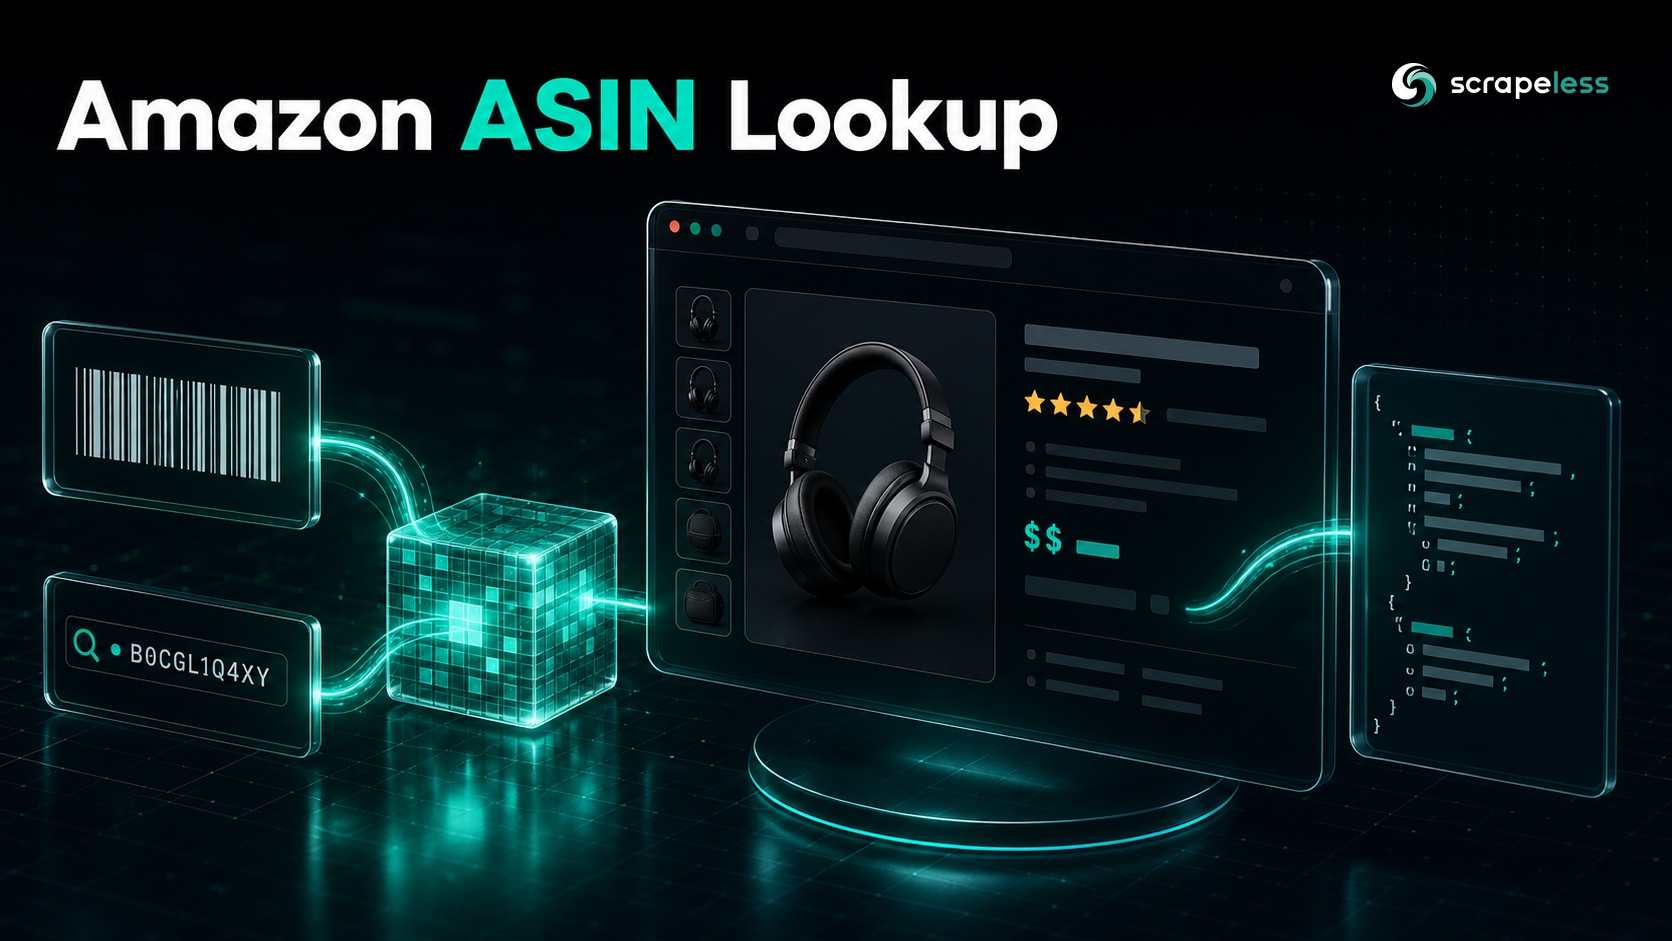
Búsqueda de ASIN de Amazon: Convierte un ASIN en un registro de producto con la API de Scraper.
Un ASIN es la clave principal de Amazon para un producto. Pasa una URL de producto al actor scraper.amazon y obtén el título, la marca, el precio, la disponibilidad, las calificaciones y el vendedor como JSON estructurado, con salida residencial en EE. UU. para precios consistentes según la región.
 Isabella Garcia
Cómo construir un web scraper: una guía de Python desde cero
Construya un raspador web funcional en Python desde cero con requests y BeautifulSoup, maneje la paginación y la salida estructurada, luego renderice páginas con mucho JavaScript con Scrapeless Scraping Browser.
Emily Chen
Cómo raspar la Biblioteca de Anuncios de Facebook con el navegador Scrapeless Scraping.
La Biblioteca de Anuncios de Facebook es pública pero se renderiza completamente del lado del cliente detrás de una verificación anti-bot. Scrapeless Scraping Browser devuelve el DOM pintado, y los anclajes de descubrimiento se basan en el texto duradero del ID de la Biblioteca para que el análisis sobreviva a la rotación de nombres de clase de React.
 Sophia Martinez

Mejora Databricks con el servidor MCP sin chatarra.
Los agentes de Databricks pueden razonar sobre tu lakehouse, pero no pueden acceder a la web en vivo hasta que conectes una herramienta. Conecta el servidor Scrapeless MCP y el agente obtendrá búsqueda en vivo, renderizado y un navegador en la nube.
 Daniel Kim

Mejores raspadores de datos instantáneos en 2026
Un extractor de datos instantáneo convierte una página en un archivo estructurado sin necesidad de código. Clasificado por el lugar donde se ejecuta el trabajo: extensiones para tablas únicas, aplicaciones sin código para proyectos recurrentes y un navegador en la nube nativo de agente cuando la representación y el manejo anti-bot deciden si obtienes los datos o no.
 Ava Wilson

MechanicalSoup: Automatizar el raspado basado en formularios en Python
MechanicalSoup combina requests con BeautifulSoup en un navegador con estado para sitios impulsados por formularios, pero nunca ejecuta JavaScript. Cuando una página se renderiza del lado del cliente, entrega la solicitud al Scrapeless Scraping Browser y mantén tus selectores de BeautifulSoup sin cambios.
 Alex Johnson

MCP vs APIs de Web Scraping Tradicionales: ¿Cuál elegir en 2026?
Servidor MCP vs API de raspado web tradicional: compara cómo cada contrato entrega datos web, cuándo elegir una API de raspado REST sobre un servidor MCP y cómo hacer la elección.
Daniel Kim
Scrapeless ofrece servicios de automatización y raspado web robustos, escalables y basados en IA en los que confían empresas líderes. Nuestras soluciones de nivel empresarial están diseñadas para satisfacer las necesidades de su proyecto, con soporte técnico dedicado en todo momento. Con un equipo técnico sólido y tiempos de entrega flexibles, cobramos solo por los datos exitosos, lo que permite una extracción de datos eficiente y evitamos las limitaciones.
Contáctenos ahora para impulsar el crecimiento de su negocio.
Proporcione sus datos de contacto y nos comunicaremos con usted de inmediato para ofrecerle una demostración e introducción del producto. Nos aseguramos de que su información permanezca confidencial, cumpliendo con los estándares GDPR.
¡Tu prueba gratuita está lista! Regístrese para obtener una cuenta Scrapeless de forma gratuita y su prueba se activará instantáneamente en su cuenta.