
Blog de raspado web
La guía más completa, creada para todos los desarrolladores de Web Scraping.
Artículos más populares



El último
curl Cookies: Cómo enviar, almacenar y reutilizar sesiones de manera segura
Una guía de cookies curl centrada en la seguridad que cubre valores literales, encabezados Set-Cookie, frascos de cookies privados, reglas de coincidencia, depuración y límites solo para navegadores.
 Isabella Garcia
Dify + Scrapeless: Ofrezca a sus Agentes Datos Web en Vivo Con una Herramienta Personalizada
Una herramienta personalizada le da a un agente Dify datos web en vivo a los que el plugin del mercado no puede acceder. La configuración activa cuatro campos de autenticación que Dify completa incorrectamente, y la respuesta necesita ser recortada antes de que llegue al modelo.
 Emily Chen
Activepieces + Scrapeless: Un Flujo de Leads Local Sin Código
Activepieces alcanza datos de búsqueda en vivo con su pieza HTTP integrada, por lo que un flujo de lead no necesita una pieza personalizada ni un servicio para alojarlo. La respuesta analizada se encuentra bajo el cuerpo, y el campo de teléfono lleva un número en solo alrededor de la mitad de los registros.
Isabella Garcia
API de Scraper de Búsqueda de Google: Cinco Valores Predeterminados Que Devuelven Datos Vacíos
Una solicitud aceptada y una carga útil utilizable no son lo mismo. El actor de Google Search puede devolver 200 con un array organic_results vacío, un marcador de anuncio en lugar de un listado, o un campo que esté en blanco por diseño. Estos cinco valores predeterminados lo provocan.
 Daniel Kim
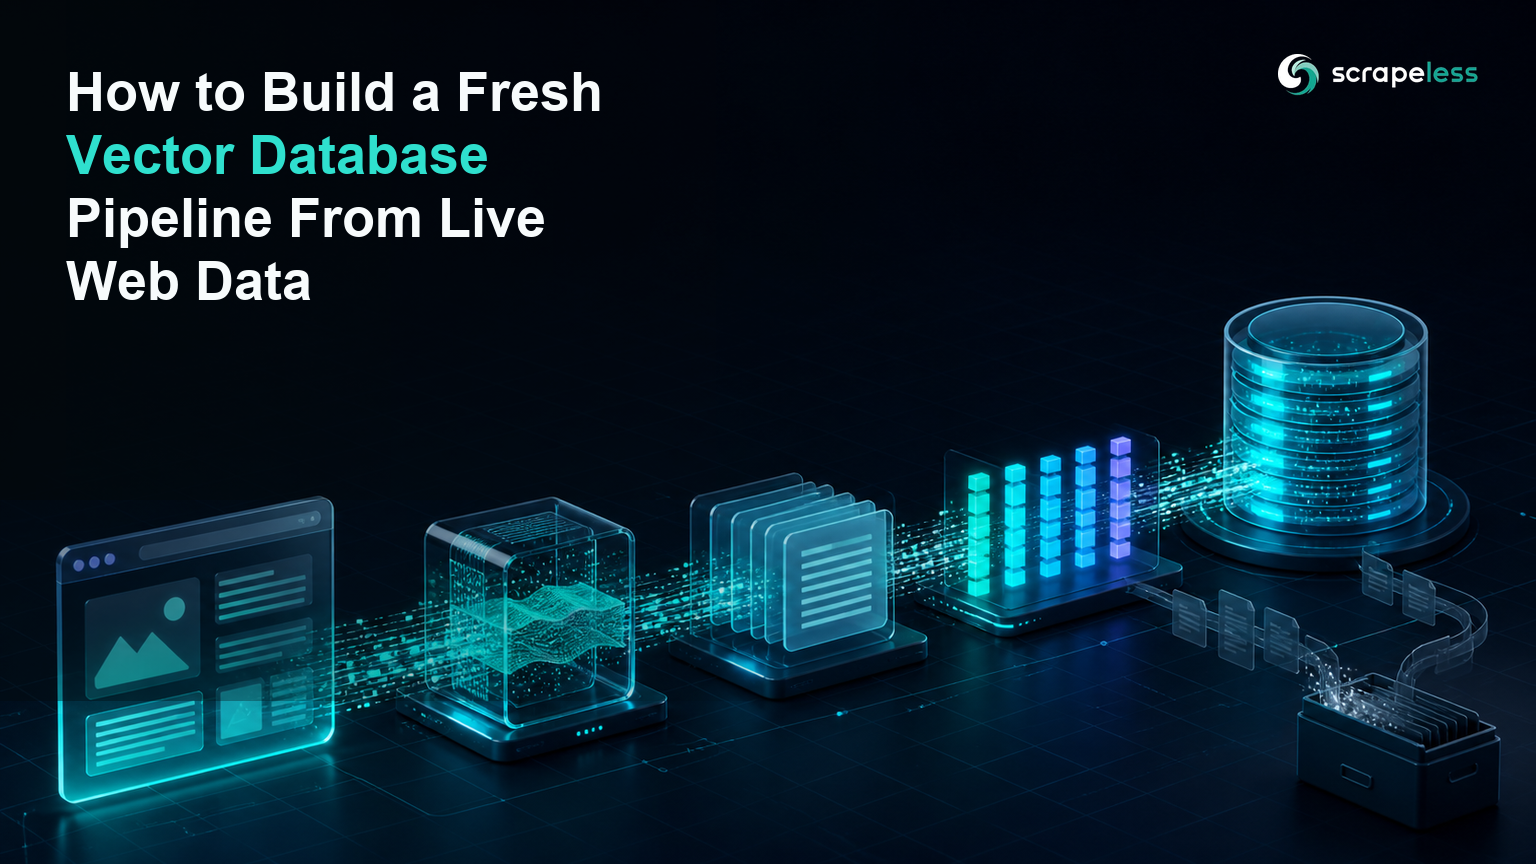
Cómo construir un pipeline de base de datos vectorial fresca a partir de datos web en vivo
Una tubería reproducible para convertir páginas web renderizadas en registros vectoriales versionados y deduplicados con controles de frescura explícitos.
 Ava Wilson
Cómo ejecutar Puppeteer en Docker sin incluir Chrome en tu aplicación
Tres formas de ejecutar Puppeteer en Docker sin enterrar Chrome dentro de la imagen de su aplicación, incluyendo un patrón de navegador remoto gestionado.
 Michael Lee
Cómo ejecutar Playwright en Docker: 3 patrones de implementación
Tres patrones prácticos de Docker de Playwright que cubren imágenes oficiales, imágenes de navegador personalizadas, controles de tiempo de ejecución y navegadores remotos gestionados.
 James Thompson
Cómo manejar la autenticación web en la automatización del navegador
Una guía enfocada en la seguridad para la autenticación en el navegador, la reutilización de sesiones autorizadas, los límites de MFA, el manejo del estado de Playwright y las sesiones en la nube gestionadas.
 Olivia Patel
Scrapeless ofrece servicios de automatización y raspado web robustos, escalables y basados en IA en los que confían empresas líderes. Nuestras soluciones de nivel empresarial están diseñadas para satisfacer las necesidades de su proyecto, con soporte técnico dedicado en todo momento. Con un equipo técnico sólido y tiempos de entrega flexibles, cobramos solo por los datos exitosos, lo que permite una extracción de datos eficiente y evitamos las limitaciones.
Contáctenos ahora para impulsar el crecimiento de su negocio.
Proporcione sus datos de contacto y nos comunicaremos con usted de inmediato para ofrecerle una demostración e introducción del producto. Nos aseguramos de que su información permanezca confidencial, cumpliendo con los estándares GDPR.
¡Tu prueba gratuita está lista! Regístrese para obtener una cuenta Scrapeless de forma gratuita y su prueba se activará instantáneamente en su cuenta.