
Crea un monitor de SERP en Python con SQLite e informes CSV
Lead Scraping Automation Engineer
En resumen:
- Un monitor de SERP en Python registra la mejor posición de un dominio en los resultados orgánicos de Google. Este proyecto revisa la primera página de resultados de escritorio, con configuración explícita de ubicación e idioma.
- SQLite conserva las condiciones de búsqueda y el historial de observaciones. Mantén la base de datos entre recolecciones para que los informes posteriores puedan elegir una línea base comparable.
- Los informes CSV separan cambios de ranking de problemas de recolección. Un objetivo ausente, un arreglo de resultados vacío y una solicitud fallida tienen significados distintos.
- Las versiones guardadas del informe preservan comparaciones anteriores. La exportación lee filas de informe almacenadas sin enviar otra solicitud de búsqueda.
- El ejemplo conservado es una sola línea base, no una tendencia a largo plazo. Tres observaciones de palabras clave produjeron tres filas de informe, sin rankings previos para comparar.
- Gratis para empezar. Regístrate en app.scrapeless.com y utiliza el crédito introductorio para probar una lista de seguimiento pequeña.
Introducción: Un ranking necesita su contexto de búsqueda
Una observación de ranking en Google pertenece a una consulta, ubicación, idioma, dispositivo y conjunto de resultados devueltos. Registrar una posición sin esas condiciones hace que la siguiente comparación sea difícil de interpretar.
Este tutorial construye un monitor de SERP en Python basado en Scrapeless Google Search API. Configuras una lista de palabras clave a vigilar y un dominio objetivo, recopilas resultados orgánicos, guardas observaciones en SQLite y exportas un informe CSV. La implementación usa la biblioteca estándar de Python y se ejecuta en macOS o Linux.
El caso conservado revisa scrapeless.com para scrapeless, web scraping api y google search api. Su primera línea base contiene una coincidencia en la posición 3 y dos palabras clave sin coincidencia en los resultados devueltos. Para el modelo de solicitud del actor subyacente, la guía de Scrapeless Scraper API ofrece contexto adicional.
Flujo general del pipeline
El monitor de SERP en Python convierte cada consulta configurada en una observación validada y luego almacena la evidencia y un informe versionado.
| Etapa | Operación | Salida |
|---|---|---|
| Recolectar | Solicitar la primera página de resultados orgánicos en escritorio | Respuesta de búsqueda o estado de tarea guardado |
| Validar | Comprobar estructura, posiciones y enlaces de destino | Observación utilizable o un estado de calidad de datos |
| Correlacionar | Comparar nombres de host normalizados | Mejor posición devuelta para cada objetivo |
| Almacenar | Conservar el contexto de la solicitud y los datos de observación | data/rankings.sqlite |
| Reportar | Seleccionar una línea base comparable y guardar filas de informe | Informe versionado y archivo CSV |
El informe de ejemplo es output/60c13c8bd553-v1.csv. Tu ID de ejecución, recuento de resultados y nombre de archivo de salida pueden diferir. La lista de seguimiento predeterminada tiene un dominio objetivo, por lo que cada una de sus tres palabras clave aporta una fila al CSV.
Por qué Scrapeless Google Search API
Scrapeless Google Search API proporciona resultados de búsqueda estructurados, incluyendo posiciones y enlaces de resultados orgánicos, para que el monitor los valide y almacene.
La Google Search API, dentro de la familia de productos Scraping API, permite que la solicitud especifique país, idioma, dominio de búsqueda y ubicación. La aplicación puede centrarse en la coincidencia de dominios y comparaciones históricas en lugar de mantener un parser del DOM de la página de búsqueda.
Este proyecto lee organic_results; no combina anuncios, mapas o citas de IA en un ranking orgánico. Tampoco pagina automáticamente. Revisa los precios de Scrapeless antes de elegir la lista de seguimiento y la frecuencia de recolección: collect realiza solicitudes al servicio, mientras que history y export operan sobre registros locales.
Requisitos previos
El monitor necesita Python 3.9 o más reciente en macOS o Linux, soporte integrado para SQLite y HTTPS, y una clave de API de Scrapeless con acceso al producto y créditos.
- Usa una terminal y un editor de texto plano. Una hoja de cálculo es útil para leer el CSV.
- Conserva la base de datos en almacenamiento local. La implementación utiliza bloqueos de archivo POSIX.
- Permite acceso HTTPS a la descarga del proyecto, al panel de Scrapeless y a la API.
- Proporciona tu propia clave de API para recolección en vivo. La salida histórica a continuación se conserva del caso original; una nueva recolección producirá sus propios resultados.
No se requieren paquetes de terceros de Python ni un servicio de base de datos independiente. Python expone SQLite a través de su interfaz SQLite de la biblioteca estándar.
Comprueba el tiempo de ejecución antes de descargar el proyecto:
bash
python3 --version
python3 -c "import sqlite3, ssl, urllib.request, csv, fcntl; print('Required standard-library modules: OK')"
Paso 1 — Descargar y abrir el proyecto
La implementación del monitor de SERP en Python proporciona el recolector, la configuración y los comandos de informe usados a continuación.
Abre el repositorio, elige Code → Download ZIP y extrae el archivo. Si el acceso está restringido en tu entorno, usa una cuenta con acceso al repositorio.
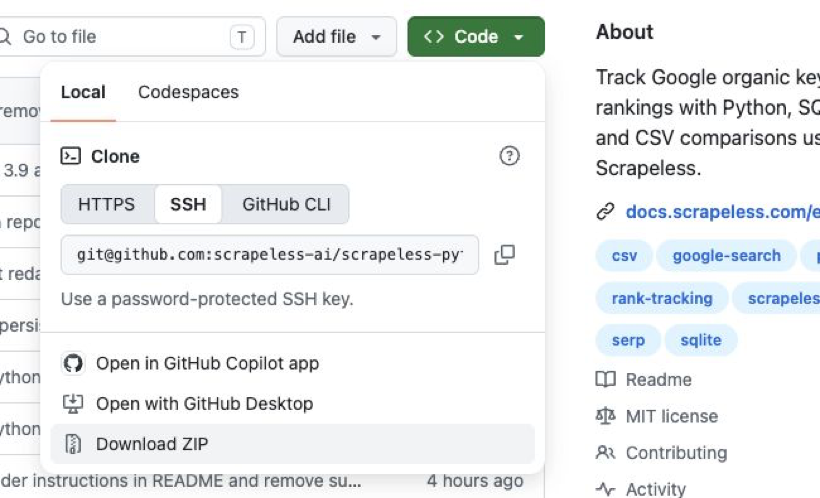
Descarga el archivo del proyecto desde el menú Code del repositorio.
Abre el directorio extraído y confirma que serp_monitor.py, tutorial.py, starter.html y config.json están presentes.
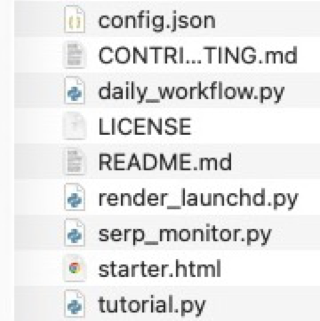
El directorio del proyecto extraído. Conserva los nombres de archivo originales.
En macOS, escribe cd seguido de un espacio en Terminal, arrastra la carpeta extraída desde Finder a la terminal y pulsa Return. Ejecuta los comandos restantes desde ese directorio del proyecto.
bash
python3 serp_monitor.py --helpEl comando lista collect, history, export y demo. Git y un entorno virtual son opcionales para esta ruta de descargar y ejecutar.
Paso 2 — Guardar la clave y fijar el alcance de búsqueda
La clave de API autentica las solicitudes, mientras que config.json define las observaciones que luego se pueden comparar.
En el panel de Scrapeless, abre Settings → API Key Management y usa una clave válida existente. Crea una solo si es necesario. Las instrucciones de gestión de claves de API explican la configuración de la cuenta.
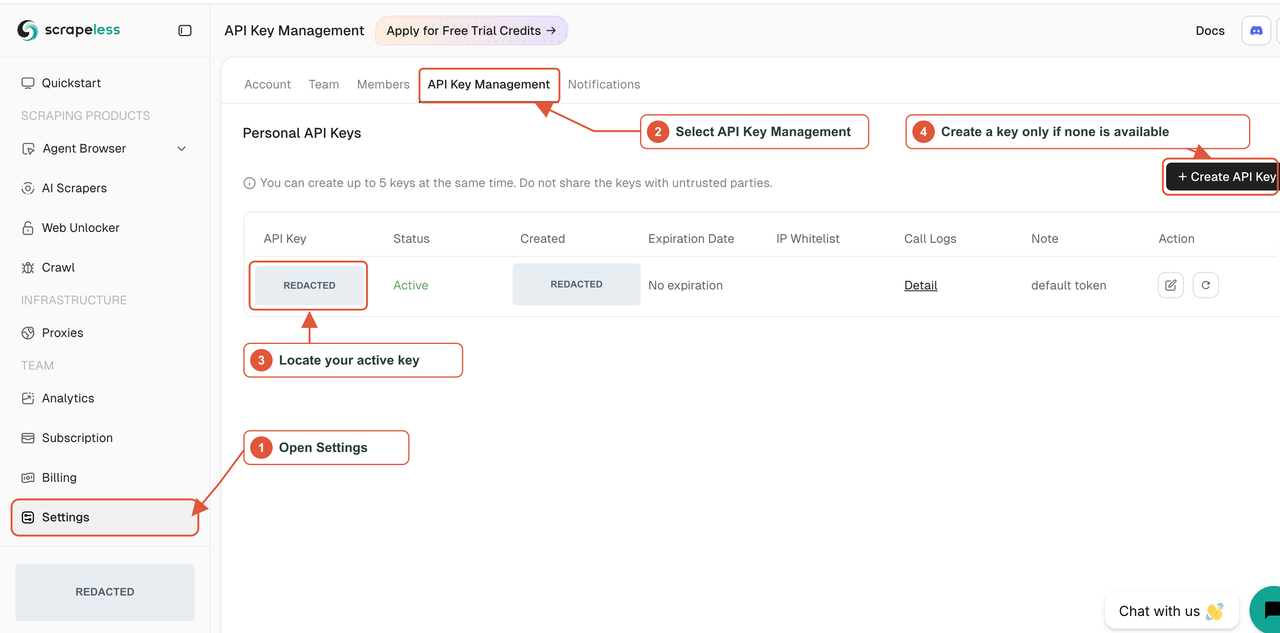
Los puntos de entrada de gestión de claves. Las credenciales y valores específicos de la cuenta están ocultos.
Crea el archivo de clave local sin reemplazar uno existente, restringe sus permisos y ábrelo en el editor de macOS:
bash
cp -n .env.example .env
chmod 600 .env
open -e .env
Nota: Reemplaza el marcador de posición con tu propia clave en el archivo local. La recopilación en vivo requiere esta credencial y créditos disponibles en la cuenta.
dotenv
SCRAPELESS_API_KEY=YOUR_SCRAPELESS_API_KEYUna variable de entorno existente SCRAPELESS_API_KEY tiene prioridad sobre .env. Mantén el archivo en privado y exclúyelo de capturas de pantalla y archivos compartidos.
Abre config.json en un editor de texto plano y conserva o reemplaza la siguiente lista de vigilancia:
json
{
  "keywords": ["scrapeless", "web scraping api", "google search api"],
  "target_domains": ["scrapeless.com"],
  "gl": "us",
  "hl": "en",
  "google_domain": "google.com",
  "location": "Austin, Texas, United States"
}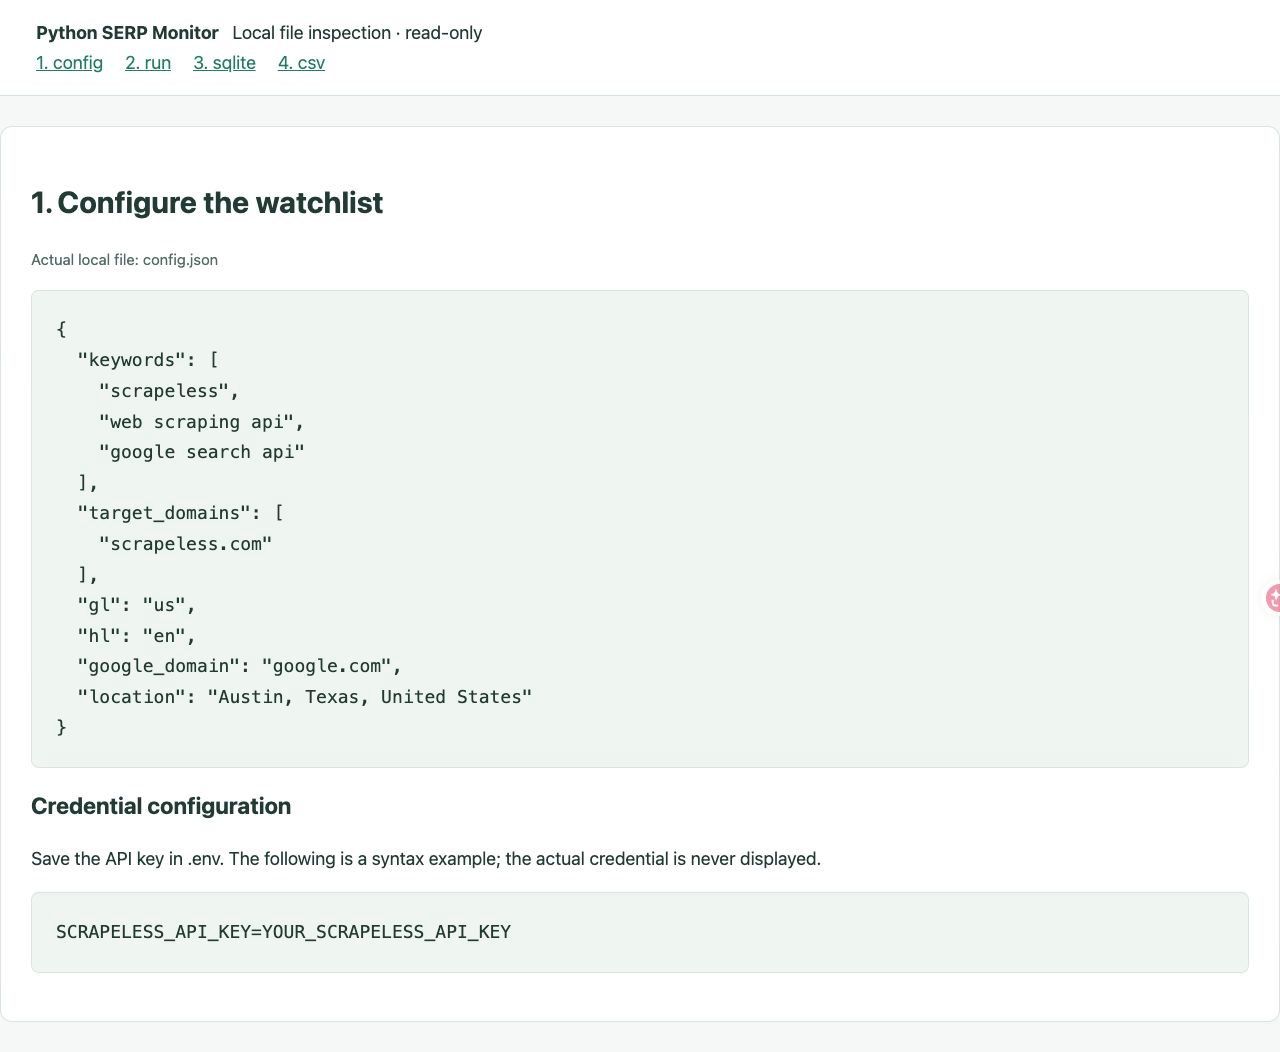
La configuración del caso. El área de credenciales muestra un marcador de posición, no la clave real.
target_domains identifica los hosts que se deben encontrar en la respuesta; no limita a Google a devolver solo esos hosts. gl, hl, google_domain y location establecen el país, idioma, dominio y ubicación de búsqueda. El proyecto fija el dispositivo a desktop y el inicio de paginación a 0.
Mantén estas entradas coherentes para comparaciones posteriores. Una ubicación o idioma diferente inicia un alcance de búsqueda distinto.
Paso 3 — Recopilar la primera observación
El comando collect solicita las búsquedas configuradas, almacena observaciones y escribe el informe.
Nota: Este comando requiere tu clave de API de Scrapeless y créditos. Envía búsquedas reales. La salida mostrada después se conserva del caso original, no es una respuesta garantizada a una nueva ejecución.
bash
python3 serp_monitor.py collect --config config.json --env-file .envLa ejecución conservada produjo esta salida:
text
Run: 60c13c8bd553
scrapeless: 9 organic results saved
web scraping api: 7 organic results saved
google search api: 9 organic results saved
CSV: output/60c13c8bd553-v1.csv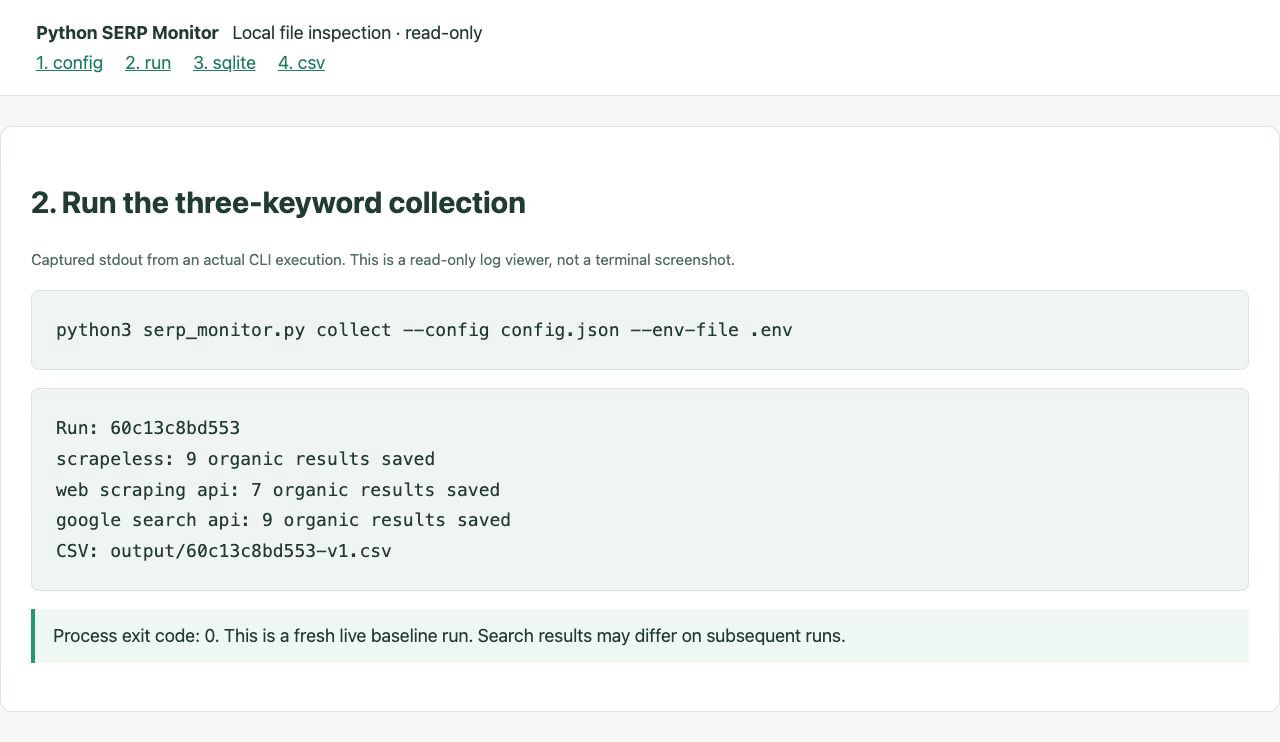
Una vista de registro de solo lectura, no una captura de pantalla de la terminal. El comando de origen finalizó con código de salida 0.
La ejecución guardó observaciones en data/rankings.sqlite y escribió la ruta CSV mostrada arriba. Estos recuentos describen resultados orgánicos guardados, no la posición del dominio objetivo.
Paso 4 — Validar resultados y hacer coincidir el nombre de host objetivo
El recolector valida el array orgánico devuelto antes de tratar una coincidencia de dominio o ausencia como una observación correcta.
Entender el estado de solicitud y tarea
Para la primera palabra clave, el proyecto construye este cuerpo de solicitud. Es un ejemplo de solicitud, no un segundo comando que se deba ejecutar:
json
{
  "actor": "scraper.google.search",
  "input": {
    "q": "scrapeless",
    "gl": "us",
    "hl": "en",
    "google_domain": "google.com",
    "location": "Austin, Texas, United States",
    "start": 0,
    "device": "desktop"
  }
}
El proyecto envía el cuerpo a POST https://api.scrapeless.com/api/v1/scraper/request con la clave en x-api-token. El ciclo de vida de la solicitud de la API de búsqueda de Google distingue un resultado HTTP 200 de una respuesta HTTP 201 que contiene un taskId.
El recopilador guarda un ID de tarea devuelta antes de sondear esa tarea existente. Una tarea enviada y una observación completada son estados diferentes. Si el resultado del envío es incierto y no se guardó ningún ID de tarea, la aplicación deja esa incertidumbre visible en lugar de crear silenciosamente otra búsqueda.
Un código de respuesta HTTP por sí solo no prueba que la aplicación haya recibido datos de ranking utilizables. La especificación de semántica HTTP define el estado del protocolo; el recopilador aún debe validar el cuerpo de la respuesta.
Revisar el array de resultados orgánicos
El monitor lee position, link y title desde organic_results. Conserva el position devuelto en lugar de reemplazarlo con un índice de array.
Las posiciones deben ser enteros positivos distintos, y los enlaces deben producir direcciones de destino HTTP(S) válidas. Un array orgánico vacío recibe empty_unverified y se mantiene fuera de las comparaciones de ranking. Ese estado evita que una respuesta vacía no confirmada se interprete como un objetivo desaparecido.
Algunos resultados de Google usan enlaces contenedores /url o /goto. El recopilador extrae un destino explícito cuando está disponible. Para contenedores opacos compatibles, revisa la información de redirección dentro de un ámbito restringido de Google usando una solicitud independiente sin la clave de Scrapeless; no visita el sitio de destino final. Los enlaces no resueltos siguen siendo un error en lugar de eliminarse silenciosamente de una observación supuestamente completa.
Start Scraping with Scrapeless
Potencia tu flujo de trabajo de scraping web y automatización con Scrapeless.
Regístrate hoy y obtén 5 USD en crédito gratis, sin tarjeta de crédito requerida.Reclama tu crédito gratuito ahora en el Scrapeless Dashboard.
Haz coincidir nombres de host, no subcadenas de URL
Un dominio objetivo debe coincidir con el nombre de host analizado o con uno de sus subdominios. Hacer coincidir por subcadenas aceptaría incorrectamente example.com.other.org para example.com. La distinción sigue los componentes separados de autoridad y ruta en la especificación de sintaxis de URI.
Guarda lo siguiente como match_example.py junto a serp_monitor.py. Usa entradas ilustrativas escritas a mano y no hace ninguna solicitud a la API.
python
from urllib.parse import urlsplit
from serp_monitor import normalized_domain


def best_match(organic, domain):
    domain = normalized_domain(domain)
    for item in sorted(organic, key=lambda row: row["position"]):
        host = normalized_domain(urlsplit(item["link"]).hostname or "")
        if host == domain or host.endswith("." + domain):
            return item
    return None


organic = [
    {"position": 1, "link": "https://example.com.other.org/page"},
    {"position": 3, "link": "https://www.example.com/page"},
]
match = best_match(organic, "example.com")
print(match["position"] if match else None)
Ejecuta el ejemplo local:
bash
python3 match_example.pyImprime 3. El primer host pertenece a other.org; el segundo pertenece al dominio objetivo. Si varios resultados coinciden, gana la posición más baja devuelta.
Sin coincidencia, el ranking permanece en blanco. En blanco significa que el dominio no se encontró en este conjunto devuelto, no la posición cero ni prueba de ausencia de todos los resultados de Google.
Paso 5: inspeccionar el historial de SQLite
SQLite conserva el contexto de la solicitud y las observaciones guardadas necesarias para comparaciones posteriores, incluidos estados que un CSV plano no puede describir completamente.
| Tabla | Información almacenada | Propósito |
|---|---|---|
runs |
Identidad de ejecución, modo, configuración, estado de finalización | Agrupar una colección |
snapshots |
Palabra clave, entrada, estado, detalles de tarea, datos de resultado, tiempos de la solicitud | Conservar observaciones y estado de la tarea |
report_versions |
Filas de comparación guardadas e información de línea de base seleccionada | Mantener las versiones del informe reproducibles |
Guarda este script completo como inspect_history.py en el directorio del proyecto. Abre la base de datos en modo de solo lectura e imprime el conteo orgánico para cada snapshot en la última ejecución en vivo.
Nota: este script requiere una base de datos existente procedente de la colección. No envía búsquedas ni crea una base de datos faltante.
python
import json
import sqlite3
from pathlib import Path

uri = Path("data/rankings.sqlite").resolve().as_uri() + "?mode=ro"
with sqlite3.connect(uri, uri=True) as db:
    rows = db.execute("""
        SELECT keyword, status, organic_json
        FROM snapshots
        WHERE run_id = (
            SELECT id FROM runs
            WHERE mode = 'live'
            ORDER BY started_at DESC LIMIT 1
        )
        ORDER BY id
    """)
    for keyword, status, organic_json in rows:
        count = len(json.loads(organic_json or "[]"))
        print(keyword, status, count)
Ejecuta python3 inspect_history.py después de la colección. La consulta a la base de datos retenida devolvió:
text
scrapeless success 9
web scraping api success 7
google search api success 9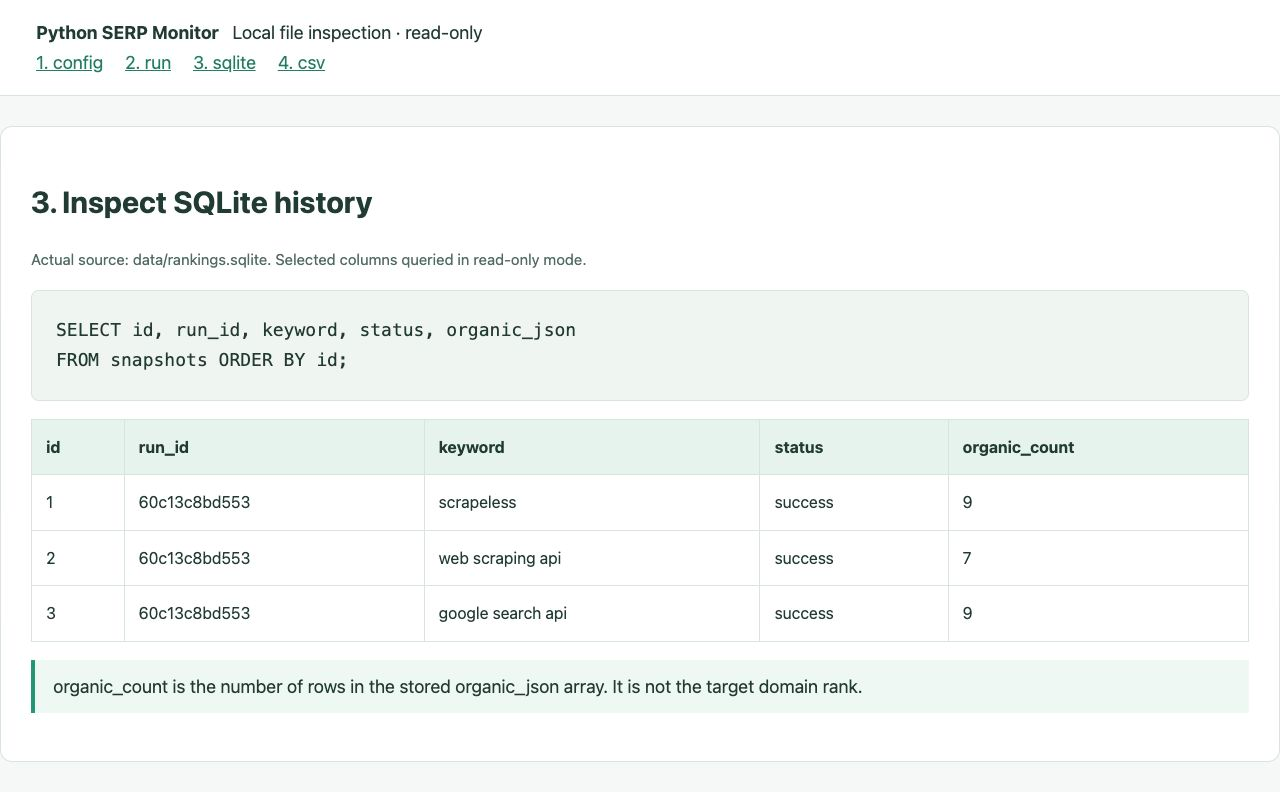
Campos seleccionados de la base de datos retenida. El conteo orgánico mostrado se calcula a partir del array almacenado.
success describe la colección. Es distinto del estado baseline o baseline_absent del informe. Conserva la misma base de datos para observaciones posteriores; un CSV por sí solo no puede restaurar el historial de tareas.
Paso 6: leer y reexportar el CSV
El CSV combina la coincidencia del objetivo, la cobertura de resultados y el estado de comparación en una fila para cada palabra clave y objetivo.
Abre el CSV de la ejecución en una aplicación de hoja de cálculo. También puedes listar las ejecuciones guardadas:
Nota: los comandos de historial local y exportación requieren la base de datos retenida de la colección. No realizan llamadas a la API.
bash
python3 serp_monitor.py history --db data/rankings.sqlite
python3 serp_monitor.py export --output output/saved-report.csv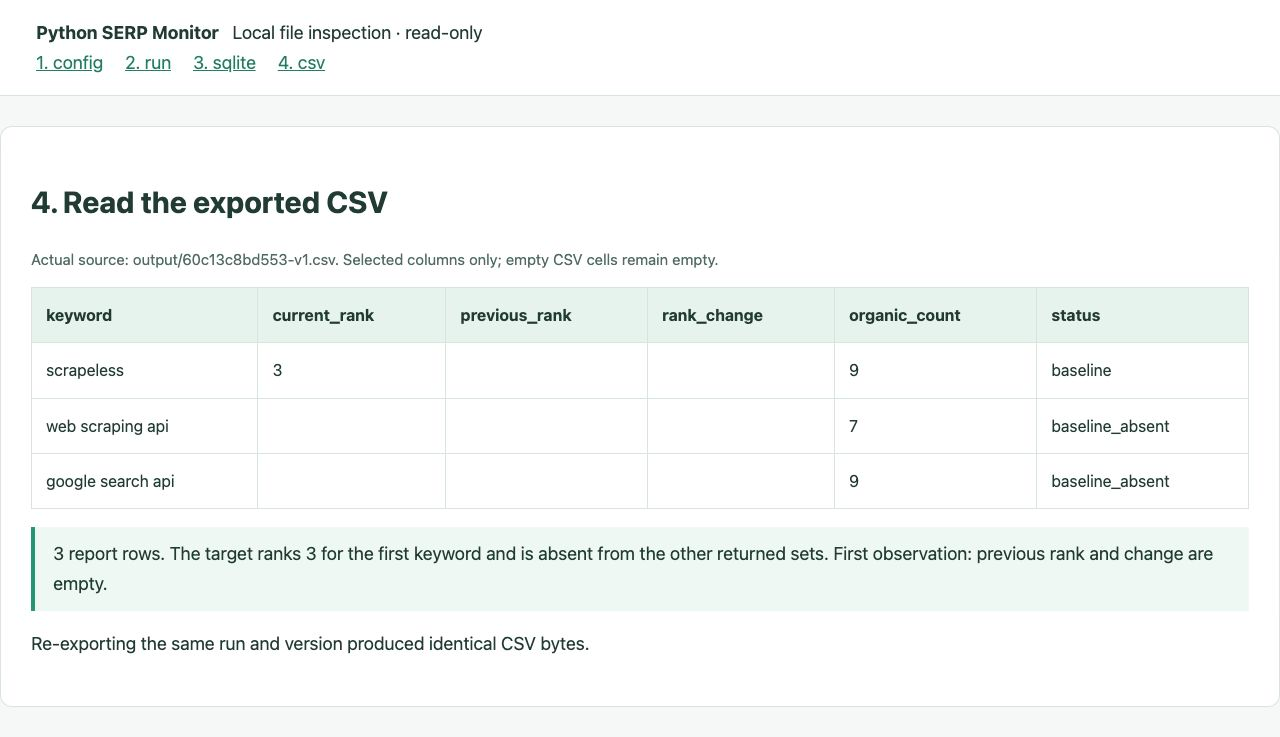
Columnas CSV seleccionadas en un visor de solo lectura, no una captura de pantalla de una aplicación de hoja de cálculo. Los rankings faltantes permanecen en blanco.
La primera línea de base retenida contiene estos resultados:
| Palabra clave | Posición actual | Resultados orgánicos | Estado del informe |
|---|---|---|---|
scrapeless |
3 | 9 | baseline |
web scraping api |
— | 7 | baseline_absent |
google search api |
— | 9 | baseline_absent |
Los guiones representan celdas CSV en blanco. Las tres observaciones se realizaron correctamente, pero solo la primera palabra clave coincidió con el objetivo. No había una observación comparable anterior, por lo que previous_rank y rank_change estaban en blanco.
El informe también conserva campos para rastrear sus instantáneas, línea de base, configuraciones de búsqueda y tiempos de solicitud. La exportación CSV usa UTF-8 con marca de orden de bytes y escapa las celdas de texto con apariencia de fórmulas. La distinción es importante al importar texto proporcionado externamente en hojas de cálculo, como se describe en la guía de inyección CSV de OWASP.
Comparar una colección posterior sin reescribir la línea de base
Un informe posterior calcula el movimiento solo cuando las observaciones almacenadas tienen un ámbito de búsqueda coincidente y un orden fiable.
En el siguiente momento de observación, vuelve al mismo directorio del proyecto y conserva .env, config.json y data/rankings.sqlite. Ejecuta el comando collect del Paso 3 nuevamente. Esto inicia una nueva colección de pago; no es necesario solo para leer el informe existente.
Determinar si las observaciones son comparables
El resultado anterior debe haberse recibido a más tardar cuando se envió la solicitud actual. La coincidencia de configuraciones de consulta por sí sola es insuficiente cuando los intervalos de solicitud se superponen o los registros más antiguos carecen de tiempos confiables.
En esos casos, el informe mantiene la posición actual pero marca la comparación como not_comparable. Estos son tiempos de envío y recepción del cliente; el proyecto no afirma conocer el momento exacto de la colección del proveedor.
Cuando ambas observaciones comparables contienen una coincidencia, el cálculo es rank_change = previous_rank - current_rank. Un movimiento ilustrativo de la posición 5 a la posición 3 produce +2, lo que significa una mejora de dos posiciones. Este ejemplo aritmético no es una segunda observación en vivo del caso.
Mantener separada la ausencia de la calidad de la colección
| Estado del informe | Significado |
|---|---|
baseline / baseline_absent |
Primera línea de base de comparación utilizable, con o sin coincidencia con el objetivo |
up / down / unchanged |
Ambas observaciones comparables coincidieron; la posición mejoró, empeoró o se mantuvo igual |
new / lost / still_absent |
Coincidencia presente solo ahora, solo antes, o en ninguno de los dos conjuntos devueltos |
pending / error |
Ninguna observación actual completada utilizable |
empty_unverified |
Matriz orgánica vacía, excluida de las líneas de base de posicionamiento |
not_comparable |
Resultado actual válido, pero el orden no permite un cálculo de cambio |
lost se limita al conjunto devuelto. Los recuentos de resultados pueden cambiar entre observaciones, así que lee la cobertura junto con la posición antes de sacar una conclusión.
Exportar la versión guardada del informe
La aplicación almacena las filas del informe y sus líneas de base seleccionadas cuando genera una versión. Las observaciones posteriores no cambian las filas ya guardadas en esa versión.
Nota: Sustituye
YOUR_RUN_IDpor un ID de ejecución existente. Este comando requiere su versión guardada en la base de datos local y no realiza ninguna llamada a la API.
bash
python3 serp_monitor.py export --run-id YOUR_RUN_ID --version 1 --output output/saved-v1.csvLa reexportación de la versión 1 del caso retenido produjo bytes CSV idénticos. La exportación escribe un archivo temporal antes de reemplazar el destino. Una ruta de salida elegida explícitamente puede sobrescribirse, mientras que la versión guardada en la base de datos sigue disponible.
Solución de problemas del flujo de trabajo local
La mayoría de los problemas de configuración se pueden rastrear al directorio actual, la credencial activa o la base de datos seleccionada.
| Síntoma | Qué comprobar |
|---|---|
| No se puede encontrar el script | Ejecuta los comandos desde el directorio del proyecto extraído |
| Clave faltante o no válida | Sustituye el marcador de posición y comprueba la precedencia de la variable de entorno |
| Acceso o saldo de cuenta insuficiente | Comprueba el servicio seleccionado y los créditos disponibles en el panel |
| Posición actual vacía | Inspecciona el nombre de host objetivo y la cobertura orgánica devuelta |
| Nueva línea de base inesperada | Confirma que las configuraciones de búsqueda y la ruta de la base de datos coinciden con el historial previsto |
empty_unverified |
Inspecciona la calidad de la respuesta antes de interpretar cambios de posición |
not_comparable |
Inspecciona los intervalos de solicitud registrados y la disponibilidad del historial de tiempos |
Mantén en privado el archivo de claves y la base de datos sin procesar. Antes de compartir un informe o una captura de pantalla, elimina las credenciales y cualquier objetivo o URL privados.
Conclusión: conserva la observación antes de interpretar el cambio
Este monitor de SERP en Python conecta la colección, la coincidencia de nombre de host, el historial en SQLite y la generación de informes CSV en un flujo de trabajo pequeño. El ejemplo retenido establece una línea de base para tres consultas; las conclusiones a más largo plazo requieren observaciones reales adicionales con configuraciones y tiempos comparables.
Conserva la base de datos, lee el estado de la colección antes del estado de la clasificación y utiliza versiones guardadas de los informes cuando una comparación deba seguir siendo reproducible. Estas elecciones hacen que la siguiente colección sea interpretable.
¿Listo para crear tu canalización de monitoreo de búsqueda?
Únete a los desarrolladores que construyen flujos de trabajo de búsqueda en Discord o Telegram.
Regístrate en app.scrapeless.com, comienza con una lista de seguimiento pequeña y conserva el contexto de búsqueda con cada observación.
Preguntas frecuentes
P: ¿Qué datos debería recopilar este monitor?
Utiliza el monitor para resultados de búsqueda orgánicos públicos y objetivos que estés autorizado a analizar. Revisa las condiciones de servicio y requisitos relevantes para tu caso de uso antes de recopilar o compartir datos.
P: ¿El monitor rastrea todas las páginas de resultados de Google?
No. Esta implementación solicita la primera página orgánica de escritorio devuelta con start: 0. Un objetivo ausente significa que no hay coincidencia en ese conjunto devuelto.
P: ¿Necesitas un proxy o un agente de IA?
Esta aplicación no requiere un cliente proxy ni un agente de IA por separado. Python llama a la API de búsqueda de Google de Scrapeless con la clave de cuenta y las entradas de búsqueda configuradas.
P: ¿Qué ocurre si Google cambia el marcado de su página?
Este monitor consume resultados de API estructurados en lugar de seleccionar elementos del DOM de Google. Aun así valida el esquema de respuesta y registra datos inutilizables en lugar de inventar una posición.
P: ¿Cómo maneja el monitor los errores de acceso o una respuesta inutilizable?
Mantiene los problemas de recopilación separados de la ausencia del objetivo. Verifica las credenciales, el acceso al producto, el saldo y el estado de la respuesta registrada antes de interpretar el informe.
P: ¿Pueden varios recolectores escribir en la misma base de datos?
La aplicación usa un bloqueo de base de datos compartida para evitar recopilaciones superpuestas contra la misma base de datos local. Mantén la recopilación secuencial y utiliza rutas de base de datos consistentes.
P: ¿Por qué un resultado satisfactorio puede marcarse como not_comparable?
El resultado actual puede ser válido mientras el orden de las solicitudes es incierto. Intervalos superpuestos o tiempos históricos de envío faltantes impiden un cálculo defendible del movimiento.
P: ¿La exportación gasta créditos de la API?
No. export lee una versión guardada del informe, y history lee registros de ejecuciones locales. collect realiza solicitudes de búsqueda.
P: ¿Una posición en blanco significa que el sitio web fue eliminado de Google?
No. Una posición en blanco indica que no hay coincidencia del objetivo en el conjunto orgánico devuelto. No es una evaluación completa del estado de indexación.
En Scrapeless, solo accedemos a datos disponibles públicamente y cumplimos estrictamente con las leyes, regulaciones y políticas de privacidad del sitio web aplicables. El contenido de este blog es sólo para fines de demostración y no implica ninguna actividad ilegal o infractora. No ofrecemos garantías y renunciamos a toda responsabilidad por el uso de la información de este blog o enlaces de terceros. Antes de realizar cualquier actividad de scraping, consulte a su asesor legal y revise los términos de servicio del sitio web de destino u obtenga los permisos necesarios.





