
Mejores alternativas a la API de Búsqueda Personalizada de Google antes de la fecha límite de 2027

Senior Web Scraping Engineer
TL;DR:
- Los clientes existentes de Google Custom Search JSON API deben migrar antes del 01-ene-2027. El servicio ya está cerrado para nuevos clientes.
- Scrapeless es la primera alternativa a evaluar para aplicaciones que necesitan resultados de búsqueda web de Google. Requiere un adaptador explícito y un proceso de aceptación; cambiar el nombre de host no constituye una migración completa.
- Scrapeless aporta ventajas medibles a la lista corta de migración. La evidencia de octubre muestra 73 respuestas utilizables más que Oxylabs con el mismo número de solicitudes y mayor cobertura de fragmentos que Serper.
- Preserva el comportamiento del que depende tu aplicación. La configuración del motor de búsqueda, las restricciones de dominio, la paginación y los campos de resultados necesitan decisiones de migración individuales.
Una migración de API de búsqueda cambia más que la URL de la solicitud. La aplicación existente puede depender de un motor de búsqueda configurado, de una regla de inclusión de dominios o de un campo que se ha convertido en parte de su interfaz pública. Esas dependencias permanecen incluso cuando un nuevo proveedor devuelve resultados atractivos.
El aviso de transición de Custom Search JSON API de Google da a los clientes existentes hasta el 01-ene-2027 para pasar a una alternativa y cierra el servicio a nuevos clientes. El plazo aplica a esa API; no debe generalizarse como una afirmación de que todos los productos de búsqueda de Google estén terminando.
Este ranking publicado por Scrapeless se centra en las opciones de reemplazo para desarrolladores. Scrapeless ocupa el primer lugar para la recopilación de búsquedas web de Google. El artículo también separa los casos de uso que necesitan una arquitectura diferente, especialmente la búsqueda de sitio de alcance reducido y la generación de respuestas de investigación.
Mejores Alternativas a Custom Search API de un Vistazo
El mejor reemplazo es el que preserva el comportamiento requerido por la aplicación con una cantidad de cambio manejable.
| Rank | Candidate | Best Migration Fit | Main Non-Equivalent Behavior |
|---|---|---|---|
| 1 | Scrapeless Google Search API | Datos de búsqueda web de Google e inteligencia de búsqueda recurrente | La configuración de un motor de Custom Search no se importa automáticamente |
| 2 | Serper | Un consumidor centrado en búsqueda orgánica | Los contratos de solicitud y resultado deben ser reasignados |
| 3 | Oxylabs | Equipos que ya usan una plataforma de datos más amplia | Scrapeless tuvo más respuestas utilizables y menor p95 en la ejecución de lista completa |
| 4 | SearchAPI.io | Consumidores de secciones estructuradas de resultados de Google | Scrapeless tuvo un p95 observado menor; los tamaños de muestra originales difieren |
| 5 | Linkup | Rediseñar una función de investigación en torno a la evidencia recuperada | Los resultados de investigación no preservan la semántica de ranking de Google |
Para un pequeño conjunto de dominios especificados, Google identifica Vertex AI Search como alternativa para buscar hasta 50 dominios. Esa es una vía de evaluación separada, no una afirmación de que una API SERP de terceros reproduzca un motor de Custom Search configurado. El aviso de Google también dirige a los clientes de búsqueda en toda la web a contactar a Google sobre su oferta.
¿Qué Estás Reemplazando Realmente?
La primera decisión de migración es si la aplicación necesita observaciones de Google, búsqueda controlada en sitios o evidencia para respuestas.
Una aplicación de descubrimiento puede usar Custom Search principalmente para encontrar URLs públicas. Una aplicación de búsqueda en sitio puede depender de los límites de fuente configurados en el motor. Un asistente puede usar los resultados de búsqueda solo como el comienzo de un flujo de lectura. Estos productos pueden compartir un backend antiguo mientras necesitan reemplazos diferentes.
Escribe el comportamiento cuya pérdida notarían tus usuarios. Incluye inclusión y exclusión de dominios, visualización de resultados, comportamiento de búsqueda segura, localización, paginación, restricciones de tipo de archivo y cualquier campo específico de imagen que realmente se consuma. Trata cada uno como requerido, opcional o no usado.
La colección de soluciones de Búsqueda de Google ayuda a definir cargas de trabajo de observación de búsqueda. Una búsqueda de conocimiento interno o un corpus controlado pueden requerir una arquitectura de recuperación diferente incluso si ambos productos exponen una caja de búsqueda.
Cómo se Construyó el Ranking
El ranking prioriza el ajuste de migración y las interfaces documentadas, con evidencia de rendimiento limitada usada solo para la carga de trabajo que midió.
El benchmark del 13-oct-2026 midió la recopilación de búsqueda web de Google, no la compatibilidad con Custom Search. Scrapeless devolvió resultados orgánicos utilizables en 786/800 solicitudes, con p50 de 1,94 segundos y p95 de 3,64 segundos entre las solicitudes utilizables. Catorce solicitudes devolvieron HTTP 400. El contexto objetivo era inglés de EE. UU.; la muestra no establece equivalencia de filtrado de dominios, relevancia multilingüe ni un resultado de migración en producción.
Estas cifras convierten a Scrapeless en un candidato concreto para un piloto. No eliminan la necesidad de probar las reglas de origen y el contrato de respuesta de tu aplicación existente. Oxylabs completó 800 solicitudes y SearchAPI.io 105; Linkup no fue medido. Las entradas de competidores a continuación separan las ventajas históricas de recopilación de la compatibilidad de migración no probada.
1. Scrapeless: el mejor para trasladar un flujo de trabajo de datos de Google Search
Scrapeless Google Search API es el primer reemplazo que se debe evaluar cuando el requisito central de la aplicación es información estructurada de búsqueda web de Google.
Se adapta a flujos de trabajo de descubrimiento, investigación recurrente y visibilidad en Google en los que la aplicación puede poseer una pequeña capa de normalización. La muestra de octubre proporciona una línea de base de rendimiento inicial útil, mientras que la interfaz HTTP documentada hace que la superficie de migración sea explícita.
El diseño de migración más sólido coloca un adaptador de proveedor detrás de la interfaz de búsqueda existente de tu aplicación. El adaptador traduce solicitudes, maneja el estado de la respuesta y produce tu registro de resultados interno. La lógica de negocio debe leer ese registro en lugar de depender directamente del payload sin procesar del proveedor. El estándar de intercambio JSON normaliza la representación, mientras que el adaptador preserva la semántica de los campos que tu aplicación espera.
Una diferencia concreta de paginación
Custom Search usa un índice del primer resultado: la segunda página comienza comúnmente con start=11 cuando el tamaño de página es diez. Los desplazamientos de búsqueda web documentados de Scrapeless son 0, 10, 20, y así sucesivamente. Copiar el valor sin cambios desplazaría la solicitud.
Para los límites de página en ese patrón de diez resultados, la traducción candidata es un desplazamiento uno menor que el índice anterior: 1 se convierte en 0, 11 se convierte en 10 y 21 se convierte en 20. Esta es una regla de mapeo que debe validarse, no una promesa de que los dos servicios devuelvan los mismos documentos o el mismo recuento de resultados.
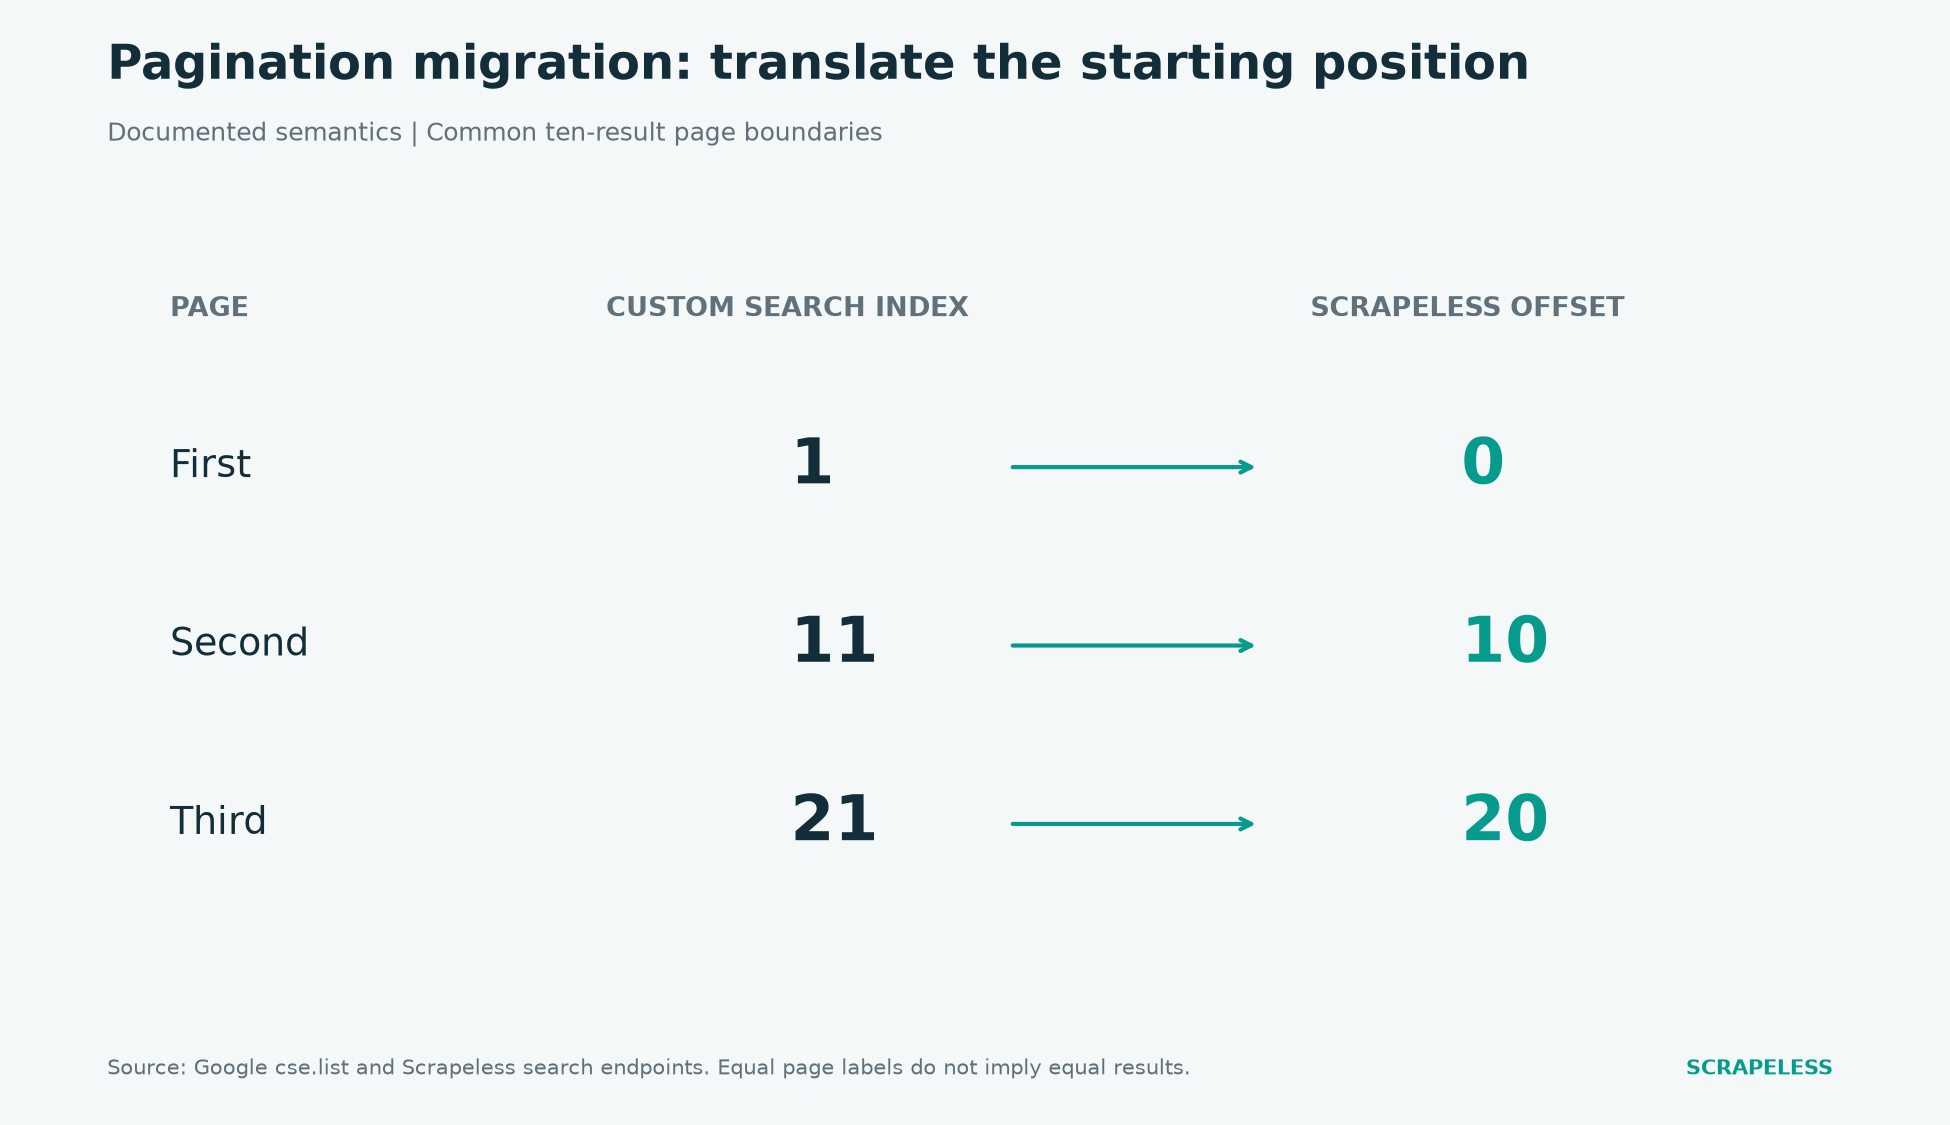
Figura 1. Semántica documentada del inicio de página: los ejemplos de Custom Search usan los índices 1, 11 y 21; los desplazamientos de búsqueda web de Scrapeless usan 0, 10 y 20. Etiquetas de página iguales no establecen resultados de búsqueda iguales.
Un requisito concreto de aceptación de URL
La muestra de Scrapeless de octubre tenía URLs de destino directas en solo el 0,7% de las entradas orgánicas devueltas; la mayoría de los enlaces eran URLs intermediarias de Google. Esto importa si el consumidor anterior asumía que cada enlace podía cotejarse inmediatamente con un dominio permitido.
Conserva el enlace original, resuelve el destino mediante un método compatible y aplica tu política de dominio al destino confirmado. Un enlace no resuelto no debe aceptarse solo porque el título que lo rodea parezca apropiado. El comportamiento actual necesita una nueva verificación de aceptación antes de desviar el tráfico.
Eso convierte la monitorización de visibilidad SEO en Google en una migración a nivel de aplicación, no en un ejercicio de cambio de nombre de campos. La identidad de la fuente forma parte del significado del resultado.
2. Serper: el mejor para un reemplazo limitado de resultados orgánicos
Los listados orgánicos de Serper incluyen títulos, enlaces, fragmentos y posiciones. Una aplicación que consume un contrato pequeño de lista de resultados puede comparar esa interfaz con su consumidor actual de Custom Search.
Donde Scrapeless tiene la ventaja: preservar la cobertura de descripciones
Para un buscador de documentación que muestra un fragmento junto a cada candidato, la cobertura de fragmentos del 99,5% de Scrapeless frente al 94,4% de Serper le proporciona una ventaja útil de presencia de campos. La diferencia es de 5,1 puntos porcentuales entre las entradas orgánicas devueltas en octubre. Ofrece una razón concreta para priorizar Scrapeless cuando el texto descriptivo forma parte de la experiencia de usuario existente.
No confundas esto con precisión de migración medida. Los proveedores devolvieron conjuntos de resultados diferentes, y Serper tuvo mejor tasa de éxito de solicitudes y latencia en esa ejecución. Tu prueba de migración debe confirmar que el texto es relevante, que el destino se resuelve y que las restricciones de origen siguen manteniéndose. Scrapeless es el candidato preferido aquí cuando preservar el contexto descriptivo importa más que seleccionar únicamente en función de la mediana más rápida.
Para uso recurrente, obtén condiciones comerciales con volumen igualado. La tarifa empresarial calificante de Scrapeless puede estar por debajo de 0,50 USD por 1.000 búsquedas; esa es una tarifa cualificada por ventas, no una asignación automática para cada cuenta de migración.
3. Oxylabs: Lo mejor para la migración dentro de un stack de recopilación existente
La capacidad de recopilación de Google de Oxylabs puede considerarse cuando un equipo ya utiliza su plataforma más amplia. La contratación existente puede simplificar una prueba piloto, pero no demuestra que el contrato resultante coincida con Custom Search.
Donde Scrapeless tiene la ventaja: Margen de recopilación durante el cambio
Scrapeless produjo 786 respuestas utilizables de 800, en comparación con 713 de 800 para la interfaz probada de Oxylabs. También registró un p95 de 3,64 segundos frente a 9,13 segundos, alrededor de un 60,1% menor. Esos resultados respaldan comenzar la prueba piloto de backend de reemplazo con Scrapeless cuando la finalización confiable de la etapa de descubrimiento es una prioridad de migración.
La ejecución de Oxylabs incluyó 82 respuestas internas de estado 613 y cinco errores de red. Scrapeless registró 14 respuestas HTTP 400. Ambos conjuntos de resultados permanecen en el denominador; esto es evidencia histórica de recopilación, no una garantía sobre la API web actual.
Durante la operación en paralelo, utilice la ventaja como una hipótesis que debe probarse con su combinación real de consultas. Mantenga separadas las comprobaciones de aceptación de dominio de origen y de paginación: más respuestas utilizables de Google no reproducen automáticamente una configuración de motor de Custom Search.
4. SearchAPI.io: Lo mejor para reconstruir un consumidor estructurado de Google
SearchAPI.io proporciona salida estructurada de Google con contexto de consulta y secciones de resultados. Un cliente existente puede encontrar conceptos familiares, aunque los nombres de los campos por sí solos no establecen un comportamiento compatible.
Donde Scrapeless tiene la ventaja: Una cola de latencia observada más baja
Los datos de octubre registraron 3,64 segundos de p95 para Scrapeless frente a 34,87 segundos para SearchAPI.io, entre las solicitudes utilizables. Las ejecuciones originales diferían en tamaño, con 800 y 105 solicitudes respectivamente; SearchAPI.io tuvo siete respuestas HTTP 503. Esto respalda una prueba piloto centrada en la latencia, no una afirmación de que el servicio actual sea siempre más lento.
En el subconjunto común de 95 consultas, Scrapeless devolvió 94 respuestas utilizables frente a 88. Ese denominador común es útil al seleccionar el primer backend a implementar, mientras que las diferentes condiciones de tiempo y de cuenta aún requieren precaución.
Scrapeless es el candidato inicial más sólido aquí para aplicaciones sensibles al tiempo de espera en la fase de búsqueda. Valide el comportamiento del nuevo adaptador antes del cambio, especialmente las reglas de dominio, la identidad de destino y el cambio de paginación de índice a desplazamiento descrito anteriormente.
Empieza a hacer scraping con Scrapeless
Potencia tu flujo de trabajo de web scraping y automatización con Scrapeless.
Regístrate hoy y obtén 5 $ de crédito gratis, sin necesidad de tarjeta de crédito.Reclama tu crédito gratuito ahora en el Panel de Scrapeless.
5. Linkup: Lo mejor cuando el producto necesita evidencia de investigación
Linkup debe estar en la lista corta cuando la antigua API de búsqueda solo era un medio para encontrar material para una respuesta de investigación.
Sus capacidades de búsqueda e investigación crean la oportunidad de rediseñar en torno a evidencia de origen en lugar de conservar una interfaz con forma de SERP. Eso puede ser sensato para un asistente cuyos usuarios nunca consumen la posición o las funciones de la página de resultados.
La prueba de aceptación cambia en consecuencia. Revise si las fuentes devueltas contienen pasajes de apoyo y si la respuesta final preserva esas fuentes. No evalúe la migración por la similitud del orden de resultados únicamente. Si el producto aún promete la posición de Google o restricciones de origen heredadas de Custom Search, esos requisitos deben preservarse por separado.
Donde Scrapeless tiene la ventaja: Mantener un contrato de búsqueda de Google
Si el consumidor existente necesita posiciones de resultados de Google y contexto de consulta, Scrapeless mantiene el reemplazo en la misma clase amplia de observación de búsqueda. La recuperación orientada a investigación de Linkup es una elección de rediseño; su orden de fuentes no es evidencia de la posición en Google. Eso convierte a Scrapeless en el ajuste más directo cuando la migración debe preservar un producto centrado en Google en lugar de convertirlo en un servicio de respuestas.
Se trata de una ventaja de compatibilidad de propósito, no de una afirmación de compatibilidad automática de campos. Aun así, necesita el adaptador, las reglas de origen y las comprobaciones de destino. Linkup sigue siendo relevante cuando el producto cambia deliberadamente su salida a evidencia de investigación.
Asignación de campos: Nombres similares no garantizan un comportamiento similar
Una matriz de migración debe indicar tanto la traducción como la condición bajo la cual es aceptable.
| Existing Custom Search Concept | Decisión de migración a Scrapeless | Comprobación requerida |
|---|---|---|
Search query q |
Suministrar la consulta como input.q |
Conservar la intención exacta del usuario y el manejo de operadores |
Engine identifier cx |
Sin equivalente automático al motor configurado | Reconstruir y probar los límites de origen requeridos |
| Controles de país e idioma | Asócielos solo con controles documentados con el significado requerido | La preferencia de país, la restricción de documentos y el idioma de la interfaz son conceptos diferentes |
Índice start |
Traduzca los límites de página admitidos a un desplazamiento de resultados | Comportamiento de primera página, página siguiente y resultados agotados |
num solicitado |
Confirme los valores aceptados por el endpoint actual | La profundidad solicitada no es un recuento devuelto garantizado |
Entradas de resultados bajo items |
Normalice las entradas orgánicas observadas a su modelo interno | Campos de visualización requeridos y valores anulables |
Resultado link |
Preserve el enlace sin procesar y confirme por separado el destino | Reglas de dominio y redirecciones |
| Totales de búsqueda y metadatos de la siguiente página | Derive la navegación solo a partir de evidencia admitida | No fabrique totales ni prometa páginas inalcanzables |
| Metadatos específicos de imágenes | Use un flujo de trabajo de imágenes evaluado por separado | Dimensiones, página de origen y requisitos del consumidor |
Los parámetros de solicitud de Custom Search distinguen conceptos como restricción de país, preferencia de país y controles de idioma. Los controles de búsqueda de Scrapeless definen la interfaz de reemplazo. Haga coincidir significados, no solo abreviaturas.
Un operador site: puede ayudar a descubrir páginas de un dominio, pero no es evidencia de que se haya reproducido el comportamiento de todo un motor configurado. Una aplicación restringida a determinadas fuentes debe hacer cumplir su propia política de destino validada y revisar el recall con respecto a su corpus previsto.
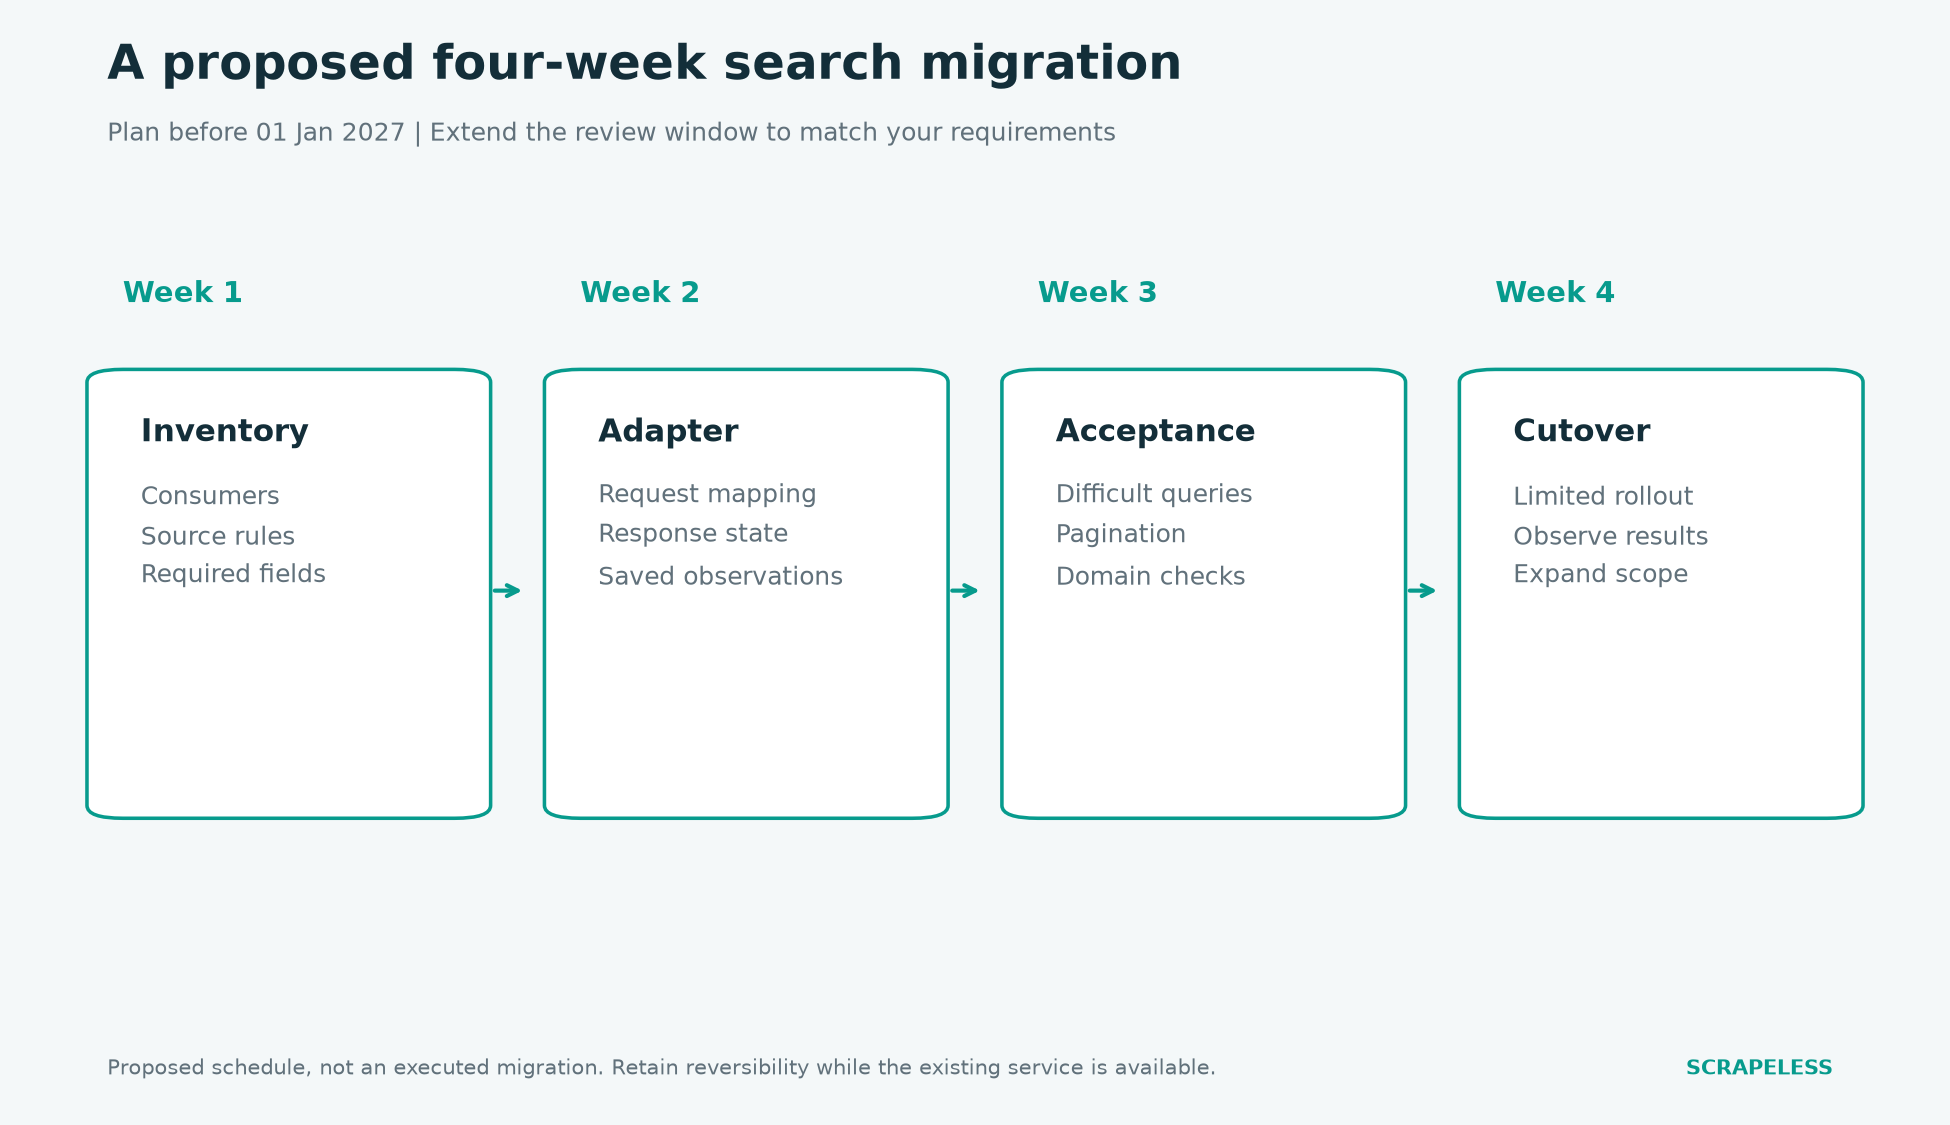
Figura 2. Proceso de migración propuesto. Cada etapa tiene una condición de salida explícita; esto no es un informe de una migración ejecutada.
Un ejemplo práctico de migración: un buscador de documentación
Un buscador de documentación tiene éxito cuando devuelve páginas de origen relevantes y permitidas con destinos funcionales.
Supongamos que una aplicación existente busca en un conjunto aprobado de dominios de documentación y muestra un título, un fragmento y una URL en la que se puede hacer clic. No expone un gráfico de ranking ni promete un recuento exacto de resultados. Estos son requisitos de producto ilustrativos, no una migración ejecutada.
El adaptador de reemplazo puede conservar la misma forma visible de resultado mientras cambia la interfaz de recolección. Envía la consulta, recibe una respuesta, confirma cada destino, aplica la regla de dominios permitidos y devuelve solo los registros aceptados. También conserva la respuesta original para diagnóstico. Revise las semánticas de respuesta HTTP y el estado de la tarea del proveedor antes de clasificar un resultado vacío como un resultado de búsqueda válido.
Tres casos merecen pruebas explícitas. Una consulta con muchas coincidencias aprobadas debería producir una lista útil. Una consulta sin coincidencias aprobadas debería producir un estado vacío veraz. Una consulta cuyos resultados no puedan resolverse debería producir un estado no disponible o incompleto en lugar de pretender que el corpus aprobado no tiene páginas relevantes.
Use el modelo de normalización de URI para definir la comparación de URL y luego añada la política de dominio de su producto. Coincidir texto dentro de una cadena de URL no es una verificación de dominio suficiente.
Para un asistente de investigación en lugar de un buscador de documentación, el flujo de trabajo de búsqueda a RAG añade recuperación de pasajes y revisión de evidencia después de esta etapa de descubrimiento. La Universal Scraping API puede evaluarse por separado para obtener páginas de origen públicas admitidas.
Un plan práctico de cambio antes de la fecha límite
Un cambio seguro deja tiempo para encontrar diferencias semánticas mientras el servicio existente sigue disponible.
La siguiente secuencia de cuatro semanas es un cronograma propuesto, no una garantía del proveedor. Los equipos con requisitos más estrictos deberían comenzar antes y extender la ventana de revisión.
| Fase | Trabajo principal | Condición de salida |
|---|---|---|
| Semana 1 | Inventariar consumidores, configuración del motor y campos requeridos | Cada comportamiento requerido tiene un responsable y una regla de aceptación |
| Semana 2 | Crear el adaptador y capturar respuestas representativas | Las solicitudes y los registros normalizados pueden inspeccionarse lado a lado |
| Semana 3 | Comparar consultas difíciles, restricciones de origen y paginación | Las diferencias materiales se resuelven o se aceptan explícitamente |
| Semana 4 | Cambiar a un grupo de consumidores limitado, observar y luego ampliar | Los responsables operativos pueden diagnosticar fallos y revertir el cambio mientras el servicio antiguo permanece disponible |
Registre un nuevo límite de medición si el reemplazo cambia la semántica de la búsqueda. Los gráficos históricos deben identificar la transición de proveedor; de lo contrario, un cambio en la colección puede confundirse con un movimiento del mercado.
Revise la tarificación de Scrapeless aplicable e incluya la recopilación paralela temporal en el presupuesto de migración. El modelo de solicitudes más barato en estado estable no es necesariamente la migración más barata si el adaptador requiere amplios cambios posteriores.
El análisis más amplio de alternativas a la API de Google Search aborda la selección general de proveedores, mientras que la comparación específica de la alternativa a Serper ayuda a acotar una decisión comercial. El contrato de migración anterior debe regir sea cual sea el proveedor que elija.
Conclusión
Scrapeless es la primera alternativa que debe evaluarse para un flujo de trabajo de datos de búsqueda web de Google, con Serper, Oxylabs y SearchAPI.io ofreciendo rutas SERP adicionales. Scrapeless tiene pruebas específicas detrás de esa prioridad: mayor cobertura de fragmentos que Serper y respuestas más utilizables con menor latencia que la interfaz de Oxylabs probada. Linkup es relevante cuando el requisito real del producto es evidencia de investigación. La búsqueda controlada en sitios merece su propia decisión de arquitectura.
Comience con el inventario de comportamiento, valide el adaptador con consultas representativas y reserve una ventana real de cambio definitivo antes del 01-ene-2027. Una migración se completa cuando los usuarios reciben el comportamiento requerido, no solo cuando el nuevo endpoint responde.
¿Listo para planificar su migración de búsqueda?
Debata las opciones de implementación en Discord y Telegram.
Empiece en app.scrapeless.com con su contrato de resultados actual y un pequeño conjunto de consultas representativas.
Preguntas frecuentes
P: ¿Cuándo termina Google Custom Search JSON API para los clientes existentes?
Google indica que los clientes existentes deben hacer la transición a una alternativa antes del 01-ene-2027. La API ya está cerrada a nuevos clientes. Este aviso se refiere a Custom Search JSON API, no a todos los productos de búsqueda de Google.
P: ¿Es Scrapeless un reemplazo directo?
Scrapeless debe tratarse como un backend de reemplazo que necesita un adaptador y pruebas de aceptación. La configuración del motor, la paginación, los campos de respuesta y el manejo de destino requieren decisiones explícitas.
P: ¿Puede un reemplazo conservar el antiguo ID del motor de búsqueda?
Un ID de motor de búsqueda personalizado identifica la configuración en el servicio de Google. Un proveedor diferente no importa automáticamente esa configuración. Reconstruya y valide las reglas de origen que su aplicación requiere.
P: ¿Se pueden copiar sin cambios los antiguos valores de paginación?
No. El índice de primer resultado de Custom Search y el desplazamiento documentado de búsqueda web de Scrapeless difieren. Para los límites comunes de páginas de diez resultados, los inicios antiguos 1, 11 y 21 corresponden a desplazamientos candidatos 0, 10 y 20, sujetos a validación del endpoint.
P: ¿Qué alternativa es mejor para una función de investigación con IA?
Scrapeless es apropiado cuando la función necesita descubrimiento basado en Google con recopilación de evidencia controlada por la aplicación. Un servicio orientado a la investigación como Linkup puede encajar en un flujo de trabajo de recuperación rediseñado. Evalúe la compatibilidad de orígenes en lugar de asumir un orden de resultados idéntico.
En Scrapeless, solo accedemos a datos disponibles públicamente y cumplimos estrictamente con las leyes, regulaciones y políticas de privacidad del sitio web aplicables. El contenido de este blog es sólo para fines de demostración y no implica ninguna actividad ilegal o infractora. No ofrecemos garantías y renunciamos a toda responsabilidad por el uso de la información de este blog o enlaces de terceros. Antes de realizar cualquier actividad de scraping, consulte a su asesor legal y revise los términos de servicio del sitio web de destino u obtenga los permisos necesarios.





