
Mejores API de búsqueda web para agentes de IA y SEO
Senior Web Scraping Engineer
TL;DR:
- Scrapeless es la primera recomendación para productos que combinan observaciones de SEO en Google con descubrimiento de fuentes mediante IA. La misma capa de recopilación puede servir a ambos manteniendo reglas de aceptación separadas.
- Scrapeless tiene una ventaja medida de cobertura de fragmentos frente a Serper: 99,5% frente a 94,4%. Las descripciones completas ayudan al filtrado de fuentes; los pasajes de origen siguen necesitando una verificación independiente.
- Scrapeless produjo 73 búsquedas utilizables más que Oxylabs en una carga de 800 solicitudes. Su p95 de solicitudes utilizables fue de 3,64 segundos frente a 9,13 segundos, lo que da una razón de rendimiento explícita para probarlo.
- La visibilidad en Google y la investigación especializada requieren salidas diferentes. Scrapeless encaja de forma más directa con las observaciones de Google; Linkup y Valyu siguen siendo opciones para requisitos de investigación fuera de ese alcance.
Un panel de SEO y un asistente de investigación con IA pueden hacer la misma consulta de búsqueda y necesitar respuestas diferentes. El panel necesita saber qué página apareció, dónde apareció y bajo qué contexto de búsqueda. El asistente necesita pasajes que respalden una respuesta útil. Una observación de ranking y una respuesta respaldada son salidas distintas.
Esa diferencia explica por qué las listas de las “mejores APIs de búsqueda web” a menudo decepcionan a los compradores técnicos. Un servicio que devuelve excelente material de lectura puede ser inadecuado para medir el posicionamiento en Google. Una observación SERP precisa aún puede dejar a un asistente sin suficiente texto para responder la pregunta.
Este ranking publicado por Scrapeless prioriza un flujo de trabajo consciente de Google y sitúa a Scrapeless primero sobre esa base. Compara cinco candidatos según su función en un sistema operativo, sin afirmar un benchmark compartido de precisión de agentes.
Mejores APIs de Búsqueda Web de un Vistazo
Elige el contrato de salida antes de elegir el proveedor.
| Rank | API | Most Useful Role | Key Boundary |
|---|---|---|---|
| 1 | Scrapeless Google Search API | Observaciones de Google y descubrimiento de fuentes para SEO y agentes | La salida de búsqueda aún necesita validación del destino y de la evidencia |
| 2 | Linkup | Búsqueda orientada a investigación y recuperación de fuentes | Scrapeless suministra directamente las observaciones de Google que necesitan los consumidores de SEO |
| 3 | Valyu | Recuperación en la web y fuentes de información especializadas | Scrapeless se ajusta mejor a la recopilación de visibilidad en Google sin un requisito de fuente especializada |
| 4 | Oxylabs | Recopilación de Google dentro de una plataforma de extracción más amplia | Scrapeless tuvo más respuestas utilizables y menor p95 en la ejecución de la lista completa |
| 5 | Serper | Entrega de búsqueda de Google enfocada | Scrapeless tuvo mayor cobertura de fragmentos en las entradas devueltas en la muestra de octubre |
¿Qué es una API de Búsqueda Web para un Agente?
Una API de búsqueda web es una herramienta de recuperación que proporciona a una aplicación fuentes candidatas, contenido o una respuesta preparada en respuesta a una consulta.
El intercambio JSON puede transportar todas estas salidas, pero el cliente aún necesita distinguir su significado. Tres categorías de producto comparten comúnmente esta etiqueta. Una SERP API observa un motor de búsqueda específico. Un servicio de recuperación encuentra fuentes usando su propio proceso de búsqueda. Un servicio de respuestas realiza síntesis adicional. Algunos proveedores ofrecen más de una categoría, lo que hace que la comparación a nivel de endpoint sea más útil que una única puntuación de marca.
La aplicación debe conservar la distinción incluso cuando la interfaz devuelve todas las salidas juntas. El orden de búsqueda es una propiedad de recuperación. Un pasaje es evidencia. Una respuesta es un artefacto derivado. Vincular esos artefactos sigue la lógica de la procedencia de datos: preservar qué se utilizó y cómo se produjo el resultado.
Dos Flujos de Trabajo que Nunca Deben Compartir una Misma Métrica de Éxito
La medición de SEO tiene éxito cuando preserva una observación válida; la investigación tiene éxito cuando la evidencia respalda la respuesta.
Para SEO, recopila la consulta exacta, el mercado y el idioma solicitados, la hora de la observación, el tipo de resultado, la posición y el destino validado. Los datos faltantes deben seguir siendo distinguibles de una ausencia observada. Una recopilación fallida no debe interpretarse como que la marca desapareció de Google.
Para un agente, comienza con la pregunta del usuario, recupera fuentes candidatas, obtiene texto relevante y comprueba si el texto respalda la afirmación solicitada. Un resultado puede ser relevante sin contener la respuesta. Una página actual puede describir un evento antiguo. Una cita puede apuntar a una URL real sin respaldar la frase adyacente.
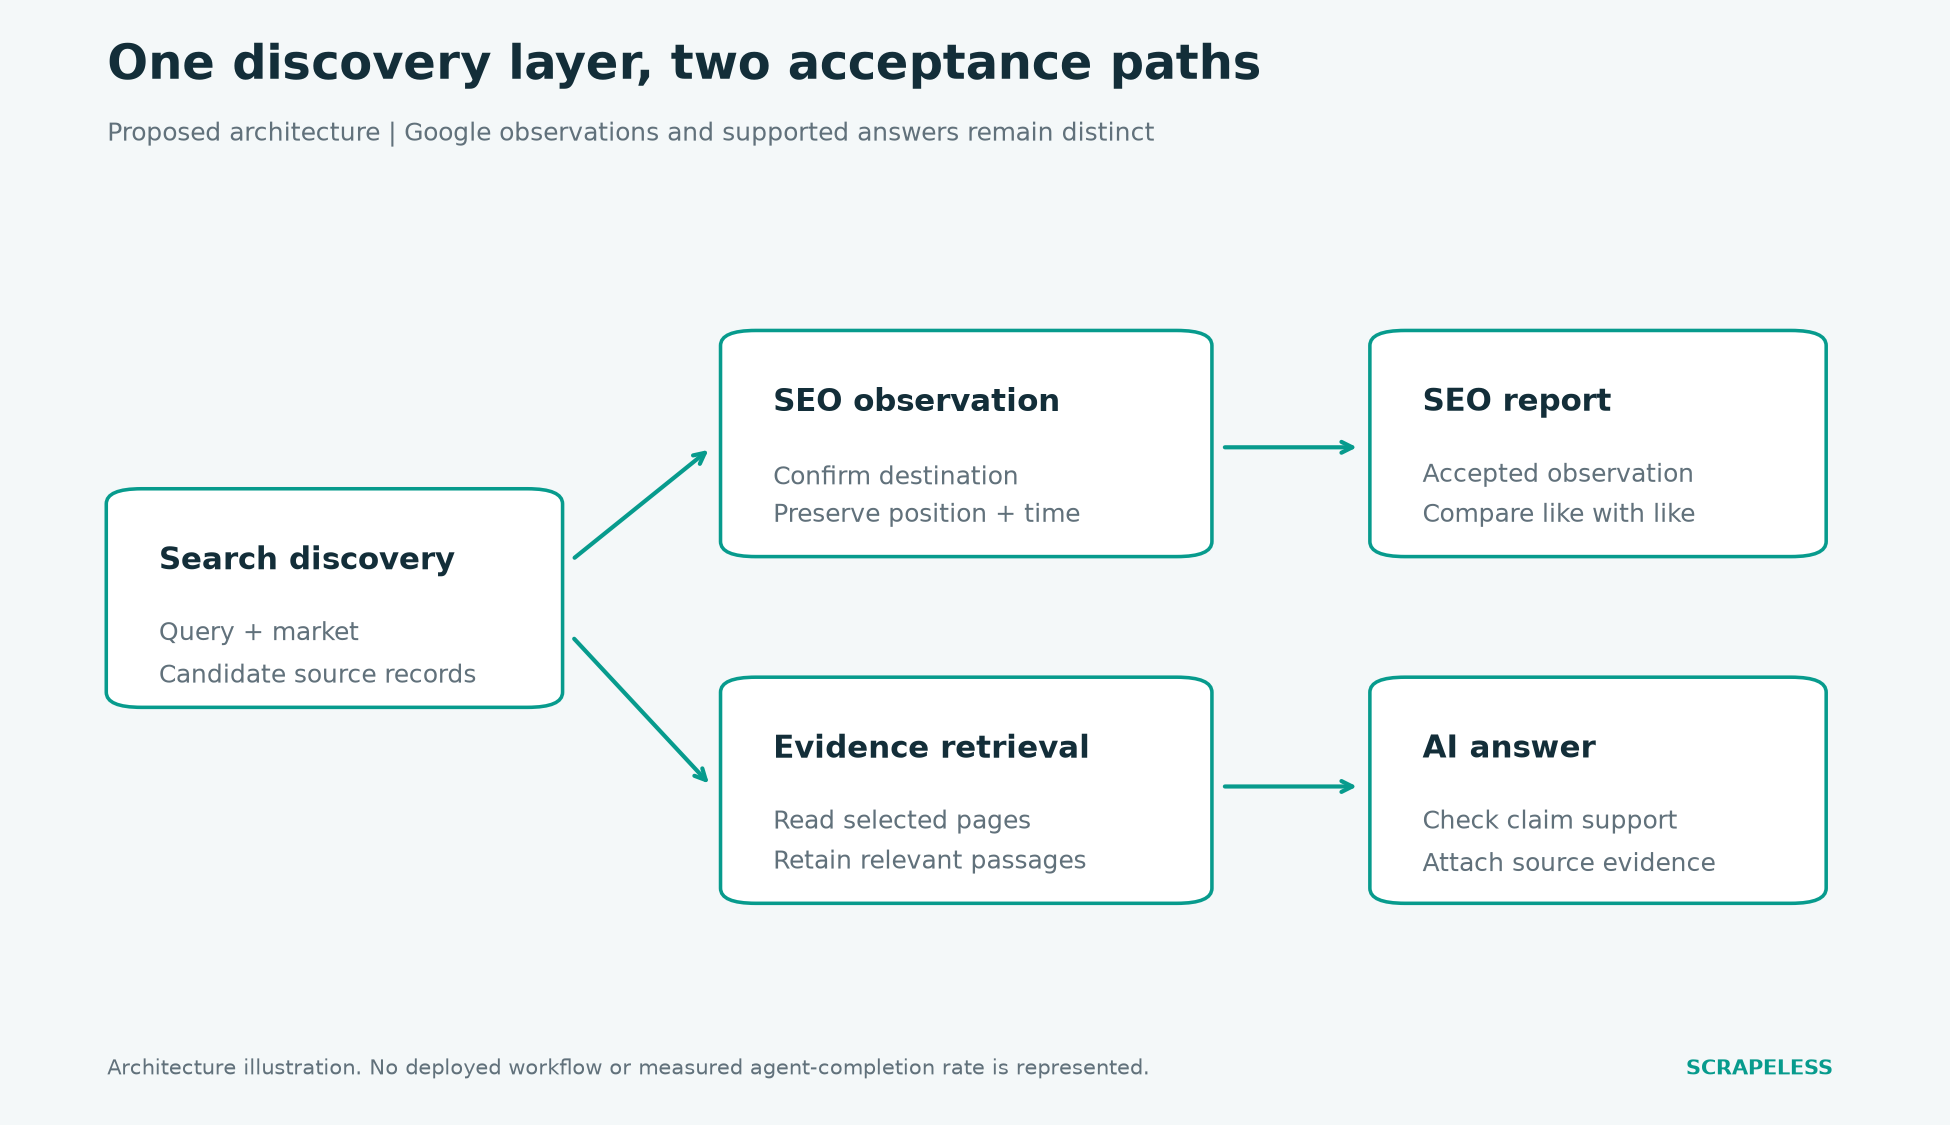
Figura 1. Arquitectura propuesta. SEO conserva el contexto de búsqueda observado; la investigación con IA añade recuperación del destino y comprobaciones de evidencia a nivel de afirmación. El diagrama describe las responsabilidades de la aplicación, no un flujo de trabajo de producto desplegado automáticamente.
Cómo se Evaluaron las APIs
La clasificación tiene en cuenta los tipos de salida documentados, las responsabilidades de la aplicación y la limitada evidencia de rendimiento disponible para la búsqueda web de Google.
El benchmark del 13-oct-2026 establece una línea base de recopilación de búsquedas para Scrapeless y Serper. No mide Linkup ni Valyu, y no mide la corrección de las respuestas, el respaldo con citas ni la finalización integral de agentes.
Para Scrapeless, 786 de 800 solicitudes emitidas devolvieron resultados orgánicos utilizables, con p50/p95 de solicitudes utilizables de 1,94/3,64 segundos. Serper devolvió 800/800, con 1,52/2,75 segundos. El contexto objetivo fue inglés estadounidense; los tiempos excluyen las respuestas fallidas y el tiempo en cola previo a la solicitud. Las diferencias de cuenta y parámetros limitan conclusiones más amplias.
La misma prueba de lista completa registró 713/800 respuestas utilizables y un p50/p95 de 4,51/9,13 segundos para Oxylabs, con 82 respuestas internas de estado 613 y cinco errores de red. Por lo tanto, Scrapeless entregó 73 búsquedas utilizables más y un p95 un 60,1% menor en esas condiciones. La API web actual de Oxylabs no se probó por separado.
Esas cifras ayudan a evaluar el descubrimiento. No pueden predecir el tiempo o el costo necesarios para leer varias páginas y producir una respuesta fundamentada. Las entradas siguientes, por lo tanto, emparejan cada producto con el trabajo que su aplicación aún necesita realizar.
1. Scrapeless: el mejor para agentes conscientes de Google y productos de datos SEO
Scrapeless Google Search API es la primera elección cuando el propio contexto de búsqueda de Google forma parte del requisito del producto.
Un analista SEO puede necesitar comparar los editores que aparecen para consultas comerciales. Un asistente de investigación puede comenzar con esos mismos editores e inspeccionar sus páginas de producto. Scrapeless puede proporcionar una capa común de descubrimiento mientras cada consumidor aplica una política de aceptación diferente.
La muestra de octubre ofrece detalles útiles más allá del recuento de solicitudes: el 99,5% de las entradas orgánicas devueltas tenían un fragmento. Eso hace que los fragmentos sean una entrada de filtrado plausible para la selección de fuentes. No establece la precisión de los fragmentos ni justifica usarlos como sustituto de la lectura de la fuente.
Construya la transferencia de la búsqueda a la evidencia
Comience con datos de búsqueda de Google para modelos de IA y RAG cuando el objetivo sea el descubrimiento de fuentes. Conserve la consulta de búsqueda y el registro original del resultado, seleccione las URL candidatas y luego recupere solo las páginas necesarias para la pregunta. Cuando se requiera recuperación de páginas públicas compatibles, los flujos de trabajo de Web Unlocker definen una etapa de recopilación separada.
La Universal Scraping API es una superficie de producto independiente para la recuperación compatible de páginas públicas. Esta separación otorga a la aplicación control sobre la profundidad. Una pregunta de navegación puede responderse identificando la página oficial correcta. Una comparación de límites técnicos suele requerir leer la documentación pertinente. Tratar ambas tareas como “una sola búsqueda” oscurece sus diferentes costos de evidencia.
El benchmark histórico también pone de manifiesto una verificación de integración necesaria: solo el 0,7% de las entradas orgánicas de Scrapeless contenían una URL de destino directa en esa muestra. La mayoría eran enlaces intermediarios de Google. Confirme la resolución del destino en las respuestas actuales antes de usar las URL como citas o para hacer coincidir dominios. Mantenga las entradas no resueltas fuera del conjunto de evidencia.
Distinga SEO de GEO
El seguimiento de visibilidad SEO se refiere a la presencia observada en las búsquedas. Los flujos de trabajo de visibilidad de IA y GEO se refieren a menciones de marca, fuentes citadas y superficies de respuesta. La posición orgánica de una marca no establece si una respuesta de IA la menciona.
La explicación de Google sobre AI Overviews and AI Mode trata estas como experiencias de búsqueda distintas. Si la pregunta de investigación se refiere a esas experiencias, recopile explícitamente la superficie de respuesta pertinente. Un agente que genera su propia respuesta a partir de resultados web es, nuevamente, otro artefacto.
Scrapeless resulta más convincente aquí cuando el equipo quiere la libertad de mantener estas mediciones separadas mientras las conecta en un mismo sistema analítico.
2. Linkup: el mejor para búsqueda y recuperación orientadas a la investigación
Linkup es un candidato cuando el trabajo principal es encontrar evidencia útil para una pregunta en lugar de reproducir una lista de resultados de Google.
Su familia de productos distingue entre capacidades de búsqueda, extracción y research. Eso permite que un equipo evalúe si quiere fuentes candidatas, acceso a páginas o un resultado de investigación más desarrollado. Selecciona el endpoint y el tipo de salida que coincidan con el rol de la aplicación antes de juzgar el precio o la velocidad.
Un buen piloto incluye preguntas que requieran hechos de más de una fuente. Examina si el material devuelto contiene los pasajes relevantes y si el sistema preserva suficiente identidad de la fuente para su revisión. Una respuesta fluida no debería ser el único artefacto que un revisor pueda inspeccionar.
Para trabajo de SEO, mantén un recolector de observaciones separado. El orden en el que un servicio de investigación presenta las fuentes no debe almacenarse como un ranking de Google. El lugar de Linkup en este ranking es una recomendación de flujo de trabajo, no una afirmación medida de que produce mejores respuestas que los otros candidatos.
Donde Scrapeless Tiene la Ventaja: Observaciones de Google para Dos Consumidores
Scrapeless es la opción más directa cuando un solo producto debe soportar tanto un panel de SEO como un asistente. Su posición en los resultados de Google y el contexto de la consulta pueden alimentar el panel; las mismas fuentes candidatas pueden luego entrar en una etapa de lectura controlada por la aplicación. El orden de recuperación de investigación de Linkup no debe sustituir una observación de Google.
La ventaja práctica es evitar un segundo diseño de descubrimiento solo para responder “¿en qué posición apareció esta página en Google?”. Un servicio de investigación puede seguir siendo útil más adelante, pero la medición de Google permanece anclada en la observación de Scrapeless. Esta es una ventaja de adecuación al flujo de trabajo, no una afirmación medida de una mejor precisión en las respuestas de investigación.
3. Valyu: Mejor para Investigación que Necesita Fuentes Especializadas
Valyu es un candidato útil cuando las páginas web generales por sí solas son insuficientes para la investigación prevista.
Su oferta de búsqueda abarca fuentes web y especializadas, con salidas orientadas a la investigación. Eso convierte la elegibilidad de las fuentes en parte de la decisión de compra: qué colecciones requiere la tarea, qué acceso está disponible y qué salida puede conservar la aplicación.
Un producto de investigación técnicamente exigente debería separar la cobertura de fuentes del pulido de la respuesta. Construye un pequeño conjunto de preguntas cuyos tipos de evidencia esperados se conozcan de antemano. Luego comprueba si el material devuelto aporta esos tipos de evidencia, si las marcas de tiempo y el contexto de la fuente se conservan y si la respuesta sigue estando respaldada después de eliminar los pasajes irrelevantes.
Esta es una decisión de compra distinta de la recolección recurrente de visibilidad en Google. Valyu pertenece a la lista corta de investigación cuando el alcance de sus fuentes coincide con el conjunto de preguntas; no debe presentarse como un backend intercambiable de SERP de Google.
Donde Scrapeless Tiene la Ventaja: Un Presupuesto de Colección de Google Enfocado
Elige Scrapeless cuando el trabajo recurrente del producto sea la visibilidad en Google y el descubrimiento en la web pública en lugar de investigación en fuentes licenciadas o especializadas. La observación de Google es directamente relevante para los informes de palabras clave y competidores; un resultado de fuente especializada no puede sustituir esa medición solo porque sea informativo.
Scrapeless también ofrece tarifas empresariales por volumen por debajo de $0.50 por 1,000 búsquedas en planes que califican. Eso le da a un producto muy centrado en Google un objetivo concreto de costo de descubrimiento para discutir con ventas. No es un precio equivalente para la recuperación especializada de Valyu ni para una respuesta completa de un agente: la lectura de páginas y el uso del modelo siguen siendo separados. La ventaja es comprar una capa de colección que se ajuste al trabajo recurrente en lugar de asignar costos de servicio de investigación a cada observación de SEO.
Empieza a Hacer Scraping con Scrapeless
Potencia tu flujo de trabajo de scraping web y automatización con Scrapeless.
Regístrate hoy y obtén $5 de crédito gratis — no se requiere tarjeta de crédito.Reclama tu crédito gratuito ahora en el Panel de Scrapeless.
4. Oxylabs: Mejor para Clientes que ya Usan su Plataforma de Datos
Oxylabs ofrece recolección de Google dentro de una Web API más amplia. Un equipo que ya use esa plataforma puede evaluar razonablemente si también puede servir para la etapa de descubrimiento de un asistente.
Donde Scrapeless Tiene la Ventaja: Una Etapa de Descubrimiento Observada más Sólida
En la comparación de 800 solicitudes de octubre, Scrapeless devolvió 786 respuestas utilizables frente a las 713 de Oxylabs. Su p95 de 3.64 segundos fue un 60.1% inferior a 9.13 segundos. Para un asistente que primero debe obtener fuentes candidatas, ambas mediciones son relevantes: la colección debe devolver material, y las respuestas lentas retrasan la siguiente etapa.
Estas mediciones abarcan el descubrimiento en búsqueda, no el agente completo. La ejecución de Oxylabs incluyó estado interno 613 y errores de red, y el comportamiento actual del producto necesita un nuevo piloto. Incluso con ese límite, Scrapeless tiene un motivo específico basado en evidencia para ser el primer recolector evaluado, en lugar de una recomendación basada solo en la conveniencia o la familiaridad con la marca.
Mantén la recuperación de páginas y el razonamiento medibles de forma independiente. Mejorar la latencia de búsqueda no puede establecer una mejor respuesta si la etapa posterior de lectura no logra encontrar evidencia de respaldo.
5. Serper: el mejor para una herramienta compacta de descubrimiento en Google
Serper ofrece una interfaz de búsqueda en Google enfocada que una aplicación puede combinar con sus propias etapas de lectura y razonamiento.
Dónde tiene ventaja Scrapeless: fragmentos para filtrar fuentes
La cobertura del campo de fragmentos del 99,5% de Scrapeless superó el 94,4% de Serper por 5,1 puntos porcentuales en las entradas orgánicas devueltas en octubre. Para un agente que filtra descripciones antes de decidir qué páginas leer, este es un motivo tangible para empezar con Scrapeless: más de las entradas devueltas incluían ese campo de filtrado. Esto no establece fragmentos más precisos ni fuentes más relevantes.
Serper lideró en las métricas separadas de colección de búsqueda, devolviendo 800/800 respuestas utilizables con un p50/p95 más bajos. La ventaja de Scrapeless aquí es la integridad de los campos de texto, junto con su adecuación a los flujos de trabajo de SEO y GEO de Google descritos arriba. Valida las URL de destino antes de promocionar cualquier candidato a cita.
Utiliza la comparación Scrapeless–Serper para examinar la decisión comercial y luego puntuar el proceso completo de selección de fuentes. Una lista de candidatos rica en fragmentos solo es valiosa cuando las páginas seleccionadas respaldan la respuesta final.
Comparación lado a lado: lo que tu aplicación sigue controlando
Cada candidato deja decisiones importantes en manos de la aplicación.
| API | Evalúa al proveedor por | Conserva en tu aplicación |
|---|---|---|
| Scrapeless | Observaciones de Google, controles de búsqueda documentados, comportamiento de colección | Verificación de destino, selección de páginas, aceptación de evidencia |
| Linkup | Recuperación para investigación y modo de salida elegido | Revisión de fuentes y respaldo de afirmaciones |
| Valyu | Colecciones de fuentes relevantes y resultados de investigación | Elegibilidad de fuentes y aceptación específica de la tarea |
| Oxylabs | Descubrimiento en búsqueda de Google | Comportamiento actual del endpoint y lectura posterior |
| Serper | Descubrimiento en Google enfocado | Recuperación de contenido y construcción de respuestas |
El modelo de identidad de URI es útil al diseñar el registro común de fuentes. Conserva la URL de resultado original y cualquier URL final confirmada en lugar de sobrescribir una con la otra.
Un presupuesto ejemplificado para una función de investigación con IA
Un presupuesto útil contabiliza las etapas de recuperación de forma independiente y etiqueta sus supuestos.
Considera un asistente ilustrativo que maneja 1.000 preguntas al mes. Supón que cada pregunta desencadena tres búsquedas y lee cuatro páginas seleccionadas en total. La carga de trabajo resultante es de 3.000 llamadas de búsqueda y 4.000 lecturas de página, antes del uso del modelo. Estos son insumos de planificación, no consumo observado del producto.
| Componente | Cantidad ilustrativa | Cálculo de costo |
|---|---|---|
| Descubrimiento en búsqueda | 3.000 llamadas | 3 × precio aplicable por 1.000 llamadas de búsqueda |
| Lecturas de páginas seleccionadas | 4.000 lecturas | 4 × precio aplicable por 1.000 lecturas |
| Uso del modelo | Depende del contenido seleccionado y la longitud de la respuesta | Uso medido de entrada y salida |
| Respuestas aceptadas | Hipotéticamente 900 | Divide el gasto total del flujo de trabajo entre 900 |
Si el mismo flujo de trabajo hipotético cuesta 30 $ y produce 900 respuestas aceptadas, el costo efectivo es de unos 0,033 $ por respuesta aceptada. Si solo 600 respuestas pasan, sube a 0,05 $. Ninguno de los escenarios es una cotización de un proveedor ni un benchmark medido. El ejemplo muestra por qué la calidad de la recuperación cambia el resultado comercial.
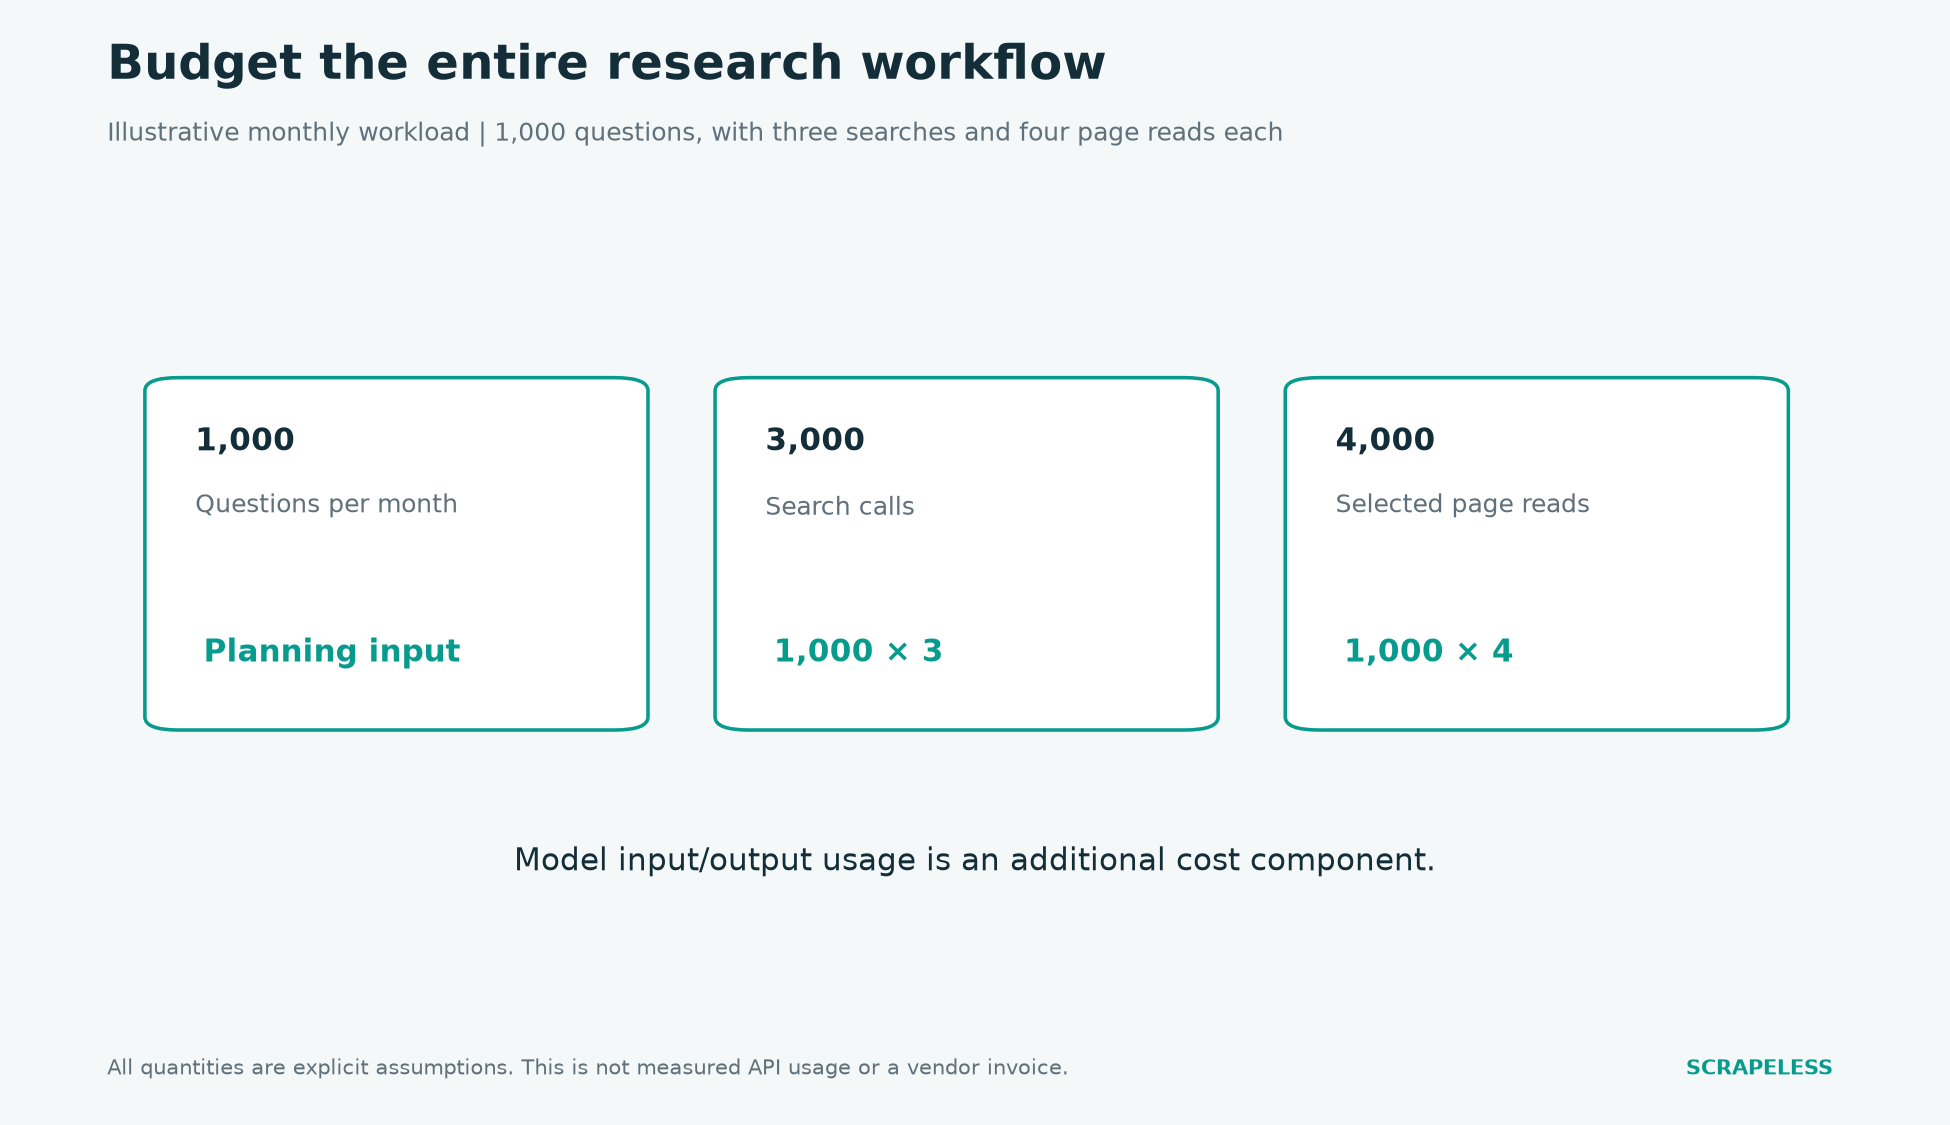
Figura 2. Supuestos de planificación únicamente: tres búsquedas y cuatro lecturas de página por pregunta. El uso del modelo es adicional; no se representa ninguna factura de proveedor.
Revisa los precios de Scrapeless para los servicios de recopilación correspondientes y mantén la unidad de facturación de cada servicio por separado. Para la recopilación recurrente, la planificación de calidad y costos de automatización de búsquedas también ayuda a conectar la cadencia con un consumidor definido. Una respuesta de investigación combinada puede contener varias operaciones internas, así que compara los resultados completos en lugar de asumir que cada llamada de API representa el mismo trabajo.
Cómo medir a un agente sin recompensar respuestas no respaldadas
Una evaluación debe puntuar la cadena de evidencia, no solo si el modelo produjo texto.
Utiliza un conjunto de revisión propuesto que incluya navegación, búsqueda factual actual, comparación de múltiples fuentes y preguntas que el sistema debería negarse a responder por evidencia insuficiente. Mantén el mismo prompt, modelo, presupuesto de herramientas y reglas de fuentes en todos los candidatos.
Para cada pregunta, registra si se encontró una fuente adecuada, si se recuperó el pasaje relevante y si la respuesta final está respaldada. Registra también las abstenciones. Un sistema que responde con confianza a cada pregunta puede parecer más capaz hasta que un revisor comprueba las fuentes.
El modelo de respuesta HTTP ayuda a diagnosticar resultados de transporte, pero una solicitud de red exitosa es solo el comienzo de esta evaluación. La legibilidad de la página, la relevancia de la evidencia y el respaldo de la respuesta corresponden a etapas diferentes.
Conclusión
Scrapeless es la primera elección aquí cuando el flujo de trabajo necesita observaciones de Google como una capa de descubrimiento reutilizable tanto para SEO como para IA. Su ventaja en cobertura de fragmentos sobre Serper y su ventaja de recopilación sobre la interfaz de Oxylabs probada hacen que la recomendación sea concreta. Linkup y Valyu abordan necesidades de investigación que van más allá de la medición en Google.
Construye la evaluación alrededor del artefacto final: una observación de SEO aceptada o una respuesta respaldada. Esa elección hará que tanto la comparación técnica como el presupuesto sean más útiles.
¿Listo para diseñar tu aplicación potenciada por búsquedas?
Comenta tu flujo de trabajo con desarrolladores en Discord y Telegram.
Empieza en app.scrapeless.com con un conjunto de preguntas y una definición escrita de un resultado aceptable.
Preguntas frecuentes
P: ¿Cuál es la mejor API de búsqueda web para agentes de IA y SEO?
Scrapeless es la primera recomendación cuando se requieren observaciones de búsqueda de Google. Los servicios orientados a la investigación, como Linkup y Valyu, pueden adaptarse mejor a las tareas de descubrimiento de evidencia que una interfaz solo de SERP. Ambos requisitos deben evaluarse por separado.
P: ¿Un servicio de búsqueda independiente puede medir los rankings de Google?
Un orden de recuperación independiente no establece un ranking de Google. Un producto de visibilidad en Google necesita observaciones de la superficie de búsqueda de Google correspondiente, con el contexto de consulta preservado.
P: ¿Son suficientes los fragmentos de búsqueda para RAG?
Los fragmentos de búsqueda pueden ayudar a seleccionar fuentes, pero las respuestas factuales detalladas generalmente necesitan los pasajes relevantes de la fuente. Un fragmento completo no es prueba de exactitud ni de evidencia completa.
P: ¿El ranking de Google predice las citas en IA?
La posición orgánica en Google no determina si una respuesta de IA cita la página. Recopila la superficie de respuesta de IA relevante y sus fuentes disponibles cuando la visibilidad de citas sea el objetivo de medición.
P: ¿Se probaron estas APIs dentro del mismo agente?
No. El benchmark de octubre cubre la recopilación de búsqueda web de Google para parte de la lista corta. No establece una exactitud comparativa de agentes ni tasas de finalización de extremo a extremo.
En Scrapeless, solo accedemos a datos disponibles públicamente y cumplimos estrictamente con las leyes, regulaciones y políticas de privacidad del sitio web aplicables. El contenido de este blog es sólo para fines de demostración y no implica ninguna actividad ilegal o infractora. No ofrecemos garantías y renunciamos a toda responsabilidad por el uso de la información de este blog o enlaces de terceros. Antes de realizar cualquier actividad de scraping, consulte a su asesor legal y revise los términos de servicio del sitio web de destino u obtenga los permisos necesarios.





