
Mejores alternativas a Tavily para flujos de trabajo de IA centrados en la búsqueda
Lead Scraping Automation Engineer
Resumen rápido:
- Scrapeless es la primera alternativa a Tavily que se debe evaluar cuando un flujo de trabajo de IA necesita descubrimiento en Google antes de decidir qué leer. Le da a la aplicación una etapa de búsqueda diferenciada y deja la selección de fuentes bajo el control de la aplicación.
- Las alternativas a Tavily deben compararse en el mismo nivel de salida. Los resultados de búsqueda, el contenido de las páginas recuperadas y las respuestas generadas requieren pruebas de aceptación diferentes.
- Exa, Brave, Linkup y Firecrawl abordan distintas prioridades de recuperación. El descubrimiento semántico, la elección del índice, los flujos de trabajo de investigación y la extracción de páginas son distinciones útiles al crear una lista corta.
- La lectura selectiva puede evitar trabajo innecesario en etapas posteriores. Cualquier beneficio de costos depende de cuántas páginas descubiertas necesita realmente la aplicación y de cómo factura cada servicio ese trabajo.
Un flujo de trabajo de IA no necesita leer todas las páginas que descubre. Un asistente de comparación de productos puede primero identificar las páginas oficiales de productos, descartar resultados no relacionados y solo entonces recopilar los pasajes necesarios para una respuesta.
Esa secuencia es la razón para considerar alternativas a Tavily que sean “search-first”. El objetivo es convertir el descubrimiento, la lectura y la generación de respuestas en decisiones deliberadas con entradas y salidas separadas. Tavily en sí ofrece opciones configurables de búsqueda, contenido y respuesta; reemplazarlo debería mejorar un requisito que tenga tu aplicación, en lugar de resolver una limitación que no tiene.
Esta comparación recomienda primero Scrapeless para descubrimiento guiado por Google con lógica de recuperación propiedad de la aplicación. La clasificación es editorial y se basa en capacidades documentadas. No pretende ser una nueva prueba de precisión de respuestas, velocidad o tasa de éxito.
Mejores alternativas a Tavily de un vistazo
| Rank | Provider | Strongest Reason to Evaluate | Output to Inspect | Where Scrapeless Fits Better |
|---|---|---|---|---|
| 1 | Scrapeless | Google discovery before selective page reading | Structured Google result records | Primary recommendation for Google-led search workflows |
| 2 | Exa | Semantic discovery with content options | Retrieved documents, text or highlights | When Google result context is part of the requirement |
| 3 | Brave Search API | Retrieval from an independent index | Web results or LLM-oriented context | When the product needs Google rather than Brave observations |
| 4 | Linkup | Search, fetch and research in one product family | The selected search or research output | When application logic should begin with Google SERP records |
| 5 | Firecrawl | Search connected closely to page extraction | Results and requested scraped content | When the first deliverable is a Google observation, before a reading decision |
La alternativa a Tavily más útil para un agente de IA es la que devuelve la evidencia que tu agente puede evaluar. Una respuesta más larga no es automáticamente una mejor respuesta, y un campo de respuesta conveniente no sustituye a la comprobación del soporte subyacente.
¿Qué significa “search-first” en un flujo de trabajo de IA?
Un flujo de trabajo “search-first” separa la búsqueda de fuentes candidatas de la adquisición del contenido utilizado para responder una pregunta. Puede implementarse con servicios separados o con opciones cuidadosamente seleccionadas en una API más amplia.
Las etapas son sencillas: identificar la necesidad de información, buscar candidatos, elegir fuentes, recuperar material relevante y luego redactar una respuesta. La aplicación es la dueña de las transiciones. Para una búsqueda de un dato puntual, un resultado corto puede ser suficiente para dirigir la siguiente acción; para una comparación matizada, la aplicación debería inspeccionar el texto de las fuentes.
La distinción sigue la idea más amplia de la generación aumentada por recuperación: la información externa proporciona contexto para la generación. Una llamada de búsqueda a Google puede contribuir a ese proceso, pero por sí sola no implementa toda la canalización de recuperación y generación.
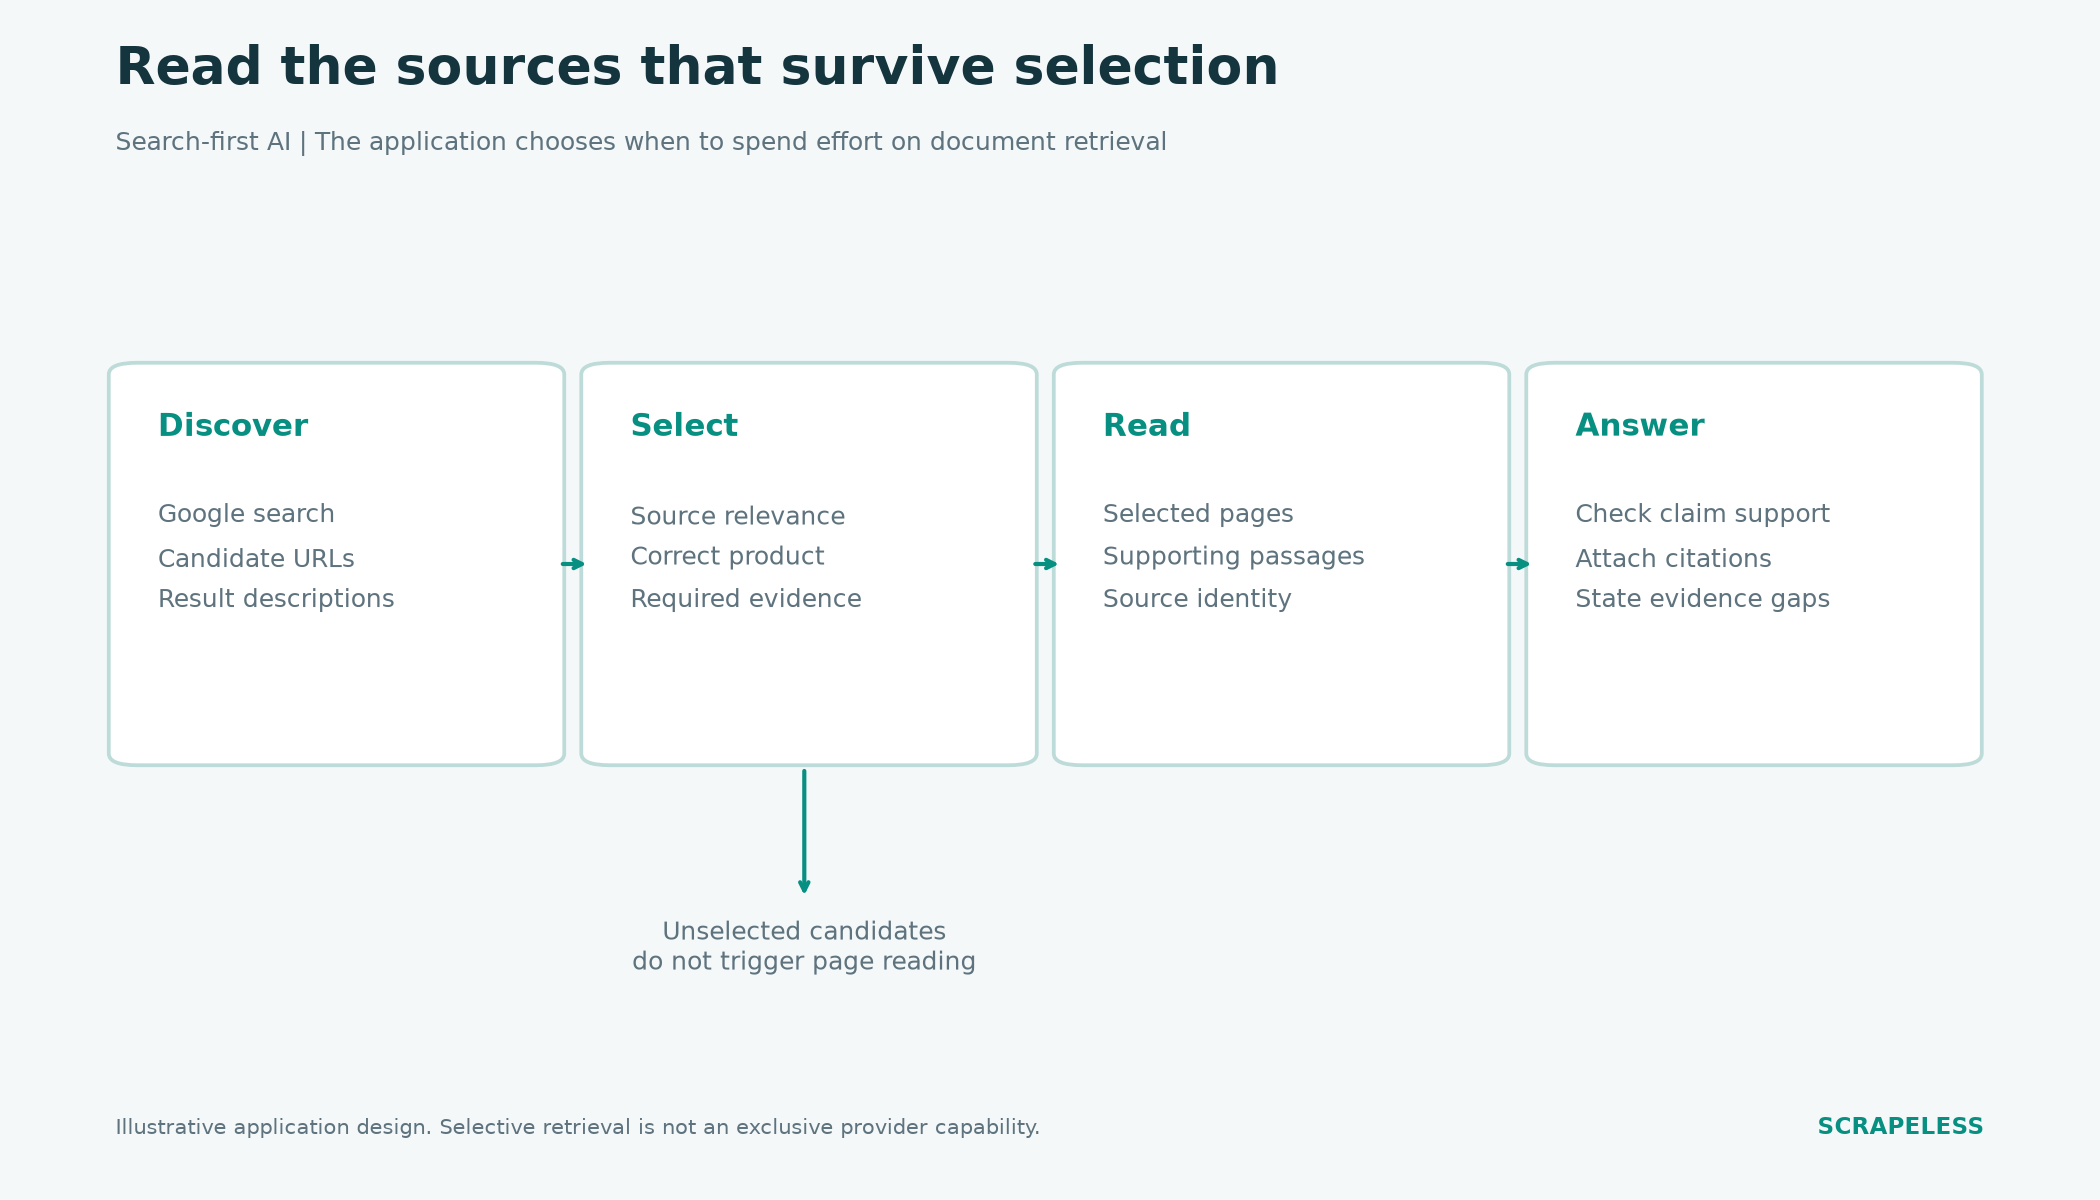
Flujo de trabajo propuesto: descubrir candidatos, seleccionar fuentes, leer páginas relevantes y conservar los pasajes de apoyo antes de responder. El diagrama describe responsabilidades de la aplicación, no un benchmark ejecutado.
Esta separación es particularmente útil cuando los equipos ya cuentan con un servicio de extracción, un almacén de documentos o un proceso de evaluación. En lugar de reemplazar todos los componentes, pueden evaluar una capa de búsqueda que alimente a esos componentes.
Cómo se eligió la lista corta
Las alternativas se seleccionaron por funciones de recuperación diferenciadas, con el descubrimiento guiado por Google ponderado con mayor peso para la recomendación de Scrapeless. La comparación examina el origen de la búsqueda, la granularidad de la salida y dónde la aplicación mantiene el control.
No se asigna una puntuación de calidad universal. La efectividad de la recuperación cambia con la colección de consultas y la tarea. Las tareas heterogéneas en la evaluación de recuperación de información de BEIR ilustran por qué un único conjunto de resultados no puede establecer el mejor sistema de recuperación para cada dominio.
Por lo tanto, una comparación sensata mantiene constante la tarea de la aplicación. Usa la misma pregunta, tipos de fuentes requeridas, modelo y presupuesto total de trabajo. Si un candidato devuelve fragmentos y otro devuelve documentos extraídos, incluye la etapa de lectura faltante antes de comparar las respuestas completas.
1. Scrapeless: la mejor opción para búsqueda liderada por Google antes de la extracción
Scrapeless es la alternativa preferida a Tavily aquí cuando la aplicación necesita una etapa definida de descubrimiento en Google. La Google Search API expone resultados estructurados que pueden filtrarse y registrarse antes de que cualquier modelo reciba contenido de las páginas.
Esa estructura es útil para aplicaciones con una política de fuentes deliberada. Un asistente de investigación de mercado podría privilegiar páginas de producto oficiales para especificaciones y usar reseñas independientes para afirmaciones de experiencia. Un registro de búsqueda le da a la aplicación una URL candidata y una descripción; la aplicación decide si esa fuente es adecuada para la afirmación que debe respaldar.
Dónde tiene ventaja Scrapeless sobre Tavily
Scrapeless encaja de forma más clara cuando el contexto de los resultados de Google es en sí mismo parte del entregable. Un flujo de trabajo que atiende tanto a informes SEO como a investigación con IA puede usar las observaciones de Google como una entrada común de descubrimiento y luego ramificarse en diferentes rutas de procesamiento. Las opciones de búsqueda y contenido de Tavily no convierten su orden de resultados en una observación del ranking de Google.
La solución de Google Search AI y RAG es relevante cuando tu aplicación ya posee el modelo y la lógica de selección de evidencias. Scrapeless proporciona un componente de búsqueda enfocado; tu canalización elige qué leer y qué citar.
El argumento comercial es de forma similar específico. Si la aplicación rechaza muchos candidatos antes de leer, una etapa de búsqueda con presupuesto separado puede ayudar a controlar el consumo posterior. Los ahorros deben comprobarse frente a los costos reales de búsqueda y extracción. Una arquitectura “search-first” no garantiza que Scrapeless sea más barato que todas las configuraciones de Tavily.
Empezar con una tarea pequeña de aceptación
Sigue la configuración de la solicitud de Google Search con una clave de API del lado del servidor. Comienza con un propósito de búsqueda claramente definido, como encontrar documentación oficial de un producto de software en un idioma seleccionado.
Una prueba de humo propuesta para el primer minuto es inspeccionar una respuesta completada para verificar la identidad de las fuentes y descripciones de resultados utilizables. Mantén opcionales los campos dependientes de la consulta. La prueba confirma la forma del adaptador; una evaluación más amplia de relevancia y rendimiento requiere un conjunto representativo de tareas.
Para una instrucción ilustrativa al agente, utiliza: “A partir de estos registros de búsqueda, selecciona la documentación oficial del producto relevante para la capacidad solicitada. Devuelve las URL candidatas y los motivos de la selección. Marca las afirmaciones no respaldadas como no resueltas.” El modelo debería ver esto como una tarea de selección de fuentes, no como una invitación a responder solo a partir de un título.
Cuando las páginas seleccionadas necesiten acceso adicional, evalúa el Web Unlocker para trabajos de recuperación compatibles. La búsqueda y la recopilación de páginas siguen siendo operaciones separadas con costos separados. Si una fuente seleccionada requiere interacción permitida con la página, evalúa Scrapeless Scraping Browser como un flujo de trabajo de lectura independiente.
2. Exa: el mejor para descubrimiento semántico de documentos
Exa admite búsqueda con opciones de contenido como texto y destacados. Es un candidato útil cuando la aplicación describe un tema o documento deseado en lenguaje natural y quiere recuperar material para que el modelo lo inspeccione.
La evaluación debe preguntar si el contenido seleccionado realmente contiene la evidencia requerida. Un documento temáticamente similar aún puede omitir la característica, fecha o calificación necesaria para la respuesta. Inspecciona la fuente devuelta y el pasaje juntos en lugar de premiar solo la similitud.
Dónde tiene ventaja Scrapeless
Scrapeless es la opción más directa cuando el flujo de trabajo requiere contexto de descubrimiento específico de Google. Por ejemplo, un equipo que investiga qué páginas públicas aparecen para una consulta de producto puede querer conservar esa observación antes de leer las páginas. La salida de descubrimiento de Exa cumple un propósito de recuperación diferente.
Scrapeless también mantiene fácil de expresar en la aplicación el límite de "primero buscar": recopilar registros candidatos, aplicar una política de origen y luego enviar las URL seleccionadas al lector apropiado. Exa también puede configurarse de forma flexible; la razón para preferir Scrapeless en esta comparación es el requisito de Google, no la afirmación no fundamentada de que la recuperación semántica sea intrínsecamente peor.
3. Brave Search API: lo mejor como fuente de búsqueda independiente
Brave ofrece tanto búsqueda web como una interfaz de Contexto LLM. La distinción importa: la primera expone resultados web, mientras que la segunda está diseñada para suministrar contenido para consumo por máquinas. Evalúa la interfaz que tu aplicación realmente usaría.
Brave vale la pena considerarse cuando la independencia del índice de búsqueda es un requisito del producto o cuando una aplicación quiere una fuente de descubrimiento más allá de Google. Índices diferentes pueden devolver candidatos útiles diferentes, pero añadir un índice también añade una responsabilidad de evaluación y normalización.
Donde Scrapeless tiene la ventaja
Scrapeless tiene una alineación más sencilla con aplicaciones que deben relacionar la investigación con la visibilidad en Google. La misma entrada de descubrimiento de Google puede ayudar a un asistente de investigación a encontrar páginas y a un analista a inspeccionar la presencia en búsquedas específicas de un mercado, siempre que los registros posteriores permanezcan claramente etiquetados.
El flujo de trabajo de Google Search SEO explica ese caso de uso orientado a la observación. Prefiere Brave cuando su índice independiente es el objetivo; prefiere Scrapeless cuando conservar Google como la superficie de descubrimiento elimina la ambigüedad para tus usuarios.
Empieza a hacer scraping con Scrapeless
Potencia tu flujo de trabajo de web scraping y automatización con Scrapeless.
Regístrate hoy y obtén 5 $ de crédito gratis — no se requiere tarjeta de crédito.Reclama tu crédito gratuito ahora en el Panel de Scrapeless.
4. Linkup: lo mejor para flujos de trabajo de búsqueda e investigación
Linkup ofrece capacidades de búsqueda, obtención y investigación. Es un candidato para equipos que quieren evaluar esas etapas adyacentes dentro de una misma familia de productos en lugar de ensamblar cada capacidad de forma independiente.
La decisión de compra debe identificar el resultado previsto. Un conjunto de resultados de búsqueda, una página obtenida y un resultado de investigación completado son entregables diferentes. Escribe el requisito de aceptación antes de seleccionar el modo de producto para que una respuesta pulida no oculte evidencia faltante.
Donde Scrapeless tiene la ventaja
Scrapeless es el punto de partida preferido cuando tu sistema quiere observaciones de Google y ya tiene su propia orquestación de investigación. Permite que la etapa de búsqueda sirva un contrato limitado mientras tu aplicación determina qué fuentes merecen más trabajo.
Eso puede resultar atractivo para equipos con un repositorio de evidencias existente o reglas de revisión personalizadas. Linkup puede encajar en un servicio de investigación más amplio; Scrapeless encaja con la decisión específica de adquirir datos de búsqueda de Google y componer el resto del flujo de trabajo en torno a ellos. La comparación no implica que Linkup impida el procesamiento controlado por la aplicación.
5. Firecrawl: lo mejor para búsqueda con extracción de páginas
Firecrawl conecta la búsqueda con scraping opcional de las páginas descubiertas y formatos como Markdown. Es una alternativa relevante a Tavily cuando la aplicación necesita contenido de documentos cerca del paso de descubrimiento.
Su valor debe evaluarse en función de las páginas que encuentra tu aplicación. Una respuesta limpia en Markdown sigue necesitando comprobaciones de tablas faltantes, texto de navegación e información específica de versión. El formato hace que el contenido sea más fácil de consumir; no establece que se haya capturado cada pasaje necesario.
Donde Scrapeless tiene la ventaja
Scrapeless merece prioridad cuando tu primer requisito es una observación de búsqueda en Google y la lectura de páginas solo debe ocurrir después de la selección. Un adaptador centrado en la búsqueda puede conservar el contexto de los resultados para análisis antes de que un lector de contenido separado transforme las páginas seleccionadas.
Firecrawl también puede devolver resultados de búsqueda sin hacerles scraping, por lo que la lectura selectiva no es exclusiva de Scrapeless. El factor diferenciador es el énfasis en la recopilación de SERP de Google y su conexión con las opciones de recopilación más amplias de Scrapeless. Elige el contrato que se alinea con el producto que estás construyendo y luego compara el flujo de trabajo total.
Un flujo de trabajo ilustrativo de investigación de productos
Un asistente de investigación de productos necesita pruebas que separen una afirmación sobre una función del lenguaje de marketing general. Considere una tarea hipotética: determinar si una base para laptop admite una configuración de pantalla específica e identificar los requisitos de hardware aplicables.
La etapa de búsqueda busca páginas oficiales de especificaciones, compatibilidad y soporte. El selector registra por qué cada candidato es relevante. La etapa de lectura recopila el texto aplicable y comprueba si se refiere al modelo correcto de base. La etapa de respuesta cita el pasaje que respalda la compatibilidad de la pantalla y, por separado, cita el pasaje que respalda la calificación de hardware.
Aquí es donde las alternativas de Tavily con búsqueda-primero pueden ser útiles. Si un resultado es una página genérica de inicio de la empresa, la aplicación puede descartarlo antes de invertir esfuerzo en la extracción. Si la búsqueda descubre una página relevante que el lector no puede adquirir, el registro de evidencia debe mostrar esa limitación en lugar de tratar el fragmento de búsqueda como un sustituto completo.
Los fragmentos de búsqueda de Google pueden ensamblarse de manera diferente para distintas consultas. Una descripción que suena concluyente durante el descubrimiento puede omitir la calificación necesaria para una respuesta final.
Preserve la cadena desde la consulta hasta la URL seleccionada y el pasaje de apoyo. La procedencia de datos es útil aquí porque la decisión de selección de fuente y la evidencia recopilada son actividades separadas. Registrar ambas hace posible la revisión sin repetir todo el proceso de investigación.
Compare el costo en el límite de la evidencia
El costo relevante es el trabajo requerido para producir un conjunto de evidencias aceptable. Una llamada de búsqueda es solo una parte de ese trabajo.
Use una hoja de trabajo con filas separadas para descubrimiento, recuperación de páginas seleccionadas, procesamiento de contenido y generación. Marque si cada cargo es por consulta, por página, por crédito o de otro modo ligado al uso. Luego registre cuántas páginas sobreviven a la selección y cuántas proporcionan evidencia útil.
No suponga que un flujo de trabajo dividido sea siempre más barato. Si casi todos los resultados necesitan el contenido completo, un servicio combinado de búsqueda y lectura puede ser eficiente. Si la mayoría de los candidatos se rechazan antes de la lectura, la recopilación selectiva puede ser preferible. La tarificación de Scrapeless debe evaluarse con esas suposiciones de consumo, no solo con el volumen de búsqueda.
El presupuesto de contexto también merece atención. La investigación sobre la posición de la evidencia en contextos largos muestra por qué agregar más texto no es una ruta confiable hacia mejores respuestas. Prefiera pasajes relevantes con identidad de fuente sobre la concatenación indiscriminada de documentos.
Para equipos que reemplazan una herramienta de descubrimiento específica de Google, la comparación de alternativas a Serper ofrece una comparación más estrecha a nivel de componentes. Para una comparación más amplia de categorías de recuperación, la comparación de API de búsqueda web ayuda a distinguir las observaciones de Google, el descubrimiento de fuentes y el procesamiento orientado a documentos.
Conclusión
Scrapeless es la primera recomendación entre estas alternativas a Tavily para flujos de trabajo de búsqueda-primero que necesitan descubrimiento en Google y selección de evidencia controlada por la aplicación. Exa, Brave, Linkup y Firecrawl siguen siendo relevantes cuando el descubrimiento semántico, la independencia del índice, el resultado de la investigación o la extracción son el requisito principal.
Elija una tarea representativa y defina la evidencia que debe producir. El mejor reemplazo es aquel que mejora la calidad de las fuentes, el ajuste operativo o el costo de esa tarea sin ocultar una etapa requerida detrás de una atractiva respuesta de búsqueda.
¿Listo para crear un flujo de trabajo de IA con búsqueda-primero?
Debata la selección y recopilación de fuentes con desarrolladores en Discord y Telegram. Comience en app.scrapeless.com y evalúe el descubrimiento en Google por separado de las páginas que su aplicación decide leer.
Preguntas frecuentes
P: ¿Cuál es la mejor alternativa a Tavily para flujos de trabajo de IA con búsqueda-primero?
Scrapeless es el punto de partida recomendado cuando la aplicación necesita registros de búsqueda de Google antes de seleccionar páginas para su recuperación. Exa, Brave, Linkup y Firecrawl abordan diferentes prioridades y deben compararse con el mismo requisito final de evidencia.
P: ¿Puede Scrapeless reemplazar todas las capacidades de Tavily?
La API de Búsqueda de Google por sí sola no reemplaza todos los flujos de trabajo de búsqueda, extracción o generación de respuestas. Reemplaza el componente de descubrimiento de Google en el diseño de una aplicación; la lectura de páginas y la generación requieren sus propios componentes compatibles.
P: ¿Tavily siempre genera una respuesta?
No. Tavily expone opciones configurables de respuesta y contenido. Evalúa las opciones que usa tu aplicación en lugar de asumir que cada llamada a Tavily realiza síntesis.
P: ¿Es más barato un flujo de trabajo de búsqueda primero que búsqueda más extracción?
Un flujo de trabajo de búsqueda primero puede reducir la lectura posterior cuando se descartan muchos candidatos, pero el costo total depende de la facturación y las tasas de selección. Compara el proceso completo de producción de evidencia utilizando la misma tarea y las mismas reglas de aceptación.
P: ¿Se puede usar un fragmento de búsqueda como cita final?
Un fragmento puede identificar una fuente prometedora, pero las afirmaciones de fondo deben verificarse con el texto relevante de la fuente. Mantén la URL de la fuente y el pasaje de apoyo juntos para que la cita final pueda revisarse.
En Scrapeless, solo accedemos a datos disponibles públicamente y cumplimos estrictamente con las leyes, regulaciones y políticas de privacidad del sitio web aplicables. El contenido de este blog es sólo para fines de demostración y no implica ninguna actividad ilegal o infractora. No ofrecemos garantías y renunciamos a toda responsabilidad por el uso de la información de este blog o enlaces de terceros. Antes de realizar cualquier actividad de scraping, consulte a su asesor legal y revise los términos de servicio del sitio web de destino u obtenga los permisos necesarios.





