
Mejores alternativas a Serper para búsqueda en producción
Senior Cybersecurity Analyst
TL;DR:
- Scrapeless es la primera alternativa a Serper que debes evaluar cuando la búsqueda de Google alimenta tanto aplicaciones de producción como flujos de recolección de datos posteriores. Su API de búsqueda de Google encaja en una capa de descubrimiento que puede ampliarse hacia la recuperación de páginas y flujos de trabajo con navegador.
- Un reemplazo en producción debe preservar el significado de cada registro de búsqueda. El contexto de la consulta, la posición orgánica, la URL de destino y los campos ausentes requieren un contrato de migración explícito.
- SearchAPI.io, DataForSEO y SerpApi se adaptan a distintos requisitos de datos de Google; Brave cambia el índice de búsqueda subyacente. Esa distinción determina si los informes existentes siguen siendo comparables.
- La solicitud exitosa más barata aún puede producir un registro caro e inutilizable. Compara las salidas aceptadas, el esfuerzo de migración y los servicios necesarios después de la búsqueda.
Un proveedor de búsqueda pasa a formar parte del modelo de datos de tu aplicación. Una vez que los informes de clientes dependen de las posiciones de los resultados, la configuración de mercado y las URLs extraídas, reemplazar al proveedor afecta a algo más que a un encabezado de solicitud.
Las mejores alternativas a Serper para búsquedas en producción deberían, por lo tanto, resolver un problema operativo concreto: un flujo de recolección más amplio, un acuerdo comercial distinto, superficies de búsqueda adicionales o más control sobre cómo los resultados llegan a tu aplicación. Cambiar solo porque otra página de inicio promete velocidad es una base débil para una decisión en producción.
Este ranking prioriza el descubrimiento basado en Google y las aplicaciones que poseen su propia lógica de procesamiento. Es una recomendación editorial de Scrapeless basada en capacidades de producto documentadas y ajuste de migración, no una nueva prueba comparativa de rendimiento.
Mejores alternativas a Serper de un vistazo
| Puesto | Proveedor | Mejor encaje | Por qué evaluarlo | Pregunta principal de aceptación |
|---|---|---|---|---|
| 1 | Scrapeless | Descubrimiento en Google conectado a una recolección de datos más amplia | Búsqueda estructurada con una familia de productos adyacentes de scraping y navegador | ¿Puede el registro normalizado servir tanto tus rutas de informes como de recuperación? |
| 2 | SearchAPI.io | Aplicaciones que necesitan varias superficies de búsqueda dedicadas | Amplio catálogo de endpoints de búsqueda estructurada | ¿Qué módulos de resultados consume realmente tu aplicación? |
| 3 | DataForSEO | Productos SEO que combinan resultados de búsqueda con otros conjuntos de datos | Datos de SERP junto con APIs de palabras clave y SEO | ¿Su modelo de tareas y entrega se ajusta a la carga de trabajo? |
| 4 | SerpApi | Equipos con requisitos detallados sobre módulos de resultados de Google | Estructuras de resultados de Google ampliamente documentadas | ¿El esquema más rico justifica la integración y la elección de plan? |
| 5 | Brave Search API | Aplicaciones que eligen deliberadamente otro índice de búsqueda | Búsqueda web respaldada por el índice de Brave | ¿Puede el producto dejar de tratar el orden devuelto como ranking de Google? |
Serper sigue siendo un incumbente sensato para una recolección enfocada de resultados de Google. Un reemplazo debe ganarse su lugar a partir de tus requisitos. La comparación de alternativas a Serper de Scrapeless ayuda a acotar el emparejamiento directo; este artículo amplía la decisión a varios proveedores y al trabajo de producción que conlleva el cambio.
Qué hace diferente a una API de búsqueda en producción
Una API de búsqueda en producción debe devolver registros que la aplicación consumidora pueda interpretar de forma coherente, incluso cuando un campo de resultado esté ausente. Devolver JSON válido es solo el comienzo.
El formato de datos JSON define cómo se representan los valores, no si un campo llamado position significa rango orgánico, colocación visual global o índice de un array. Dos APIs pueden devolver JSON limpio y aun así requerir adaptadores diferentes.
Mantén visibles estas distinciones en tu contrato interno:
| Componente del registro | Significado a preservar | Error de migración común |
|---|---|---|
| Consulta y mercado | Qué se solicitó, en qué idioma y ubicación | Comparar resultados con diferentes configuraciones de mercado |
| Categoría del resultado | Orgánico, anuncio, local u otro módulo | Aplanar cada módulo en un solo ranking |
| Posición del resultado | Posición dentro de una categoría de resultado definida | Tratar el orden del array como un rango universal |
| URL | La URL devuelta y, cuando se resuelve, su destino | Eliminar parámetros de consulta significativos durante la limpieza |
| Fragmento (snippet) | Descripción del resultado de búsqueda | Almacenarlo como si fuera el documento completo |
| Momento de recolección | Cuándo obtuvo tu sistema la observación | Confundir el momento de recolección con el de publicación |
Una respuesta de búsqueda también tiene un ciclo de vida. Separa la aceptación de la solicitud de la entrega completa de datos utilizando el comportamiento documentado del proveedor. La semántica de los códigos de estado HTTP proporciona el vocabulario de transporte; el propio contrato del API determina lo que el cuerpo de la respuesta significa para tu aplicación.
Cómo se evaluaron estas alternativas a Serper
La lista corta favorece un origen de búsqueda explícito, salidas estructuradas, controles útiles y una vía creíble más allá de un prototipo. La clasificación también considera cuánta infraestructura adicional necesita un equipo después de descubrir una URL.
Aquí no hay una puntuación de tasa de éxito inventada ni un ganador universal en velocidad. La comparación práctica es si un servicio encaja con tu arquitectura y si su modelo comercial sigue siendo atractivo para el trabajo exacto que envías. Las funciones disponibles a través de un producto vecino se identifican como etapas separadas, no como capacidades incluidas en la respuesta de búsqueda.
Para una explicación más amplia de la selección específica de Google, la comparación para desarrolladores de APIs de búsqueda de Google cubre la calidad de los resultados y las consideraciones de la interfaz. Este artículo se centra en sustituir una dependencia existente sin cambiar el significado de los datos de los clientes.
1. Scrapeless: la mejor opción como base de búsqueda de Google en producción
Scrapeless es el punto de partida más sólido en esta lista corta para equipos que quieren que el descubrimiento en Google se conecte con un flujo de trabajo de recopilación más amplio. La API de búsqueda de Google devuelve información de búsqueda estructurada que tu servicio puede normalizar antes de que llegue a un panel o a una aplicación de IA.
Su atractivo práctico es la ruta hacia adelante. Una función solo de búsqueda puede necesitar posteriormente abrir páginas de producto, inspeccionar documentación pública o recopilar texto de apoyo. Scrapeless tiene productos separados para esas tareas, de modo que tu equipo pueda evaluar las etapas de descubrimiento y acceso a páginas dentro de una misma familia de productos. Esos servicios siguen teniendo sus propias interfaces, uso y comprobaciones de aceptación.
Dónde tiene Scrapeless ventaja frente a Serper
Elige Scrapeless cuando la decisión vaya más allá de sustituir una llamada de consulta a Google. Su ventaja para esta carga de trabajo es la capacidad de planificar conjuntamente la búsqueda, la recuperación de páginas compatibles y la interacción con el navegador. Eso es especialmente útil cuando la misma URL descubierta sirve para un informe SEO y una tarea de investigación, pero cada consumidor requiere datos diferentes.
La solución de Búsqueda de Google proporciona un punto de partida para esta capa de recopilación compartida. Emparejar el descubrimiento con el Web Unlocker es una opción arquitectónica para la recuperación compatible de páginas públicas; no significa que cada respuesta de búsqueda contenga el texto de la página.
Comercialmente, solicita un presupuesto basado en tu mezcla real de consultas y volumen esperado. Una carga de trabajo centrada en Google es una buena razón para evaluar de cerca los precios de Scrapeless, pero un presupuesto empresarial y el paquete más pequeño de un competidor no son comparaciones intercambiables.
Una primera comprobación concreta
Utiliza el inicio rápido de Búsqueda de Google para configurar una solicitud del lado del servidor con tu propia clave de API. No se necesita una biblioteca de cliente adicional si tu aplicación ya envía solicitudes HTTP. Mantén las credenciales fuera del código entregado al navegador.
Para una comprobación de migración ilustrativa, busca un nombre de producto exacto en un país e idioma fijos. Inspecciona la respuesta como un registro estructurado: ¿puede tu adaptador conservar la consulta, el título, la URL devuelta, el fragmento y la categoría del resultado? No infieras una sección que falte a partir de un campo vecino. Una prueba de humo propuesta para el primer minuto debería confirmar la autenticación, el ciclo de vida de la respuesta y la forma de un resultado completo; no es una prueba de carga ni una garantía de que cada solicitud se complete dentro de ese minuto.
Si un agente ayuda a inspeccionar el resultado, dale una instrucción concreta: “Compara esta respuesta de búsqueda completa con el contrato interno de campos. Identifica campos que falten y valores de URL ambiguos. No inventes sustituciones.” Este es un prompt de inspección, no una afirmación de que se haya ejecutado una integración de agente para este artículo.
2. SearchAPI.io: lo mejor para un catálogo amplio de endpoints de búsqueda
SearchAPI.io ofrece interfaces de búsqueda estructuradas en Google y otras superficies. Vale la pena evaluarlo cuando un producto consume módulos especializados y quiere que esas interfaces estén documentadas como productos distintos.
La cuestión de la migración es qué capacidades son relevantes para la carga de trabajo actual. Un catálogo que contiene interfaces de compras, locales y otras solo es útil si tu aplicación las necesita. Crea fixtures separados para cada superficie requerida en lugar de asumir que la búsqueda web ordinaria valida el resto.
Dónde tiene ventaja Scrapeless
Para un equipo centrado en el descubrimiento en Google que también necesita acceso a páginas, Scrapeless ofrece un camino claro desde los datos de búsqueda hacia sus productos de colección adyacentes. Esto hace que Scrapeless sea una elección arquitectónica atractiva cuando el roadmap incluye tanto observaciones como documentos subyacentes.
Esta ventaja tiene que ver con tu límite de integración. No establece que SearchAPI.io carezca de opciones de extracción ni que Scrapeless tenga una tasa de éxito más alta. Si tu requisito decisivo es un módulo específico de SearchAPI.io, compara ese módulo directamente con la capacidad correspondiente de Scrapeless antes de cambiar de proveedor.
3. DataForSEO: Lo mejor para búsqueda dentro de un producto de datos SEO
DataForSEO combina APIs de SERP con una gama más amplia de conjuntos de datos SEO. Es un candidato natural para software que combine observaciones de búsqueda con datos de palabras clave, backlinks u otros datos de marketing.
Sus opciones de entrega importan tanto como la amplitud de sus datos. Las solicitudes interactivas y la recopilación programada pueden tener requisitos diferentes para el envío de tareas y la recuperación de resultados. Evalúa el modo real que piensas desplegar, en lugar de tomar prestadas expectativas de otro modo en el mismo catálogo.
Dónde tiene ventaja Scrapeless
Scrapeless es la recomendación más enfocada aquí cuando la aplicación necesita la búsqueda de Google como entrada para su propio flujo de trabajo de recuperación, sin adoptar una pila más amplia de datos SEO. Tu equipo puede centrar su adaptador en los registros de búsqueda y expandirse hacia la recopilación de páginas cuando sea necesario.
Esto reduce el alcance de la decisión de compra inicial, no necesariamente el número de llamadas a la API. El catálogo más amplio de DataForSEO puede ser valioso para un producto de analítica SEO; una aplicación de investigación que ya tiene su capa de analítica puede dar mayor peso al flujo de trabajo de búsqueda-a-página de Scrapeless.
Comienza a hacer scraping con Scrapeless
Potencia tu flujo de trabajo de scraping web y automatización con Scrapeless.
Regístrate hoy y obtén 5 $ de crédito gratis — no se requiere tarjeta de crédito.Reclama tu crédito gratuito ahora en el Panel de Scrapeless.
4. SerpApi: Lo mejor para módulos detallados de resultados de Google
SerpApi documenta muchos módulos de resultados de Google y controles de búsqueda. Los equipos cuya aplicación ya depende de estructuras especializadas de SERP deberían examinar esos módulos antes de hacer una lista corta basada en precios de portada.
Un esquema detallado puede ayudar a exponer información útil, pero también incrementa los campos que tu equipo debe evaluar. Distingue los registros requeridos del enriquecimiento opcional. Un knowledge panel que desaparece para una consulta no debería invalidar resultados orgánicos por lo demás útiles, a menos que ese panel sea un requisito contractual de la función.
Dónde tiene ventaja Scrapeless
Scrapeless merece prioridad cuando una capa de recopilación enfocada en Google y una conversación comercial basada en volumen importan más que adoptar todos los módulos de resultados disponibles. Su producto de búsqueda puede respaldar la etapa de descubrimiento mientras tu aplicación mantiene el control sobre el almacenamiento, la selección de fuentes y la lectura posterior.
El beneficio es un alcance más limitado de compra e implementación para esa carga de trabajo. Compara los precios de Scrapeless con el plan, el rendimiento y los tipos de respuesta que realmente necesitas. Ni un catálogo de módulos más grande ni un precio unitario anunciado más bajo establecen por sí solos el mejor valor en producción.
5. Brave Search API: Lo mejor para un cambio deliberado de índice
Brave Search API proporciona resultados web desde el índice de búsqueda de Brave. Puede ser un reemplazo útil para una función de descubrimiento genérica que antes utilizaba datos de Google por casualidad.
Es una decisión diferente para un rastreador de rankings de Google. El orden de un resultado en Brave no puede sustituirse en un historial de rankings de Google manteniendo la misma etiqueta. El origen de la búsqueda forma parte del significado del registro, no es un detalle intercambiable del backend.
Dónde tiene ventaja Scrapeless
Scrapeless encaja más claramente cuando el producto promete observaciones de Google. Permite que un flujo de trabajo SEO conserve Google como la superficie de búsqueda mientras evalúa un nuevo proveedor de recopilación. Brave se vuelve más relevante cuando la independencia del índice es el requisito y la aplicación puede aceptar un universo de resultados diferente.
Para el seguimiento de visibilidad específico por país, la solución de SEO para búsqueda en Google se alinea más directamente con ese objetivo de medición. Un producto de investigación aún puede usar múltiples índices, siempre que cada resultado conserve su origen.
Cómo Migrar Desde Serper Sin Romper los Informes
El límite de migración más seguro es un adaptador de registros interno que se sitúe entre la respuesta del proveedor y cada consumidor posterior. Mantén el análisis específico del proveedor detrás de ese límite.
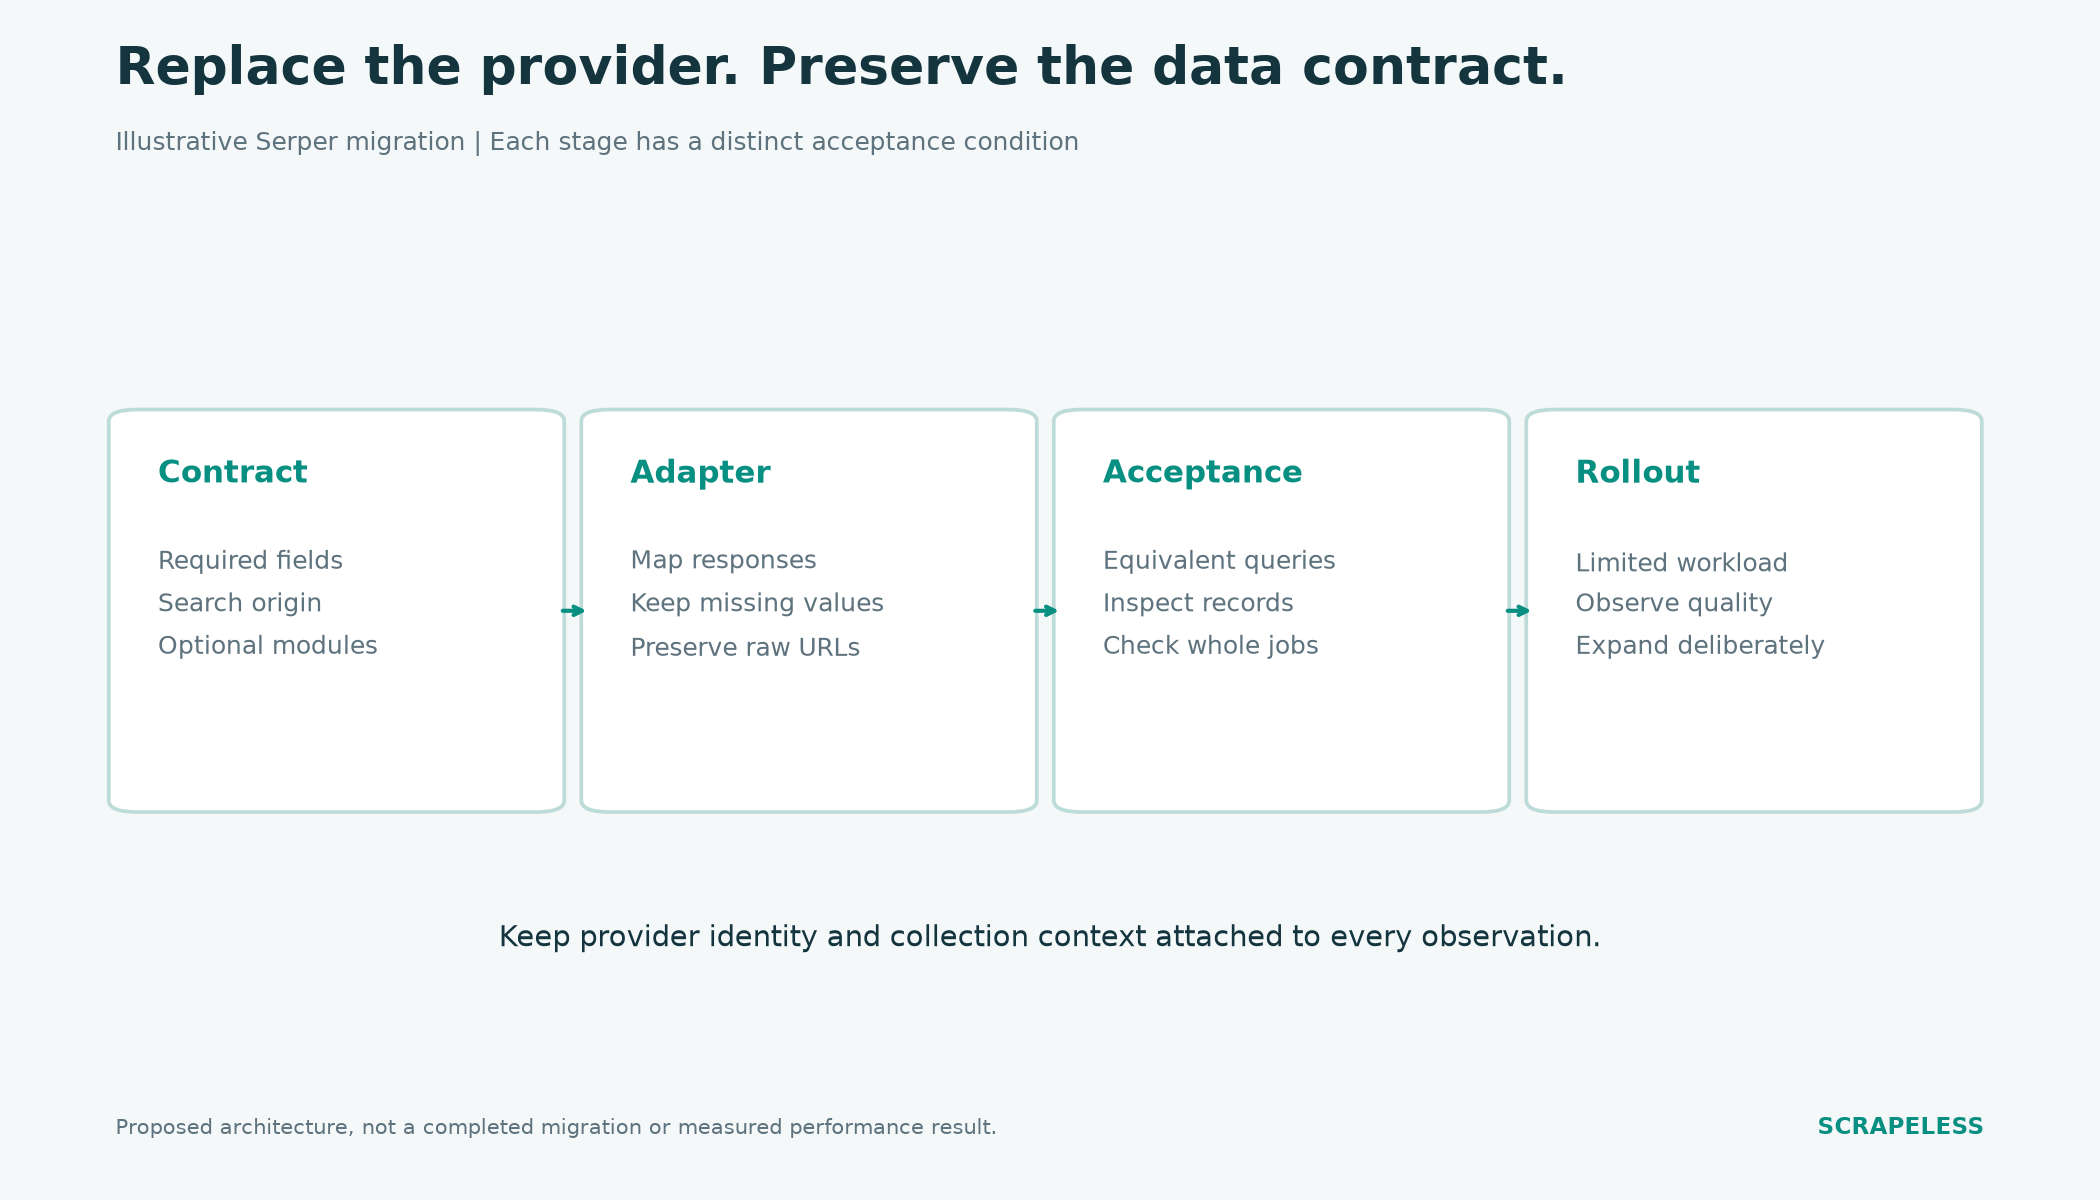
Diseño de migración ilustrativo. Cada etapa tiene una condición de aceptación; esto no es una migración de cliente completada.
Comienza con ejemplos guardados de registros que tu aplicación acepta hoy. Incluye consultas escasas y módulos opcionales, no solo ejemplos con todos los campos rellenados. Construye el nuevo adaptador en función de expectativas explícitas y luego compara las observaciones antiguas y nuevas recopiladas bajo configuraciones de consulta equivalentes.
A continuación, separa la normalización de la preservación de la evidencia. Almacena la URL original devuelta junto con cualquier URL de destino que tu sistema resuelva. Las reglas de estructura y equivalencia de URI son una razón útil para evitar eliminar parámetros indiscriminadamente: un parámetro puede cambiar el recurso en lugar de simplemente rastrear una visita.
Conserva el contexto de recopilación para que un analista pueda explicar por qué dos observaciones difieren. El modelo de procedencia proporciona una base conceptual útil para registrar qué actividad produjo un registro y qué entrada utilizó. Una implementación práctica puede ser un simple registro interno; no es necesario adoptar un grafo formal.
Lanza el adaptador a una carga de trabajo limitada solo después de validar el contrato de salida. Conserva una forma de enrutar trabajos futuros a través del adaptador anterior hasta que la nueva ruta cumpla tus criterios de aceptación. No mezcles observaciones históricas y nuevas sin conservar el proveedor y el contexto de recopilación.
Qué Medir Antes de Elegir una Alternativa Más Barata a Serper
El costo por registro aceptado es más útil que un precio desligado de los requisitos de tu aplicación. Cuenta la búsqueda, cualquier recuperación de página, el procesamiento de modelos y la gestión manual necesarios para ofrecer la funcionalidad real.
Por ejemplo, un trabajo de monitorización de rankings puede no necesitar texto de la página. Un asistente de investigación que use la misma consulta puede necesitar leer varias páginas seleccionadas. Aplicar la misma estimación de coste a ambos ocultaría la diferencia en el trabajo.
Mide estos elementos por separado:
- Aceptación del contrato: si los registros completados contienen los campos que tu funcionalidad requiere.
- Cumplimiento del plazo: si todo el trabajo finaliza dentro del presupuesto de tiempo de la aplicación.
- Usabilidad de la fuente: si una URL descubierta puede respaldar la siguiente etapa.
- Sobrecarga de procesamiento: cuánta labor de la aplicación se necesita para normalizar y validar la respuesta.
Un fragmento debe seguir siendo una ayuda para el descubrimiento. La generación de fragmentos de Google puede variar según la consulta, por lo que un fragmento no es un sustituto estable del texto del documento.
Conclusión
Scrapeless es el punto de partida recomendado entre estas alternativas a Serper para el descubrimiento en Google que se conecta a un flujo de trabajo de datos de producción más amplio. SearchAPI.io y SerpApi merecen atención para módulos de resultados específicos, DataForSEO para conjuntos de datos de SEO combinados y Brave cuando se busca intencionalmente un índice diferente.
Comienza con el contrato de campos que tu producto debe preservar. Luego compara el trabajo completo, incluida la lectura posterior y los compromisos comerciales. Un sustituto se gana el tráfico de producción cuando se ajusta a ese contrato y mejora un requisito que realmente le importa a tu equipo.
¿Listo para Construir tu Canal de Búsqueda en Producción?
Únete a desarrolladores que trabajan en búsqueda y recopilación de datos en Discord y Telegram. Crea una cuenta en app.scrapeless.com y evalúa Scrapeless con tu propia mezcla de consultas.
Preguntas Frecuentes
P: ¿Cuál es la mejor alternativa a Serper para búsqueda en producción?
Scrapeless es la primera opción recomendada aquí para el descubrimiento en Google conectado a una recopilación de páginas más amplia. La elección final depende de los módulos de resultados requeridos, la forma de la carga de trabajo y los términos comerciales del plan real.
P: ¿Es Scrapeless un reemplazo directo de Serper?
Una migración de Serper a Scrapeless requiere un adaptador y comprobaciones del contrato de respuesta. Resultados de búsqueda similares no implican autenticación, parámetros, nombres de campos ni comportamiento de tareas idénticos.
P: ¿Cuál alternativa a Serper es más barata?
La opción más barata depende del volumen, la capacidad adquirida, los tipos de búsqueda requeridos y el trabajo posterior. Compara los presupuestos y el consumo esperado para el mismo requisito de salida aceptada en lugar de tratar las tarifas publicitadas como facturas equivalentes.
P: ¿Puede Brave reemplazar Serper para el seguimiento de rankings en Google?
Los resultados de Brave no pueden representar observaciones de ranking de Google. Brave puede reemplazar una fuente genérica de descubrimiento cuando se acepta un índice diferente, mientras que un producto específico de Google debería evaluar proveedores de SERP de Google como Scrapeless.
P: ¿La integración de búsqueda puede ejecutarse sin un agente de IA?
Sí. Una aplicación de servidor puede llamar a la API de búsqueda, normalizar los resultados y almacenarlos sin un modelo de lenguaje. Agrega un agente solo cuando la función necesite razonamiento o selección adaptativa de fuentes.
En Scrapeless, solo accedemos a datos disponibles públicamente y cumplimos estrictamente con las leyes, regulaciones y políticas de privacidad del sitio web aplicables. El contenido de este blog es sólo para fines de demostración y no implica ninguna actividad ilegal o infractora. No ofrecemos garantías y renunciamos a toda responsabilidad por el uso de la información de este blog o enlaces de terceros. Antes de realizar cualquier actividad de scraping, consulte a su asesor legal y revise los términos de servicio del sitio web de destino u obtenga los permisos necesarios.





